JEPA-Anything 一套預測框架打通不同世界模型

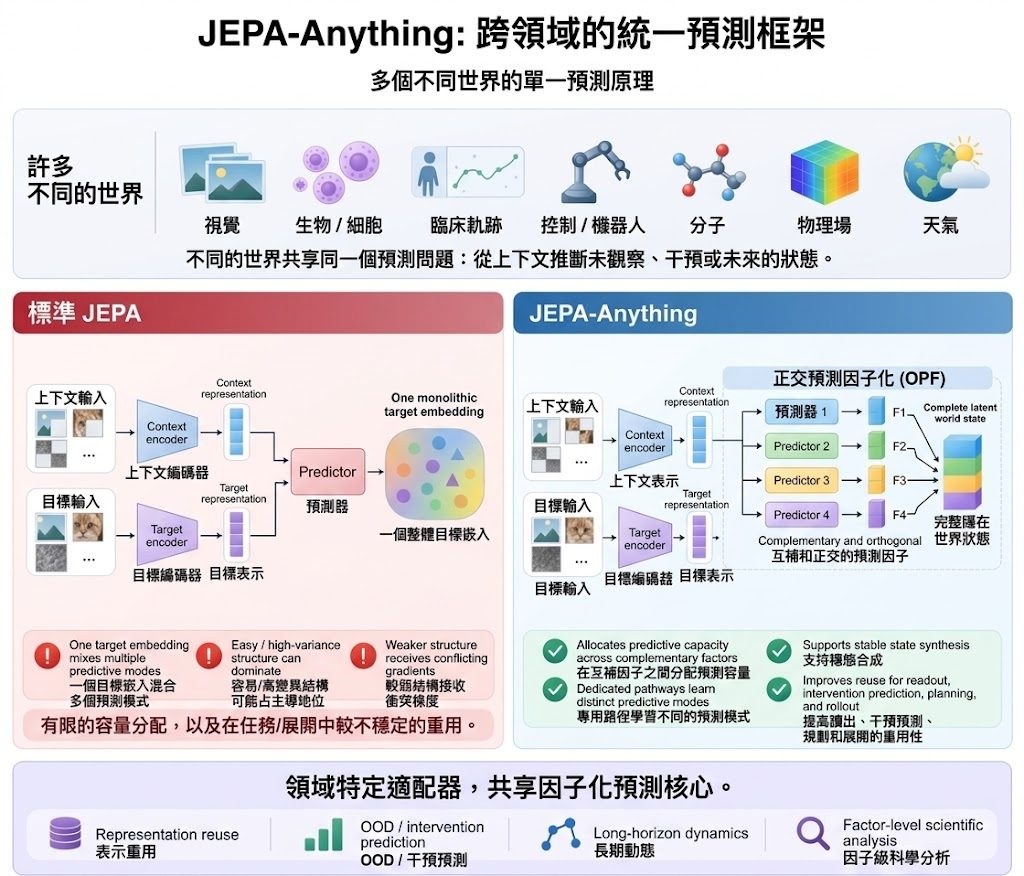
JEPA-Anything 提出 domain-agnostic 框架,把細胞、分子、物理場、控制環境、臨床軌跡等差異極大的世界,交給同一套預測原理學習。它用 Orthogonal Predictive Factorization 取代單一目標表徵,嘗試讓跨領域的世界模型有共享接口。

JEPA-Anything overview: cross-domain predictive learning and Orthogonal Predictive Factorization

世界模型的難題之一,是不同領域看似南轅北轍,卻共享同一個核心問題:能否用同一套預測學習原則,去處理完全不同的世界?Gen-Verse 的 JEPA-Anything 瞄準的正是這個長期卡位。它以 joint-embedding predictive architectures(JEPAs)為基礎,把傳統那塊「單一、整塊」的目標表徵拆開,改由一種叫 Orthogonal Predictive Factorization(OPF)的做法,把潛在的 world state 切成多個互補的預測因子,每個因子各自走一條預測路徑,最後再重組回完整狀態,作為下游讀取、干預預測、規劃與多步 rollout 的接口。

對研究者與工程團隊而言,它的價值在於允許不同領域保留各自的觀測、context–target 結構與編碼器,卻共享同一個預測核心與潛在狀態接口。換句話,領域不必共用同一個編碼器,也不必共用同一組權重,卻仍能復用同一套建模邏輯。框架內部除了可重用的 projection、objectives、baselines、representation diagnostics 外,也提供任務規格驗證與實作 scaffold 工具,並附上一個可控動力系統作為起步範例,方便團隊在自己的領域落地。

相較於針對單一領域訓練的 world model,JEPA-Anything 取捨的方向是放棄「一套權重打天下」的野心,改為提供一個結構化的共享接口與預測路徑。它對於需要把生物干預、物理定律等實驗訊號接回模型內部做分析的場景尤其有用,同時讓 out-of-distribution 預測與長程 rollout 有更清楚的表示基礎。模型權重與評估可在 Hugging Face 上的對應頁面取得。
GitHub

Categories: 開源, Embedding, 世界模型, 模型訓練, 框架, 工具

PANORAMA 把場景描述逐個詞對應到像素

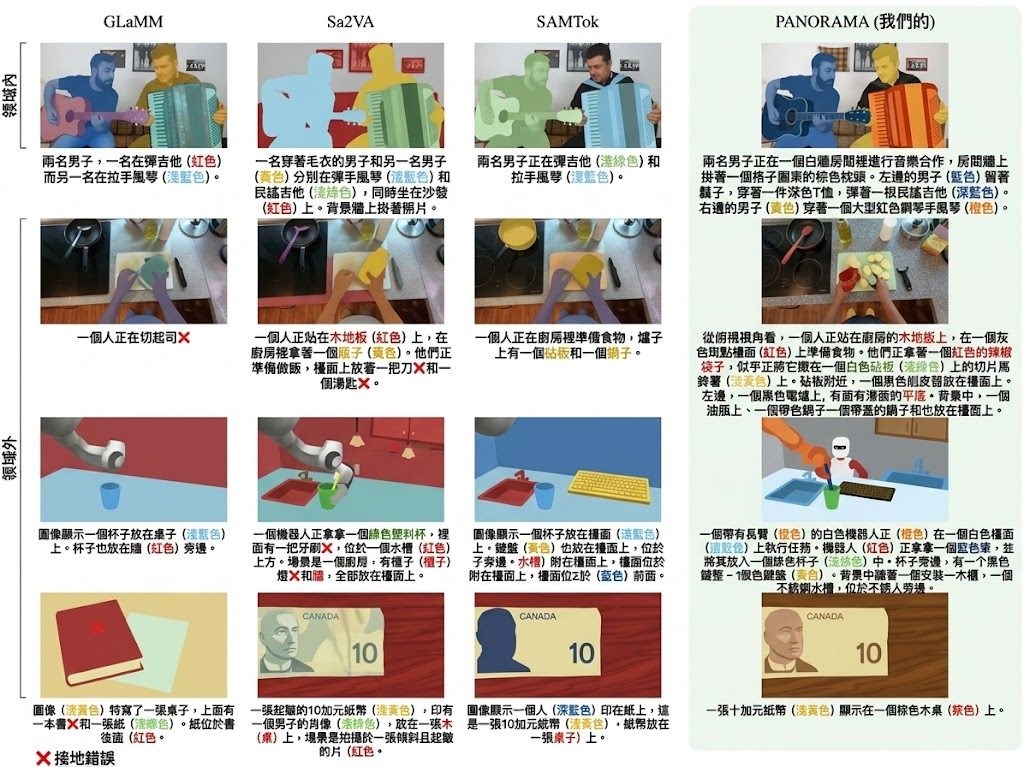
Inria 與捷克理工合作開源的 PANORAMA,能為整個場景生成描述並把每個實體精確對應到像素遮罩,並同步釋出近全幅覆蓋的人工標註基準 PanoCaps。

PANORAMA compared with prior grounded captioning models, in and out of domain

現時的視覺語言模型(VLM)寫得出漂亮描述,卻往往無法把句子裡的物件真正對到像素,導致「說的是一回事、畫出來又是另一回事」。PANORAMA 想處理的是 panoptic grounded captioning:模型要不只描述前景物件,還要連背景區域都講清楚,並為每個提到的實體給出像素級遮罩。

做法上,它把短語定位(phrase grounding)重新定義成「從短語條件化的遮罩提案池中挑選」。預訓練分割器根據每個短語的上下文表徵生成候選遮罩,模型再從中選出真正對應的那一塊,無論是單一區域、多個實例,或根本沒有對應都涵蓋在內。這樣把分割與語言生成用同一介面聯合訓練,文字與遮罩就不再各說各話。

配套資源同樣在 Hugging Face 公開:PanoCaps 約有 3.5K 張圖片、34K 個遮罩和 17.9K 條獨立短語,參照區域覆蓋近 99% 像素;COCONut-PanCap-Recaptioned 提供 118K 張訓練圖的重新標註;MRSeg-Referring-Expressions 則帶來約 101K 條改編自 SegLLM 的單輪指代表達。評估端還提出 generalized Panoptic Quality(gPQ),把文字與遮罩的一致性納入單一指標。實驗結果顯示,PANORAMA 在 PanoCaps 上整體定位表現最佳,並在多個像素級任務上與專門模型持平或更強。

這個項目適合以下情境:

  • 做機器人感知或場景理解的研究團隊:需要模型同時提供自然語言描述與實例級遮罩,減少對接多個模型的成本
  • 訓練數據匱乏的多模態團隊:PanoCaps 與兩份重新標註集合計逾十萬張圖,可直接用作訓練或微調
  • 需要精細指代(referring expression)任務的工作:MRSeg-Referring-Expressions 提供多粒度指代表達,比單一句式更有助泛化
  • 對 VLM 評測有疑慮的研究者:gPQ 指標把文字與遮罩綁定,避免「描述漂亮但對錯位置」的高分陷阱

對想直接跑實驗的人,訓練、微調與評估程式碼已隨倉庫釋出;模型權重則透過 Hugging Face 取得。如果你關心的是 VLM 能否真正「看懂」場景而不只是寫句子,這套統一框架比多數把描述與分割拆開處理的方案更接近落地需求。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Image, 框架, 庫, Dataset 數據集

ActionPiece:設計動作分詞器,幫機械人學得更穩

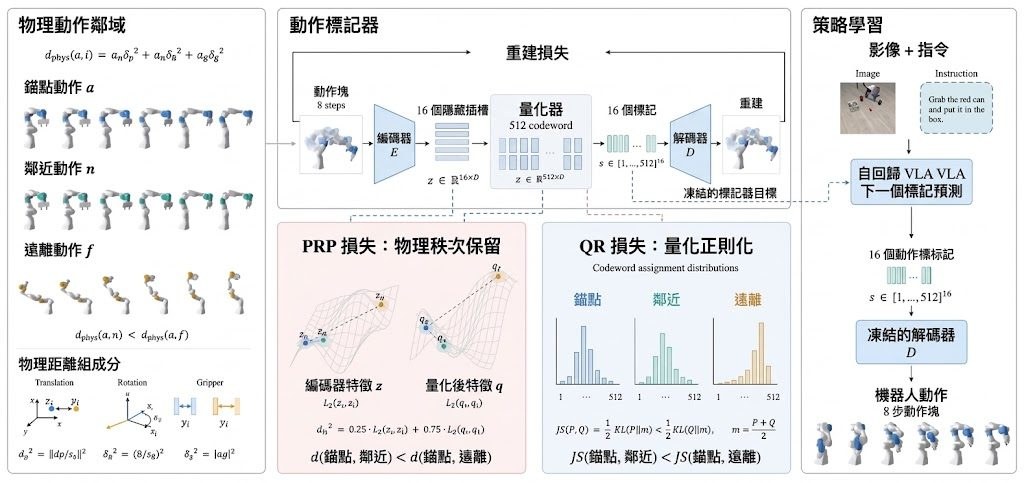
可以把 ActionPiece 理解為一個專給視覺語言動作模型用的動作編碼器,特別針對自回歸生成時動作細節流失的問題,強調保留物理距離的先後關係。

DeepCybo, Zhongguancun Academy, and Zhongguancun Institute of Artificial Intelligence

當自回歸視覺語言動作模型(VLA)把機械人動作切成離散 token 再一個個吐出來,最大的隱性成本往往不是單一動作的誤差,而是相鄰動作之間的物理距離被打亂。ActionPiece 正是針對這個卡位設計:它把動作切成一塊八步的短序列,每塊壓成 16 個離散 token,並要求 tokenizer 不只重建動作,還要保留「物理排序一致性」(physical rank consistency, PRC)。換句話,兩個本來很接近的動作,編碼後的距離也要維持接近;兩個本來很遠的動作,編碼後也要維持較遠。這種監督讓 token 表徵本身帶有物理結構,而不是純粹的重建損失。

在 Libero、Libero-Plus、SimplerEnv 與 VLA-Arena 四組基準上,ActionPiece 配合 Qwen3-VL-4B 作為策略骨幹,跑出 94.8%、68.8%、71.9%,以及 VLA-Arena L0 至 L2 平均 51.5% 的成功率。Libero-Plus 的訓練刻意排除其示範數據,因此這項成績更能反映遷移表現,而不是單純記住示範。從結果可以看到,重建保真度與 PRC 之間並非完全等價:有些 tokenizer 重建得很好,但鄰近關係一塌糊塗,部署成功率也跟著掉。ActionPiece 把「物理排序保留」與「碼字分配的量化正則化」綁在一起訓練,正好同時壓住這兩個問題。

這個項目的實際意義,是給正在做 VLA 研究的團隊一個可直接替換的動作 tokenizer,無需重寫策略架構。對關注 SimplerEnv 真實遙操作或 VLA-Arena 跨平台泛化的工程師來說,這類保留物理關係的分詞方式,會比純重建式 tokenizer 更貼近控制任務的需求。PhysBrain 1.5 也採用了 ActionPiece 作為動作 tokenizer,顯示它已不只在論文層面,而是走進實際模型發佈。

要真正評估它,比較合理的做法是把它接進自己的 VLA 流程,比對換 tokenizer 前後的策略成功率與 PRC;單看 Libero 94.8% 容易被低估,因為重建誤差小的 tokenizer 不一定保留鄰近結構。原始程式碼與 PhysBrain 1.5 的權重將在官方頁面釋出,想搶先試的人可以先讀論文並鎖定後續更新。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, VLA, Robotic, Dataset 數據集

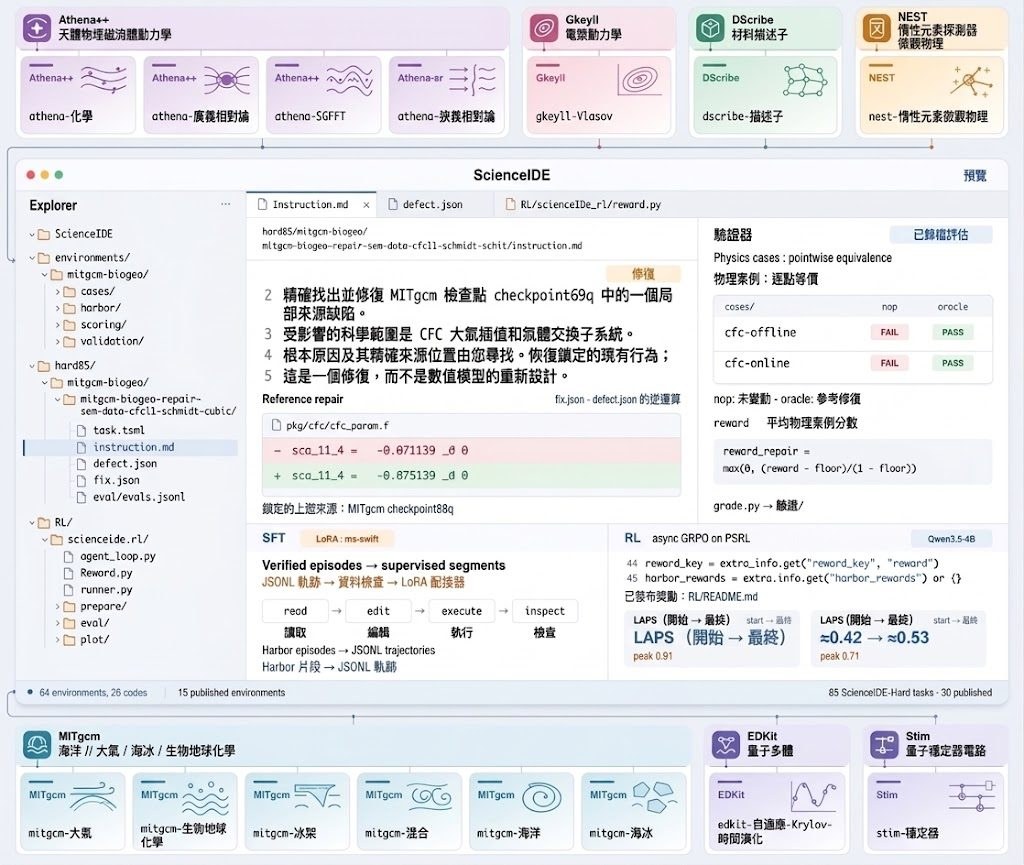
ScienceIDE 把科學模擬變成 AI agent

ScienceIDE 用 64 個科學模擬環境訓練 agent 修 bug、重寫函式,並釋出 4B、9B、72B 三個模型。你可以把它理解成:用真實物理模擬的數值對不對,來判斷 AI 改程式改得啱唔啱。

ide overview

大多數 code agent 訓練環境用靜態單元測試或合成題目,ScienceIDE 走一條更狠嘅路:直接搬真實科學模擬器入嚟做試煉場,等 agent 改動 pinned、未經修改嘅上游源碼,再由 verifier 重新編譯並跑原本嘅物理 case,數值要對得返先算過。換句話,reward 唔係「diff 似唔似」,而係「模擬結果啱唔啱」。呢套框架對工程團隊同做 AI for Science 研究嘅人特別有用,因為佢直接量度 agent 對物理計算嘅影響,而唔係紙上談兵。

項目提供 64 個環境同 85 條 ScienceIDE-Hard 任務,已公開 15 個,全部都附帶可量度嘅難度指標(未修復分數、編輯點數量、驗證成本、通過率),避免人為標 difficulty。Reward 設計亦幾巧妙:untouched repository 一定攞零分,等模型必須真係做嘢先有分。

團隊同時釋出 PhAI-IDE-4B、9B、72B 三個模型,覆蓋唔同算力預算。從結果睇,SFT 後 PLUTO-Particles-Dust 由 0.0 跳到 0.33;Qwen3.5-4B 經 30 步 RL,LAPS 由 0.357 升到 0.857,MITgcm-biogeo 由 0.286 升到 0.571。訓練用科學 code 唔止提升呢類任務,亦帶動一般 benchmark:CodeXGLUE defect detection +6.99pp,BBH Word Sorting +36pp。

要部署嘅人最直接嘅入口係 Hugging Face 嘅 model collection 同 GitHub repo;想理解 reward 邏輯同難度定義,paper 同項目頁有完整交代。訓練數據、開發環境同 verifier 開源,等社區可以喺真實科學 codebase 上繼續 scale up。

重點摘要:

  • 真實物理模擬做 reward:agent 改動上游源碼後,verifier 重編譯並比對物理 case 數值,唔靠 diff 相似度。
  • 64 個環境、85 條 Hard 任務:已開源 15 個,難度由可量度指標自動決定,唔靠人手標 label。
  • 三個模型規模:PhAI-IDE-4B、9B、72B 覆蓋唔同算力,訓練設定與評估條件一致。
  • 科學任務外溢到通用 benchmark:CodeXGLUE defect detection +6.99pp,BBH Word Sorting +36pp。
  • 完整開源鏈:code、environments、tasks 同模型權重同步釋出,方便研究團隊複製同擴展。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, 框架, IDE, Dataset 數據集

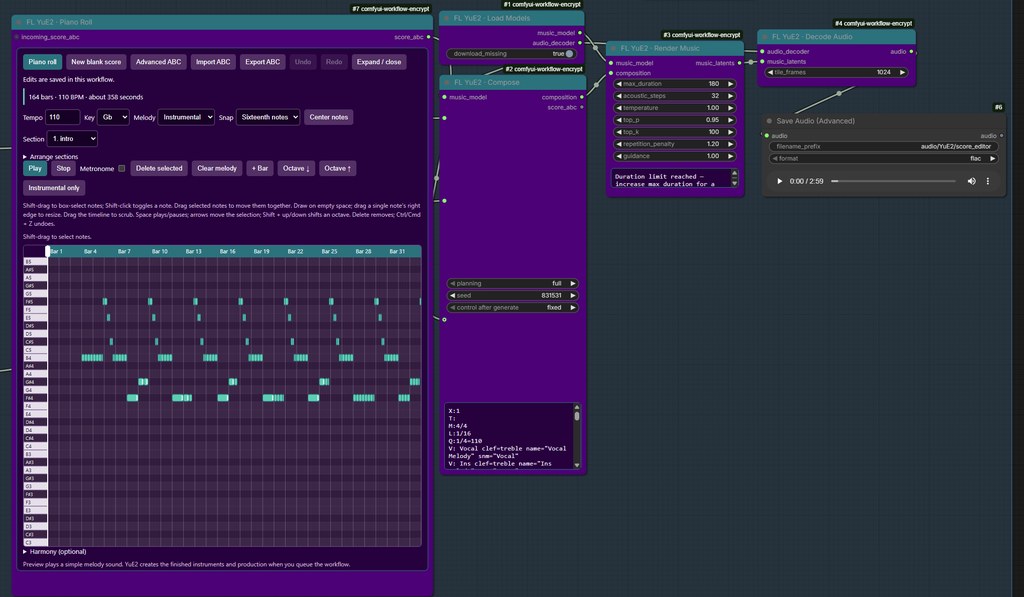
ComfyUI-FL-YuE2:ComfyUI 內砌歌:FL YuE2 把樂譜編輯、AI 作曲、LoRA 訓練三件事接起來

ComfyUI-FL-YuE2 是一組節點,把 YuE2-3B 音樂模型包進 ComfyUI 工作流,讓你用鋼琴卷軸寫樂譜、灌歌詞,最後輸出 48 kHz 立體聲成品,亦支援 AR LoRA 訓練。

YuE2 inference workflow in ComfyUI

以往想在 ComfyUI 玩音樂生成,往往要面對幾個卡位:要自行接 YuE2 的推理指令、要另外找譜面編輯工具、想做 LoRA 微調更要跳出 ComfyUI 自己搞訓練腳本。FL YuE2 嘗試一次解決這三件事,把樂譜編輯、AI 作曲、AR LoRA 訓練全部接成節點流程,對熟悉 ComfyUI 圖形化工作流的用家算是頗順手的整合。

項目核心是一個可視化鋼琴卷軸編輯器,支援點擊加音、Shift 框選、箭頭鍵移動、Undo/Redo 等基本操作,並提供 Instrumental 或 Sung 旋律模式。和弦面板可摺疊,匯入的 ABC 樂譜會保留 slash chord 等進階標記。換 Key 時同時處理旋律與和弦根音,最短轉調、超出音域會直接拒絕而非裁切音高,設計上偏向「樂理正確」多於「暴力生成」。

音訊輸出走 YuE2-3B 加獨立 VAE 解碼器,產出 48 kHz 立體聲,內建瀏覽器合成器可預覽節段節拍,但並非最終成品音色。LoRA 訓練流程則提供數據集檢視與 checkpoint 預覽,方便用家挑選權重繼續微調。

重點摘要
– 屬於 ComfyUI 自訂節點套件,整合 YuE2-3B 音樂生成與樂譜編輯
– 鋼琴卷軸支援框選、群組移動、Undo/Redo,轉調按樂理而非裁切處理
– 推理與 AR LoRA 訓練共用同一組節點,方便迭代
– 需 NVIDIA GPU 支援 BF16,已驗證 RTX PRO 6000 Blackwell,其餘 24 GB 配置未經驗證
– 首次執行約下載 7.8 GB 模型權重,支援中斷續傳與離線模式

適合已有 ComfyUI 基礎,又想嘗試可控音樂生成或自訓風格 LoRA 的用家。注意目前僅在 Windows + Python 3.12 + Torch 2.11 環境驗證,跨平台或較舊 GPU 仍需自行測試。

GitHub

Categories: 開源, ComfyUI, 模型, 模型訓練, NVIDIA, Audio, Python, 音樂, Dataset 數據集, 廣東話

HarnessVLN:不訓練也能走的統一導航框架

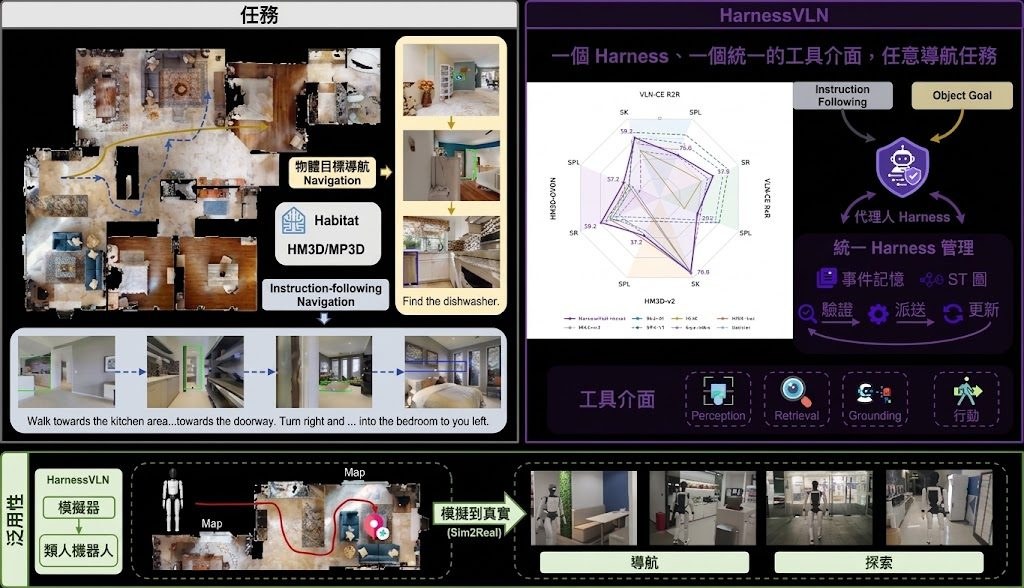
HarnessVLN 把視覺、語言、空間證據交給一套 Agent Harness 統籌,用零訓練方式處理多任務導航,並以層化記憶與時空圖解決長程失敗。

Repository image for AgibotGeneral/harnessvln

Embodied Navigation 過去依賴大規模訓練與任務專用流程,但不同場景的 pipeline 各自為政,難以共享空間證據與錯誤紀錄。HarnessVLN 把這個痛點攤開:現有 training-free 方法雖然借助多模態大語言模型,卻缺乏把「提案」與「空間證據、任務進度、執行失敗」對齊的機制,於是同一個 agent 在長時序任務中容易重複犯錯、難以回收。

作為一個訓練無需更新的 agent harness,HarnessVLN 用統一工具介面串接感知、檢索、定位、導航、恢復與終止,並透過層化事件記憶與持久化時空圖(Spatiotemporal Graph)保留可重用的空間證據與失敗標註,讓跨子目標的經驗真正沉澱。提案不再直接落地,而是先被 Agent Harness 結合幾何可行性與過往失敗做驗證,再分派給工具執行。

在 R2R、RxR、HM3D-v2、HM3D-OVON 等基準上,HarnessVLN 報出 60.8、53.9、76.0、59.3 的 SR%,覆蓋 instruction navigation 與 online exploration 兩種形態,並提供真機 demo 與模擬環境。對機器人團隊、具身 AI 研究者與需要快速驗證導航策略的工程師來說,它提供一個不必從零訓練就能橫向比較的底層框架。

重點摘要

  • 訓練無需更新:以 Agent Harness 統一感知、檢索、定位、導航、恢復與終止工具
  • 層化事件記憶 + 時空圖:把子目標進度與空間證據沉澱為可重用資產
  • 提案先驗證再執行:用幾何可行性與失敗紀錄把 LLM 操作提案過濾一次
  • 覆蓋 R2R、RxR、HM3D-v2、HM3D-OVON 等多項導航基準
  • 同時提供模擬與真機 demo,適合做跨任務導航策略的快速評測

對在意長時序導航穩定性、想避開昂貴 fine-tuning 的團隊,這套來自南京大學、清華大學與 AGIBOT 合作的方案,給出一條「不訓練也能走得更穩」的工程化路線。

項目主頁 · GitHub · Paper

Categories: 開源, 南京大學, 清華大學, Agentic, 多模態模型, 模型訓練, Robotic, 框架, 工具, Dataset 數據集

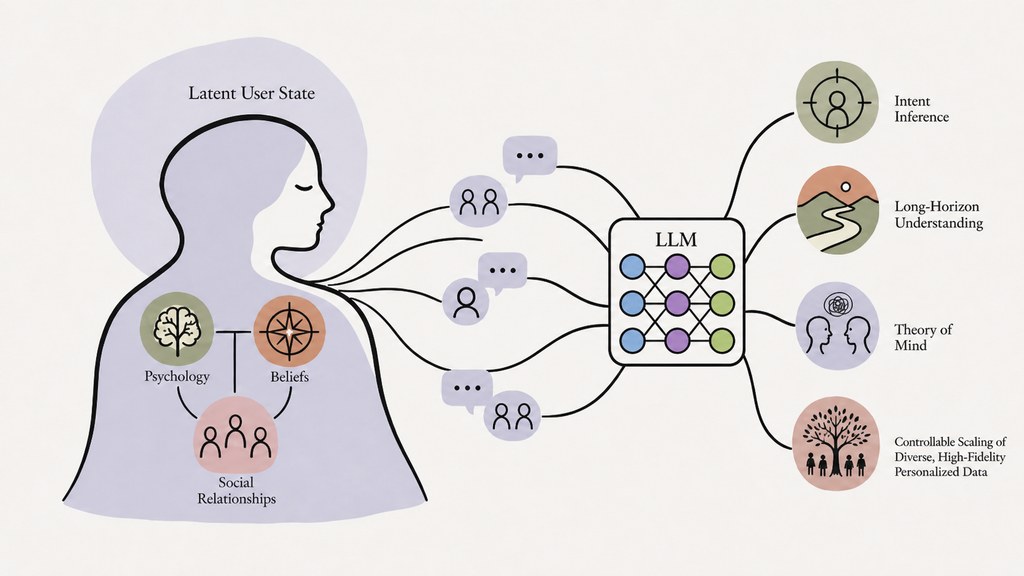
Mind2Dialogue:讓模型學會推斷用戶內心狀態

這個項目用一套共享狀態的對話模擬流程,讓模型從純對話歷史推回用戶的信念、目標和情緒,從而提升個人化與心理理論能力。

idea-promotion

現時很多聊天模型在多輪對話中表現不錯,但一到「這個用戶其實想要什麼、心情如何、跟上一句話背後的脈絡」就容易失去線索。Mind2Dialogue 直接在訓練階段把這個缺口補上:模擬器跟一個 Oracle 助理共用同一個會隨對話演化的用戶狀態,Oracle 寫出的回覆就成為學生模型的訓練目標;學生模型在訓練時只看到 persona 與對話紀錄,要自行還原背後狀態。

整個流程由六個階段組成:規模化產生 persona 種子情境、批次生成對話、用 LLM 作評審過濾低質樣本、從對話抽取 QA 對、語料改寫增廣,最後做微調與評估。設計上刻意把模擬者、Oracle、評審分成不同模型端點,避免自我評分,也容許把較強模型放在 Oracle 位置。情境類型涵蓋終生關係、高頻互動、情緒事件與敏感議題,使訓練語料貼近真實長期陪伴的場景。

在 Qwen2.5-7B-Instruct 上,個人化指標 PrefEval-Gen 比基礎模型高 33.4 分,PersonaMem-v2 高 10.0 分,並在同骨架下壓過加記憶模組與其他個人化方法。Qwen 與 Llama-3.1-8B-Instruct 在 BigToM 等 Theory-of-Mind 基準上也同步進步,代表個人化與心智理論可能共享同一種「從觀察推回未觀察狀態」的能力。OLMo-3-8B-Instruct 則未見轉移,顯示效果仍受骨架預訓練影響。

隨訓練資料量由八分之一擴到全量,三個骨架的個人化分數都穩步上升,呼應「資料規模足夠,學生才能學會狀態還原」這個核心假設。對做對話系統、角色 AI、AI 陪伴或客服助手的研究團隊,這套管線可作為不需要逐句人工標註的個人化資料生成起點;對關心評測的研究者,內附 LLM-as-judge 與消融設定(full、no_privilege、no_state、latent 等)便於追溯不同監督訊號的貢獻。

重點摘要:

  • 共享狀態模擬:模擬器與 Oracle 共用演化中的用戶狀態,Oracle 回覆成為學生訓練目標
  • 零人工標註管線:六階段流程從 persona 種子到微調皆可批次執行
  • 個人化與 ToM 同步提升:Qwen 與 Llama 在 PrefEval-Gen、PersonaMem-v2、BigToM 上均有明顯改善
  • OLMo 未見轉移:效果依賴骨架預訓練特性,OLMo-3-8B-Instruct 在 ToM 上反而下跌
  • 資料越多越好:從 1/8 到全量語料,三個骨架的個人化分數持續上升

項目主頁 · GitHub · 數據集

Categories: 開源, Agentic, 模型訓練, Qwen, LLaMa, Dataset 數據集

PhysStream:邊播邊拉物件,讓 AI 影片生成更貼近物理直覺

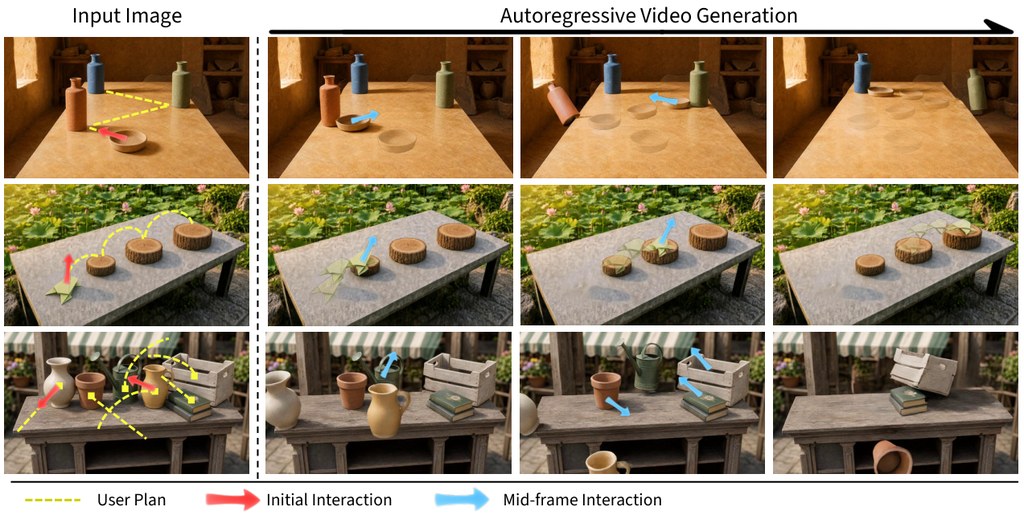
PhysStream 是一個物理導向的影片生成模型,用戶可以在生成過程中隨時拖動物件來改變它的運動方向,做到真正的中途互動控制。

Og image

以往想用 AI 生成一段符合物理規律的影片,往往需要在生成前就設定好整個控制排程,而且很多方法只懂在像素層面指定物件位置,未必真正理解「力」與「速度」這類物理量。PhysStream 的切入點正正落在這個空隙:它是一個自回歸的物理導向圖生影片模型,支援中途互動,容許用戶在生成過程中隨時拉動物件,改變它的運動方向。

核心做法分兩個階段。先用一個雙向模型做微調,加入速度增量(velocity increment)這類稀疏信號作控制條件,讓模型學到背後的動力學;再訓練一個因果自回歸模型,引入結構化場景記憶,記錄位置圖與物件追蹤圖,使每一幀生成都能參考歷史畫面的一致狀態。同時解決了「中途介入」與「物理一致性」兩個難題。

PhysStream 把運動分佈距離(FVMD)降低 33%、軌跡誤差降低 12%,而且在真實場景的人類評測中,超過 85% 的對比都獲得偏好。在多物件桌面剛體場景裡,這種邊生成邊控制的能力是目前其他方法做不到的。對做特效、動畫預覽或物理模擬預演的團隊來說,這種「拉到邊做」的互動模式會比較貼近日常工作流。

重點摘要:

  • 中途拖動控制:生成過程中可隨時改變物件運動方向,毋須事先設定控制排程
  • 物理導向信號:採用速度增量而非像素位置,讓模型學習真正的動力學
  • 結構化場景記憶:以位置圖與物件追蹤圖維持長影片一致性
  • 兩階段訓練:先雙向微調學控制條件,再因果自回歸強化物理一致性
  • 評測表現:FVMD 降 33%、軌跡誤差降 12%,人類評測偏好率逾 85%

項目主頁

Categories: AI productions, 視頻模型, 模型訓練, Video, World-Action Model, Robotic, 動畫

awesome-ai-for-games:基礎模型開始當玩家、設計師與測試員

基礎模型在遊戲場景的角色,已經不限於落子對奕。新加坡國立大學團隊發表的120頁綜述,把AI在遊戲生命週期中的用途分成六種角色,並用同一組問題貫穿比較。

Awesome AI for Games — AI for Games in the Foundation Model Era

過去談遊戲 AI,多數人直覺想到 AlphaGo 或強化學習對奕 agent,但這個 GitHub 項目展示的視角明顯更廣。它由新加坡國立大學與南洋理工大學作者群發表,圍繞 442 篇文獻、416 篇核心著作,把基礎模型在遊戲生命週期中的角色拆成六類:玩家或 NPC、世界或玩家模型、內容與規則設計、在遊戲引擎內操作、調整運行中的遊戲,以及產出測試證據。

之所以這樣分類,原因是同一個預訓練模型可能同時擔任多個角色,但每個角色對應的接口、限制與所需證據都不同。項目用三個反覆出現的問題貫穿六個角色:邊界(由遊戲或工作流提供、由 AI 負責的部分)、遷移與重用(哪些能力與產物能跨場景複用,哪些仍綁死在特定設定)、證據(評估方法是否真正支撐了結論)。這套問法讓「會寫程式」與「會做玩家」不再混為一談。

從實際工作場景看,遊戲工作室、引擎開發者、玩家行為分析團隊,以及研究遊戲 AI 的學界,都能從這份分類地圖中快速定位自己關心的子題,例如社交協調架構 CASCADE、桌面資料視覺—動作預訓練 D2E,或者長時程 LLM agent 的 bounded-memory 測試環境 AgenticSTS。

理解這個項目最直接的方式,是把它視為一份研究地圖加書目入口:項目網站提供可搜尋的 442 條參考清單、論文圖表與影片導讀,並把同一套分析框架套到每一個角色,讓讀者比較不同子領域的成熟度。對想入門遊戲 AI 的人而言,它比單篇論文更容易判斷哪些方向已有共識、哪些仍處於早期定義階段。

重點摘要

  • 120 頁綜述、442 篇參考文獻,由新加坡國立大學與南洋理工大學團隊共同整理
  • 把基礎模型在遊戲中的角色分成六種(玩家、世界模型、設計、引擎內操作、運行中調整、測試),而非按模型架構分類
  • 用「邊界、遷移與重用、證據」三個問題貫穿所有角色,作為統一的分析視角
  • 涵蓋社交協調、桌面視覺—動作預訓練、長時程 LLM agent 測試等多條子題線索
  • 項目網站提供可搜尋書目、圖表與 90 秒影片導讀,方便快速定位子領域

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型訓練, Video, 框架

LynnReal-Omni 把十幾種影片任務塞進一個 32B 模型

一個 32B 多模態擴散 Transformer,同時做文字生影片、圖生影片、動作控制、風格遷移、影片修復同長影片串流。Flash 版本更可喺單張 H100 上 377 毫秒出 22 帧 540p 短片。

LynnReal-Omni — Standard four-step and Flash three-step multimodal generation

LynnReal-Omni 想解決嘅,係影片生成工具鏈最煩嘅一件事:每加一個任務(動作控制、參考影像、風格遷移、編輯、修復)就要疊多一個模型或多一套 pipeline。作者選擇用一個 32B 共享多模態擴散 Transformer(跟 MiniMax H3 架構)一次過承載文字生影片、圖生影片、人體與手部姿勢控制、結構控制、omni-reference、風格遷移、影片編輯、退化影片修復,以至串流式長影片生成,仲可以接駁外觀參考、可編輯 3D render、遊戲錄影等異質輸入,等 Agent 可以喺同一個模型內組合視覺條件。

對比同類做法,最大差異係「統一框架」而非「任務專用模型」。每個源帧獨立編輯再組裝成無聲 24fps 影片,每帧只需四次 DiT forward,120 帧即 480 次 forward。輸入限制清楚:24fps、寬高需為 32 倍數、目前只支援 768p(1344×768 起手)。獨立逐帧編輯會帶來亮度或形狀嘅帧間抖動,作者亦坦白標示為已知限制。

對短片創作者、遊戲或 3D 團隊、Agent 開發者來講,好處係少咗一套模型接駁嘅工程成本;Agent 可以直接用外觀參考同 3D render 嚟組裝條件。Flash 版本(27B、三步生成、輕量 VAE decoder)將單張 H100 上 22 帧 540p 由 843 毫秒壓到 377 毫秒,為實時或互動應用鋪路。

項目已提供 ComfyUI workflow 涵蓋 t2v、i2v、r2v、pose2v、v2v 幾個入口,但作者明言仲係早期 beta,質量、兼容性同 bug 仍然存在,訓練代碼、部分訓練數據同更高效 DiT 預計稍後釋出。打算用佢做關鍵流程嘅團隊,宜先以小批量預覽(--indices 0,24,48 --keep-clips)確認穩定性再評估是否引入生產。

重點摘要:
– 一個 32B DiT 模型覆蓋十幾種影片任務,Agent 可直接組合異質視覺條件
– 每源帧四次 DiT forward,120 帧共 480 次;輸入限 24fps、寬高需 32 倍數、768p
– Flash 版本用 27B 加輕量 VAE,單張 H100 上 22 帧 540p 暖機生成耗 377 毫秒
– 獨立逐帧編輯會產生帧間亮度與形狀抖動,屬已知限制
– ComfyUI 支援 t2v、i2v、r2v、pose2v、v2v,目前屬早期 beta,訓練代碼尚未開源

GitHub · 模型

Categories: 開源, ComfyUI, Agentic, AI productions, 模型, 多模態模型, 模型訓練, Video, Image, 框架, 工具, Content Creator, 3D, MiniMax

Page 16 of 38
1 … 14 15 16 17 18 … 38