Rapid-MLX:加快 Apple Silicon 的本地編程代理

想讓 Codex、OpenCode、Claude Code 等編程代理使用本地模型,又不想犧牲回應速度與工具呼叫能力?Rapid-MLX 提供兼容 OpenAI 和 Anthropic API 的推理服務器,專為 Apple Silicon 設計。

Rapid-MLX. Local LLM server for Apple Silicon, built for coding agents. Up to 4× faster than Apple

在 Mac 上用本地模型操作 Codex、Claude Code 或 OpenCode,回應速度和代理能否可靠呼叫工具都會影響工作流程。Rapid-MLX 是建基於 MLX、面向 Apple Silicon 的開源大型語言模型(LLM)推理服務器,讓多款編程代理透過兼容 OpenAI 與 Anthropic 的介面連接本地模型。

它與直接使用 Apple 的 MLX(mlx-lm)相比,主打更快的生成速度和編程代理所需的工具呼叫能力;同一模型、同一組權重下,項目報告最高可達 4 倍解碼速度,典型任務約快 1.5 倍。比較結果會受模型、任務和硬件影響,不能視為所有情況都能達到的速度提升。

測試資料包括 Mac mini M4 Pro 上的 Qwen3.5-9B 4-bit,以及 Mac Studio M5 Max(36 GB)上的多款 Qwen 模型。Rapid-MLX 的 Qwen3.5-9B 解碼速度為每秒 115.5 個 token,oMLX 為 77.9,LM Studio 為 81.0;但測試只記錄單次執行,並使用各服務器的預設模式,因此數字適合參考,不宜直接當作全面排名。

安裝後選用支援的編程代理,再以 rapid-mlx launch 啟動即可;同一指令可重複使用,移除 Rapid 的私人設定檔也不會改動 Codex 原有設定。首次回覆可能較慢,因為模型需要下載或載入,也可能要處理代理的開場提示詞。項目要求使用 M 系列 Mac,目前沒有 Windows 或 Linux 桌面版本。

  • 支援 Codex、Claude Code、OpenCode、Pi、Hermes、Crush 和 Goose。
  • 提供兼容 OpenAI 與 Anthropic 的 API,並著重可靠的工具呼叫。
  • 可按模型和任務查看速度比較,項目亦提供測試方法與原始數據。
  • 首次回覆可能受模型下載、載入及提示詞處理時間影響。
  • 僅支援 Apple Silicon;不適合需要 Windows 或 Linux 桌面版本的團隊。

需要在 Mac 上運行本地模型、又希望保留編程代理工作流程的開發者,可以用 Rapid-MLX 測試常用模型與任務,再決定速度提升是否足以配合硬件需求。模型仍須在本機下載和載入,選擇時應一併考慮記憶體容量及首次啟動等待時間。
GitHub

Categories: 開源, 模型, Qwen, 提示詞, 工具, Mac, 編程, 蘋果

Embodied Agent Arena:測試十款 VLM 的任務能力

十款前沿視覺語言模型接受 1,000 個具身任務測試,結果顯示,能生成可執行動作,不代表能完成多步操作或精細接觸任務。

logo transparent

要判斷視覺語言模型(Vision-Language Models,VLMs)能否勝任機械人通用操作,不能只看它有沒有成功發出動作。Embodied Agent Arena 是一個具身代理評測項目,以共同測試流程比較十款模型在五類能力上的表現,涵蓋 1,000 個案例,並把幾何理解、空間推理和視覺定位納入評測。

項目把任務理解、推理和動作選擇交由模型處理,再以同一套精簡評測框架測試不同模型。測試資料整合 32 個既有來源,另加入 168 個案例的 GeoProbe 幾何基準;相比只看機械人互動任務,這種安排能同時檢視模型理解空間資訊的能力,以及能力能否轉化為實際任務成果。

結果反映,單一指標容易掩蓋任務是否真正完成。Gemini 4 Argon 的 3D 路徑誤差最低,為 0.310 米,但 56 條路徑中只有 24 條符合全部限制;Manipulation 成功率最高的 Opus 5.5 亦只有 47.8%。CALVIN 測試中,100 個序列有 60 個完成第一個目標,完成全部五個目標的只有 9 個;在五項 ManiSkill 診斷任務中,Opus 5.5 能完成拾取、放置和堆疊,卻未能完成插入插銷或充電器。

  • 同一批 157 項 Planning 任務中,至少有一款模型完成 142 項;仍有 15 項十款模型全部失敗。
  • Astra 的 31 項失敗任務耗用 55.5% token;失敗任務平均耗用的 token 是成功任務的 5.1 倍。
  • CALVIN 有 65 個序列曾遇到執行錯誤;其中 62 個後來能無錯執行程式碼,但只有 3 個最終完成序列。
  • Case Atlas 收錄 181 個涵蓋五類能力的案例,提供十款模型的紀錄;缺少影片的項目會使用共用任務場景,API 中斷則標記為失敗嘗試。

這些結果適合用來比較模型在哪些環節失手,亦提醒研究團隊不要把路徑精度、程式碼執行成功或單一步驟操作,直接當成完整任務能力。項目提供線上結果、案例影片、資料集及程式碼。

項目主頁 · GitHub · 數據集

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, AI productions, 世界模型, Qwen, DeepSeek, Gemini, API, VLA, Robotic, 框架, 香港, Anthropic, Dataset 數據集

BYOD:用單張 GPU 將指令模型改造成雙向擴散模型

BYOD 讓你從 Colab Notebook 選擇指令模型並進行訓練,再透過互動介面觀察逐步去噪生成;但快速模式不會重現論文分數。

Repository image for RuurdKuiper/BYOD

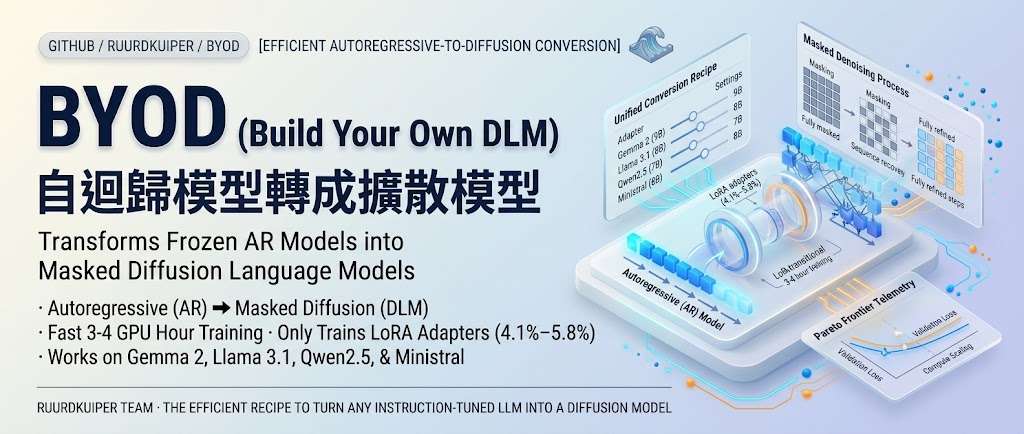
BYOD 把指令模型轉成雙向遮罩擴散語言模型,讓模型生成文字時能逐步去噪,並在互動頁面即時查看生成變化。它是模型訓練工具,主要處理如何用單張 GPU 訓練這類模型;Colab Notebook 可選模型、啟動訓練及查看 loss 曲線,第 6 步會開啟可調整生成設定的推理介面。

使用方式分為 Colab 和本機兩條路徑:Notebook 會沿用 Colab 的 PyTorch、CUDA 套件,只在啟動推理介面時安裝 Gradio;本機訓練則需 NVIDIA GPU、Hugging Face 讀取權杖,並先接受受限模型的使用條款。本機推理網頁需安裝 .[demo] 套件。訓練資料會自動下載,手動中止時會保存 interrupted/,可載入該次結果繼續推理。

BYOD 以 LoRA 微調既有模型,而非從頭訓練;quick 模式採用較小模型和 rank-128 LoRA,適合先檢查流程,但不會重現論文分數。paper 模式使用 rank-1024 LoRA,原始訓練使用 96 GB 記憶體,對硬件要求高。兩種模式預設均訓練 25,000 次更新,訓練與驗證 loss 若出現 NaN 或無限值,程序會報錯並保留先前最佳 adapter。

  • Notebook 提供模型選擇、訓練和 loss 曲線檢視。
  • 推理介面可調整生成設定,並即時查看去噪過程;也支援載入中斷訓練的結果。
  • 可選 Llama、Gemma、Qwen 和 Ministral;各模型提供不同 quick 或 paper 配置,Ministral 只有 paper 配置。
  • 評估在每個 checkpoint 執行,輸出只保留 best/;本機訓練要求 NVIDIA GPU,quick 模式不等同論文設定。

研究者和模型工程團隊可用它比較不同指令模型經擴散式訓練後的生成過程,也可先透過託管示範體驗已訓練模型。若目標是復現論文結果,應採 paper 配置並準備高記憶體 GPU;低資源測試則可用 quick 模式確認訓練流程。

GitHub

Categories: 開源, 模型, 模型訓練, Qwen, NVIDIA, Gemini, 工具, LLaMa, Python, LoRA

CoworkOS:2D/3D 網頁任務統一工作流

複雜項目往往要跨多日推進,也需要人手覆核和中途調整。CoworkOS 讓 AI 代理接手分工與持續監察,並保留進度、記錄及待審核成果。

CoworkOS: geometric wordmark, fixed OS frame and illustrated desktop workspace

從研究、文件到 CAD 和 Blender,CoworkOS 讓人與 AI 代理在同一工作空間協作,處理需要多步推進、跨日跟進的工作。它屬於開源 AI 協作執行框架,目標是把任務由規劃、分工一路帶到可檢查的成果;長時間運行的 Jobs 會保留狀態和日誌,遇到等待或中斷後仍可接續處理。

代理工作分成三層:Main Agent 制定計劃、分派任務及檢查成果;Coordinator Runtime 負責派送子任務並追蹤進度;可選用的 Subagents 則執行範圍明確的工作。模型負責決定任務策略,執行環境則維持協調、回饋和工作連續性,避免把多代理協作的管理全交由模型自行處理。

CoworkOS 把 CLI、搜尋、檔案和 MCP 接到文件編輯器、簡報、CAD 與 Blender 等工具,人和代理可以共同修改文件、模型及場景。階層式工作空間和語意記憶用來延續項目脈絡;候選修改會保留版本資訊,讓人先檢查再整合。這種做法適合需要覆核、追蹤及中途改方向的團隊,但可用工具和模型服務的實際配合仍會影響工作流程。

研究團隊也可用同一套機制建立長期監察迴圈,例如分析模型失誤、改善訓練資料、執行訓練及驗證結果。配套研究報告記錄了 Qwen3.6-35B-A3B 經五輪後訓練後,在八個基準的平均分由 33.19 升至 42.95;這是特定實驗結果,各任務仍有升跌,不能直接視為其他模型或工作流程的保證。

  • Jobs 保留長時間任務的狀態與日誌,方便中斷後繼續監察。
  • Main Agent、Coordinator Runtime 和 Subagents 分別負責規劃、協調與執行。
  • 人與代理可共同處理文件、簡報、CAD 模型及 Blender 場景。
  • 候選修改可先經人手檢查,再整合到項目成果。

CoworkOS 面向使用 macOS 的研究人員及需要多工具協作的團隊,支援 Apple Silicon,並要求 macOS 14 或以上及 Node.js 22.19.0 或以上。儲存庫資料提及可透過 npm 安裝,亦提供文件、展示及即時示範連結,開始部署前,仍需查閱項目文件確認模型服務與工作空間的配置方式。

項目主頁 · GitHub

Categories: 開源, 北京大學, Agentic, MCP, 模型, 模型訓練, Qwen, 框架, 工具, Mac, 庫, 中國, 蘋果, Dataset 數據集

NorthCUA:讓桌面與網頁任務留下可查證成果

交給 AI 的桌面任務,可以連同操作過程與成果一起檢查。NorthCUA 容許自選模型,但接入仍有能力要求。

NorthCUA

讓 AI 操作桌面與網頁後,還能檢查最終檔案或軟件狀態,NorthCUA 把這一步納入開源執行框架 Harness。它串連操作、畫面資訊、工作筆記與結果檢查,讓長任務保留中間進度。

框架建基於 NexAU,不綁定單一模型,但接入的視覺模型須支援結構化工具呼叫。NorthCUA 模型系列則基於 Qwen3.5,提供 Nano、Mini、Pro 三種規模;框架與模型應分開理解。

  • 可先試免金鑰的本機教學,再接入模型執行任務。
  • docs/first-run.md;所附節錄未提供完整安裝步驟。
  • 支援可恢復的批次執行,並保留過程記錄供檢查。

項目公布 Pro 在 OSWorld-Verified 得分為 88.6%,測試涵蓋 361 個任務、上限 100 步,排除 8 個 Google Drive 任務。參考模型的操作介面與結果彙整方式不同,不能直接視為同條件比較。

需要追查操作失敗原因、驗證交付成果的自動化團隊較容易受益;具體任務能否完成,仍要接入模型後測試。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, Qwen, 框架, 教學, 軟件, 工具

ReGap-Bench:視覺與推理分開評測

模型看見物件,不代表能逐步追蹤它們。ReGap-Bench 用可配對的視覺參照,測出多模態推理究竟卡在哪裏。

Teaser

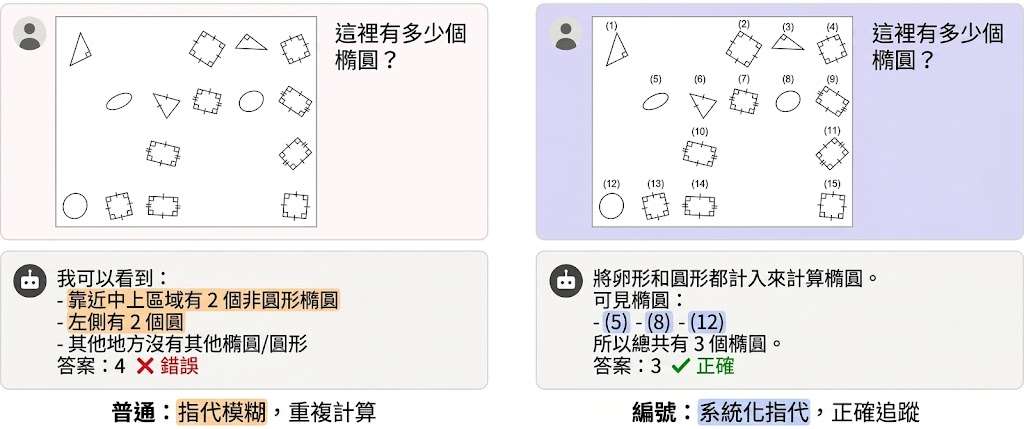
模型明明看見圖中所有物件,數數時卻會重複計算;ReGap-Bench 是一個針對 multimodal large language models(MLLMs)的資料集與評測項目,專門檢查語言推理能否正確對應視覺中的物件、區域和位置,並將問題命名為 reference gap。

它把同一場景、問題和答案固定,只更換額外參照,形成 paired reference-intervention benchmark。編號讓物件可以被索引,陰影標示有界區域,網格線則協助定位、追蹤邊界和比較位移;參照是否配合任務,會直接影響推理結果。

  • 涵蓋 shape counting、angle ranking、size ranking、clock ranking 和 transformation prediction 五項任務
  • 共 200 個場景及 3,400 張圖片,設有 plain、numbering、shading 和 grid 條件
  • task-matched references 可令所有受測模型在所有任務提升,最高達 25%
  • mismatched references 幫助有限,甚至會令表現下降

測試可用 OpenAI、Google Gemini API,亦可透過 vLLM 執行 Qwen3.5;後者需要 GPU,API 模型則只需設定相應金鑰。Python 3.10 環境和 requirements 已列明,輸出會保存到 outputs,方便比較同一模型在不同參照條件下的差異。

ReGap-Bench 的價值不在於再加一個總分,而是把視覺感知和語言推理之間的接合問題單獨拉出來。結果支持一個務實判斷:改善模型未必只靠更強的視覺編碼器,為任務建立合適的外部視覺參照,也可能成為不需重新訓練的 visual skill;不過參照錯配會反過來干擾模型,因此它更適合研究團隊、MLLM 評測人員和需要分析多步視覺推理失誤的開發者。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, 模型, 多模態模型, 模型訓練, Qwen, Google, OpenAI, Gemini, API, Image, Python, Dataset 數據集, Skill 技能

Wizard:讓 AI 即時改動遊戲世界與戰鬥規則

Wizard 讓玩家用指令改變場景、角色和戰鬥狀態,再即時生成連貫影片。它適合探索互動遊戲原型與可控世界模型的創作方式。

favicon

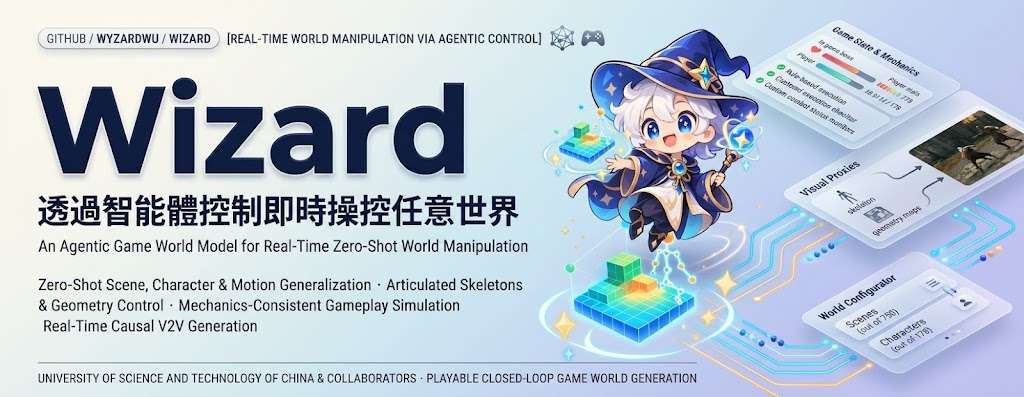
改變地形、召喚敵人,甚至令角色變身,Wizard 都能把這些操作整合到即時遊戲畫面中。這個世界模型項目以代理控制修改遊戲狀態,再由影片生成模型呈現變化,目標是讓互動不只限於移動角色,也能改動環境與戰鬥規則。

使用者可透過按鍵、文字指令或單張畫面控制世界。場景幾何、角色骨架、動作和戰鬥狀態會分開記錄,因此系統可以處理平台升降、地面變形、角色攻擊與受傷等變化;影片生成器則以每秒 24 幀輸出畫面。項目亦稱,展示中的場景和角色都是模型未曾見過的內容。

整個流程分成快速建置和遊戲期間的控制。建置階段會重建場景與角色、配置骨架並整理動作;遊戲期間,代理更新幾何、動作和戰鬥狀態,再交由 Wan2.2-TI2V-5B 生成影片。文字指令會轉成幾何操作程式,戰鬥則由狀態追蹤、攻擊規劃和規則控制器處理。

• 適合想測試可互動遊戲場景、角色動作及戰鬥變化的研究者與創作者。
• 可用文字指令、按鍵或畫面輸入控制世界,也能比較生成影片與場景代理畫面。
• 每秒 24 幀生成,並以兩步去噪處理;項目描述的建置階段少於五分鐘。
• 程式碼尚未公開,現有資料亦未提供下載或使用流程。

Wizard 把可明確追蹤的遊戲狀態與即時影片生成結合,適合探索「能否直接操控世界規則」這類互動設計。它的應用仍受限於目前展示和程式碼尚未開放的狀態,外部使用者暫時難以自行驗證或整合。

項目主頁

Categories: 騰訊, Agentic, AI productions, 模型, 視頻模型, 世界模型, Qwen, Video, Image, 框架, Content Creator, 動畫

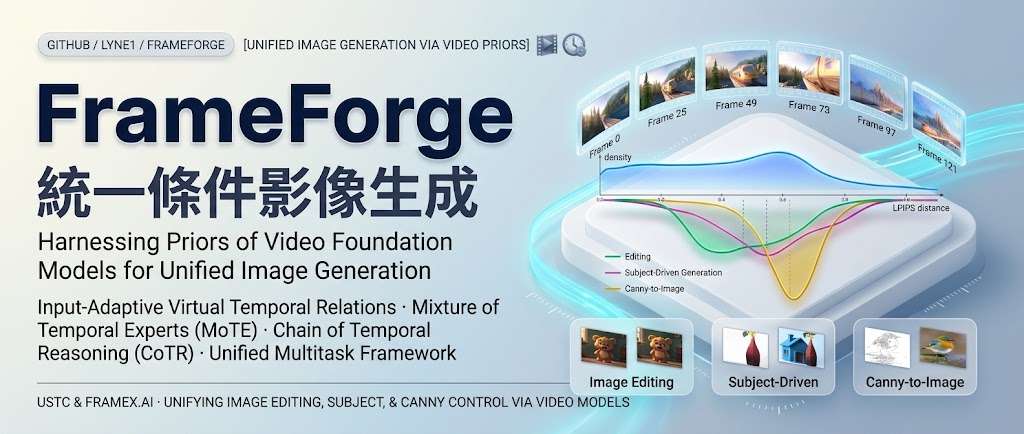
FrameForge「換場景、不換主角」統一三種影像生成

FrameForge 把 HunyuanVideo 1.5 的影片時間帶入影像生成,讓同一套模型處理主體生成、邊緣圖生圖和指令式編輯。

Repository image for Lyne1/FrameForge

同一張參考圖可以用來保留主體、遵循 Canny 邊緣結構,或按照文字指令改變內容,但三種任務對「要保留多少、要改變多少」的要求並不相同。

FrameForge 是一個「給它一張參考圖,再用文字指示生成或修改圖片」的 AI 研究專案。它的特色是借用影片模型理解畫面變化的能力,來處理靜態圖片。

它用同一個模型處理三種工作:

功能 你提供什麼 可以做什麼
參考主體生成 一張人物、動物或物件的參考圖,加上文字描述 保留主體的辨識特徵,重新生成不同場景,例如把同一隻狗放到海灘上
邊緣圖轉圖片 一張 Canny 邊緣圖,也就是描出物件輪廓的線條圖,加上文字描述 依照既有輪廓、姿勢與構圖生成完整圖片
文字指令修圖 原始圖片,加上修改指令 改變動作、加入物件或轉換風格,例如「把貓的動作改成睡覺」,同時盡量保留其餘內容

這三種功能分別適合「保留是誰/是什麼」、「保留畫面結構」以及「修改指定內容」的需求;不是每次都從文字重新生一張毫無關聯的圖。

技術上有兩個重點:
– MoTE:動態選擇不同的虛擬時間間隔,對應不同程度的畫面變化。
– CoTR:加入一個潛在中間狀態,作為原圖轉換到目標圖的中間路徑。

官方已提供推論程式及模型下載方式,環境需要 Linux、Python 3.10 和支援 CUDA 的 GPU;公開流程以 512 × 512 輸入及輸出圖片、50 次去噪步驟運行,部分模型下載也需要先申請存取權。

注意「同一個模型整合三類圖片工作流程」,可作為評估自建圖像生成/編輯服務的 PoC 起點。官網目前提供的是研究結果與部署入口,不能直接視為已具備完整產品能力。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, NVIDIA, Stable Diffusion, Video, Image, 影像模型, Linux, Python, 庫, 中國, LoRA

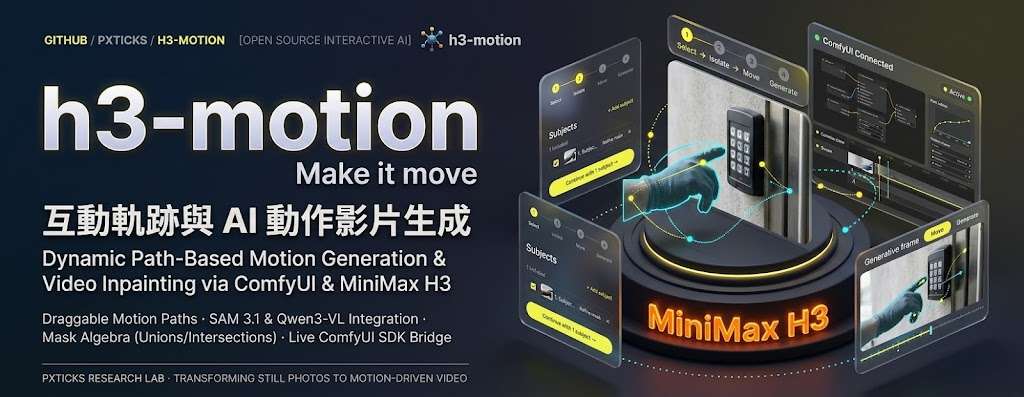
h3-motion:沿路徑移動照片主體並重生成影片局部

沿路徑移動照片主體,或為影片局部加上遮罩再重新生成;h3-motion 透過自架 ComfyUI 串連影像理解與動畫模型。

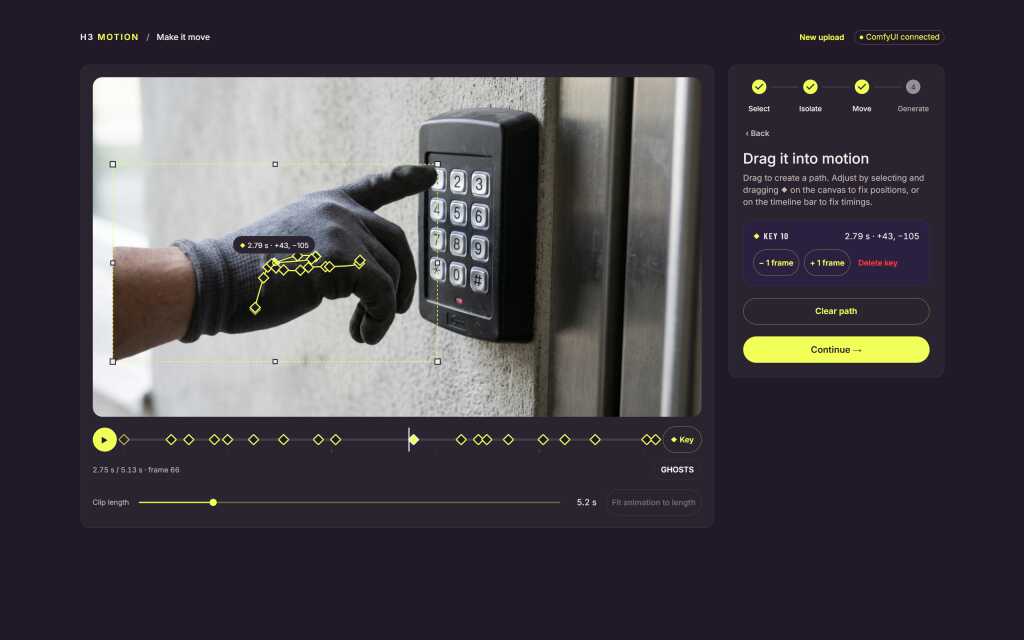
Select step: a gloved hand picked out with SAM 3.1

想沿路徑移動照片主體,或只重做影片局部,h3-motion 把兩種編輯流程整合在獨立 React app,透過 Comfy SDK 操作自架 ComfyUI。流程只用開放權重模型,不依賴 Comfy Router、合作夥伴節點或封閉 API。

照片流程以 SAM 3.1 選取主體,並可用點擊修整遮罩;Qwen3-VL 描述主體,Qwen Image 2.1 清除主體並補回背景。使用者設定路徑、大小或翻轉後,由 MiniMax H3 透過 Time-to-Move 生成動畫與聲音。

影片可用矩形或橢圓標出範圍,設定 keyframe 路徑或讓遮罩跟隨物件,並加入描述及可選參考圖。H3 重生成遮罩區域後,由 app 合成回原片;原有聲音可保留、參照或替換。

  • 照片:主體分割、背景清除,再沿路徑生成動畫。
  • 影片:局部遮罩、路徑或物件跟隨,並合成回來源影片。
  • 模型串連 SAM 3.1、Qwen3-VL、Qwen Image 2.1 與 MiniMax H3。

需要 NVIDIA 或 AMD GPU、近期 ComfyUI、ComfyUI-vlo 0.3.0 或更新版本,以及 Node.js 22.12 或更新版本;原生 Windows 尚未測試。文件未提供速度或畫質評測,較適合熟悉 ComfyUI、需要精細編輯影像局部的創作者。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, Qwen, NVIDIA, API, Video, Image, Audio, Content Creator, 動畫, MiniMax

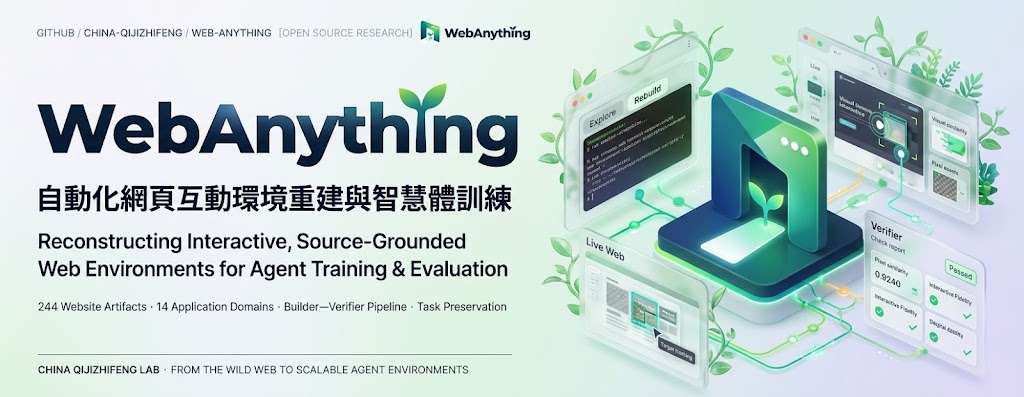
WebAnything 把真實網站重建成可重設的測試環境

從網站獲其內容重建互動網站,能在可重設的環境中完成任務。

WebAnything concept logo

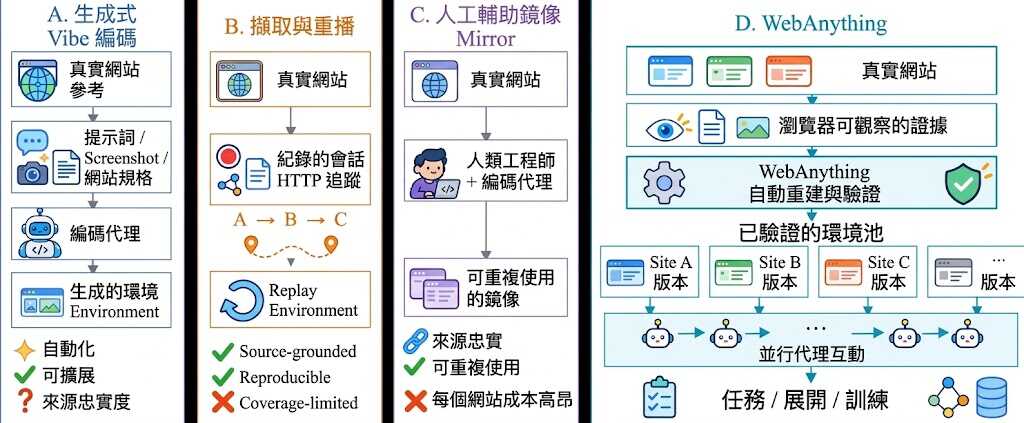
要訓練或評測 Web agent,截取網站畫面並不足夠,代理還要能操作控制項、切換頁面並完成多步任務。WebAnything 是一套研究程式碼,將網站證據轉成可執行、可重設的代理環境,目標是保留任務流程,而不只是重現畫面。

建構流程先由 Builder 透過瀏覽器探索網站,記錄頁面狀態、互動資料、DOM、畫面截圖及網絡資源,再重建環境。候選環境會先凍結,交由 Verifier 獨立檢查;發現實作錯誤或證據不足時,系統會針對問題修正。Full 模式適合追求較廣覆蓋,JIT 則按代理任務需要建構環境,兩者在完整度與建構成本之間作取捨。

項目分析了 6,172 個獲接納的來源任務執行紀錄,平均每個任務使用 10.4 個工具步驟,中位數為 8 步;34.7% 的任務超過 10 步,最長達 89 步。這些數字反映任務包含多步互動,但不能單獨代表重建保真度或代理能力;評估亦分別涵蓋歷史頁面狀態的保真度,以及模型在指定基準測試中的下游效用。

  • 適合研究 Web agent 訓練與評測、需要可重複網站任務環境的團隊。
  • Builder 和 Verifier 使用支援 Responses API 的模型服務;兩者需配置模型 ID、API URL 及 API key。
  • 本機需安裝 Chromium,瀏覽器操作由 Playwright 支援;代理亦需要終端機存取權。README 未列出最低 CPU、記憶體或 GPU 規格,不能據此判定具體硬件門檻。
  • 儲存庫提供建構流程及 244 個歷史網站項目的清單,但網站原始碼與第三方媒體存放在外部 artifact store,並未隨儲存庫附上。

Web agent 提供 Python 套件、命令列工具及設定流程,並可把本機 agent skill 安裝給 Codex 或 Claude Code;這個 skill 不是 MCP server。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 模型訓練, Qwen, API, 工具, Python, 庫, Anthropic, 中國, Dataset 數據集, Skill 技能

Page 1 of 26
1 2 3 … 26