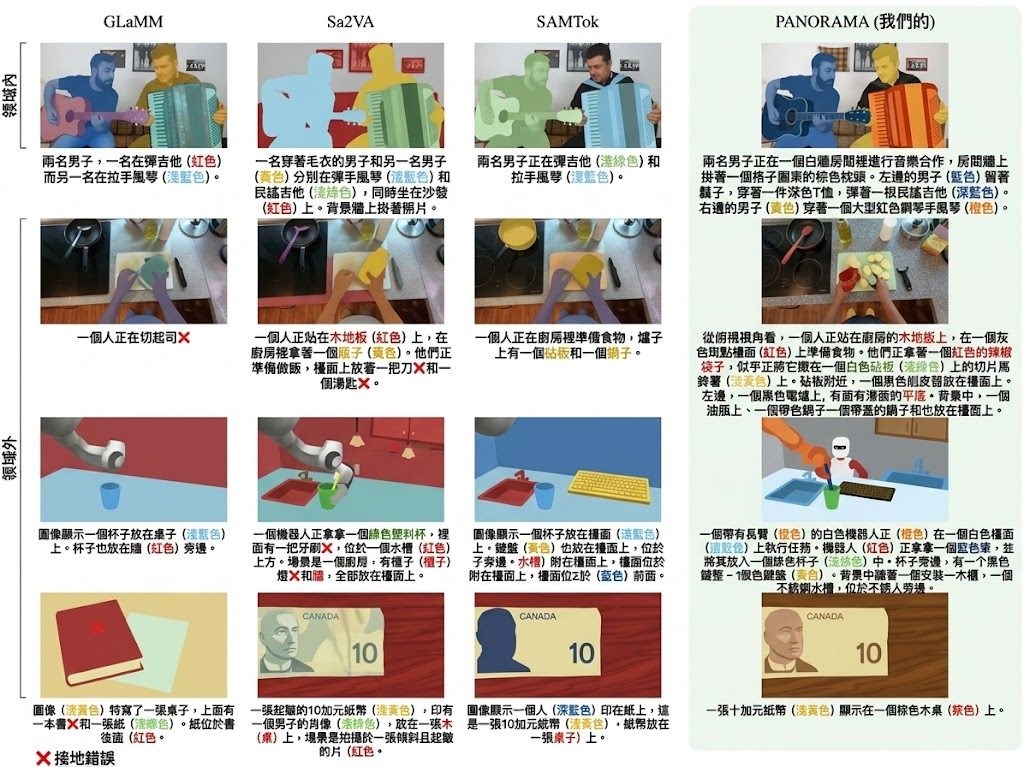
現時的視覺語言模型(VLM)寫得出漂亮描述,卻往往無法把句子裡的物件真正對到像素,導致「說的是一回事、畫出來又是另一回事」。PANORAMA 想處理的是 panoptic grounded captioning:模型要不只描述前景物件,還要連背景區域都講清楚,並為每個提到的實體給出像素級遮罩。
做法上,它把短語定位(phrase grounding)重新定義成「從短語條件化的遮罩提案池中挑選」。預訓練分割器根據每個短語的上下文表徵生成候選遮罩,模型再從中選出真正對應的那一塊,無論是單一區域、多個實例,或根本沒有對應都涵蓋在內。這樣把分割與語言生成用同一介面聯合訓練,文字與遮罩就不再各說各話。
配套資源同樣在 Hugging Face 公開:PanoCaps 約有 3.5K 張圖片、34K 個遮罩和 17.9K 條獨立短語,參照區域覆蓋近 99% 像素;COCONut-PanCap-Recaptioned 提供 118K 張訓練圖的重新標註;MRSeg-Referring-Expressions 則帶來約 101K 條改編自 SegLLM 的單輪指代表達。評估端還提出 generalized Panoptic Quality(gPQ),把文字與遮罩的一致性納入單一指標。實驗結果顯示,PANORAMA 在 PanoCaps 上整體定位表現最佳,並在多個像素級任務上與專門模型持平或更強。
這個項目適合以下情境:
- 做機器人感知或場景理解的研究團隊:需要模型同時提供自然語言描述與實例級遮罩,減少對接多個模型的成本
- 訓練數據匱乏的多模態團隊:PanoCaps 與兩份重新標註集合計逾十萬張圖,可直接用作訓練或微調
- 需要精細指代(referring expression)任務的工作:MRSeg-Referring-Expressions 提供多粒度指代表達,比單一句式更有助泛化
- 對 VLM 評測有疑慮的研究者:gPQ 指標把文字與遮罩綁定,避免「描述漂亮但對錯位置」的高分陷阱
對想直接跑實驗的人,訓練、微調與評估程式碼已隨倉庫釋出;模型權重則透過 Hugging Face 取得。如果你關心的是 VLM 能否真正「看懂」場景而不只是寫句子,這套統一框架比多數把描述與分割拆開處理的方案更接近落地需求。