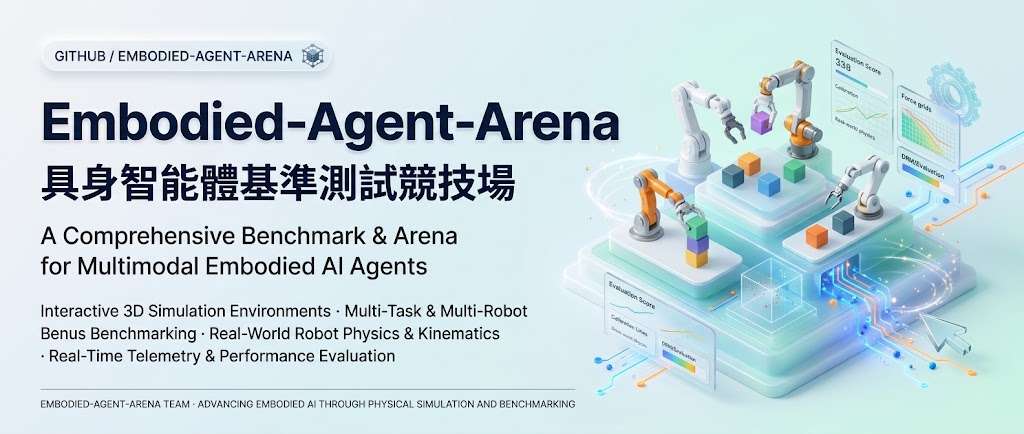
Embodied Agent Arena:測試十款 VLM 的任務能力

十款前沿視覺語言模型接受 1,000 個具身任務測試,結果顯示,能生成可執行動作,不代表能完成多步操作或精細接觸任務。

logo transparent

要判斷視覺語言模型(Vision-Language Models,VLMs)能否勝任機械人通用操作,不能只看它有沒有成功發出動作。Embodied Agent Arena 是一個具身代理評測項目,以共同測試流程比較十款模型在五類能力上的表現,涵蓋 1,000 個案例,並把幾何理解、空間推理和視覺定位納入評測。

項目把任務理解、推理和動作選擇交由模型處理,再以同一套精簡評測框架測試不同模型。測試資料整合 32 個既有來源,另加入 168 個案例的 GeoProbe 幾何基準;相比只看機械人互動任務,這種安排能同時檢視模型理解空間資訊的能力,以及能力能否轉化為實際任務成果。

結果反映,單一指標容易掩蓋任務是否真正完成。Gemini 4 Argon 的 3D 路徑誤差最低,為 0.310 米,但 56 條路徑中只有 24 條符合全部限制;Manipulation 成功率最高的 Opus 5.5 亦只有 47.8%。CALVIN 測試中,100 個序列有 60 個完成第一個目標,完成全部五個目標的只有 9 個;在五項 ManiSkill 診斷任務中,Opus 5.5 能完成拾取、放置和堆疊,卻未能完成插入插銷或充電器。

  • 同一批 157 項 Planning 任務中,至少有一款模型完成 142 項;仍有 15 項十款模型全部失敗。
  • Astra 的 31 項失敗任務耗用 55.5% token;失敗任務平均耗用的 token 是成功任務的 5.1 倍。
  • CALVIN 有 65 個序列曾遇到執行錯誤;其中 62 個後來能無錯執行程式碼,但只有 3 個最終完成序列。
  • Case Atlas 收錄 181 個涵蓋五類能力的案例,提供十款模型的紀錄;缺少影片的項目會使用共用任務場景,API 中斷則標記為失敗嘗試。

這些結果適合用來比較模型在哪些環節失手,亦提醒研究團隊不要把路徑精度、程式碼執行成功或單一步驟操作,直接當成完整任務能力。項目提供線上結果、案例影片、資料集及程式碼。
項目主頁 · GitHub · 數據集

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, AI productions, 世界模型, Qwen, DeepSeek, Gemini, API, VLA, Robotic, 框架, 香港, Anthropic, Dataset 數據集

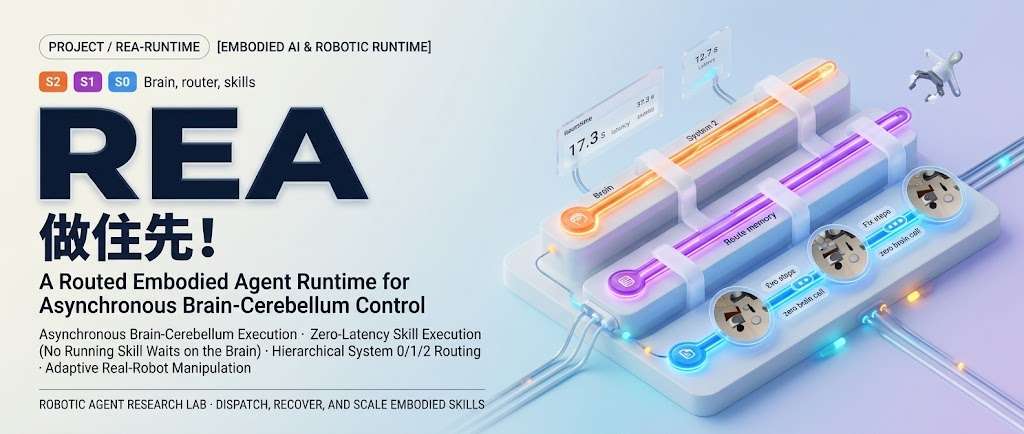
REA:讓機械人執行動作時不必等待 AI 思考

機械人控制常要在慢速推理與即時動作之間取捨,REA 透過路由與復原機制,讓執行中的控制政策不必停下來等候大腦回應。

Og image

機械人執行動作時,若每一步都要等 AI 完成較慢的推理,控制就可能停頓。REA(Routed Embodied Agent Runtime)是為具身智能代理設計的執行框架,讓負責推理的「大腦」與快速控制的「小腦」非同步協作,並在需要時路由任務或復原執行流程。

這種安排適合需要連續動作、同時又要處理複雜指令的機械人工作流。REA 可協調 VLA(Vision-Language-Action)模型與程式控制政策,讓系統按任務選用不同控制方式;推理延遲不會直接令正在執行的控制政策停下來。

評測結果包括:在 3,000 個 LIBERO-Pro 測試回合中取得 95.9%,控制步數減少 25%;在 RoboTwin 2.0 中,結合 VLA 與程式政策取得 86%。頁面亦稱,REA 在 BEHAVIOR-1K 與真實 Unitree G1 測試中解決的回合數最多,但沒有提供這兩項測試的具體數字。

  • 推理與快速控制非同步進行,執行中的政策毋須等待大腦回應。
  • 透過路由與復原機制,協調不同類型的控制政策。
  • RoboTwin 2.0 評測結合 VLA 與程式政策,結果為 86%。
  • 項目頁需啟用 JavaScript 才能查看互動圖表;提供的內容沒有安裝或下載步驟。

REA 適合研究機械人長流程任務、異質控制政策協作,以及推理延遲如何影響動作連續性的團隊。現有內容提供多項基準測試結果,但未列出各項實驗設定與比較基線,閱讀數字時仍需留意這些資訊限制。

項目主頁 · 模型

Categories: Agentic, 模型, 視覺模型, 多模態模型, VLA, Robotic, 框架, Discord

System 1+2:AGI 也要先估互動價值再花算力

多想幾步、多試幾次,都有成本。研究構想讓 AI 先估計哪些互動有價值,再投入資源執行。

Hero image preview

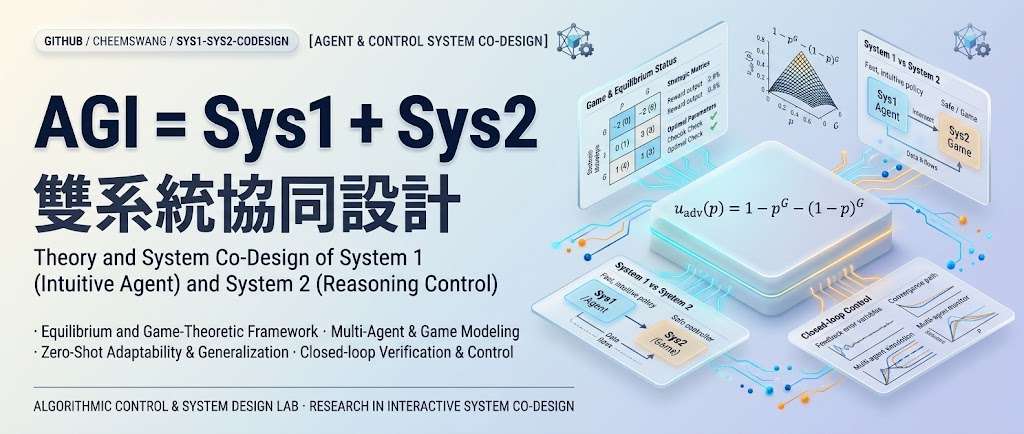
AI 代理搜尋資料、執行程式或讓機械人試走一步,都要付出成本,卻未必帶來有用結果。清華大學團隊提出 System-1/System-2 協同設計構想,希望在執行前先篩選值得投入的互動。

成本較低的 System-1 按預期價值排列互動的優先次序,再由成本較高的 System-2 執行較困難的工作。這個構想把資源分配提前,讓增加推理、訓練或探索次數之前,多一道價值判斷。

它涵蓋的場景包括:

  • 語言模型推理:判斷哪些推理步驟值得繼續投入。
  • AI 代理:篩選搜尋、程式執行及應用程式介面(Application Programming Interface,API)呼叫。
  • 機械人與強化學習(Reinforcement Learning,RL):優先探索可能提供學習訊號的經驗。

對互動成本高、數據取得慢的研究與開發工作,這個構想提供了分配預算的思路。不過,所提供節錄未交代價值預測器的具體實作或量化結果,仍未能判斷它能節省多少成本,以及會否錯過有用的探索。

項目主頁 · Paper

Categories: 清華大學, Agentic, 模型, 模型訓練, API, World-Action Model, Robotic, 框架, 軟件, 編程, AGI, 強化學習

ScaleNav 把影片變成導航能力

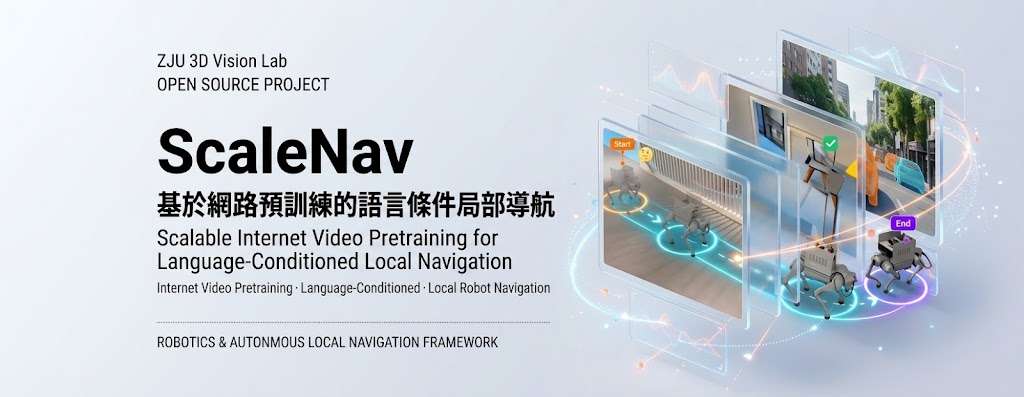
ScaleNav 先從互聯網第一視角影片學習路徑規律,再轉成機器人動作,面對語言指定目標的局部導航。

ScaleNav navigation: real robot on the left, simulation on the right

網上第一視角影片 seldom 附帶機器人動作,但當中蘊藏大量「沿走廊前進、避開障礙、轉入目標房間」的視覺規律。ScaleNav 是一個研究型導航模型,試圖把這些 action-free 預訓練所得到的 navigation priors,轉移到有動作標籤的模擬軌跡,再用於 language-conditioned local navigation:按文字尋找初始畫面可見的目標並停下來。

模型屬共享式 Diffusion Transformer,會根據指令、目前 RGB 影像及記憶,共同預測未來 video latents 和 action chunks。流程分三階段:先從互聯網第一視角影片學習目標導向視覺動態,再進行 action alignment,最後 joint fine-tuning,同時保留影片回放並微調共享骨干與輸出頭。

ScaleNav 與同類做法的主要取捨,是毋須先收集大量完整機器人示範,便能借助互聯網影片建立導航先驗;代價是仍要依賴模擬軌跡、動作對齊及多階段訓練。官方模型約 10.02 GB,推論及評估建議使用支援 BF16 的 NVIDIA GPU、24 GB GPU 記憶體與 64 GB 系統記憶體,並按文件配置 Linux、Habitat-GS 和場景轉換工具。

結果涵蓋 HabitatGS-LN、Short-Horizon OVON 與真實四足機械人;公開資料列出 ScaleNav 在兩項模擬評估的成功率分別為 94.9% 及 86.5%,真實機械人則在 60 次試驗中錄得 83.3% 成功率。團隊亦整理 gallery 導航影片、軌跡、目標與結果,以及 summary.json 內的 SR、SPL 和逐任務成績,方便比較與重現。

  • 影片預訓練不必附帶逐格動作標籤
  • 同一模型處理影片動態與動作生成
  • 支援模擬環境及真實四足機械人
  • 提供模型、資料、評估結果與操作文件

這套方法較適合研究 embodied navigation、 robotics 與 VLA(Vision-Language-Action)的團隊;評估數字雖亮眼,仍須留意各方法採用不同設定,跨模型比較應同時核對 episode 數、場景及 fine-tuning 條件。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視覺模型, 多模態模型, 模型訓練, NVIDIA, Video, Image, VLA, Robotic, 工具, Linux

GroundingPI 以 4B 視覺基礎模型連接感知與機械控制

GroundingPI 把視覺定位轉成可供機械系統使用的點和框,主打複雜場景下的精準感知與控制效率。

GroundingPI

要讓自動駕駛或機械人準確知道「要處理哪件物件、位置在哪裏」,單靠一般視覺語言模型仍可能在雜亂畫面和細小物件上失準。GroundingPI 屬於視覺 grounding foundation model,以 4B 參數模型處理定位問題,輸出可供後續控制使用的視覺結構。

模型以 visual primitives 為核心,將點和框表示成 shared vocabulary 中的 quantized coordinates,再配合 vision-language model、tokenizer、processor 和 custom model code。這種做法針對 VLA(vision-language-action)及 WAM(world-action models)常見的感知瓶頸,並讓 perceptual foundation 可以轉移到 autonomous driving 和 robotic manipulation。

  • 定位方式:同時支援點與框,適合指定目標及描述空間位置。
  • 模型規模:4B 參數,目標是在能力與運算成本之間取得平衡。
  • 評測結果:涵蓋 34 個 grounding benchmarks、11 種感知能力,對比 44 個基準模型平均達 73.68%,高於 GPT-6 Astra 的 71.54%。
  • 轉移價值:在 ID 和 OOD 評估,以及 action-data efficiency 方面,展示對自動駕駛和機械人操作的幫助。

對研究團隊而言,GroundingPI 不只是單次定位模型,亦可作為 System-1 foundation-model 的感知層,補足未必擅長精準 grounding 的通用視覺模型。項目提供 Hugging Face 模型及 Demo,並列出 vLLM、Transformers backend、OpenAI-compatible API 和 JSONL batch annotation 工作流;不過提供的儲存庫資料未交代完整硬件需求,部署前仍需按文件確認環境。

研究重點同時放在 pretraining scale 和 data composition 如何影響 grounding 及轉移效果。需要即時視覺定位、閉環控制或希望減少 action data 的自動駕駛、機械人及 embodied AI 團隊,會較容易從這個模型的感知能力受益;純文字或一般影像分類工作則未必能直接發揮其價值。

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 香港科技大學, 北京大學, 清華大學, 模型, 視覺模型, 多模態模型, 模型訓練, API, Image, VLA, World-Action Model, Robotic, 香港, 庫, Tokenize

UniWAM 把理解、預測與機械人動作合而為一

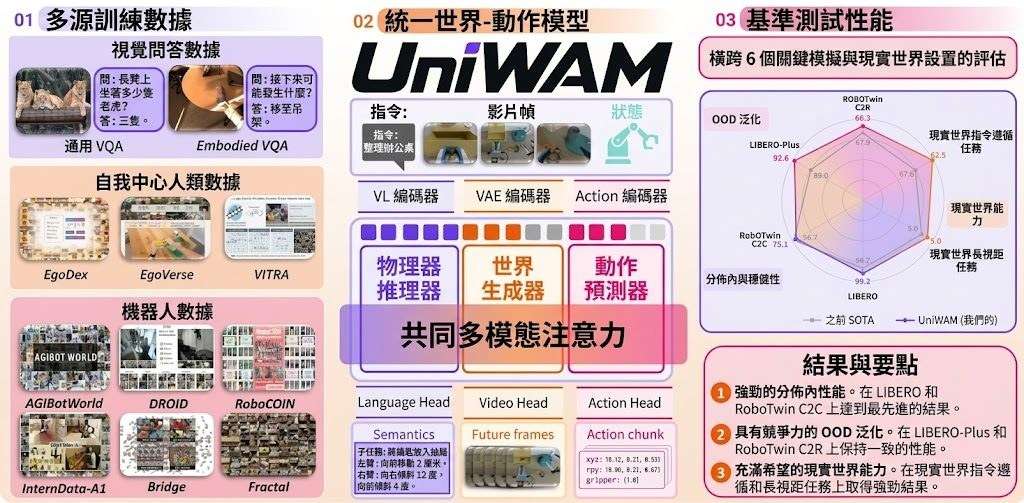
UniWAM 以 8B 參數模型整合語意理解、視覺預測和動作生成,瞄準機械人操作中理解與執行脫節的問題。

UniWAM teaser

面對需要理解指令、預測環境變化再控制機械人的任務,UniWAM 將三個步驟放進同一個 8B-parameter 模型,屬於結合世界模型與 Vision-Language-Action(VLA)的開源研究項目。它以 Mixture-of-Transformers(MoT)連接 physical reasoner、world generator 和 action predictor,讓三者透過 joint multimodal attention 交換資訊。

模型不只依賴機械人示範,預訓練亦混合 human egocentric data、robot data 及 visual question answering(VQA)資料,並把低層動作轉成自然語言,改善視覺語言能力與實體操作之間的銜接。Post-training 再加入 future visual noise augmentation,配合 history-conditioned flow matching,以較少 denoising steps 生成動作。

  • 整合範圍: 同時處理 physical reasoning、視覺生成與動作預測
  • 訓練訊號: 結合機械人、第一身人類視角及 VQA 資料
  • 效率設計: 用動作歷史初始化生成流程,減少 denoising steps
  • 硬件成本: RoboTwin 2.0 post-training 曾以 8 張 NVIDIA H100 GPU 執行 10 小時

GitHub 儲存庫提供 models/、train/ 和 utils/ 等模型與訓練程式,並附有 RoboTwin 2.0、LIBERO 及 LIBERO-plus 的資料處理和評估工具。Python 3.10、CUDA 兼容的 PyTorch 環境較適合測試,使用者可先以模擬器資料和配置檔驗證訓練或推理流程。

項目首頁宣稱 UniWAM 在 in-distribution、robustness、generalization 及 instruction following 等多項評估取得 SOTA,但儲存庫提供的資訊未列出完整分數和比較表。Bridge、DROID、Fractal 以及 real-world inference 明確不在今次發布範圍內,因此它較適合研究團隊測試統一式機械人模型,而不是即時接駁真實機械人的現成方案。

項目主頁 · GitHub · 項目

Categories: 開源, 香港科技大學, 北京大學, 模型, 視覺模型, 多模態模型, 世界模型, 模型訓練, NVIDIA, VLA, Robotic, 香港, 工具, Python, 庫, Dataset 數據集

RobotWorld:把多模態智能體放進機械人世界測試

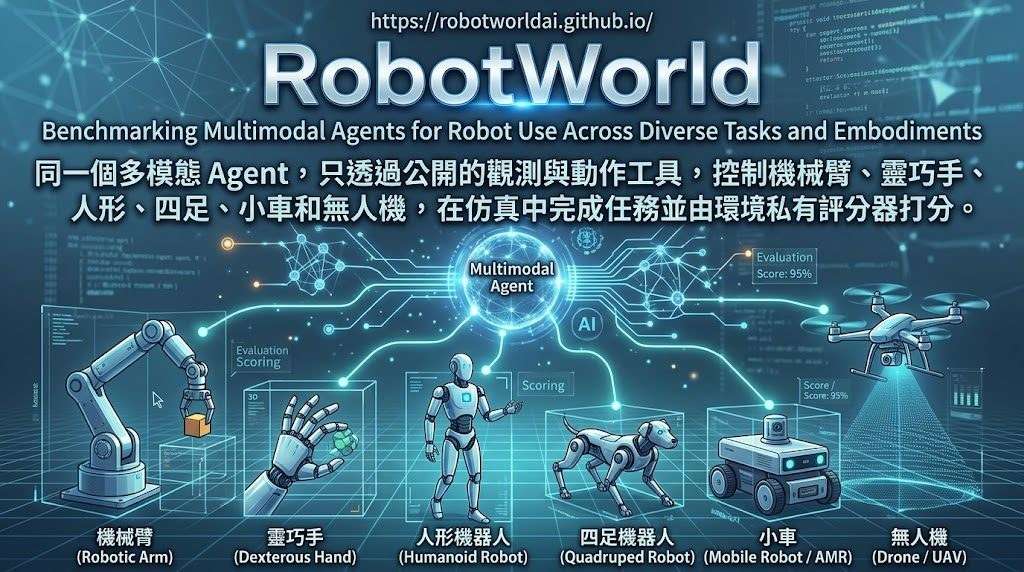
想比較多模態模型控制不同機械人的能力,RobotWorld 提供 84 項模擬任務及隱藏評測。

Watch RobotWorld in 45 seconds

想測試模型能否由影像和狀態資訊控制機械人,而不只是回答完成任務,RobotWorld 提供一套跨模擬器的機械人基準測試項目。它屬於具身智能體評測框架,讓多模態代理透過觀察與動作介面控制機械臂、靈巧手、人形機械人、四足機械人、汽車及無人機,處理 84 項任務和 20 個 benchmark integrations。

代理只能讀取允許的相機影像、關節及任務狀態,再發出受限制的控制指令;環境會回傳執行收據和新觀察,讓代理修正下一步。任務結果由代理看不到的 hidden evaluators 判定,避免模型自行聲稱成功而取代環境驗證,亦能揭示物件狀態遺失、子目標停滯和錯誤完成判斷等失敗原因。

  • 評測方式:預設每項任務進行三次 rollout,並停用 environment-side code control。
  • 涵蓋範圍:由 manipulation、locomotion 延伸至 driving 和 flight。
  • 執行流程:需要還原 source、準備指定 assets、建立 Docker images、編譯 runtime,以及設定模型 API credentials。
  • 限制:已註冊任務不代表全部都有已驗證的成功軌跡,部分依賴和受限制資料集仍需另行取得。

相比只測文字答案或單一機械人的方法,RobotWorld 把模型推理、感知、控制和環境回饋放入同一條閉環,較適合研究團隊比較不同多模態模型、重現評測流程,或為新任務和新 embodiment 擴充測試。代價是安裝和資源準備較複雜,結果亦會受模擬器、模型設定及每項任務預算影響。

項目主頁 · GitHub

Categories: 開源, 模型, 多模態模型, API, Image, World-Action Model, Robotic, 框架, Anthropic, Dataset 數據集

MiniCorp 以模擬企業填補 AGI 代理數據缺口

企業代理要學識做決策,欠缺的往往不是模型,而是真實、連續又可重演的商業數據。MiniCorp 嘗試用虛擬公司補上這個缺口。

The MiniCorp simulation core

企業代理要處理日常工作、作出商業決策,卻難以取得足夠真實而且可長期追蹤的企業資料。MiniCorp 以 Office Simulators for Enterprise AGI 為核心,建立可讓 autonomous enterprise agents 運作的高擬真虛擬公司環境,藉此研究 AI 管理企業的方式。

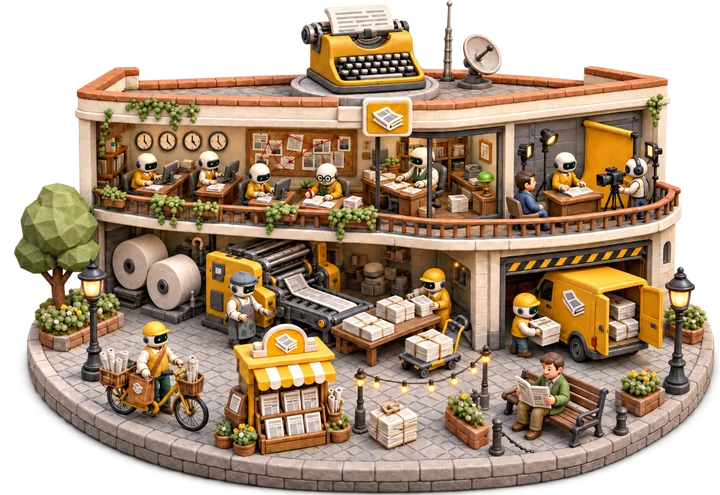
這些模擬公司涵蓋醫院、航空公司、對沖基金、報紙、電子商貿及高科技企業等場景。代理可以在連續運作的環境中執行工作,研究團隊亦能生成 longitudinal enterprise data,以及比較不同決策後果的 counterfactual enterprise data,減少依賴受私隱限制、價格昂貴或需要專家標註的真實企業檔案。

MiniCorp 處理虛擬企業讓研究者重播情境、改變決策條件,再觀察代理長期表現,適合用於訓練、測試及分析企業級 AI agent。

目前項目提供研究資料、GitHub、arXiv 及 Hugging Face 入口,互動示範仍標示為準備中。使用者可先把它理解成研究企業代理的模擬場,而不是可直接接管真實公司的現成產品。

  • 建立醫院、航空、金融及電子商貿等企業場景
  • 產生可長期追蹤的企業運作數據
  • 支援反事實決策比較與代理研究
  • 針對企業級 autonomous agents 的訓練和測試
  • 互動 Demo 尚未正式推出

項目主頁

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, World-Action Model, Robotic, 安全, AGI

RealtimeWAM 讓世界動作模型走向即時生成

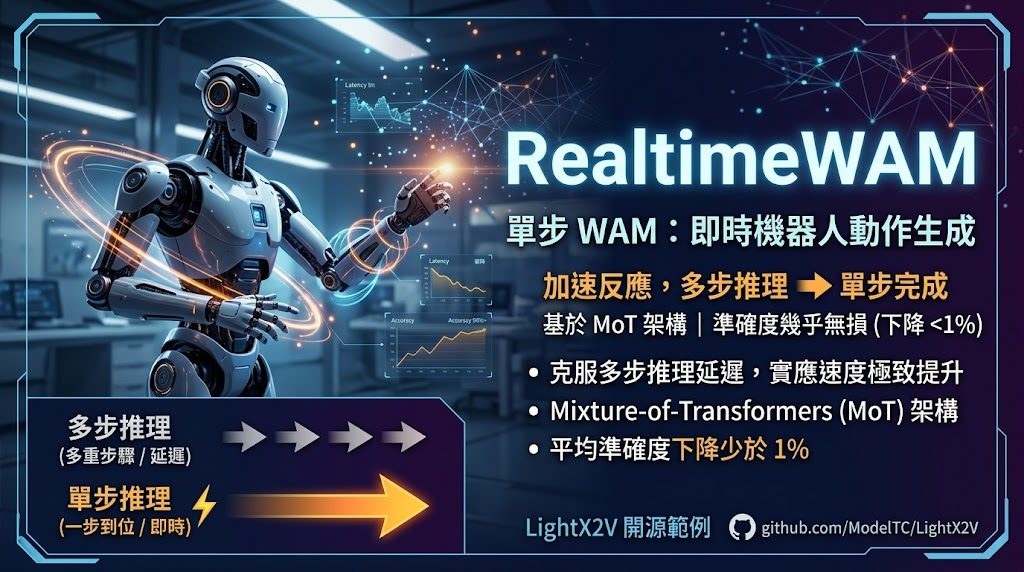
LightX2V 的 RealtimeWAM 以單步生成降低延遲,嘗試保留多步模型的表現,讓機械人動作反應更接近即時。

Og image

機械人需要根據畫面快速產生下一個動作時,多步推理帶來的延遲會直接影響反應速度。LightX2V 的 RealtimeWAM 範例針對這個取捨,提供面向即時推理的 World Action Models (WAM) 方法,將動作生成壓縮至單步完成。

RealtimeWAM 建立在 Mixture-of-Transformers (MoT) 架構的 WAM 之上,主張在減少推理步驟的同時,盡量維持原有模型的準確度。項目 README 將它描述為首個單步 WAM,並指出相較多步版本,跨多個基準測試的平均準確度下降少於 1%。

項目列出的測試包括 RoboTwin 2.0 和 LIBERO,涵蓋機械人操作相關場景。這代表它較適合需要低延遲動作決策的研究者、機械人控制工作流,以及希望在既有 MoT-based WAM 架構上探索即時生成的開發者;不過,實際效果仍會受模型、硬件和測試任務影響。

  • 單步生成,降低多步推理造成的延遲
  • 兼容以 Mixture-of-Transformers 為基礎的 WAM 架構
  • README 聲稱平均準確度下降少於 1%
  • 提供 RoboTwin 2.0 和 LIBERO 等評估參考
  • 以 LightX2V 框架形式呈現即時 WAM 範例

項目主頁

Categories: 開源, Agentic, MCP, 模型, 世界模型, World-Action Model, Robotic, 框架, 安全, Skill 技能

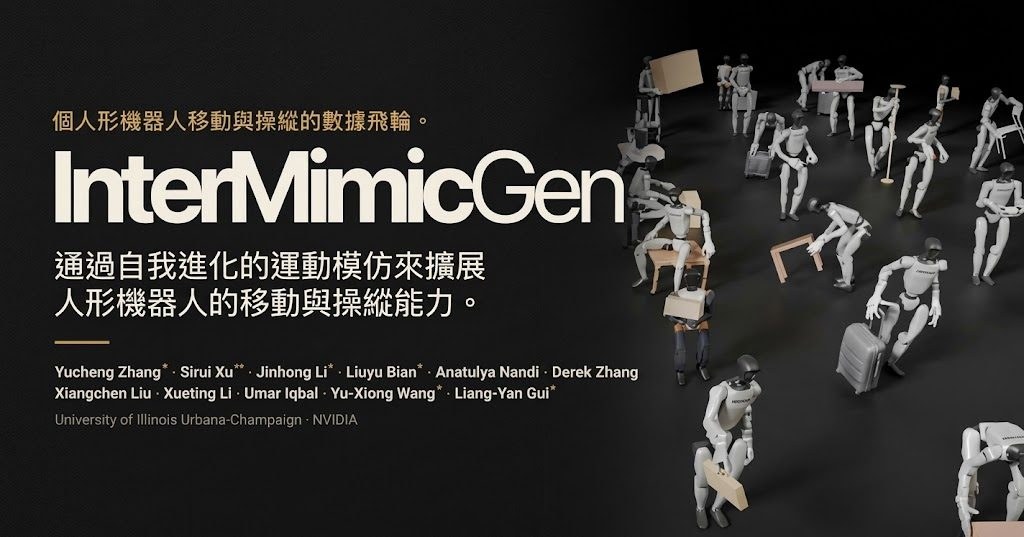
InterMimicGen 讓一段示範變成多種機械人動作

InterMimicGen 把人類互動示範轉化成不同人形機械人的動作,並透過實體執行持續擴充數據。

Og image

一段人類與物件互動的示範,經過 InterMimicGen 可以轉化成多種人形機械人的行走、抓取和操作動作。這個研究項目針對不同機械人身體結構難以直接套用同一動作的問題,連接動作重定向、追蹤、演化和實體部署流程。

系統結合 MimicGen 的動作擴展方式與 InterMimic 的物理落地能力,先把示範調整至不同物件和機械人配置,再由真實機械人執行。每次成功完成的動作都會成為新數據,支援下一輪生成,形成持續增長的數據循環。

• 跨物件重定向,例如行李箱和大型箱子
• 支援 Unitree G1、Dexmate Vega、Booster K1 等平台
• 涵蓋雙手操作、抓取及不同手部配置
• 透過多輪局部修改,逐步擴大動作範圍

研究展示了 Unitree G1 配合 Inspire hands、橡膠手,以及 Dex3 等組合的實體執行案例,也測試大型梳化、三腳架和球拍等不同物件。內容未有提供統一的量化性能指標,成果主要以跨平台動作轉移和連續實體執行作展示。

這個項目較適合研究人形機械人模仿學習、動作重定向和資料生成的團隊。它的價值在於減少每個機械人配置都要重新收集示範的需要,但動作是否成功仍取決於機械人的硬件、手部形態和現場環境。

項目主頁 · Paper

Categories: NVIDIA, Robotic

Page 1 of 10
1 2 3 … 10