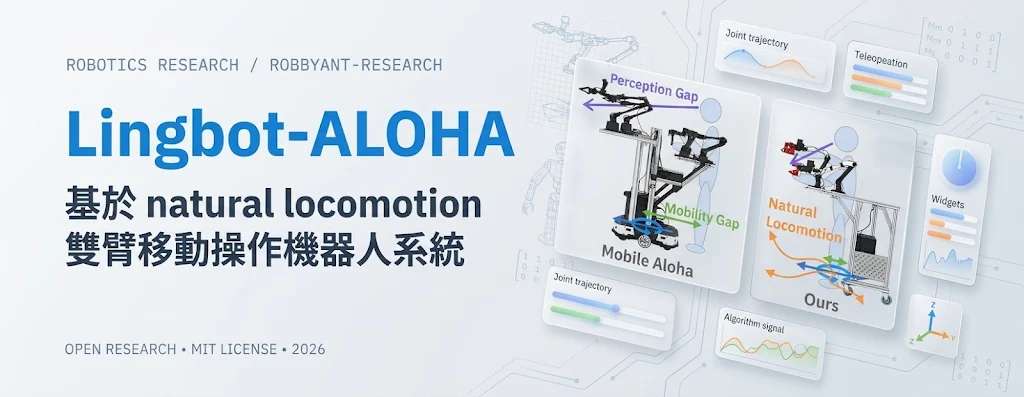
LingBot ALOHA:讓動作預測接續執行中的指令

把上一段動作帶入下一次預測,有助安排連續控制;但重疊動作可能重播,接駁機械人仍要處理交接。

Repository image for robbyant-research/Lingbot-ALOHA

讓機械人執行動作期間,同時準備下一段指令,是 LingBot ALOHA 最有辨識度的能力。這套基於 OpenPI、為 Mobile ALOHA 改編的策略訓練與推論程式碼,將 Real-Time Chunking(RTC)的 prefix conditioning 接到 JAX π₀.₅ 模型,並支援合併多個 LeRobot datasets 訓練,適合已有機械人資料和控制系統的研究團隊。

RTC 會把上一段預測中的部分動作,放到下一段預測開頭作為參考,讓模型接着已有計劃往下生成。訓練時,開頭保留不加噪音的動作,後段才加入噪音並計算 flow-matching loss;開頭只提供條件,不計入損失。這把「接續動作」納入訓練過程,但項目文件描述的支援限於 JAX π₀.₅,未證明 PyTorch 路徑具備等效能力。

執行端的 RTCActionChunkBroker 每次回傳一個 action,並在舊動作段仍在執行時,非同步要求新預測。交接未必無縫:切換時會從新動作段的 index 0 開始,沒有跳過已用作條件的 prefix,因此重疊期間執行過的動作可能重播。對需要連續移動或精確協調的任務,團隊應先檢查交接位置的指令序列;文件沒有提供足以量化這個問題影響的測試結果。

多資料集訓練則把資料整理方式直接變成訓練取捨:MultiVLADataset 將影格串成共同索引,再打亂抽樣,沒有獨立的 dataset-weight 參數,也不會自動平衡來源。項目文件的例子中,A 有 10,000 個影格、B 有 30,000 個影格,預期混合比例約為 25% A、75% B。較小資料集即使包含重要任務,也不會因此獲得更多抽樣機會,資料量本身便影響模型接觸各類示範的頻率。

能夠串接資料,不代表能直接混用不同機械人的紀錄。各資料集的 feature dimensions、camera conventions、action ordering、units 和 task meanings 必須一致,否則相同欄位可能代表不同動作或觀察,串接流程不會替團隊調和差異。這令它較適合同一套機械人規格下累積的多批資料;跨硬件整合仍須先處理資料定義,不能單靠增加路徑完成。

  • RTC 把前一段預測帶入下一段,將動作接續納入模型條件。
  • 非同步取得新預測可與舊動作執行重疊,但交接可能重播動作。
  • 多資料集按影格量參與抽樣,來源比例需要自行管理。
  • 資料欄位、單位及動作含義須一致,合併不會自動完成對齊。
  • 發布內容只有 source code,資料與模型資產均須另外準備。

要驗證這套流程,團隊須自行提供 datasets、pretrained weights 和 trained checkpoints,不能下載後便直接重現已訓練策略。訓練配置需要 π₀.₅ 初始 parameters 及 tokenizer assets,也可改用本地 parameters 目錄。合理的試驗順序是先核對資料定義及抽樣比例,再測試新舊動作段交接,避免把資料混合問題與控制時序問題混在一起判斷。

執行環境支援 Ubuntu 22.04 與 NVIDIA Graphics Processing Unit(GPU),依賴透過 uv 管理,定義保存在 pyproject.toml 和 uv.lock。上游列出的 full fine-tuning 單 GPU 記憶體需求約為 70 GB,而 RTC 範例正是採用 full fine-tuning;這只能作資源規劃參考,實際用量仍取決於配置,不能視為本項目的實測要求。
項目主頁 · GitHub

Categories: 開源, 香港科技大學, 模型, 多模態模型, 模型訓練, NVIDIA, 香港, Linux, Python, Dataset 數據集, Tokenize

Pinky:讓 AI 操作手機而風險審批留在你手上

Pinky 是一個手機操作工具與 MCP 伺服器,讓 AI Agent 真正點擊 iPhone 或 Android,同時把付款、刪除等高風險決定交回用戶審批。

pinky macos 1024

讓 AI 替你點開手機 App、下單、回覆訊息,真正難處不在模型識字,而在誰有權按下最後一按。Pinky 是一款原生桌面工具兼 MCP(Model Context Protocol)伺服器,透過電腦連接 iPhone 與 Android,讓 Claude Code、Claude Desktop、Codex、Cursor 或自訂 Agent 操作真實手機;手機端另有原生 App,選用模型後可脫離電腦執行。

它取捨明確:Agent 可以行動,但安全規則由 Pinky 的 gateway 執行,不靠提示詞要求模型「小心」。付款、交易、轉帳預設等待確認,發送訊息、下單、刪除、致電、安裝、外部連結與系統設定亦可納入審批。銀行、錢包及密碼管理 App 預設不可見,密碼及一次性驗證碼欄位禁止輸入,避免 Agent 自行取得敏感資料。

  • 連接方式:支援 macOS、Windows、Linux,可控制 Android 10 至 17 及 iOS 17.4 以上裝置
  • 接入模型:涵蓋 DeepSeek、Qwen、Kimi、GLM、Claude、GPT、Gemini,以及 Ollama 或 LM Studio 的本地模型
  • 運行方式:可從電腦操作,也能在手機 App 內直接安排任務或定時執行
  • 安全邊界:每個新 Agent 都要獲批准,並只取得你授權的範圍
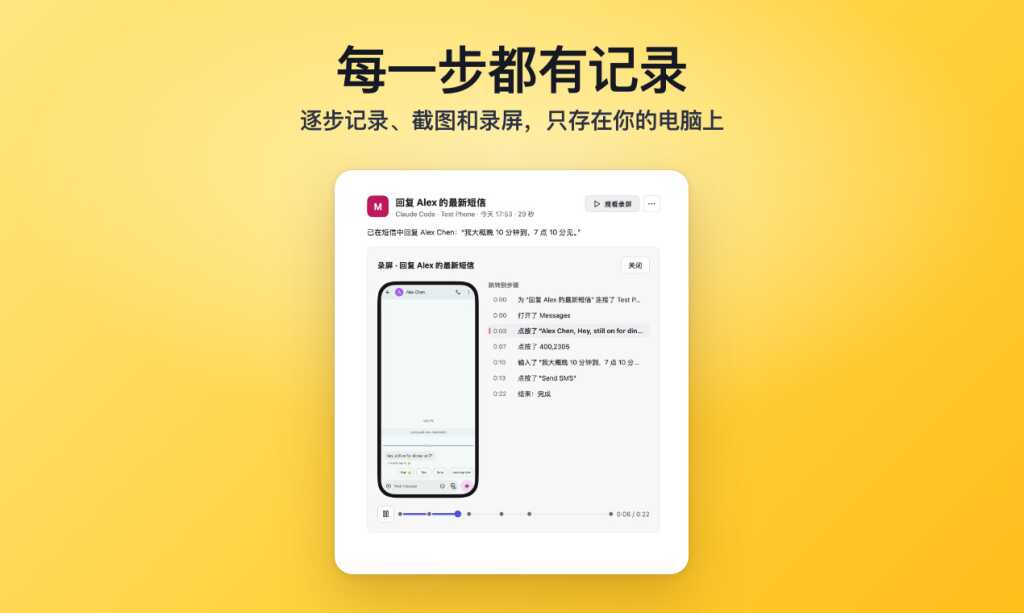
  • 稽核紀錄:保留逐步說明、截圖及螢幕錄影,並可輸出 HTML 報告

與單靠 Agent 自身安全提示的做法相比,Pinky 把審批放在控制層,而非寄望模型每次都聽話。代價是首次設定需要配置裝置、Agent 與權限;iOS 17.4 至 26 要從 Mac 以 Xcode 安裝手機端程式。iPhone 與較舊 Android 仍使用主螢幕,Android 13 以上則可讓 Agent 在隱藏第二屏操作,減少打斷。

原生視窗由 MyGo 在 GPU 上繪製,沒有 Electron 或 WebView,Mac 版下載約 16 至 22 MB,閒置時約佔 70 MB 記憶體及 0% CPU。桌面版可從官方發行頁下載;手機控制功能需要手機與電腦配對。想做跨裝置自動化、研究手機 Agent,或需要保留人工確認與完整操作紀錄的團隊,會較容易感受到它的價值。

GitHub

Categories: 開源, Agentic, MCP, 模型, Qwen, DeepSeek, Gemini, 提示詞, 工具, IDE, Mac, Linux, Ollama, 安全, Anthropic, Kimi

OpenFilm:讓編碼代理直接製作可編輯影片

OpenFilm 把影片變成網頁時間線,讓 Codex、Claude Code 等代理先製作,再由人在瀏覽器編輯器中修改。

OpenFilm

一部片由代理生成,之後仍要逐項執剪、改字、調音量,往往是 AI 影片工作流最難銜接的一步。OpenFilm 是一套開源 AI 影片工具與框架,將生成、檢查和後製放進同一個瀏覽器工作環境,並讓影片保留為可繼續編輯的網頁項目。

OpenFilm 透過現代化技術棧與開源精神,為影視團隊帶來了以下核心價值:

  • 全方位的專案生命週期管理: 從專案立項、任務分配、進度追蹤到資產歸檔,OpenFilm 提供了一站式的管理介面,讓製片人、導演與技術人員能在同一個資訊源(Single Source of Truth)上高效運作。
  • 無縫的影音資產協同: 支援高效的媒體預覽、線上審片與時間軸標記回饋,讓團隊成員與客戶可以直接在影格(Frame)上進行精準溝通,告別模糊不清的文字描述。
  • 資料自主與開源自由(Open Source & Self-Hostable): 採用開源授權,團隊可以完全掌控自己的核心智慧財產權與高畫質素材資料,不必擔心雲端服務商的隱私侵犯或無預警的訂閱費調漲。

它為每個鏡頭成為一個 frame(t) ,按時間繪畫畫面;影片、圖片、聲音和文字則放在 film.html 的時間線上。代理可運用 HTML、CSS、Canvas、SVG、WebGL、Three.js、GSAP 及現有影片上面建立內容。

  • 一個 HTML 檔案整合動畫、片段、圖片和聲音,CSS 負責樣式與版面。
  • 一個 frame(t) 函式負責每個鏡頭,以支援亂序及並行算圖。
  • Studio 在瀏覽器提供時間線剪輯,可移動、縮放、旋轉物件,亦可裁剪片段、修改文字、色彩、字幕、速度和音量。
  • Canvas 協助整理分鏡、素材、旁白與音樂,再按次序送入時間線。
  • 匯出涵蓋 MP4、GIF、聲音、字幕、靜態圖、透明影片,以及 Final Cut Pro、Premiere Pro 和 DaVinci Resolve 時間線。

透過編碼代理使用內建 CLI 開啟 Studio、檢查畫面和輸出影片。環境需要 Node.js、ffmpeg 與 Git,首次執行會下載約 100MB 的 headless Chromium;macOS、Windows 和 Linux 桌面版已包括 ffmpeg 與瀏覽器。生成語音、音樂、圖片和影片時,可在 Studio 連接 ElevenLabs、OpenAI、Google、OpenRouter 及 fal,並使用自己的 API key。

適合需要快速製作產品示範、社交媒體短片、動態簡報或教學片段,並希望保留人手修改能力的開發者、內容團隊與代理工作流研究者。

GitHub

Categories: 開源, AI productions, 模型, Google, OpenAI, API, Video, Image, Audio, 框架, 教學, 軟件, 工具, Mac, Linux, Python, 語音, Anthropic, 動畫, 音樂, Skill 技能

OpenMausBot:比 GrokBot 更強的工作團隊

OpenMausBot 把 Claude、Codex 或 Grok CLI 接入聊天介面,讓每個 AI 代理擁有自己的角色、工作環境與權限審批。

Boat (boat.dev)

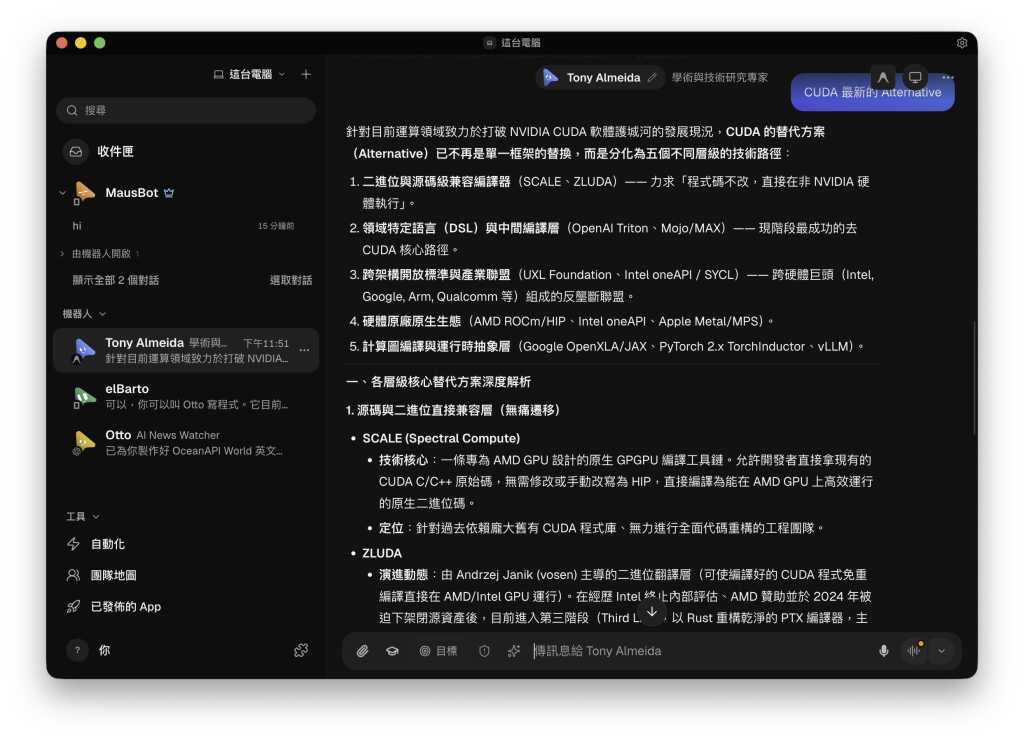
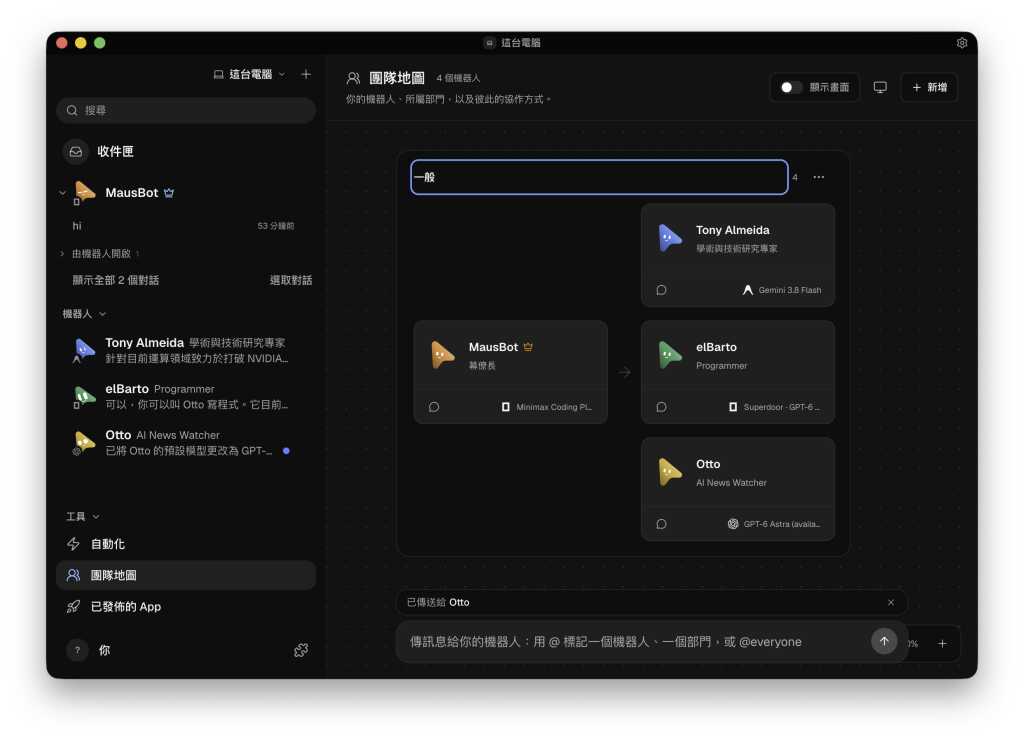
把多個 AI 代理放進同一個聊天視窗,最容易出現的問題不是模型不夠強,而是誰負責哪件事、可以動到哪些檔案,以及哪些操作必須先讓人批准。OpenMausBot 是一個開源桌面工具,正好把代理團隊、執行環境和人工確認串在一起。

它採用 local-first 架構,由一個綁定 127.0.0.1 的輕量 harness server 管理本機上的代理程序;聊天紀錄與金鑰留在自己的電腦。每個 bot 可以選擇 DeepSeek Harness、Claude、Codex 或 Grok CLI,配置不同模型、個性與工作目錄,像管理一群同事般分配任務。

  • 每個 bot 都是獨立代理,而非單一模型的聊天分頁
  • 代理可使用雲端 Linux desktop、隔離的 Local VM,或按平台支援的環境執行工作
  • 支援連接應用程式,並由使用者審批重要操作
  • 提供 React 19、Electron、TypeScript 桌面介面,涵蓋 macOS、Windows 與 Ubuntu

與直接使用 CLI 相比,OpenMausBot 增加的是聊天入口、代理分工、工作環境和權限控制;與雲端協作代理相比,它保留較高的資料控制權,代價是要自行處理 CLI 安裝、登入、API 費用及本機環境設定。官方沒有提供統一的模型跑分,因此較適合以任務完成率、操作審批流程和實際檔案需求來評估。

這個工具特別適合需要多個 AI 角色並行處理資料、研究、文件和程式工作的個人或團隊。Claude、Codex 與 Grok 是可選的 agent engines,並非 OpenMausBot 自行訓練的模型;先安裝桌面程式,再按引導連接其中一種引擎,便能由單一代理逐步建立代理團隊。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, Google, OpenAI, DeepSeek, API, 工具, Mac, Linux, Anthropic

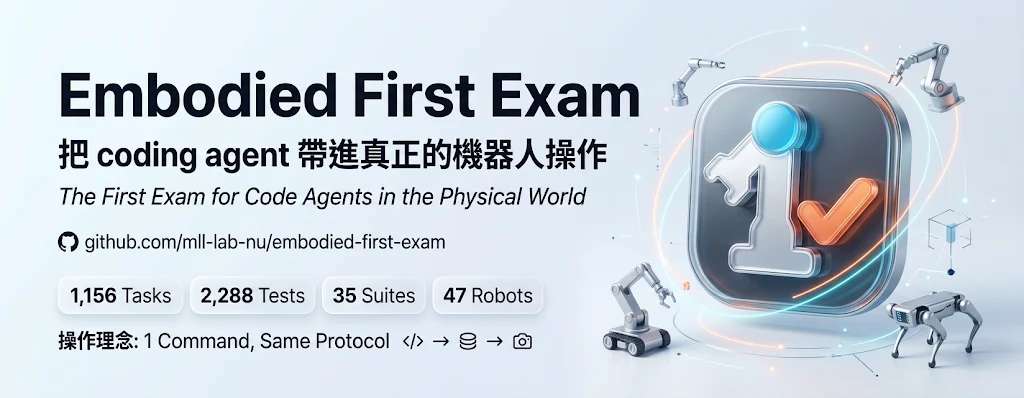
Embodied First Exam:機器人是否真正理解任務?

這是一套針對具身智能程式代理的統一測試框架,以程式作答,再重播機器人片段評分。

logo

Embodied First Exam 把 coding agent 帶進真正的機器人操作題:代理在凍結場景中編寫並執行程式,觀察機械臂或身體控制器的反應,再按結果修正。它屬於 benchmark(評測基準)與統一框架,專門檢查程式代理能否把抽象指令轉成可運行的物理動作。

與只比較最終成功率的一次性測試不同,這套方法保留執行程式及場景重播,讓研究人員能分辨模型是真正理解任務,還是碰巧得到滿意結果。框架涵蓋 RoboPaint、RoboARC、RoboDynamicExam 等九個原創 suite,亦接納多個既有機器人與具身 benchmark,著重增加任務多樣性。

測試可分成三個層次:
– 以 RoboPaint、RoboARC 等任務檢視操作能力。
– 以 Embodied Olympics、KinDER、MuJoCo Playground 等涵蓋動態與控制。
– 以 Embodied Safety Exam 等檢查安全表現。

代價是測試環境相當厚重:需要 Linux、Docker、模型 API 權杖,部分 suite 要 NVIDIA GPU;RTX 級別顯示卡與 A100、H100 的支援安排不同,首次拉取映像亦可能佔用 1 至 30 GB。GPU 亦不是每項任務都需要,部分 suite 可在無 GPU 環境執行。

這套框架較適合具身智能研究團隊、agent 開發者,以及需要重現操作失敗原因的工程師。它提供的是可審核的考試環境,而非單一最佳模型;真正有用的成果,是讓不同 coding agent 接受相同物理任務、程式與重播式評分。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, NVIDIA, API, 框架, Vibe Coding, Linux, 編程, 安全

Tree-Ising:告別昂貴的 Agent 權重維修

模型反覆推理卻走不出迴圈,未必需要大幅重訓。Tree-Ising 嘗試直接挑選少量權重修改,降低修補成本。

Repository image for TheQuantumGOAT/Tree-Ising

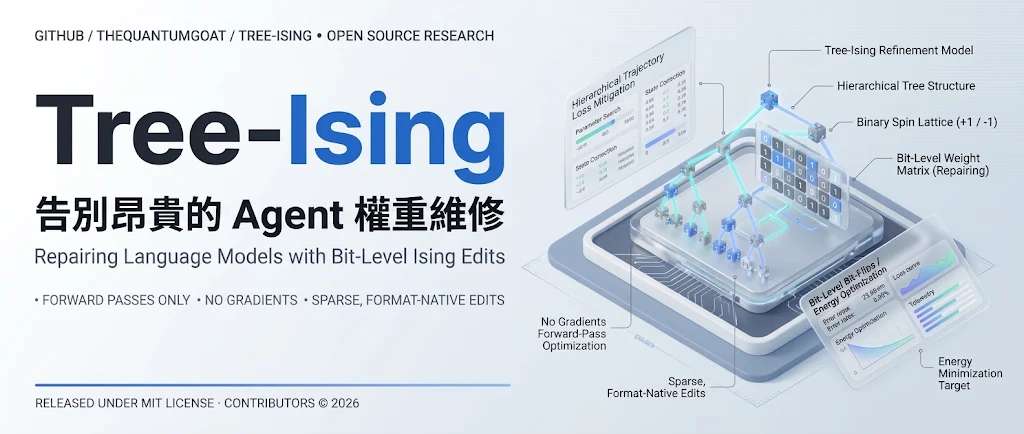
Tree-Ising 是修補語言模型推理迴圈的研究工具。作者以需要大量互動與生成的代理改權重流程作對照,改用模型運算統計挑選修改位置,減少搜尋開支。

方法沿用 state trees,把權重視為離散決策路徑;只對 Brain Floating Point 16(BF16)權重作少量正負號翻轉及二的冪次縮放,再以 forward pass 統計,為每個輸出列建立 Quadratic Unconstrained Binary Optimization(QUBO)問題。

專案核心機制:樹狀伊辛自旋晶格(Tree-structured Ising Spin Lattice)、位元級量化權重矩陣(Bit-level Quantized Weights)、正向傳播無梯度修復(Forward passes only / No gradients)與稀疏編輯(Sparse format-native edits)

  • 提供 simulated annealing 與 simulated bifurcation 求解。
  • 作者報告 Qwen3.5-0.8B 的 MATH-500 成績為 54.6%,對照修改為 51.7%。
  • 同一方法令 Qwen3.5-2B 的 GSM8K 成績由 21.6% 升至 69.4%。

研究團隊可先在 Python 3.11 環境驗證實驗設定,再準備模型與題目、收集答案及統計,產生完整 Hugging Face checkpoint。修補需要 Linux 與 NVIDIA 顯示卡;項目文件列出的實驗使用 40GB A100。

這種離散修改適合研究局部修補的成本與效果,但上述數字屬作者報告的數學測試結果,尚不足以判斷其他模型或一般對話能力是否同樣受益。

項目主頁 · GitHub · Paper

Categories: 開源, 模型, 模型訓練, Qwen, NVIDIA, 工具, Linux, Python

WorldFoundry:影片、3D 世界放進同一模型工作流

研究團隊將會可以用同一套工作流探索模型、執行生成、檢查產物及比較評測結果;不同模型的輸入方式與評測協議仍各自保留。

WorldFoundry WeChat Group 1

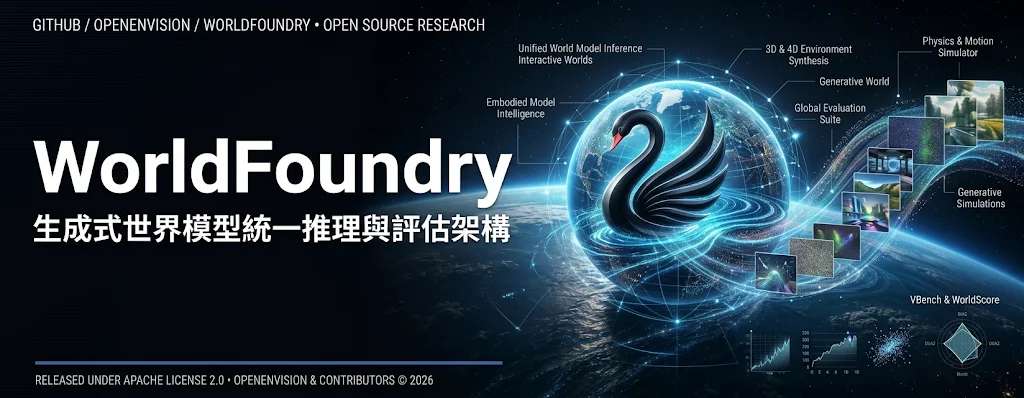
WorldFoundry,一套用於影片、3D 與 4D、具身動作及互動式世界系統之可重現推論與評估的開源基礎設施。WorldFoundry 把影片生成、互動世界、3D/4D 重建及具身動作模型放進同一套推理與評測工作流,屬於開源框架。它處理的問題是:模型種類繁多,如何整理執行條件、檢查生成結果,並在保留各自協議的情況下比較評測資料。

推理可透過命令列、終端介面或瀏覽器版 Studio 執行。Studio 亦可檢視任務狀態、生成媒體與幾何資料,評測則以模型和基準的組合執行,並整理正規化指標、就緒狀態及資格評分卡。

它沒有把不同模型硬塞進相同的評測方式,共享的是目錄、素材格式與結果計算流程,原生輸入、執行語義和評測協議仍按模型保留;評分亦區分文件宣告的支援、操作就緒程度與已驗證表現,避免把列入目錄或展示範例當成基準成績。

執行環境要求 Linux 和支援 CUDA 的 NVIDIA GPU;預設統一環境需要支援 CUDA 12.8 或以上的驅動。推理、Studio、評測及開發共用 CUDA 環境,但 ABI 或模擬器等個別模型需求可能需要不同環境。

  • 目錄涵蓋影片、互動世界、3D/4D、VLA/VA/WAM 等模型類別。
  • 可在 CLI、終端介面及瀏覽器版 Studio 執行目錄內的推理流程。
  • 生成影片、幾何資料與執行紀錄可供檢查,亦可在生成後重新評分。
  • 比較結果時需留意各模型仍採用不同輸入方式與評測協議。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, AI productions, 模型, 世界模型, NVIDIA, DeepSeek, Video, VLA, World-Action Model, 框架, 3D, Linux

EvoWorld:讓鏡頭外世界持續演化並保留因果變化

EvoWorld 將 VLM 推理與視覺渲染結合,處理影片中離開視野的物件如何繼續變化,並在鏡頭返回時保留合理反應。

EvoWorld logo

鏡頭轉開後,世界唔應該停唔轉。EvoWorld 是一套生成式影片系統,專門處理「Out-of-Sight World Evolution」(鏡頭外世界演化):物件離開畫面後仍會參與事件,等鏡頭再次回到同一人物或場景,變化亦要延續落去。

LTX-2.5 負責輸出影片:EvoWorld 作為 visual renderer,將條件轉成 896 × 512、24 fps 影片。

EvoWorld 負責「鏡頭外發生咗乜」:透過視覺語言模型做推理,再配合影片生成器,令鏡頭移開後嘅事件仍然可以發展;鏡頭返轉頭時,呈現合理嘅事件結果,而唔係只還原之前見到嘅畫面。

  • 支援事件觸發的世界演化,可由用戶指定中途發生的事件。
  • 重現原本的人物與場景,維持身份及整體連續性。
  • 渲染鏡頭外動態與因果反應,而不只是重播舊有畫面。
  • EvoWorld-Data 提供約 12,000 段影片,涵蓋 65 種事件、63 種場景及 14 種反應類型。
  • EvoWorld-Bench 設有 120 個測試案例,評估事件、重訪與反應的完整流程。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視覺模型, 多模態模型, Gemini, Video, 提示詞, 框架, Linux, Python, LTX, Dataset 數據集

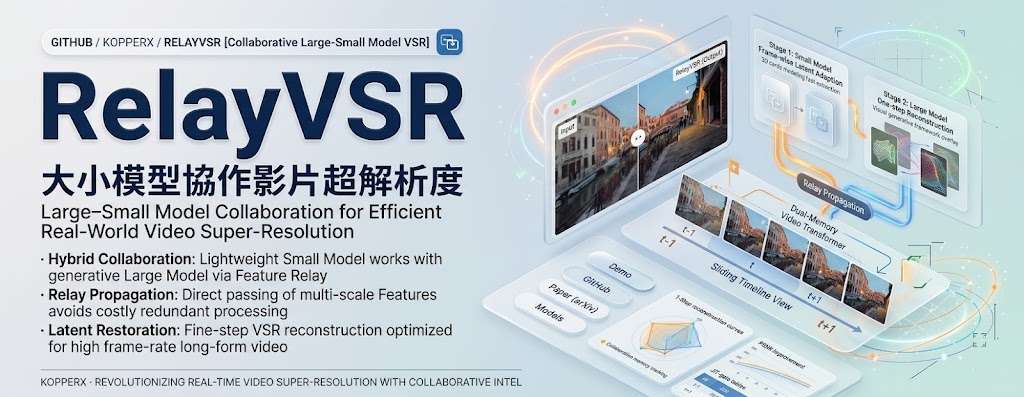
RelayVSR:用稀疏關鍵幀加速 4×影片超解像

RelayVSR 讓大型生成模型只處理稀疏關鍵幀,再交由輕量網絡完成串流放大,兼顧細節、速度與記憶體用量。

RelayVSR overview from the paper

低清影片要放大四倍,往往要在細節真實感與處理速度之間取捨。RelayVSR 屬於影片超解像模型項目,讓大型 Wan 模型產生稀疏參考,再由輕量 Dual-Memory Video Transformer 重建其餘畫面,減少逐幀使用生成模型的成本。

RelayVSR 的流程不只是把兩個模型串起來:Video-Aware Reference Optimization(VARO)以影片層面及關鍵幀層面的獎勵,透過強化學習改善參考品質,降低錯誤關鍵幀在後續畫面累積的風險。輕量模型會結合關鍵幀細節與近期影片內容,支援有限前看及雙端點條件。

在單張 NVIDIA A100 80GB、1080p 及 15 幀關鍵幀間隔下,雙端點 RelayVSR 達到 29.29 FPS,峰值 GPU 記憶體為 13.82 GB,首幀模型延遲 0.327 秒;FlashVSR-Tiny 則為 7.80 FPS、24.447 GB 及 2.83 秒。這個比較反映它把速度和記憶體壓力放在系統協作,而非單一大型模型硬撐。

RelayVSR in ComfyUI - A Fast Upscale AI Video
  • 支援 4×輸出,保留輸入影片 FPS
  • Linux、Python 3.11–3.13 及 NVIDIA GPU
  • Wan 與 Flash 兩個 safetensors 權重分開載入
  • 可處理 MP4 或按順序排列的圖片資料夾
  • 不會複製原影片音訊,長片可用 --max-frames 限制處理量

要試用項目,需要先取得兩個 Hugging Face 權重,再以 inference.py 指定輸入影片;預設每 15 幀產生參考端點,也可調整 --window-size。它較適合需要串流處理、長影片放大或受 GPU 記憶體限制的研究者與影像工作流程,但輸出沒有音訊,亦仍依賴 NVIDIA GPU,未必適合一般消費級電腦直接處理高解像長片。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視頻模型, NVIDIA, Video, Image, Audio, Linux, Python, 中國, 強化學習

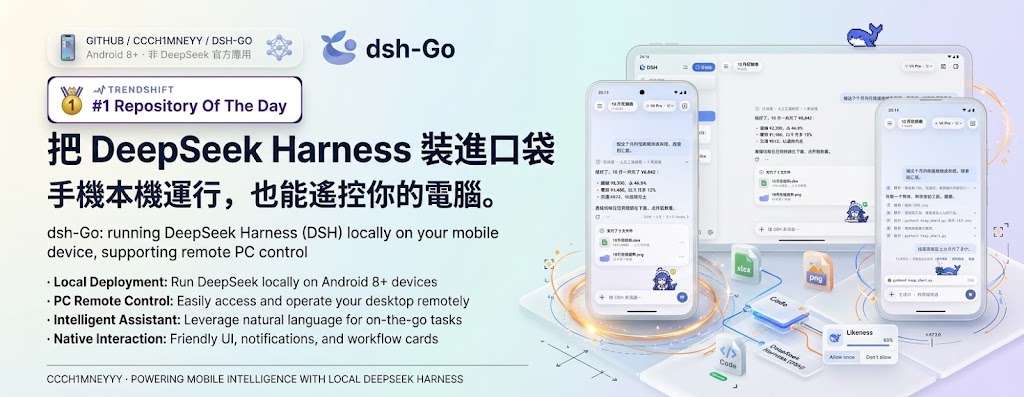
DSH Go:Android 手機執行或遙控 DeepSeek Harness

DeepSeek Harness 的 Android 客戶端 DSH Go,讓你在手機安裝執行環境,或透過 SSH 遙控電腦和伺服器上的 DSH,並在手機處理對話與工具審批。

DSH Go:把 DeepSeek Harness 装进口袋

想在外出時繼續使用 DeepSeek Harness,或直接讓 Android 手機執行它,DSH Go 提供兩種做法:在 App 內安裝 Ubuntu、Node.js 和 DSH 執行環境,或連接電腦及伺服器上的 DSH。這款 Android 客戶端支援 Android 8 或以上,無需 Root,也不必另裝 Termux。

遠端連線可使用 SSH,亦可使用 DSHarness Remote。聊天介面支援切換模型、傳送圖片、語音輸入,以及處理工具審批和提問;需要不同操作方式時,也可切換至網頁模式。這令手機不只是查看對話的介面,亦能接續處理 DSH 的工作流程。

DSH Go 亦支援適配專用 SDK 的原生工具卡、表單和面板,項目提供 SDK、教學和示例,方便開發者製作手機介面。開啟權限後,本機引擎可以讀取屏幕、點按和輸入;這類操作涉及裝置控制,使用者應留意授權範圍,並可隨時停止操作。

  • 可在 Android 手機本機執行 DSH,或連線至遠端電腦及伺服器。
  • 支援圖片、語音輸入、模型切換、工具審批和網頁模式。
  • 原生工具卡、表單及面板可透過項目提供的 SDK 開發。

這個項目適合已使用 DSH、需要以手機接續工作的人,以及希望為 DSH 工具製作原生手機介面的開發者。

GitHub

Categories: 開源, 模型, DeepSeek, Image, 教學, 工具, Linux, 編程, 語音

Page 1 of 8
1 2 3 … 8