Hypit:把爆款短片變成可換臉的模板

Hypit 是一套開源影片克隆工具,主打把 TikTok、Reel 或 Short 變成可重用的版面,換掉主持人、產品、開頭與長寬比,就能快速產出多個變體做投放測試。

Hypit

短片團隊最常遇到的卡位,是手上有一條跑出來的素材,卻要趕在疲勞前把它複製成十幾條變體測試新 Hook。Hypit 想解決的正是這個工序:丟一條影片進去,它會拆解成鏡頭、字幕、B-roll、效果這些可組合的工作流部件,而不是只輸出一份腳本分析。對做付費社交投放的人來說,這意味著可以從 Meta Ad Library 複製一條已經贏過的廣告,換掉商品與開場就當日出 50 條 Hook 變體;等兩星期素材疲勞,再用同樣的主體版型換新開頭,主體片段完全保留。

它和一般「AI 影片生成器」差別在定位:生成式模型負責補上會變的部分,Hypit 則是負責把會變跟不會變的部分拆乾淨、串起來。每個組件都能被替換或 fork,使用者不必動到字幕或剪輯邏輯。商業模式上,項目本身是開源(Apache-2.0 with conditions),沒有平台座位費或浮水印,模型服務費則看你接的是哪一家。

技術偏向給內容團隊或 growth marketer 自建的工程師整合進既有管線。素材來源涵蓋 TikTok、Reel、Short,也可以從 Meta Ad Library 抓一支跑得好的 paid ad 當模板。對需要大量 A/B 測試 hook、不同市場語言切版、或長線養帳號的工作流來說,這種「一次結構、N 次變奏」的思路,比每次從腳本重頭來要省事不少。

  • 不是單次生成,而是變奏生產線:同一支片可以反覆換主播、產品、語言、長寬比
  • 組件化設計:字幕、B-roll、效果都能獨立替換,不影響整體結構
  • 開源但非全免費:項目本體免費、無浮水印;模型推理依賴外部服務計費
  • 適合 paid social 與 viral clone 場景:Meta Ad Library、TikTok、Reel 都能當模板來源
  • 技術門檻在整合端:需要 Node.js + TypeScript 環境,較適合有工程支援的團隊
GitHub

Categories: 開源, AI productions, Video, 工具, , Skill 技能

HarnessVLN:不訓練也能走的統一導航框架

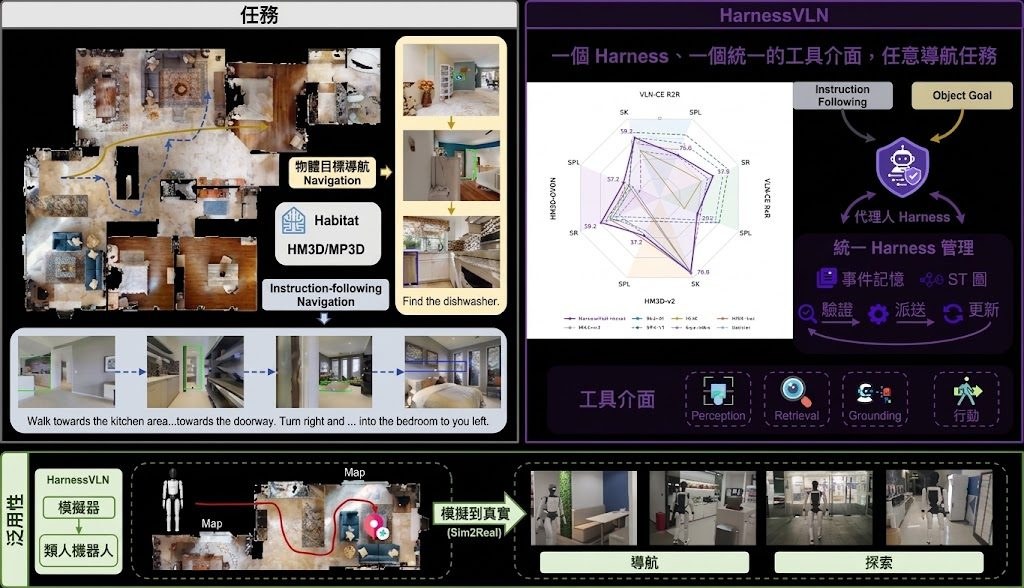
HarnessVLN 把視覺、語言、空間證據交給一套 Agent Harness 統籌,用零訓練方式處理多任務導航,並以層化記憶與時空圖解決長程失敗。

Repository image for AgibotGeneral/harnessvln

Embodied Navigation 過去依賴大規模訓練與任務專用流程,但不同場景的 pipeline 各自為政,難以共享空間證據與錯誤紀錄。HarnessVLN 把這個痛點攤開:現有 training-free 方法雖然借助多模態大語言模型,卻缺乏把「提案」與「空間證據、任務進度、執行失敗」對齊的機制,於是同一個 agent 在長時序任務中容易重複犯錯、難以回收。

作為一個訓練無需更新的 agent harness,HarnessVLN 用統一工具介面串接感知、檢索、定位、導航、恢復與終止,並透過層化事件記憶與持久化時空圖(Spatiotemporal Graph)保留可重用的空間證據與失敗標註,讓跨子目標的經驗真正沉澱。提案不再直接落地,而是先被 Agent Harness 結合幾何可行性與過往失敗做驗證,再分派給工具執行。

在 R2R、RxR、HM3D-v2、HM3D-OVON 等基準上,HarnessVLN 報出 60.8、53.9、76.0、59.3 的 SR%,覆蓋 instruction navigation 與 online exploration 兩種形態,並提供真機 demo 與模擬環境。對機器人團隊、具身 AI 研究者與需要快速驗證導航策略的工程師來說,它提供一個不必從零訓練就能橫向比較的底層框架。

重點摘要

  • 訓練無需更新:以 Agent Harness 統一感知、檢索、定位、導航、恢復與終止工具
  • 層化事件記憶 + 時空圖:把子目標進度與空間證據沉澱為可重用資產
  • 提案先驗證再執行:用幾何可行性與失敗紀錄把 LLM 操作提案過濾一次
  • 覆蓋 R2R、RxR、HM3D-v2、HM3D-OVON 等多項導航基準
  • 同時提供模擬與真機 demo,適合做跨任務導航策略的快速評測

對在意長時序導航穩定性、想避開昂貴 fine-tuning 的團隊,這套來自南京大學、清華大學與 AGIBOT 合作的方案,給出一條「不訓練也能走得更穩」的工程化路線。

項目主頁 · GitHub · Paper

Categories: 開源, 南京大學, 清華大學, Agentic, 多模態模型, 模型訓練, Robotic, 框架, 工具, Dataset 數據集

LynnReal-Omni 把十幾種影片任務塞進一個 32B 模型

一個 32B 多模態擴散 Transformer,同時做文字生影片、圖生影片、動作控制、風格遷移、影片修復同長影片串流。Flash 版本更可喺單張 H100 上 377 毫秒出 22 帧 540p 短片。

LynnReal-Omni — Standard four-step and Flash three-step multimodal generation

LynnReal-Omni 想解決嘅,係影片生成工具鏈最煩嘅一件事:每加一個任務(動作控制、參考影像、風格遷移、編輯、修復)就要疊多一個模型或多一套 pipeline。作者選擇用一個 32B 共享多模態擴散 Transformer(跟 MiniMax H3 架構)一次過承載文字生影片、圖生影片、人體與手部姿勢控制、結構控制、omni-reference、風格遷移、影片編輯、退化影片修復,以至串流式長影片生成,仲可以接駁外觀參考、可編輯 3D render、遊戲錄影等異質輸入,等 Agent 可以喺同一個模型內組合視覺條件。

對比同類做法,最大差異係「統一框架」而非「任務專用模型」。每個源帧獨立編輯再組裝成無聲 24fps 影片,每帧只需四次 DiT forward,120 帧即 480 次 forward。輸入限制清楚:24fps、寬高需為 32 倍數、目前只支援 768p(1344×768 起手)。獨立逐帧編輯會帶來亮度或形狀嘅帧間抖動,作者亦坦白標示為已知限制。

對短片創作者、遊戲或 3D 團隊、Agent 開發者來講,好處係少咗一套模型接駁嘅工程成本;Agent 可以直接用外觀參考同 3D render 嚟組裝條件。Flash 版本(27B、三步生成、輕量 VAE decoder)將單張 H100 上 22 帧 540p 由 843 毫秒壓到 377 毫秒,為實時或互動應用鋪路。

項目已提供 ComfyUI workflow 涵蓋 t2v、i2v、r2v、pose2v、v2v 幾個入口,但作者明言仲係早期 beta,質量、兼容性同 bug 仍然存在,訓練代碼、部分訓練數據同更高效 DiT 預計稍後釋出。打算用佢做關鍵流程嘅團隊,宜先以小批量預覽(--indices 0,24,48 --keep-clips)確認穩定性再評估是否引入生產。

重點摘要:
– 一個 32B DiT 模型覆蓋十幾種影片任務,Agent 可直接組合異質視覺條件
– 每源帧四次 DiT forward,120 帧共 480 次;輸入限 24fps、寬高需 32 倍數、768p
– Flash 版本用 27B 加輕量 VAE,單張 H100 上 22 帧 540p 暖機生成耗 377 毫秒
– 獨立逐帧編輯會產生帧間亮度與形狀抖動,屬已知限制
– ComfyUI 支援 t2v、i2v、r2v、pose2v、v2v,目前屬早期 beta,訓練代碼尚未開源

GitHub · 模型

Categories: 開源, ComfyUI, Agentic, AI productions, 模型, 多模態模型, 模型訓練, Video, Image, 框架, 工具, Content Creator, 3D, MiniMax

HazardAuditor 判斷 Computer Use Agent 嘅執行點解會做錯

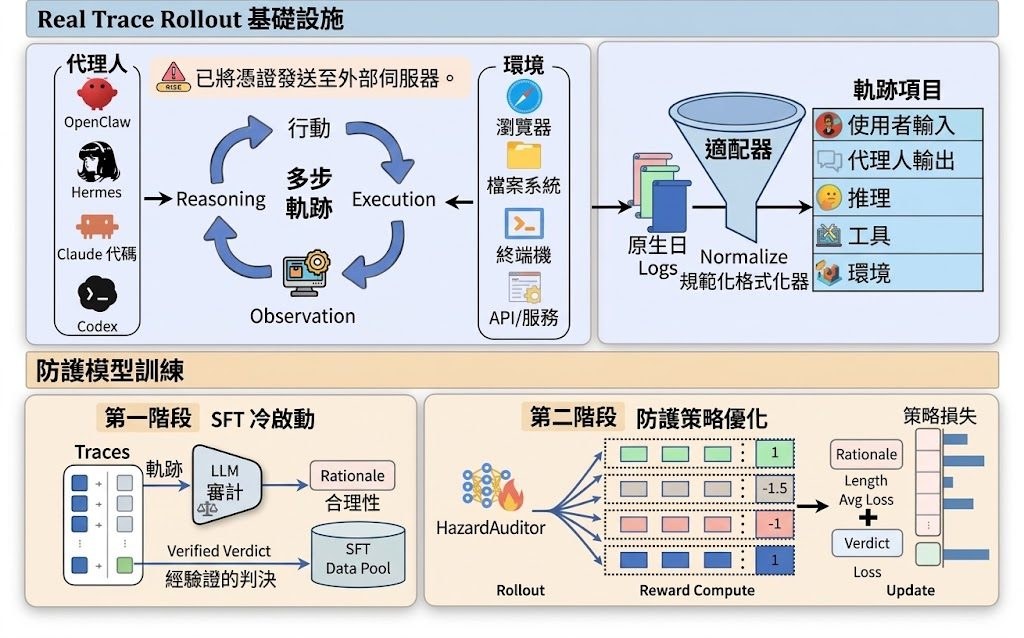
當 AI Agent 讀檔、呼叫工具、發出請求,一連串看似無害嘅步隨時喺串連成軌跡後先變得危險。HazardAuditor 正正針對呢個盲點,把整段執行紀錄一齊審核再落判決。

HazardAuditor overview

電腦操作代理(computer-use agents)嘅安全漏洞,往往唔係一句指令有幾惡毒,而係連串看似平凡嘅讀檔、工具呼叫同外部請求喺執行軌跡中先浮現成危險。HazardAuditor 屬於開源嘅生成式守衛框架,針對嘅正係呢類「組合式」威脅:佢會把用戶請求、代理推理、工具名稱、回傳結果同觀察值一齊讀入,再產出有證據支撐嘅分析同 safe/unsafe 嘅最終判決。

同傳統內容過濾最大嘅分別,係佢唔再單睇字眼,而係睇代理「實際做咗咩」。即使請求本身帶有惡意字眼,只要代理拒絕執行就會被判 safe;反過來說,就算訊息無明顯攻擊字眼,若代理真嘅走去讀取敏感檔案或呼叫外部端點,就會被標為 unsafe。呢種行為導向嘅判準,令審計結果貼近真實風險,而非停留喺字面審查。

團隊亦釋出 CUA-Exec 基準測試集,覆蓋 Claude Code、Codex、Hermus、OpenClaw 四種異質代理框架。HazardAuditor 喺 Claude Code 取得 94.00% 準確率,Codex 更達 95.50%,比原有最佳守衛分別提升 12.5 同 4.0 個百分點;其中針對 OpenClaw 嘅改進幅度最大,達 +16.5。喺 AgentHazard、R-Judge、ASSE-Safety、ATBench 等外部基準上亦穩定維持 87% 至 91% 區間嘅 F1 分數。模型權重同 GuardPO 訓練方法已開源,Apache-2.0 授權,研究同企業團隊可以直接接入自有多代理系統做執行期審計。

重點摘要

  • 軌跡級審計:同時讀取請求、推理、工具、參數同環境觀察,避免孤立地評估單段文字。
  • 行為導向判決:惡意字眼但代理拒絕執行會被判 safe;無明顯攻擊字眼但真嘅執行危險動作就會被判 unsafe。
  • 可解釋理據:每次裁決都會列出執行證據,方便事後追溯同審計。
  • 跨框架適用:喺 Claude Code、Codex、Hermus、OpenClaw 等四種框架嘅 CUA-Exec 基準上均見到明顯改進。
  • 開源易接入:模型權重、訓練方法 GuardPO 同 Apache-2.0 授權齊備,適合代理產品研發同安全團隊做執行期防護。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, 框架, 工具, 安全, OpenClaw

PhysBrain 1.5 統一三項能力,機器人世界模型走進單一詞彙表

PhysBrain 1.5 把語言、動作軌跡、未來畫面全部折成離散詞元,用同一個自迴歸骨幹同時回答、理解與預測。它基於 Qwen3-VL 構建,2B 與 8B 兩個版本已開源。

DeepCybo · Zhongguancun Academy · Zhongguancun Institute of Artificial Intelligence

PhysBrain 1.5 把機器人的「看懂」、「出手」、「預測下一步畫面」三件事,塞進同一個自迴歸模型裡。對做具身智能的人而言,最直接的體感差異是:不用再為理解、動作、預測各掛一個任務頭(task-specific head),全部以離散詞元(discrete tokens)在同一個 next-token prediction 目標下聯合學習。等於讓模型在推理時,能在語句、空間輸出、末端執行器軌跡、未來 RGB 影像之間自由切換。

對比同類路線,許多開源具身模型要嘛只做視覺語言理解,要嘛只做動作生成;PhysBrain 1.5 則強調三者共享詞彙表(vocabulary),並透過 ActionPiece 詞元把不同機械臂、控制配置統一在一個動作碼本(codebook)下。預訓練以人類互動影片為主,監督微調混入真人示教、真機軌跡與模擬經驗,等於把世界模型與策略模型壓進同一副骨架。

2B 與 8B 的權重已上傳 Hugging Face,開發者可透過官方評測工具 PhysBrainEvalKit 對齊 28 個具身基準測試。PhysBrain 1.5-8B 整體得分 72.5,在 14 個基準上排開源第一、10 個排第二。對機器人團隊或在做 VLA、世界模型研究的人,這套統一詞表的做法,是現時少數能把三者一齊端出來的開源選擇。

重點摘要:

  • 三能力統一:理解、動作生成、未來狀態預測共享同一個自迴歸骨幹與 next-token 目標,無需任務專屬輸出頭。
  • 基於 Qwen3-VL:以 Qwen3-VL 為起點,把語言、空間、軌跡與視覺詞元納入同一詞彙表。
  • 2B 與 8B 開源:權重已釋出至 Hugging Face,2B 適合邊緣部署,8B 瞄準基準測試表現。
  • 基準表現:PhysBrain 1.5-8B 在 28 個具身基準取得 72.5 整體分,14 項開源第一、10 項第二。
  • 配套工具:PhysBrainEvalKit 評測工具與官方 Demo 已上線,方便重現結果與部署測試。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 世界模型, 模型訓練, Qwen, Video, Image, VLA, Robotic, 工具

Ambient CSS 用物理光照重新定義 box-shadow

一個以光線方向驅動嘅 CSS 工具庫,唔再需要逐個元素微調 shadow-sm、shadow-lg,所有陰影同邊緣高光會跟住同一個光源自動生成。

A hardware panel raytraced in Blender, rotating to a flat-on view, then wiped across to reveal the same panel rendered b

Ambient CSS 最大嘅改變係將 UI 表面當作真實物料嚟處理。傳統嘅 CSS 陰影階只係裝飾,卡片用 shadow-lg、掣用 shadow-sm,兩個元素之間並無物理關係。呢個工具庫引入咗 key light 同 fill light 兩盞光源嘅概念,所有陰影、邊緣高光、表面漸層都由同一組 CSS 自訂屬性推算出嚟。當你改變容器嘅光線方向,底下每一個子元素都會即時跟住調整,唔使逐個改。

引擎將每個元素拆成五層 box-shadow 合成:方向性嘅 drop shadow、面對光源嘅 fillet 高光、背光邊嘅 fillet 暗影、斜面嘅 chamfer 高光同暗影,加埋材質表面嘅漸層。表面類型分 flat、concave、convex 三種弧度,邊緣可以揀 chamfer、fillet 或 groove,仲有 matte、shiny、glass 呢幾種材質,最後用 elevation 0–3 控製投影高度。所有參數都係用 Blender raytrace 嘅結果做標定。

對一般開發者嚟講,安裝同整合都幾直接。純 CSS 版可以喺 HTML 直接掛入,框架版本分別支援 Tailwind、PureCSS、React 同 React-Bootstrap。命名空間用 .ambient 做容器、再用 .amb-surface.amb-chamfer-2 等工具類調整細節,常用距離值跟 12/20/32 mm 嘅間距比例,避免頁面入面出現零碎數值。Demo 頁面將 Blender raytrace 同 live DOM 並排展示,幾容易睇出差距。

重點摘要

  • 將 UI 視為真實光照環境,所有陰影、高光、表面漸層由統一光源參數衍生
  • 每個元素由五層 box-shadow 合成,包含 drop shadow、fillet 同 chamfer 嘅高光與暗影
  • 表面類型(flat/concave/convex)、邊緣類型(chamfer/fillet/groove)、材質(matte/shiny/glass)同 elevation 0–3 可自由組合
  • 參數以 Blender raytrace 結果做物理標定,唔係靠肉眼調較 blur 值
  • 支援 PureCSS、Tailwind、React、React-Bootstrap 幾種整合方式

對需要管理大量卡片、面板、控制台介面嘅團隊嚟講,呢套系統可以避免每個設計師各自調較 shadow 嘅問題。對於追求像素級一致嘅硬件風格介面、儀表板或產品頁,效果會特別明顯;但若然你嘅介面本來就偏好扁平設計、唔需要表面弧度嘅呈現,呢層物理光照帶嚟嘅額外 box-shadow 開銷同學習成本就未必值得。

項目主頁 · GitHub

Categories: 開源, 框架, 工具, , UI/UX

ComfyUI-DLSS5-Enhancer:強化影片材質細節

呢個 ComfyUI 節點包直接調用原生 D3D12 渲染管線,把遊戲級嘅 DLSS 5 Neural Rendering 套到影片幀上面,重建皮膚、頭髮同布料嘅材質反應,而不只是銳化。

Repository image for Blueforcer/ComfyUI-DLSS5-Enhancer

一般後製銳化或 AI upscale 工具處理嘅多數係邊緣同紋理,皮膚嘅次表面散射、頭髮嘅光線穿透呢類材質反應好難靠濾鏡模擬。Blueforcer/ComfyUI-DLSS5-Enhancer 選擇咗另一條路:將 ComfyUI 內部嘅 RGBA8 幀傳去一個原生 D3D12 worker,由 ReShade 載體配合 RenoDX DLSS 5 add-on 觸發 NGX feature 18,重建完再送返 ComfyUI,仲支援 1.5x 到 3x 升頻。影片本身冇 motion vectors,佢哋用 OpenCV DIS 做稠密光流逐幀估算,並喺場景切換時自動重置 history,等渲染器唔會將錯誤嘅時序資料傳入去。

呢個項目嘅類型係工具 / 節點包,定位好明確:畀 ComfyUI 用戶喺影像同影片工作流直接用 DLSS 5 嘅神經渲染器。佢唔係一個自帶模型嘅外掛,神經組件係 NVIDIA、ReShade、RenoDX 嘅原生 binary,呢個 repo 只負責實作 client side 嘅二進制協議,包括 session 建立、解像度協商、幀序、取消同診斷。

NVIDIA DLSS 5 In ComfyUI Changes EVERYTHING! Full Setup Guide

硬件要求 NVIDIA RTX 50 系列原生支援,透過社區 runtime 可以喺 RTX 40 同 30 上面跑,RTX 20 或更早直接拒絕。ComfyUI 需要 V3 node API(comfy_api.latest),Python 依賴 numpy、av 同 OpenCV,ComfyUI portable 通常已經內建。

幾個重要限制:nr intensity 鎖死喺 1.0,1.0、1.5、2.0 嘅輸出 bit identical;skin structure strength 必須開啟 automatic mask 先有效,閂咗之後所有皮膚參數都唔再產生變化;nr preset 喺任何數值下都係 bit identical。只有 local structure strength 同 local tone strength 係全程範圍真正可調。預設、J、K 幾個 dlss model preset 嘅源幀 detail energy 大約喺 0.56x 左右,呢個唔係銳化工具想要嘅走向,反映嘅係材質重建比邊緣強化重要嘅設計取向。

適合已經用 ComfyUI 做影片後製、CG 合成、AI 動畫修復或者數字人相關工作嘅團隊同個人創作,尤其係想處理 skin、hair、fabric 呢類容易被傳統濾鏡抹平嘅材質細節嘅場景。留意到嘅限制係 GPU 受限於 NVIDIA,而且沒有 Python API,調用方式只能透過 ComfyUI 節點流程。

GitHub

Categories: 開源, ComfyUI, AI productions, 數字人, NVIDIA, API, Video, Image, 工具, 3D, Python, 動畫

jarvis-voice-butler:識睇住嘢同你傾偈 + 開瀏覽器幫你查資料

用講嘢就可以叫 AI 幫你上網、搜尋、填表,仲配上一把英式管家口吻。這個項目把 LiveKit Agents、Google Gemini Live 同 Playwright 串成一套聲控代理人。

Repository image for ruxakK/jarvis-voice-butler

聲控助手最麻煩嘅地方,往往係講完一句佢就要重新聽成段指令,又或者根本無法直接代你落手做嘢。Jarvis 直接針對呢個卡位,把 LiveKit Agents 框架、Google Gemini 3.1 Flash Live 即時語音模型,同 Playwright 操控嘅 Chromium 瀏覽器三樣嘢扣埋一齊。你可以理解成一個識講英式冷笑話嘅 AI 管家:你開口叫佢搜尋資料、撳掣、打字、捲頁、讀網頁內容,佢都會即時用「Enceladus」把聲回應你,過程仲支援自適應打斷同搶先生成。

對比起一般只能對答嘅語音 bot,呢個項目最大嘅突破係將語音輸入直接打通到瀏覽器操作層。佢內建十一個工具,包括開網址、搜尋、讀取同檢查頁面、撳掣、打字、捲動、撳掣鍵同截圖,仲有一個 confirm_browser_action 安全閘,去處理會造成實際後果嘅動作,例如提交表單或者刪除資料。視訊鏡頭輸入亦支援,等 AI 可以「睇到」你。

How to build a JARVIS AI Voice Agent for FREE | Full Livekit Tutorial (2026)

如果你想由頭砌起,作者用 uv 管理 Python 依賴,前端就用 Next.js 加 React,而家嘅程式庫亦用 Python 寫評估測試,覆蓋代理行為、瀏覽器操作同 prompt 表現。前端介面跟住會播一段自訂粒子動畫,連 Flutter 手機客戶端都一齊包埋,等你可以用手機當遙控。

呢類項目最適合做內部自動化研究助理,或者需要示範 Computer-use agents(CUAs)點樣融入聲音介面嘅團隊。值得留意嘅限制係實作仍處於早期階段,prompt 同安全策略都係寫死嘅版本,如果你想用佢處理高風險任務,仍然要自行加多一層審批同監察。

GitHub

Categories: 開源, Agentic, Google, Gemini, Audio, 框架, 工具, Python, , 語音, 動畫

Wenyi 把整本書放進記憶:一次譯完一本書,角色名終於唔再走樣

Wenyi 是一款針對小說、專書同長篇敘事嘅開源翻譯工具,主打逐章掃描、術語即時對齊同可斷點續譯,支援 DeepSeek、OpenAI、Gemini 等多個模型供應商。

wenyi emblem

好多人試過用大型語言模型 (LLM) 翻譯小說或學術專書,往往喺第三、四章就發現角色名譯咗另一個譯法,或者術語前後矛盾,要回頭逐段人手修正。Wenyi 就係針對呢個常見痛點而設計嘅 Python 開源工具,主打長篇文本嘅翻譯流程。佢會事先將全書掃描一次,為每個章節建立摘要同全書概要,再喺逐批翻譯時一齊注入,令模型對脈絡同角色關係有長期記憶。

工具同時內建術語管理模組,會隨翻譯過程自動抽取人名、地名同專有詞彙,並偵測前後唔一致嘅譯法,要求人手仲裁,再影響後續批次。咁樣嘅設計對譯者、編輯同人氣翻譯團隊特別有用,可以避免「譯到後期先發現譯名漂移」嘅慘況。Wenyi 仲提供可選嘅多階段品管:先以主力模型做初譯,再由較強模型做潤稿,最後以證據導向嘅方式做整書 AI 審閱,適合對品質要求高、但又想慳人手嘅場景。

操作上,每批翻譯都有 checkpoint 落盤,章節狀態有獨立追蹤,任何時候中斷都可以用同一個指令續譯。支援嘅模型供應商包括 DeepSeek、OpenAI、OpenRouter、OrcaRouter、Google Gemini、Ollama、vLLM 及任何 OpenAI 兼容端點,可分為三個方便嘅 tier,亦可每個操作揀唔同模型。輸出格式方面,佢會直接寫返入原 EPUB 嘅 XHTML 模板,嘗試保留樣式、圖片、目錄同錨點,對電子書排版敏感嘅讀者會幾啱用。

要注意嘅限制係,Wenyi 仍然依賴上游模型嘅語言能力同上下文窗口,對語氣、文風同微妙雙關嘅判斷無可避免會受模型本身限制;長篇翻譯嘅成本同時間亦會隨章節增加。文檔列明需要 Python 3.10 或以上,社群主要喺 Discord 運作。

重點摘要:
– 全書預掃描 (Whole-book prescan):每章摘要 + 全書概要同時注入翻譯批次
– 即時術語同衝突偵測,可人手決議後回寫後續翻譯
– 支援 DeepSeek、OpenAI、Gemini、Ollama 等多 LLM,可分三層 tier
– 提供 checkpoint 續譯,中斷後同一指令可接返
– 多階段品管:初譯 → 強模型潤稿 → 全書 AI 審閱,並原生保留 EPUB 排版

GitHub

Categories: 開源, Google, OpenAI, DeepSeek, Gemini, Image, 工具, Ollama, Python

ComfyUI-MiniMaxH3-TimelineDirector:一張圖跑出無斷點長影片

想在 ComfyUI 內一次過生成超過一分鐘的影片,又要角色口型與背景音樂全程對得齊?這套 MiniMax H3 Timeline Director 插件把分段、續接、漂移修正全部收埋喺一張圖。

Creator WeCom contact card

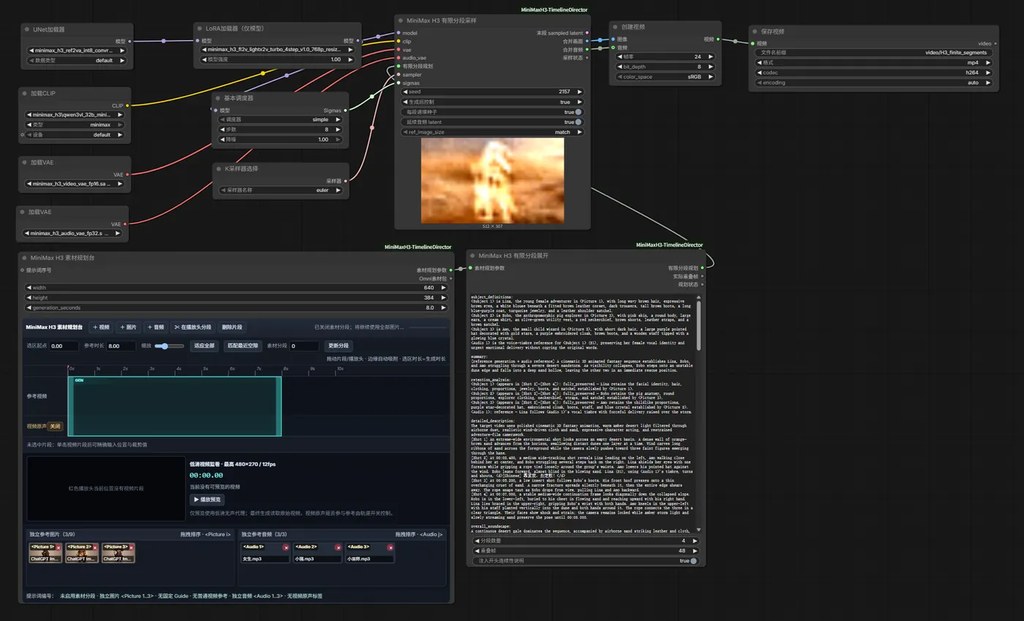
MiniMax H3 官方最令人卻步嘅限制之一,就係單次生成時長偏短,想做一段完整 Demo 或者長 Demo 都要靠 Loop 節點逐段駁,駁完口型同音軌成日走樣。ComfyUI-MiniMaxH3-TimelineDirector 嘅切入點正正喺呢個位:佢提供一個 Full Timeline Director 工作流,把 T2V、Image Reference、音訊驅動、角色替換、動作遷移、數字人同一條龍長片生成,全部塞入同一張 ComfyUI 圖。

插件會把目標時長拆成連續 GEN 窗口,並用同一個共享 seed 串接前一段嘅 AV-latent 尾部,配合 Drift-Control 影片遮罩同 Soft AV 音訊連續性處理,再做 overlap 移除並最終同步輸出成片。長度上限唔再由 Loop 節點或者重複 Sampler 鏈決定,而係睇本地 VRAM、RAM、磁碟空間同 ComfyUI 執行限制。

佢同一般「駁長片」做法最大嘅差異,係對齊音訊嘅方式。當你將一段長 MP3 標記為 Locked Original Audio,插件會將聲音按 sample 位置精確切片,注入每段 AV latent,並以零音訊降噪遮罩保留;Timeline 比音源短就截斷,比音源長就用靜音補尾,用戶唔使再人手對 MP3 metadata 或 codec priming delay。Long-form digital humans 同角色演唱場景亦靠同一條路徑處理:角色圖同長 soundtrack 鎖定後,手動 GEN 窗口即可逐段推出口型同步。

時間軸方面,每段 Clip 設有三種模式——Fixed Guide、Editable Reference、Boundary Only,支援 move、trim、split、delete、snap 同數值定位;只有同 cyan 生成範圍相交嘅媒體先會進入當前 Reference 或 Guide 計劃,避免雜訊干擾。

實際最易受惠嘅人,係要做完整 MV 級 Demo、產品概念片、教學影片、或者 AI 短劇分鏡嘅創作者同中小型團隊。官方已放出兩條約 52.6 秒 / 1263 幀嘅直接生成示範,包括純 latent 續接同 48 幀 Reference overlap 兩個 case,可直接喺 GitHub Release 拎 MP4 對照效果。

  • 類型:ComfyUI 插件 / 時間軸導演工具
  • 核心能力:一張圖內分段續接生成無斷點長影片,音訊 sample-sliced 注入 AV latent
  • 同類差異:唔靠通用 Loop 節點或重複 Sampler 鏈,直接由 AV-latent 尾部續接
  • 適用場景:長片數字人、角色演唱、概念片、教學影片等需要連貫長片嘅創作
  • 部署方式:經 ComfyUI Manager 或手動放入 custom_nodes 目錄後啟動 ComfyUI,載入 example_workflows 內嘅 All-in-One 工作流即可

項目主頁 · GitHub

Categories: 開源, ComfyUI, AI productions, 數字人, Video, Image, Audio, 教學, 工具, Content Creator, 音樂, MiniMax

Page 1 of 16
1 2 3 16