MoneyPrinterTurbo 整合 AI 影片流程

輸入主題即可生成短片內容與素材,亦可接入不同模型;適合內容團隊快速製作多語言影片。

Kimi 赞助 MoneyPrinterTurbo

給定一個主題,便要自行寫稿、找素材、配音、加字幕再剪輯;MoneyPrinterTurbo 將這套流程整合成 AI 短影片生成工具,涵蓋腳本、配音、素材搜尋、字幕、配樂及剪輯,並提供 AI Agent、WebUI、API 和 CLI 四種介面。

由一句主題到成片:它可自動生成或改寫多語言影片腳本,也允許逐個環節改用自訂內容。支援批量生成、任務紀錄,以及設定和 API Key 的匯入、匯出與恢復,對經常製作大量短內容的編輯、社交媒體營運團隊及小型工作室尤其方便。

  • 輸入主題或關鍵詞,自動完成短片內容與素材配對
  • 以 WebUI、API、CLI 或 AI Agent 接入不同工作流程
  • 可替換腳本、配音、素材、字幕或配樂
  • 支援批量生成、任務歷史及多語言腳本
  • 兼容多種模型服務、統一網關及本地環境

模型選擇相當廣,可連接 Kimi/Moonshot AI、OpenAI、Anthropic Claude、Google Gemini、DeepSeek、阿里云通義千問、Microsoft Azure OpenAI、火山引擎方舟、xAI Grok、MiniMax、小米 MiMo,以及 Ollama、LiteLLM、OpenRouter 等平台。Kimi K3 獲項目採用,負責撰寫文案、提煉素材搜尋關鍵詞及判斷合適畫面;本地模型則適合重視資料控制或降低雲端依賴的團隊,但最終流暢度與準確度仍取決於所選模型、服務配額及素材來源。

這套工具的優勢不是生成單段影片,而是把多個製作步驟串成可重複運作的流程。代價是成品質素仍受文字模型、素材版權、語音及剪輯設定影響,重要影片應保留人工審核,而非直接自動發佈。
GitHub

Categories: 開源, Agentic, AI productions, 模型, Google, 微軟, OpenAI, DeepSeek, Gemini, API, Video, 工具, Ollama, 語音, Anthropic, Kimi, 小米-Xiaomi, MiniMax

Deepseek Recipe 幫本地推論後端連接多格式 API

在本地跑 DeepSeek 模型、想同時提供 Messages、Chat Completions 與 Responses 三種 API 格式?這個 Rust + Python 工具庫把格式轉換、prompt 渲染與 token 編碼一條龍包辦。

DeepSeek

對想自建 DeepSeek 推論服務嘅開發者來說,最頭痛往往唔係模型本身,而係點樣令自家後端兼容外界各種 API 格式。deepseek-recipe 就係針對呢個痛點而來——它用 Rust 寫核心邏輯,再提供 Python bindings,專門負責將 Messages、Chat Completions 同 Responses 三種主流請求格式統一轉換成 DeepSeek 內部嘅 Conversation 結構,再渲染成模型識讀嘅 prompt,最後用附帶嘅 tokenizer 編碼成 token ID。

呢個庫定位相當清晰:佢只處理格式轉換同 prompt 拼裝,模型推論、工具執行、HTTP 傳輸呢啲都交返俾呼叫方自己負責。換句話講,開發者可以揀任何推論引擎,再喺外面搭一層 recipe 做「翻譯員」,咁就可以用同一個後端撐起多個對外 API 端點。對於正在從 Ollama、vLLM 或自家 CUDA 服務過渡到 DeepSeek 模型嘅團隊嚟講,等於慳咗大量重複開發。

它對 DeepSeek V4 同 V4.1 有針對性處理:V4.1 支援圖像(會用 OpenCV 預處理),V4 則會把圖片替換成 [Unsupported Image] 字串,避免下游出錯。Thinking mode 方面亦照顧周到,無設定時自動補 8192 tokens,開啟 thinking 預設 65536,開到 max effort 就去到 131072。Structured output 同樣齊全,Chat Completions 嘅 json_schema、regex,以至 Responses 嘅 text.format 都做咗驗證同轉寫,並會喺 InferenceOptions 揀選對應嘅 OutputConstraint,畀呼叫方決定要唔要開 constrained decoding。

工具支援亦係重點之一。Function tools 全部覆蓋,V4.1 仲額外支援 Messages 嘅 deferred tool loading 同 Responses 嘅 client-executed tool search,對做 agent 框架嘅人特別有用。串流方面,token usage 會回報 reasoning_tokens,logprobs 喺 Responses 格式下亦會被轉成 InferenceOptions。不過要留意,圖片抓取組件 ReqwestImageFetcher 預設連任何地址都得,如果服務面向不可信來源,記得裝返 DestinationFilter。

GitHub

Categories: 開源, Agentic, 模型, NVIDIA, DeepSeek, API, Image, 框架, 工具, Ollama, Python, 庫, Tokenize

[技術文章] 阿里 CommerceGen-Studio:商用級主圖生成端到端框架

把白底 SKU 商品照變成可上架主圖,並以幾秒延遲處理每日百萬級流量。

Hugging Face

白底商品照難以直接吸引搜尋頁點擊,CommerceGen-Studio 由 Alibaba Group 提出,面向電商 SKU 粒度的商業主圖生成。來源沒有交代具體 base model 或 fine-tuned from 哪個模型,因此無法確認其原始基礎模型。

系統分成資訊抽取、語義改寫及多條件生成三階段。Prompt-Eval-Refine-Loop Agent(PERL-Agent)讓 VLM 與 LLM 按照 reference-free rubric 反覆整理商品資料;Layout Thinker Optimization(LTO)則同時以文字描述及渲染圖片質素調整改寫策略。

SKU-DiT 透過 Reinforce-Distill-Reinforce(RDR)漸進式訓練,聯合使用白底商品圖、商標裁剪圖及結構化版面條件,兼顧商品外觀、商標完整性和字元級文字準確度。系統聲稱已達到每日生成數百萬張主圖、每張延遲數秒,並在 CommerceGen-Bench 的兩條編輯測試中勝過所比較的開源基線,部分指標可媲美或超越大型閉源模型。

  • 檔案與推論:來源是研究論文內容,沒有提供 GGUF 檔名、檔案大小、量化級別、mmproj 或 chat template。
  • 框架支援:論文摘要沒有公開各項數值分數,也未交代 SKU-DiT 的參數規模及訓練資料細節。
  • 適用場景:重點在大量電商商品主圖生產,而非通用文字轉圖片服務。

CommerceGen-Studio 與單一生成模型的差異,在於把商品資料理解、賣點整理、版面規劃及圖片生成串成完整項目流程;CommerceGen-Bench 則以真實流量中的困難案例測試 Instruction Following 和 Product Integration。由於缺乏公開權重、量化檔案及硬體規格,讀者目前較適合把它視為可大規模運行的研究框架,而非可直接下載的本地模型。

Paper

Categories: 開源, 阿里巴巴, Agentic, 模型, 視覺模型, 模型訓練, Image, 影像模型, VLA, 框架, LLaMa, Ollama, Dataset 數據集

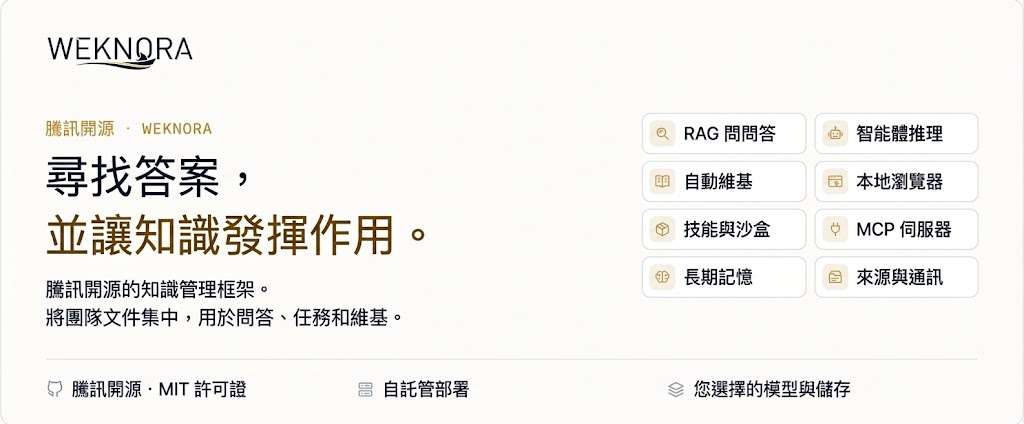
WeKnora 把企業知識庫變成可問、可做、可追溯的 AI

WeKnora 將 RAG、Agent 與 Wiki 放進同一個知識庫,兼顧企業資料整合、任務執行和私有化部署。

WeKnora: find the answers, and put knowledge to work. Tencent

不只可以問文件內容,WeKnora 會幫你用 AI 操作工具、整理 Wiki,並保留已確認的偏好與事實。WeKnora 是一個開源 LLM 知識框架,處理企業文件理解、語意檢索與多步推理;RAG、Agent 和 Wiki 共用同一套知識庫,減少資料分散造成的落差。

RAG 會結合語意及關鍵字檢索,回答附上原文引用;Agent 可搜尋網頁、呼叫 MCP 工具、執行技能,並在沙箱中處理檔案。Wiki 則把文件整理成互相連結的頁面與知識圖譜,支援編輯、差異比較和版本回滾,適合需要持續維護內部知識的團隊。

  • 支援 PDF、Word、圖片、Excel、XMind 等十多種格式
  • 可同步飛書、Confluence、GitLab、Notion、語雀、RSS 等來源
  • 透過企業微信、飛書、Slack、Telegram、MCP Server 或 API 提供服務
  • 具備多空間 RBAC、審計日誌、任務佇列及 Langfuse 追蹤

模型、向量資料庫及儲存後端都可以替換,內置 29 家模型供應商,包括 OpenAI、DeepSeek、Qwen、Gemini、MiniMax、LiteLLM 和 Ollama。v0.8.2 加入本機瀏覽器操作、MCP Server、對話分叉與回滾,令知識庫不再只負責回答問題,也能參與任務流程。

Docker、Kubernetes、Helm、Lite 單機版及桌面應用都在支援範圍內,資料可以留在本地或私有雲。對重視資料留存、內部協作和可追溯性的企業,這套整合度具備明確吸引力。

項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, RAG, MCP, Qwen, OpenAI, DeepSeek, Gemini, Image, 框架, KnowledgeGraph, Ollama, 庫, Anthropic, MiniMax, Skill 技能

MiniMax H3 4-bit 量化保留原生影音生成

MiniMax H3 壓縮至 4-bit 後,仍保留影片與音訊生成能力。

Og image

要在較有限的硬件資源下製作影片,又不想放棄同步音訊,MiniMax H3-QuantFunc-4bit 提供了一個量化選擇。頁面將它定位為 MiniMax H3 的 4-bit 量化版本,而非獨立微調模型;原始基礎模型可確認為 MiniMax H3,但未交代更完整的 base model 訓練資料或微調流程。

模型把核心權重精度由 16-bit 降至 4-bit,官方稱壓縮幅度約為 4 倍,並宣稱角色細節、風格一致性及快速動作仍可維持。它支援 text-to-video、image-to-video,以及原生 video+audio generation;附真人演出、動畫追逐、高速汽車及風格化角色展示生成結果。

FL2VA 在相同提示詞及 seed 下,QuantFunc INT4 對 BF16 基準取得約 23.7 dB PSNR。這個數字可用作重建品質參考,但屬項目方的內部測試,未有列出測試硬件、影片設定、速度或顯存用量,因此不能單憑該指標推算日常生成體驗。

  • 標籤包含 svdquant、int4、quantized 及 comfyui,但沒有交代量化演算法細節。
  • 頁面未提供 GGUF 檔案名稱、檔案大小、mmproj、上下文長度或推薦量化級別。
  • 未列明 llama.cpp、Ollama 或 LM Studio 支援,也沒有硬件需求及 MTP draft speculation 資訊。
  • 項目連結 ComfyUI-QuantFunc,較適合配合相關工作流探索;授權為 MiniMax H3 Community License,使用前應查閱條款。

模型

Categories: 開源, ComfyUI, AI productions, 模型, 視頻模型, 模型訓練, Video, Image, 影像模型, 影像處理, Audio, 提示詞, Discord, LLaMa, Ollama, 動畫, MiniMax

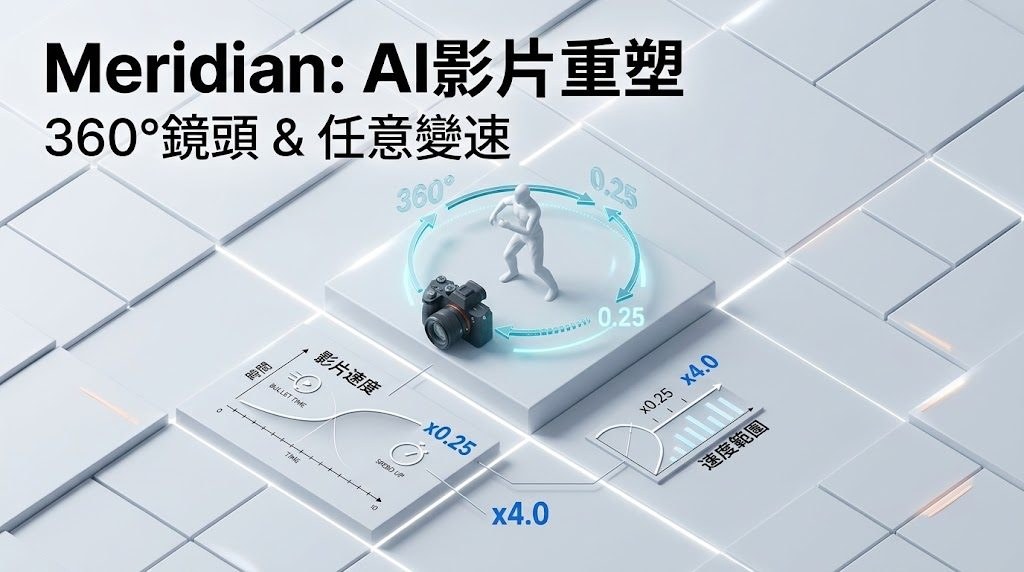
Meridian 讓 MiniMax H3 將時間與鏡頭重新編排 – Bullet time

Meridian 可從影片或單張圖片重新設計鏡頭路徑,重訪同一事件的不同視角。

Og image

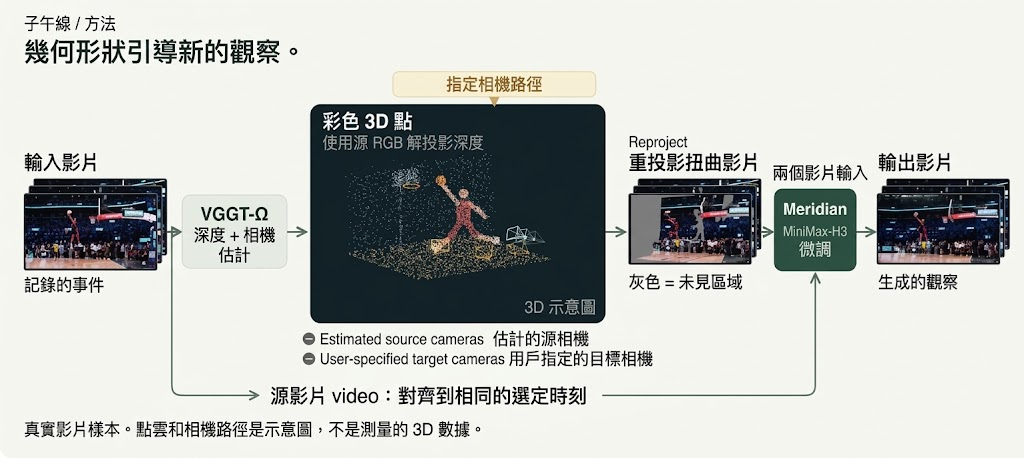
想將一段已拍攝的動作改成全新鏡頭,甚至暫停某個瞬間再繞行拍攝,Meridian提供了影片到影片(video-to-video)的處理方式。它基於 MiniMaxAI/MiniMax-H3,以 adapter 形式加入幾何控制能力,並結合 VGGT-Omega 幾何資訊,亦支援由單張圖片建立鏡頭移動。

Meridian 處理的是空間與時間的共同編排:鏡頭可沿指定路徑移動,原有動作則可繼續、放慢或暫停。Bullet time 只是其中一種時間與鏡頭組合,並非模型的邊界;要加快或放慢動作,應先重新調整輸入影片的時間,再按該時間軸設計 camera path。

頁面提供的例子包括以原片重新觀看 NBA 灌籃、在草莓片段中暫停動作並移動鏡頭,以及以芭蕾單張相片產生鏡頭運動。這種做法適合重構已有事件的觀察角度,但生成畫面與原片如何銜接、遮擋區域能否保持一致,仍取決於輸入內容與指定路徑。

  • 基礎模型:MiniMaxAI/MiniMax-H3;模型關係標示為 adapter
  • 幾何元件:VGGT-Omega
  • 任務標籤:video-to-video、novel-view-synthesis、camera-control、re-camera
  • 提供 installation.md 連結

項目主頁 · 模型

Categories: 開源, AI productions, 模型, 視頻模型, Google, NVIDIA, Video, Image, 框架, 教學, Discord, LLaMa, Ollama, Python, 蘋果, MiniMax

Wenyi 把整本書放進記憶:一次譯完一本書,角色名終於唔再走樣

Wenyi 是一款針對小說、專書同長篇敘事嘅開源翻譯工具,主打逐章掃描、術語即時對齊同可斷點續譯,支援 DeepSeek、OpenAI、Gemini 等多個模型供應商。

wenyi emblem

好多人試過用大型語言模型 (LLM) 翻譯小說或學術專書,往往喺第三、四章就發現角色名譯咗另一個譯法,或者術語前後矛盾,要回頭逐段人手修正。Wenyi 就係針對呢個常見痛點而設計嘅 Python 開源工具,主打長篇文本嘅翻譯流程。佢會事先將全書掃描一次,為每個章節建立摘要同全書概要,再喺逐批翻譯時一齊注入,令模型對脈絡同角色關係有長期記憶。

工具同時內建術語管理模組,會隨翻譯過程自動抽取人名、地名同專有詞彙,並偵測前後唔一致嘅譯法,要求人手仲裁,再影響後續批次。咁樣嘅設計對譯者、編輯同人氣翻譯團隊特別有用,可以避免「譯到後期先發現譯名漂移」嘅慘況。Wenyi 仲提供可選嘅多階段品管:先以主力模型做初譯,再由較強模型做潤稿,最後以證據導向嘅方式做整書 AI 審閱,適合對品質要求高、但又想慳人手嘅場景。

操作上,每批翻譯都有 checkpoint 落盤,章節狀態有獨立追蹤,任何時候中斷都可以用同一個指令續譯。支援嘅模型供應商包括 DeepSeek、OpenAI、OpenRouter、OrcaRouter、Google Gemini、Ollama、vLLM 及任何 OpenAI 兼容端點,可分為三個方便嘅 tier,亦可每個操作揀唔同模型。輸出格式方面,佢會直接寫返入原 EPUB 嘅 XHTML 模板,嘗試保留樣式、圖片、目錄同錨點,對電子書排版敏感嘅讀者會幾啱用。

要注意嘅限制係,Wenyi 仍然依賴上游模型嘅語言能力同上下文窗口,對語氣、文風同微妙雙關嘅判斷無可避免會受模型本身限制;長篇翻譯嘅成本同時間亦會隨章節增加。文檔列明需要 Python 3.10 或以上,社群主要喺 Discord 運作。

重點摘要:
– 全書預掃描 (Whole-book prescan):每章摘要 + 全書概要同時注入翻譯批次
– 即時術語同衝突偵測,可人手決議後回寫後續翻譯
– 支援 DeepSeek、OpenAI、Gemini、Ollama 等多 LLM,可分三層 tier
– 提供 checkpoint 續譯,中斷後同一指令可接返
– 多階段品管:初譯 → 強模型潤稿 → 全書 AI 審閱,並原生保留 EPUB 排版

GitHub

Categories: 開源, Google, OpenAI, DeepSeek, Gemini, Image, 工具, Ollama, Python

MiniMax H3 Director Studio:Windows 本地模型做 AI 影片前期製作

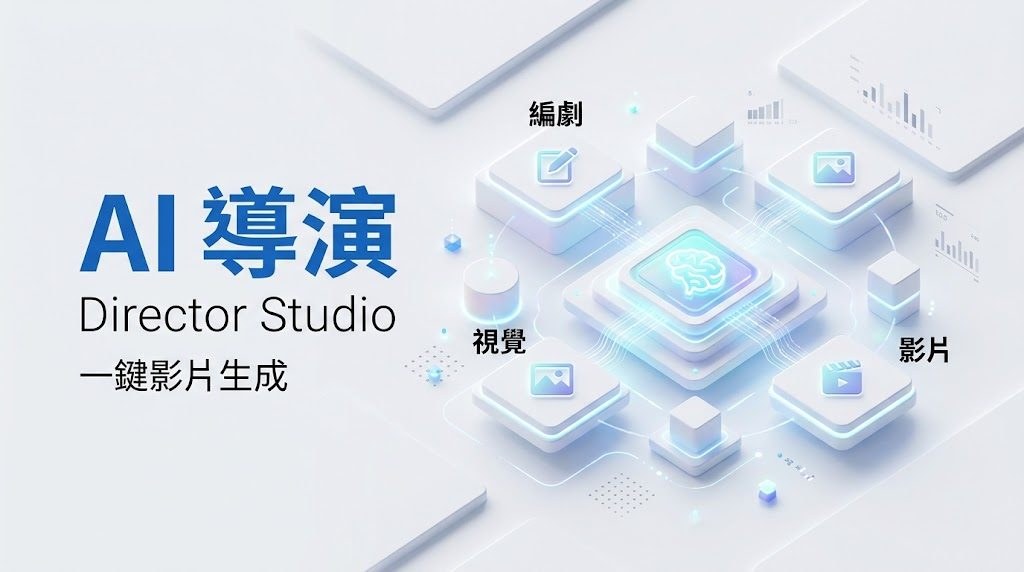
Director Studio 是一個本地優先的前期製作工作空間,串接 Ollama 規劃鏡頭、ComfyUI 生成畫面,再交由 MiniMax H3 出片,特別適合想完全控制創作流程的獨立創作者。

Repository image for ai2764/Director-Studio

想在本地完成 AI 影片從構思到成片的整條前期流程,而不依賴雲端訂閱?Director Studio 正是針對這個需求的工作空間類工具。它把鏡頭規劃、可重用的視覺與語音資產管理、以及 MiniMax H3 Ref2AV 提示詞撰寫,整合在同一個介面內,最後透過 ComfyUI 與 MCP 協議生成圖像與影片。

與一般 ComfyUI 前端不同,它把「規劃 Agent」綁定在本地 Ollama 上運行,並與 ComfyUI 共享 VRAM,避免兩者搶顯存。用戶可以選擇全本地流程,亦能把 H3 影片交給官方 MiniMax API 處理,兼顧靈活與效能。內建的 typed asset library、演員與場景工作流、可編輯的 Picture/Audio 參考、以及六段式 H3 提示詞結構,讓鏡頭設計不再是憑感覺亂試。

Qwen3.8 27B Directs H3 | Director Studio Is Now Open Source

對於獨立創作者、小型製作團隊,或需要反覆迭代鏡頭分鏡的人,這套工作流省下了在不同工具間切換的成本。Windows 用戶只要安裝 Ollama、ComfyUI Desktop 與 Python 3.10+,再解壓官方 zip 即可透過 DirectorStudio.exe 啟動,所有資料儲存在執行檔旁的 data 目錄,方便升級前備份。

採用 FastAPI 後端配合 Vite + React 前端,規劃 LLM 透過 Ollama 執行,生成層則透過 ComfyUI MCP 串接。架構與擴展點已在 docs/ARCHITECTURE.md 說明,適合想自行修改管線的進階用戶。

需要注意,VRAM 是這套系統的瓶頸:Ollama 與 ComfyUI 需共享顯存,若要同時運行大型本地模型與高解像度影片工作流,硬體門檻不低。對於偏好全雲端、或無獨立顯卡的用戶,這套方案未必比 SaaS 工具方便。

GitHub

Categories: 開源, ComfyUI, Agentic, AI productions, MCP, 模型, 多模態模型, API, Video, Image, Audio, 工具, Content Creator, Ollama, Python, 庫, MiniMax

VibeVoice-ASR-Streaming-7B 即時辨識與轉錄合而為一

Microsoft Research團隊將講者辨識加入串流語音轉錄,讓語音助手更快知道誰在說甚麼。

Hugging Face

Microsoft Research 聯同中國科學院大學及上海交通大學研究人員,開發VibeVoice-ASR-Streaming。

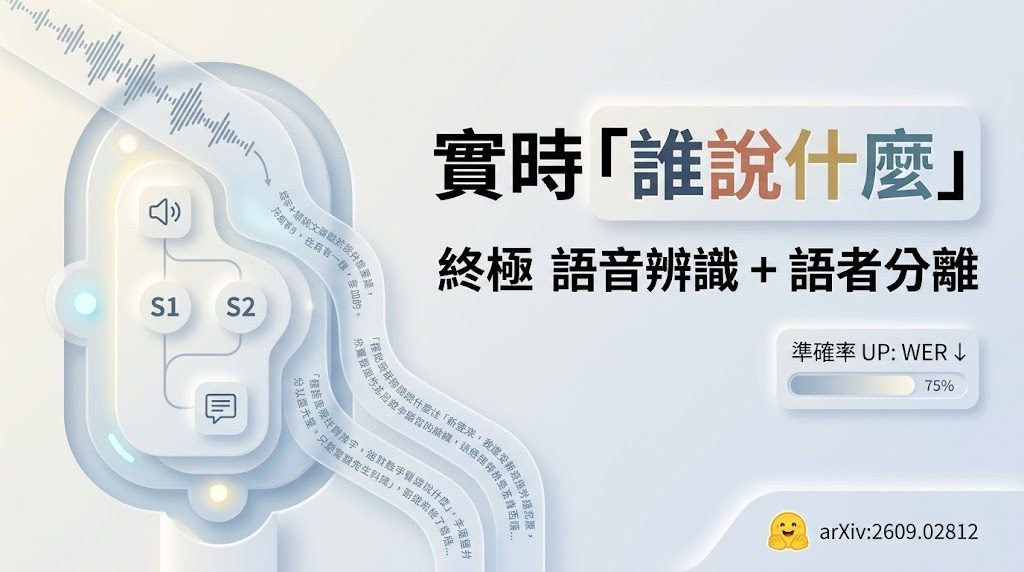
模型以 Large Language Model(LLM)為核心的端到端串流Speaker-Attributed Automatic Speech Recognition(ASR)系統,連續處理到達中的語音,同時輸出文字及講者身份。傳統流程通常把ASR與speaker diarization分開處理;此模型將兩項工作放進單一模型,針對即時語音助手及語音代理需要低延遲回應的場景,減少等待完整錄音後才分析的限制。

VibeVoice-ASR-Streaming 會交錯處理固定大小的audio chunks,並加入少量lookahead,讓模型在保留未來聲音片段作判斷的同時,逐步產生轉錄結果。固定分塊有助控制處理延遲,但lookahead 與分塊大小之間仍要取捨:前者越多,講者切換及語句判斷可能更穩定,回應時間亦可能增加。

  • 以單一LLM-based端到端模型同步處理ASR與speaker attribution
  • 使用固定大小audio chunks及少量lookahead支援串流輸出
  • 針對即時語音助手及agents的低延遲需求設計
  • 量化檔案、推論框架、硬體需求及效能指標尚未在提供內容中交代

項目主頁 · Paper · 模型

Categories: Agentic, 微軟, Audio, Discord, LLaMa, Ollama, 語音, Dataset 數據集

[技術文章]LLM 媲美 Embedding,成本卻高逾 1431 倍

LLM已能追上頂尖Embedding模型,但搜尋系統未必值得因此承受高昂成本。

Hugging Face

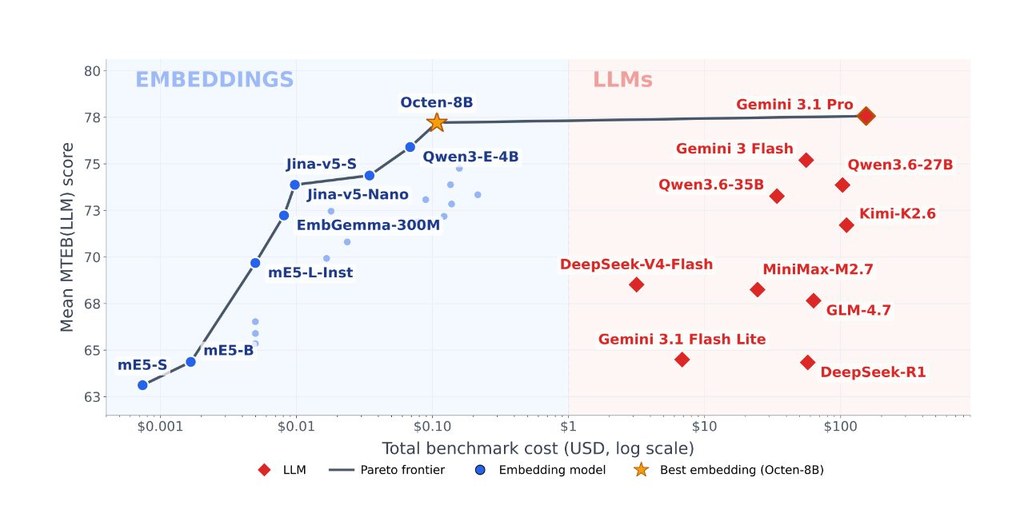
做語意搜尋、分類或文件聚類時,LLM已能在多項測試追上專門的文字嵌入模型;但每次評測成本最高相差1,431倍,令「是否應取代Embedding pipeline」成為成本與能力之間的取捨。本頁屬研究論文內容,並非可直接下載的單一模型頁面;未有提供可確認的 base model 或 fine-tuned from 資訊,因此無法判定某個模型的原始基礎模型。

研究比較10個、來自6個家族的 large language models (LLMs),以及26個參數量由118M至14B的 embedding models,測試涵蓋37項 MTEB(LLM) 任務,包括分類、semantic textual similarity (STS)、聚類、pair classification 和 retrieval。最佳 LLM Gemini 3.1 Pro 得分77.6,最佳 embedding model 得分77.2,差距只有0.4分。

  • Embedding models 在分類、相似度和聚類表現較合適
  • LLM 在需要推理的 retrieval 任務較有優勢
  • LLM 每次 benchmark pass 成本約154美元,embedding model 約0.11美元
  • 開源 LLM 在同一 GPU 上慢約2.5至736倍
  • reasoning tokens 佔 LLM inference 成本28%至81%

研究亦指出,降低 reasoning budget 對多數模型的 retrieval 品質沒有明顯傷害,反映混合式流程更合理:以 embedding model 負責大部分相似度搜尋,再把需要理解語境或多步推理的查詢交給 LLM。

Paper

Categories: Embedding, Qwen, Gemini, LLaMa, Ollama, Dataset 數據集, Kimi

Page 1 of 4
1 2 3 4