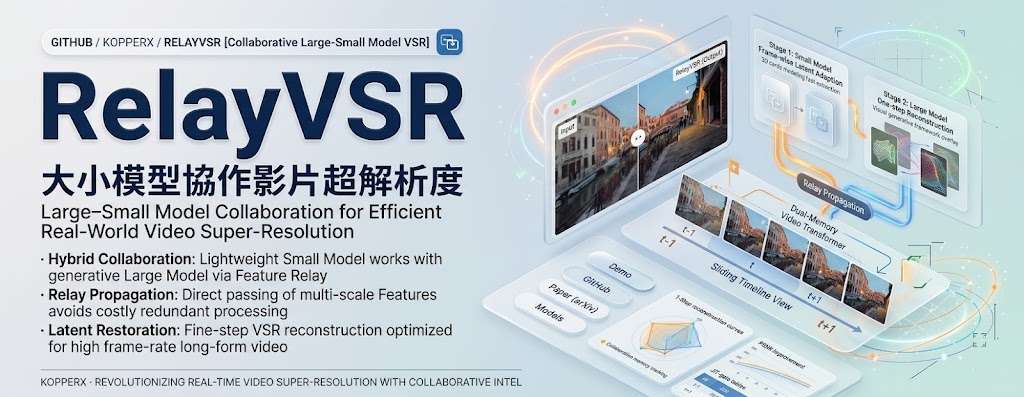
RelayVSR:用稀疏關鍵幀加速 4×影片超解像

RelayVSR 讓大型生成模型只處理稀疏關鍵幀,再交由輕量網絡完成串流放大,兼顧細節、速度與記憶體用量。

RelayVSR overview from the paper

低清影片要放大四倍,往往要在細節真實感與處理速度之間取捨。RelayVSR 屬於影片超解像模型項目,讓大型 Wan 模型產生稀疏參考,再由輕量 Dual-Memory Video Transformer 重建其餘畫面,減少逐幀使用生成模型的成本。

RelayVSR 的流程不只是把兩個模型串起來:Video-Aware Reference Optimization(VARO)以影片層面及關鍵幀層面的獎勵,透過強化學習改善參考品質,降低錯誤關鍵幀在後續畫面累積的風險。輕量模型會結合關鍵幀細節與近期影片內容,支援有限前看及雙端點條件。

在單張 NVIDIA A100 80GB、1080p 及 15 幀關鍵幀間隔下,雙端點 RelayVSR 達到 29.29 FPS,峰值 GPU 記憶體為 13.82 GB,首幀模型延遲 0.327 秒;FlashVSR-Tiny 則為 7.80 FPS、24.447 GB 及 2.83 秒。這個比較反映它把速度和記憶體壓力放在系統協作,而非單一大型模型硬撐。

  • 支援 4×輸出,保留輸入影片 FPS
  • Linux、Python 3.11–3.13 及 NVIDIA GPU
  • Wan 與 Flash 兩個 safetensors 權重分開載入
  • 可處理 MP4 或按順序排列的圖片資料夾
  • 不會複製原影片音訊,長片可用 --max-frames 限制處理量

要試用項目,需要先取得兩個 Hugging Face 權重,再以 inference.py 指定輸入影片;預設每 15 幀產生參考端點,也可調整 --window-size。它較適合需要串流處理、長影片放大或受 GPU 記憶體限制的研究者與影像工作流程,但輸出沒有音訊,亦仍依賴 NVIDIA GPU,未必適合一般消費級電腦直接處理高解像長片。
項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視頻模型, NVIDIA, Video, Image, Audio, Linux, Python, 中國, 強化學習

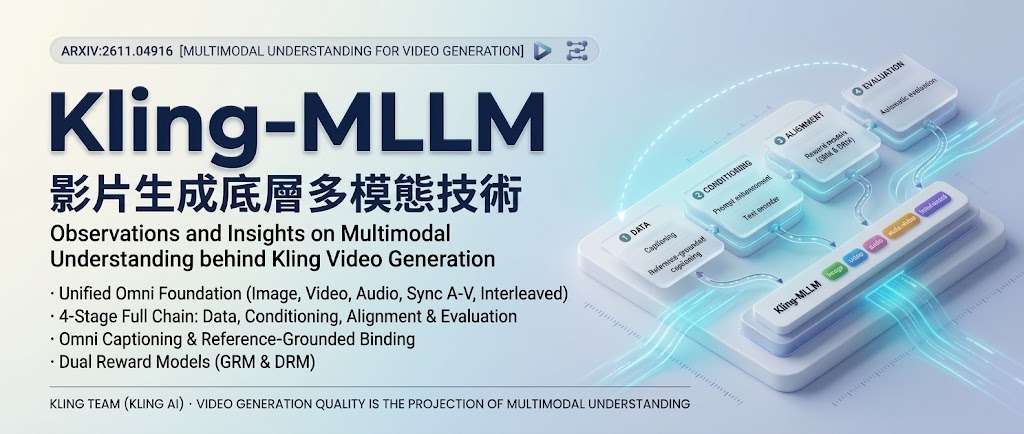
[技術文章] 影片生成的背後故事:Kling 的多模態理解觀察與見解

影片生成的瓶頸正由畫面渲染轉向語意控制。Kling 團隊拆解資料、提示、對齊與評估環節,說明如何令生成結果更貼合使用者意圖。

Hero image preview

當影片生成要跟從複雜描述、維持人物與物件一致,單靠提升畫面品質並不足夠。Kling 團隊的技術報告聚焦多模態理解,分析資料、條件輸入、對齊和評估如何共同影響生成結果,適合關注可控影片生成的研究者與產品團隊參考。

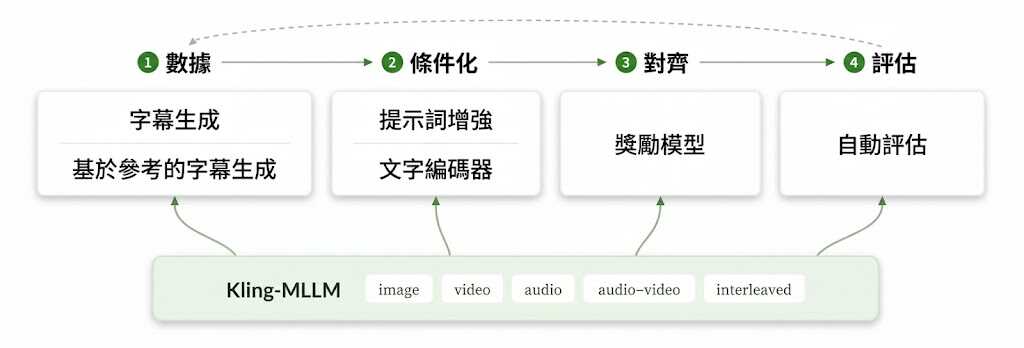
研究以 Kling-MLLM 為共用基礎模型,處理圖片、影片、音訊、同步影音及交錯輸入,再按不同下游任務作專門調整。團隊指出,DiT 的訓練樣本遠少於語言模型,因此字幕不能只求流暢,而要作為高密度的語意契約;延伸出的 reference-grounded captioning,亦會明確標示描述與參考內容的對應關係。

提示詞增強負責把使用者意圖轉成生成模型較能處理的描述分佈。基本方法由優質影片字幕整理而成,再配合文字層面的強化學習及生成器迴圈微調;agentic prompt enhancement 則會進一步整理故事,並檢索具參考價值的例子。報告亦指出,可靠的 text encoder 需要感知訓練,單純提升語言能力並不足夠。

報告涵蓋的技術重點包括:
– 以共享多模態模型支援不同輸入形式及下游模組。
– 用高密度字幕和明確參考綁定,補足訓練語意與素材之間的連結。
– 以可解釋、能定位問題的通用 reward model,配合快速多維評分的 decision reward model。
– 設計任務專用自動評估,揭露評分捷徑,並協助追查上游失誤。

這套思路適合用於影片生成系統的資料整理、提示處理、模型對齊和品質診斷;團隊也強調,感知能力、描述品質與評估協定需要一併設計。內容屬於 Kling 團隊對其多代系統經驗的整理;提供的資料亦未列出可供外部讀者直接重現的完整流程。

Paper

Categories: Agentic, AI productions, 多模態模型, 視頻模型, 模型訓練, Video, Image, Audio, 提示詞, 強化學習

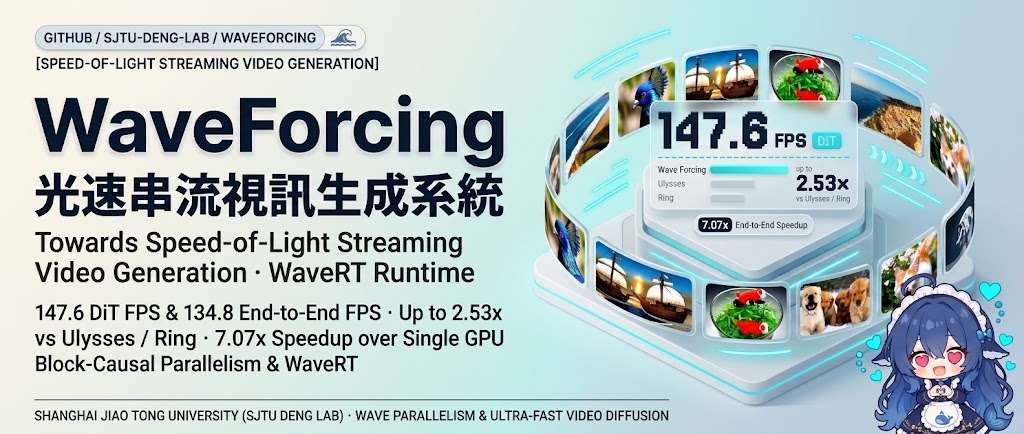
WaveForcing:讓多步影片生成每秒 134.8 幀

WaveForcing 讓多段影片同步去噪,持續輸出畫面;高速度背後,仍要付出多張高階 GPU 的成本。

Wave Forcing logo

WaveForcing 讓影片不同片段同步去噪,毋須逐段完成才繼續。這套串流影片擴散方法在流水線填滿後,每輪前向運算便輸出一個片段,適合研究連續影片生成的團隊。

Wave Parallelism 讓各張圖形處理器(Graphics Processing Unit,GPU)持有完整模型,分工處理不同片段與去噪階段,而非拆開模型。較嘈雜的新片段可參考較乾淨的舊片段,Wave Runtime(WaveRT)則把資料傳送與運算重疊,減少等待。

  • WaveForcing-1.3B 提供 4-step、5-step 權重。
  • 推理程式與 WaveRT 已開源。
  • 快速開始範例採用八張 GPU,並非單卡配置。

測試環境已驗證 Python 3.12、PyTorch 2.11.0+cu128、SGLang diffusion runtime 及 Hopper GPU。準備測試須下載基礎模型與 WaveForcing 權重。

4-step 版本在八張 H200、832×480 解像度下,連同解碼達每秒 134.8 幀。這個結果展示多卡串流吞吐量,不能當作單卡速度或首幀延遲;硬件成本仍是採用門檻。

項目主頁 · GitHub · 模型

Categories: 開源, 北京大學, AI productions, 模型, 視頻模型, Video, Python, 中國

387 篇獨特論文與資源,關於影片生成遇上 Harness

想了解 AI 影片生成如何由單次生成走向規劃、互動和持續改進,這份研究索引整理了 387 篇論文與相關資源,並提供三條互補的閱讀路徑。

Video Rebirth

由創作影片、探索生成世界,到改進生成系統,研究者關心的問題各不相同。Awesome Agentic Video Generation 是一份論文與資源索引,整理 Agent harness 如何連接目標、工具、記憶、回饋與執行流程,協助讀者追蹤 Agentic Video Generation、Agentic World Modeling 和 Recursive Self-Improvement(RSI)相關研究。

三條閱讀路徑分別聚焦影片創作流程、生成世界中的行動與狀態,以及資料整理、模型訓練、評估和改進程序。它們代表不同研究情境,而非能力排名;同一項資源亦可能出現在多條路徑中,387 是去重後的總數。

索引收錄的題目涵蓋從創作簡報規劃影片、生成鏡頭和後期剪輯,到讓代理在生成世界中行動並維持狀態。例如 CutVerse 聚焦媒體後期剪輯的 GUI agents benchmark;CineAGI 探討以 LLM 編排多模態生成及跨場景整合。這些題目讓讀者可以按工作流程或研究問題尋找相關方向,但索引本身不代表每個項目都已證明具備 RSI。

  • 創作:查找規劃、素材、鏡頭生成、剪輯與來源追蹤相關研究。
  • 互動:追蹤動作條件影片、語意控制、狀態記憶及互動世界評估。
  • 改進:了解資料、訓練、評估和 harness 改進如何支援未來的 RSI 研究。
  • 延伸閱讀:資源連結通往論文或項目;整理者亦提供貢獻入口,方便提交新資源。

對研究者、影片生成系統開發團隊,以及需要快速掌握相關文獻的讀者,這份索引可作為分類閱讀的起點。它的價值在於整理與導覽,而非提供可直接執行的影片生成工具。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 多模態模型, 視頻模型, 模型訓練, Video, World-Action Model, 工具, Dataset 數據集

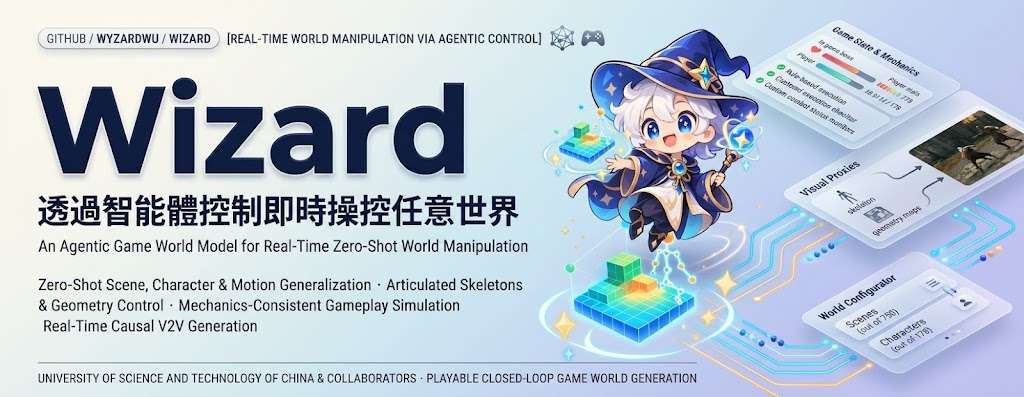
Wizard:讓 AI 即時改動遊戲世界與戰鬥規則

Wizard 讓玩家用指令改變場景、角色和戰鬥狀態,再即時生成連貫影片。它適合探索互動遊戲原型與可控世界模型的創作方式。

favicon

改變地形、召喚敵人,甚至令角色變身,Wizard 都能把這些操作整合到即時遊戲畫面中。這個世界模型項目以代理控制修改遊戲狀態,再由影片生成模型呈現變化,目標是讓互動不只限於移動角色,也能改動環境與戰鬥規則。

使用者可透過按鍵、文字指令或單張畫面控制世界。場景幾何、角色骨架、動作和戰鬥狀態會分開記錄,因此系統可以處理平台升降、地面變形、角色攻擊與受傷等變化;影片生成器則以每秒 24 幀輸出畫面。項目亦稱,展示中的場景和角色都是模型未曾見過的內容。

整個流程分成快速建置和遊戲期間的控制。建置階段會重建場景與角色、配置骨架並整理動作;遊戲期間,代理更新幾何、動作和戰鬥狀態,再交由 Wan2.2-TI2V-5B 生成影片。文字指令會轉成幾何操作程式,戰鬥則由狀態追蹤、攻擊規劃和規則控制器處理。

• 適合想測試可互動遊戲場景、角色動作及戰鬥變化的研究者與創作者。
• 可用文字指令、按鍵或畫面輸入控制世界,也能比較生成影片與場景代理畫面。
• 每秒 24 幀生成,並以兩步去噪處理;項目描述的建置階段少於五分鐘。
• 程式碼尚未公開,現有資料亦未提供下載或使用流程。

Wizard 把可明確追蹤的遊戲狀態與即時影片生成結合,適合探索「能否直接操控世界規則」這類互動設計。它的應用仍受限於目前展示和程式碼尚未開放的狀態,外部使用者暫時難以自行驗證或整合。

項目主頁

Categories: 騰訊, Agentic, AI productions, 模型, 視頻模型, 世界模型, Qwen, Video, Image, 框架, Content Creator, 動畫

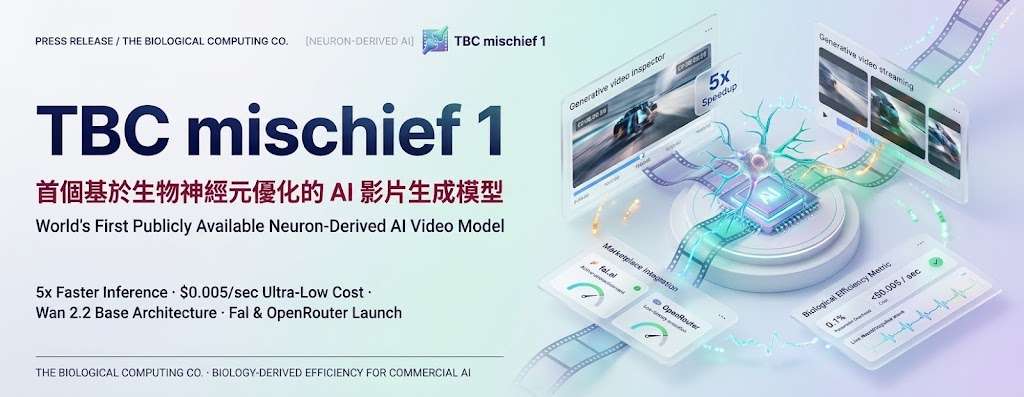
mischief 1:用生物神經元技術加速影片生成

mischief 1 建基於 Wan 2.2,主打以相近質素提供快 5 倍、成本更低的 image-to-video 生成。

6aa474e3eb96b19a0696dbe6 cta row bg

生成影片最花時間和預算的地方,往往是反覆試做、比較不同版本,再逐步修正畫面。TBC mischief 1 是 The Biological Computing Co. 推出的 AI video model,透過從活神經元取得的計算效率,處理 image-to-video 生成速度和成本之間的取捨。

TBC執行長兼聯合創辦人Alex Ksendzovsky表示:「我們曾說過,要將對活體神經元的研究成果轉化為人人都能使用的產品,而我們實現這一目標的速度遠超預期。這個模型背後是一個持續學習的發現平台。每一次實驗都加深了我們對神經元計算方式的理解,並為我們改進人工智慧提供了新的契機。」

模型建基於廣泛使用的 open-weight video model Wan 2.2,TBC 表示 mischief 1 在保持相近質素的同時,生成速度提升至基礎模型的 5 倍。項目已在 fal 和 OpenRouter 提供,定價為每秒半美仙;五秒短片約需 2.5 美仙,100 段影片約為 2.50 美元。

較低成本適合需要大量試作的影片創作者、AI-native creative studio,以及把影片生成功能整合到產品的開發者。Wonder Studios 測試後表示,模型讓團隊可以在相同時間和預算內反覆推進創意;不過,來源內容未提供具體畫質指標、支援格式或詳細使用流程。

  • 建基於 Wan 2.2,主打相近質素與更快生成
  • 生成速度較基礎模型快 5 倍
  • 每秒半美仙,適合大量試作和版本比較
  • 可在 fal 和 OpenRouter 使用
  • 技術效率來自 TBC 對活神經元計算方式的研究

項目主頁

Categories: AI productions, 模型, 視頻模型, Video, Image, World-Action Model, Content Creator

L3G-World 可以連續生成長達數分鐘影片

L3G-World 把單張影像、文字提示和鏡頭路徑接成可持續探索的 3D 世界,重點在長片段一致性與生成速度。

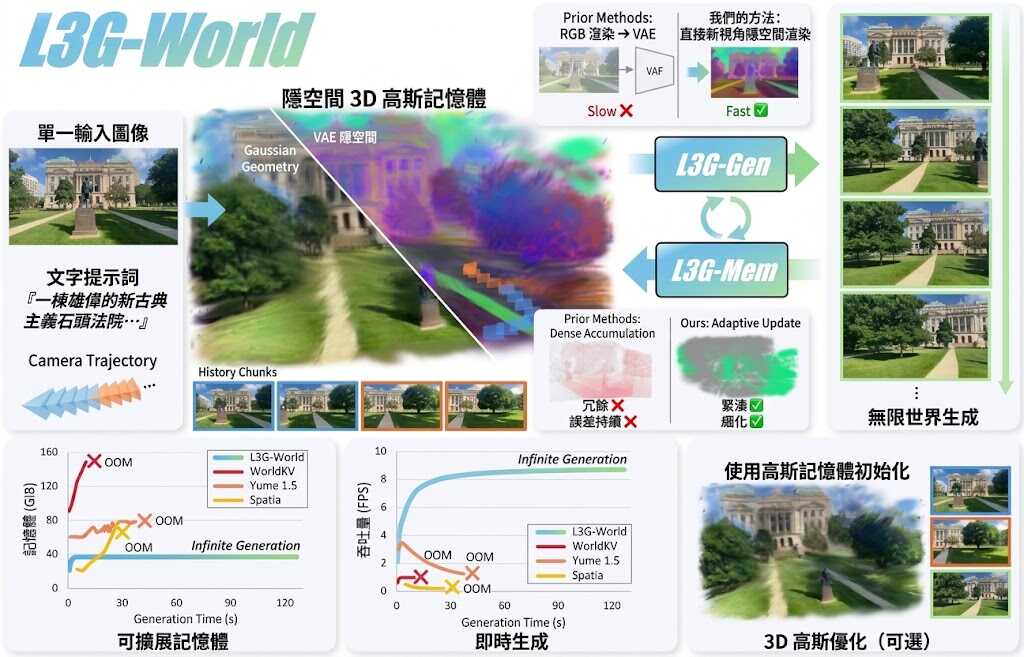
L3G-World overview: input images, text and cameras initialize latent 3D Gaussian memory; L3G-Mem updates the memory whil

由單張影像、文字提示和鏡頭路徑開始,L3G-World 可以連續生成長達數分鐘、視角一致的影片。它屬於世界模型及視頻生成模型項目,針對長時間生成容易失去場景結構、記憶不斷膨脹的問題,加入可持續更新的 3D 記憶。

L3G-Mem 會在新探索區域建立 Gaussian,重訪舊區域時則修正原有幾何資料;L3G-Gen 再利用更新後的記憶,自回歸生成下一段影片。每個 Gaussian 儲存 VAE latent,直接渲染到 diffusion 的 latent space,省去先渲染 RGB、再重新編碼的步驟,配合 few-step video model,目標是支援即時生成。

  • 長時一致性:影片片段會共享持續更新的 3D memory。
  • 記憶增長受控:記憶量跟隨探索範圍,而不是單純跟隨影片幀數增加。
  • 多視角探索:支援單張影像或少量多視角輸入,沿不同 camera trajectory 延伸場景。
  • 速度取捨:直接 latent rendering 減少重建成本,但項目仍屬研究原型。

對需要從影像建立可探索場景的研究團隊、世界模型開發者、機械人和虛擬環境項目較有參考價值。相比每段影片獨立生成的做法,它把場景記憶放入閉環流程;代價是需要同時處理 3D Gaussian 記憶、latent rendering 和擴散模型,工程整合較複雜。

項目首頁展示了 minute-long generation、不同鏡頭路徑和多視角場景延伸,但未提供明確的 FPS、GPU 型號或 VRAM 要求。儲存庫列出的 L3G-Mem、L3G-Gen、推理程式及 Fast checkpoints 仍在發布計劃中,因此目前只能按公開展示理解能力,未能據此確認安裝流程、所需硬件或可直接部署程度。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 視頻模型, 世界模型, Video, Image, World-Action Model, 3D, 庫

JCA 讓文字生成可重播的 3D 動作與影片

文字提示不只生成畫面,JCA 亦同步產生可重播的 3D 動作,並支援場景及關鍵影格控制。

Paper overview: rigs and scene images, keyframes, video, or rig motion enter JCA to produce scene-aware animation, keyframe-controlled motion, recovered rig motion, or video.

文字生成影片時,動作通常只留在畫面裏,難以直接套用到指定的 3D 角色,或放回原有場景。NVIDIA Research 的 Joints, Camera, Action!(JCA)同步生成影片、3D 骨架動作與鏡頭資訊,讓動作可以重播,並對應到 3D 場景。

JCA 支援不同骨架結構,不限於人形角色。輸入圖片可令動作回應周邊環境,加入少量關鍵影格則可控制動作軌跡;模型亦支援由影片還原骨架動作,或由骨架動作生成影片,適合 3D 資產動畫、場景化影片製作和動作擷取。

  • 文字提示可生成同步的影片與 3D 動作。
  • 輸入圖片和關鍵影格可提供場景及動作控制。
  • 支援不同骨架結構,並可進行影片與動作之間的轉換。

模型以圖編碼器描述骨架,並讓獨立的動作模型與預訓練影片生成器透過少量 cross-attention layers 交換資訊。動作模型可先利用較易取得和擴增的純動作資料學習;它亦會定位影片中的關節,以推算鏡頭位置,協助把 3D 動作放回場景。

訓練資料接近 20 萬組配對,涵蓋人類與機械人影片,以及經整理、確保動作有效的 3D 資產場景影片。研究團隊表示,評估中 JCA 比以影片生成為先的流程更貼合文字描述,動作也能回應場景;原文沒有列出量化指標,效果幅度仍難以比較。

項目主頁

Categories: AI productions, 模型, 視頻模型, 模型訓練, NVIDIA, Video, Image, World-Action Model, 教學, 3D, 動畫

WorldCast 預測並生成世界狀態

WorldCast 把視覺生成拉到多步推演:模型要交代世界如何逐步變化,而不只是交出一張合理終局圖。

(a) The four-level capability tree of visual generation. (b) The WorldCast benchmark and overall results.

當任務要求模型根據觀察、物件參照和操作示範,預測一個過程接下來會怎樣發展,單張圖片的合理性已經不夠。WorldCast 屬於視覺生成基準測試,實際處理的是多模態模型如何理解不同參照在何時生效,並生成一連串有因果關係的世界狀態。

它把能力分成 L1 至 L4:由靜態 text-to-image,推進至編輯、主體參照和 text-to-video,再進入複雜限制、物理合理性及把現實情境轉化為行動。WorldCast 聚焦較少被量度的 L3、L4,涵蓋 320 個人工設計案例、1,352 個視覺狀態及 8 類任務,並同時測試 unified systems、multi-reference image models 和 video models。

• 評分把 grid、interleaved 和 video 輸出視為有次序的狀態序列
• 參照內容可以是觀察狀態、目標、規則、物料特性或示範程序
• 12 個代表性模型接受同一套評估協議及 Judge rubrics
• GPT-Image-2.5 System 取得 72.8 分,反映前沿模型已出現早期世界狀態預測能力

可從 Hugging Face Dataset 取得資料測試,配合項目提供的 evaluation toolkit 和 Evaluation Guide 重現評分;模型亦可輸出逐格圖像、交錯圖像或影片。結果差距會在較高層次任務擴大,interleaved generation 對圖像模型有幫助,但評測仍集中於人工設計案例,未等同於真實環境中的長期規劃能力。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, AI productions, 模型, 多模態模型, 視頻模型, Video, Image, txt2img, Dataset 數據集

ATAS 以持續世界記憶改善長片生成一致性

ATAS 讓每個鏡頭共享可回訪的世界狀態,減少長片生成中人物、場景與事件難以保持連貫的問題。

ATAS: Any Time, Any Space

長片生成最難處理的不是單一鏡頭是否漂亮,而是角色重返同一地點、事件在不同時間再次出現時,畫面能否維持一致。ATAS(Any Time, Any Space)屬於 agentic video generation 框架,將劇本拆成包含場景、鏡頭、時間及事件的 shot request,再以持續更新的世界狀態支援後續生成。

ATAS 沒有只把上一個鏡頭或提示詞傳給下一次生成,而是分開保存兩類記憶:Scene Memory 記錄已註冊的靜態幾何,Event Memory 則按場景、事件和時間索引動態觀察。新片段生成後會被重建、註冊及檢查,只有通過審核和狀態驗證的內容才會更新記憶;影片交付則不受記憶是否接納影響,減少錯誤觀察污染後續鏡頭的風險。

• 將劇本編譯成具體的場景、相機和事件時間要求
• 支援從不同視角回訪同一場景
• 可重現較早時間點發生過的事件
• 生成後進行註冊、審核及世界狀態檢查

項目展示的差異,在於把跨鏡頭一致性視為世界狀態管理問題,而不是單純延長上下文或串接最近畫面。這會增加記憶建立、片段重建和驗證所需的計算與流程複雜度,但更適合長片、分段製作及需要角色與場景持續連貫的內容工作流。

研究結果涵蓋四個影片生成器;ATAS 在報告的跨鏡頭一致性指標均有改善,並在每個 backbone 取得最高綜合 benchmark 分數。它亦在目標影像空間回訪、三項事件重現指標及六項人工評分準則中領先比較的 agents 和 3D-guided methods。儲存庫目前主要提供研究程式碼、技術資料及示範,使用者需要按項目頁面的環境與模型依賴自行重現流程。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 視頻模型, Video, Image, World-Action Model, 提示詞, 框架, 3D, 庫, Dataset 數據集

Page 1 of 18
1 2 3 … 18