WorldFoundry:影片、3D 世界放進同一模型工作流

研究團隊將會可以用同一套工作流探索模型、執行生成、檢查產物及比較評測結果;不同模型的輸入方式與評測協議仍各自保留。

WorldFoundry WeChat Group 1

WorldFoundry,一套用於影片、3D 與 4D、具身動作及互動式世界系統之可重現推論與評估的開源基礎設施。WorldFoundry 把影片生成、互動世界、3D/4D 重建及具身動作模型放進同一套推理與評測工作流,屬於開源框架。它處理的問題是:模型種類繁多,如何整理執行條件、檢查生成結果,並在保留各自協議的情況下比較評測資料。

推理可透過命令列、終端介面或瀏覽器版 Studio 執行。Studio 亦可檢視任務狀態、生成媒體與幾何資料,評測則以模型和基準的組合執行,並整理正規化指標、就緒狀態及資格評分卡。

它沒有把不同模型硬塞進相同的評測方式,共享的是目錄、素材格式與結果計算流程,原生輸入、執行語義和評測協議仍按模型保留;評分亦區分文件宣告的支援、操作就緒程度與已驗證表現,避免把列入目錄或展示範例當成基準成績。

執行環境要求 Linux 和支援 CUDA 的 NVIDIA GPU;預設統一環境需要支援 CUDA 12.8 或以上的驅動。推理、Studio、評測及開發共用 CUDA 環境,但 ABI 或模擬器等個別模型需求可能需要不同環境。

  • 目錄涵蓋影片、互動世界、3D/4D、VLA/VA/WAM 等模型類別。
  • 可在 CLI、終端介面及瀏覽器版 Studio 執行目錄內的推理流程。
  • 生成影片、幾何資料與執行紀錄可供檢查,亦可在生成後重新評分。
  • 比較結果時需留意各模型仍採用不同輸入方式與評測協議。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, AI productions, 模型, 世界模型, NVIDIA, DeepSeek, Video, VLA, World-Action Model, 框架, 3D, Linux

Embodied Agent Arena:測試十款 VLM 的任務能力

十款前沿視覺語言模型接受 1,000 個具身任務測試,結果顯示,能生成可執行動作,不代表能完成多步操作或精細接觸任務。

logo transparent

要判斷視覺語言模型(Vision-Language Models,VLMs)能否勝任機械人通用操作,不能只看它有沒有成功發出動作。Embodied Agent Arena 是一個具身代理評測項目,以共同測試流程比較十款模型在五類能力上的表現,涵蓋 1,000 個案例,並把幾何理解、空間推理和視覺定位納入評測。

項目把任務理解、推理和動作選擇交由模型處理,再以同一套精簡評測框架測試不同模型。測試資料整合 32 個既有來源,另加入 168 個案例的 GeoProbe 幾何基準;相比只看機械人互動任務,這種安排能同時檢視模型理解空間資訊的能力,以及能力能否轉化為實際任務成果。

結果反映,單一指標容易掩蓋任務是否真正完成。Gemini 4 Argon 的 3D 路徑誤差最低,為 0.310 米,但 56 條路徑中只有 24 條符合全部限制;Manipulation 成功率最高的 Opus 5.5 亦只有 47.8%。CALVIN 測試中,100 個序列有 60 個完成第一個目標,完成全部五個目標的只有 9 個;在五項 ManiSkill 診斷任務中,Opus 5.5 能完成拾取、放置和堆疊,卻未能完成插入插銷或充電器。

  • 同一批 157 項 Planning 任務中,至少有一款模型完成 142 項;仍有 15 項十款模型全部失敗。
  • Astra 的 31 項失敗任務耗用 55.5% token;失敗任務平均耗用的 token 是成功任務的 5.1 倍。
  • CALVIN 有 65 個序列曾遇到執行錯誤;其中 62 個後來能無錯執行程式碼,但只有 3 個最終完成序列。
  • Case Atlas 收錄 181 個涵蓋五類能力的案例,提供十款模型的紀錄;缺少影片的項目會使用共用任務場景,API 中斷則標記為失敗嘗試。

這些結果適合用來比較模型在哪些環節失手,亦提醒研究團隊不要把路徑精度、程式碼執行成功或單一步驟操作,直接當成完整任務能力。項目提供線上結果、案例影片、資料集及程式碼。

項目主頁 · GitHub · 數據集

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, AI productions, 世界模型, Qwen, DeepSeek, Gemini, API, VLA, Robotic, 框架, 香港, Anthropic, Dataset 數據集

REA:讓機械人執行動作時不必等待 AI 思考

機械人控制常要在慢速推理與即時動作之間取捨,REA 透過路由與復原機制,讓執行中的控制政策不必停下來等候大腦回應。

Og image

機械人執行動作時,若每一步都要等 AI 完成較慢的推理,控制就可能停頓。REA(Routed Embodied Agent Runtime)是為具身智能代理設計的執行框架,讓負責推理的「大腦」與快速控制的「小腦」非同步協作,並在需要時路由任務或復原執行流程。

這種安排適合需要連續動作、同時又要處理複雜指令的機械人工作流。REA 可協調 VLA(Vision-Language-Action)模型與程式控制政策,讓系統按任務選用不同控制方式;推理延遲不會直接令正在執行的控制政策停下來。

評測結果包括:在 3,000 個 LIBERO-Pro 測試回合中取得 95.9%,控制步數減少 25%;在 RoboTwin 2.0 中,結合 VLA 與程式政策取得 86%。頁面亦稱,REA 在 BEHAVIOR-1K 與真實 Unitree G1 測試中解決的回合數最多,但沒有提供這兩項測試的具體數字。

  • 推理與快速控制非同步進行,執行中的政策毋須等待大腦回應。
  • 透過路由與復原機制,協調不同類型的控制政策。
  • RoboTwin 2.0 評測結合 VLA 與程式政策,結果為 86%。
  • 項目頁需啟用 JavaScript 才能查看互動圖表;提供的內容沒有安裝或下載步驟。

REA 適合研究機械人長流程任務、異質控制政策協作,以及推理延遲如何影響動作連續性的團隊。現有內容提供多項基準測試結果,但未列出各項實驗設定與比較基線,閱讀數字時仍需留意這些資訊限制。

項目主頁 · 模型

Categories: Agentic, 模型, 視覺模型, 多模態模型, VLA, Robotic, 框架, Discord

ScaleNav 把影片變成導航能力

ScaleNav 先從互聯網第一視角影片學習路徑規律,再轉成機器人動作,面對語言指定目標的局部導航。

ScaleNav navigation: real robot on the left, simulation on the right

網上第一視角影片 seldom 附帶機器人動作,但當中蘊藏大量「沿走廊前進、避開障礙、轉入目標房間」的視覺規律。ScaleNav 是一個研究型導航模型,試圖把這些 action-free 預訓練所得到的 navigation priors,轉移到有動作標籤的模擬軌跡,再用於 language-conditioned local navigation:按文字尋找初始畫面可見的目標並停下來。

模型屬共享式 Diffusion Transformer,會根據指令、目前 RGB 影像及記憶,共同預測未來 video latents 和 action chunks。流程分三階段:先從互聯網第一視角影片學習目標導向視覺動態,再進行 action alignment,最後 joint fine-tuning,同時保留影片回放並微調共享骨干與輸出頭。

ScaleNav 與同類做法的主要取捨,是毋須先收集大量完整機器人示範,便能借助互聯網影片建立導航先驗;代價是仍要依賴模擬軌跡、動作對齊及多階段訓練。官方模型約 10.02 GB,推論及評估建議使用支援 BF16 的 NVIDIA GPU、24 GB GPU 記憶體與 64 GB 系統記憶體,並按文件配置 Linux、Habitat-GS 和場景轉換工具。

結果涵蓋 HabitatGS-LN、Short-Horizon OVON 與真實四足機械人;公開資料列出 ScaleNav 在兩項模擬評估的成功率分別為 94.9% 及 86.5%,真實機械人則在 60 次試驗中錄得 83.3% 成功率。團隊亦整理 gallery 導航影片、軌跡、目標與結果,以及 summary.json 內的 SR、SPL 和逐任務成績,方便比較與重現。

  • 影片預訓練不必附帶逐格動作標籤
  • 同一模型處理影片動態與動作生成
  • 支援模擬環境及真實四足機械人
  • 提供模型、資料、評估結果與操作文件

這套方法較適合研究 embodied navigation、 robotics 與 VLA(Vision-Language-Action)的團隊;評估數字雖亮眼,仍須留意各方法採用不同設定,跨模型比較應同時核對 episode 數、場景及 fine-tuning 條件。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視覺模型, 多模態模型, 模型訓練, NVIDIA, Video, Image, VLA, Robotic, 工具, Linux

[技術文章] 阿里 CommerceGen-Studio:商用級主圖生成端到端框架

把白底 SKU 商品照變成可上架主圖,並以幾秒延遲處理每日百萬級流量。

Hugging Face

白底商品照難以直接吸引搜尋頁點擊,CommerceGen-Studio 由 Alibaba Group 提出,面向電商 SKU 粒度的商業主圖生成。來源沒有交代具體 base model 或 fine-tuned from 哪個模型,因此無法確認其原始基礎模型。

系統分成資訊抽取、語義改寫及多條件生成三階段。Prompt-Eval-Refine-Loop Agent(PERL-Agent)讓 VLM 與 LLM 按照 reference-free rubric 反覆整理商品資料;Layout Thinker Optimization(LTO)則同時以文字描述及渲染圖片質素調整改寫策略。

SKU-DiT 透過 Reinforce-Distill-Reinforce(RDR)漸進式訓練,聯合使用白底商品圖、商標裁剪圖及結構化版面條件,兼顧商品外觀、商標完整性和字元級文字準確度。系統聲稱已達到每日生成數百萬張主圖、每張延遲數秒,並在 CommerceGen-Bench 的兩條編輯測試中勝過所比較的開源基線,部分指標可媲美或超越大型閉源模型。

  • 檔案與推論:來源是研究論文內容,沒有提供 GGUF 檔名、檔案大小、量化級別、mmproj 或 chat template。
  • 框架支援:論文摘要沒有公開各項數值分數,也未交代 SKU-DiT 的參數規模及訓練資料細節。
  • 適用場景:重點在大量電商商品主圖生產,而非通用文字轉圖片服務。

CommerceGen-Studio 與單一生成模型的差異,在於把商品資料理解、賣點整理、版面規劃及圖片生成串成完整項目流程;CommerceGen-Bench 則以真實流量中的困難案例測試 Instruction Following 和 Product Integration。由於缺乏公開權重、量化檔案及硬體規格,讀者目前較適合把它視為可大規模運行的研究框架,而非可直接下載的本地模型。

Paper

Categories: 開源, 阿里巴巴, Agentic, 模型, 視覺模型, 模型訓練, Image, 影像模型, VLA, 框架, LLaMa, Ollama, Dataset 數據集

GroundingPI 以 4B 視覺基礎模型連接感知與機械控制

GroundingPI 把視覺定位轉成可供機械系統使用的點和框,主打複雜場景下的精準感知與控制效率。

GroundingPI

要讓自動駕駛或機械人準確知道「要處理哪件物件、位置在哪裏」,單靠一般視覺語言模型仍可能在雜亂畫面和細小物件上失準。GroundingPI 屬於視覺 grounding foundation model,以 4B 參數模型處理定位問題,輸出可供後續控制使用的視覺結構。

模型以 visual primitives 為核心,將點和框表示成 shared vocabulary 中的 quantized coordinates,再配合 vision-language model、tokenizer、processor 和 custom model code。這種做法針對 VLA(vision-language-action)及 WAM(world-action models)常見的感知瓶頸,並讓 perceptual foundation 可以轉移到 autonomous driving 和 robotic manipulation。

  • 定位方式:同時支援點與框,適合指定目標及描述空間位置。
  • 模型規模:4B 參數,目標是在能力與運算成本之間取得平衡。
  • 評測結果:涵蓋 34 個 grounding benchmarks、11 種感知能力,對比 44 個基準模型平均達 73.68%,高於 GPT-6 Astra 的 71.54%。
  • 轉移價值:在 ID 和 OOD 評估,以及 action-data efficiency 方面,展示對自動駕駛和機械人操作的幫助。

對研究團隊而言,GroundingPI 不只是單次定位模型,亦可作為 System-1 foundation-model 的感知層,補足未必擅長精準 grounding 的通用視覺模型。項目提供 Hugging Face 模型及 Demo,並列出 vLLM、Transformers backend、OpenAI-compatible API 和 JSONL batch annotation 工作流;不過提供的儲存庫資料未交代完整硬件需求,部署前仍需按文件確認環境。

研究重點同時放在 pretraining scale 和 data composition 如何影響 grounding 及轉移效果。需要即時視覺定位、閉環控制或希望減少 action data 的自動駕駛、機械人及 embodied AI 團隊,會較容易從這個模型的感知能力受益;純文字或一般影像分類工作則未必能直接發揮其價值。

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 香港科技大學, 北京大學, 清華大學, 模型, 視覺模型, 多模態模型, 模型訓練, API, Image, VLA, World-Action Model, Robotic, 香港, 庫, Tokenize

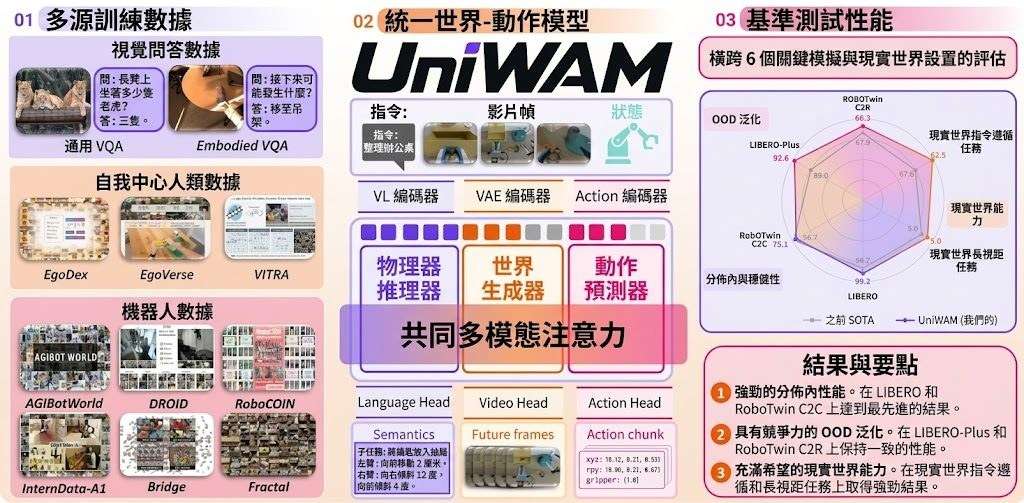
UniWAM 把理解、預測與機械人動作合而為一

UniWAM 以 8B 參數模型整合語意理解、視覺預測和動作生成,瞄準機械人操作中理解與執行脫節的問題。

UniWAM teaser

面對需要理解指令、預測環境變化再控制機械人的任務,UniWAM 將三個步驟放進同一個 8B-parameter 模型,屬於結合世界模型與 Vision-Language-Action(VLA)的開源研究項目。它以 Mixture-of-Transformers(MoT)連接 physical reasoner、world generator 和 action predictor,讓三者透過 joint multimodal attention 交換資訊。

模型不只依賴機械人示範,預訓練亦混合 human egocentric data、robot data 及 visual question answering(VQA)資料,並把低層動作轉成自然語言,改善視覺語言能力與實體操作之間的銜接。Post-training 再加入 future visual noise augmentation,配合 history-conditioned flow matching,以較少 denoising steps 生成動作。

  • 整合範圍: 同時處理 physical reasoning、視覺生成與動作預測
  • 訓練訊號: 結合機械人、第一身人類視角及 VQA 資料
  • 效率設計: 用動作歷史初始化生成流程,減少 denoising steps
  • 硬件成本: RoboTwin 2.0 post-training 曾以 8 張 NVIDIA H100 GPU 執行 10 小時

GitHub 儲存庫提供 models/、train/ 和 utils/ 等模型與訓練程式,並附有 RoboTwin 2.0、LIBERO 及 LIBERO-plus 的資料處理和評估工具。Python 3.10、CUDA 兼容的 PyTorch 環境較適合測試,使用者可先以模擬器資料和配置檔驗證訓練或推理流程。

項目首頁宣稱 UniWAM 在 in-distribution、robustness、generalization 及 instruction following 等多項評估取得 SOTA,但儲存庫提供的資訊未列出完整分數和比較表。Bridge、DROID、Fractal 以及 real-world inference 明確不在今次發布範圍內,因此它較適合研究團隊測試統一式機械人模型,而不是即時接駁真實機械人的現成方案。

項目主頁 · GitHub · 項目

Categories: 開源, 香港科技大學, 北京大學, 模型, 視覺模型, 多模態模型, 世界模型, 模型訓練, NVIDIA, VLA, Robotic, 香港, 工具, Python, 庫, Dataset 數據集

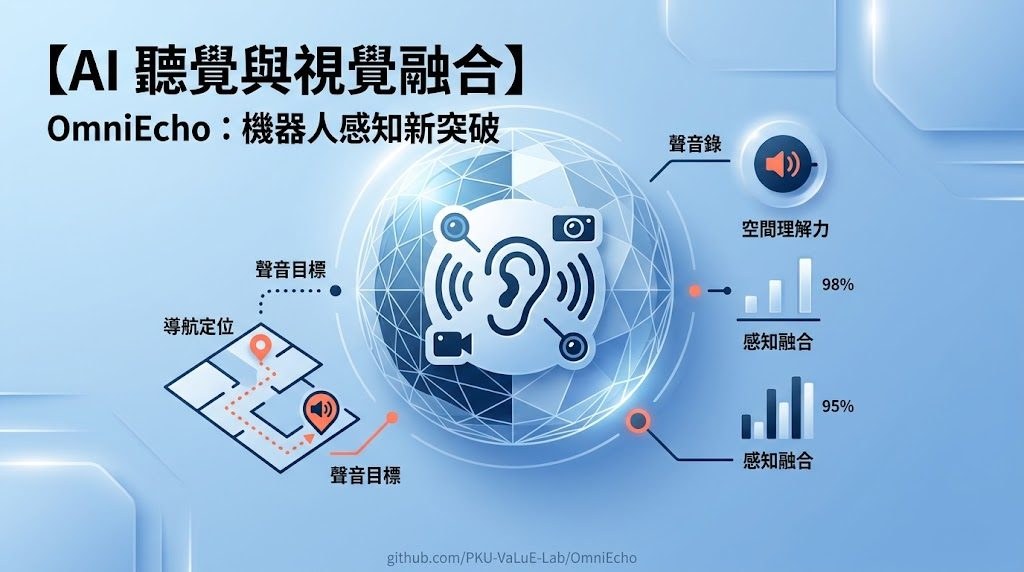
OmniEcho:讓智能體真正「聽聲辨位」的全方位音視覺模型

聲音從哪個方向來、距離多遠,是人類憑本能就能判斷的事,對機器人卻是一道難題。OmniEcho 把一階 Ambisonics 空間音訊、視覺與語言整合到同一個智能體,專門研究這類空間感知與聲源導航。

Repository image for PKU-VaLuE-Lab/OmniEcho

OmniEcho 是一個面向 embodied agent 的音視覺空間感知項目,由北京大學 PKU-VaLuE-Lab 開源。它要解決的問題很直觀:當一個智能體同時聽到聲音、看到畫面,它能否判斷聲源在哪個方向、距離多遠,並進一步循聲走去?這件事對人類毫不費力,但要讓 AI 真正做到,過去並不容易。

項目同時提供三樣東西:統一基準 OmniEchoBench、可控的空間音訊渲染管線,以及基於 Qwen3-Omni 改進的 OmniEcho 模型。後者最關鍵的設計,是在 Qwen3-Omni 既有語意音訊通路之外,加掛一個專門處理 FOA(一階 Ambisonics)空間資訊的編碼器,讓模型同時理解「聽到什麼」和「聲音從哪來」。

基準涵蓋六類任務,合共 197 個真實音視覺場景、2,972 條 QA 與 900 條導航樣本,全部由人工核對標註。OmniEcho 在空間音視覺感知上達到 state-of-the-art,而循聲導航的表現已經逼近傳統「靠文字指示」的視覺語言導航。不過細粒度的方位判定與距離估計,仍被作者列為尚未解決的難題。

對做機器人導航、音視覺融合研究,或需要智能體在真實場景中聽聲定位的團隊,這套項目提供了一個可以直接拿來跑評測、訓練、再挑戰的起點。原文並未附上完整的安裝或下載流程,相關代碼與模型權重目前標示為即將釋出。

重點摘要

  • 空間音訊加視覺語言:以 FOA 為輸入,與視覺、語言一起餵進 omni-modal agent。
  • 雙編碼器設計:在 Qwen3-Omni 之上新增 FOA 空間編碼器,保留原有語意音訊能力。
  • 真實世界基準 OmniEchoBench:六類任務、近 3,000 條 QA 與 900 條導航樣本,人工核對。
  • 循聲導航貼近文字導航:在 Nav 任務上接近傳統 VLN 水平,但方位與距離仍偏弱。
  • 代碼與權重待發佈: 標示 Coming Soon,暫無公開安裝步驟。

GitHub

Categories: 開源, 北京大學, Agentic, 模型, 視覺模型, 模型訓練, Qwen, VLA, Audio

Grounded-Action-Model:讓機械人先理解物件位置,再決定如何動作

Grounded Action Model 把語言、點和框選提示轉成同一套 3D 物件表示,提升機械臂面對場景變化時的穩定性。

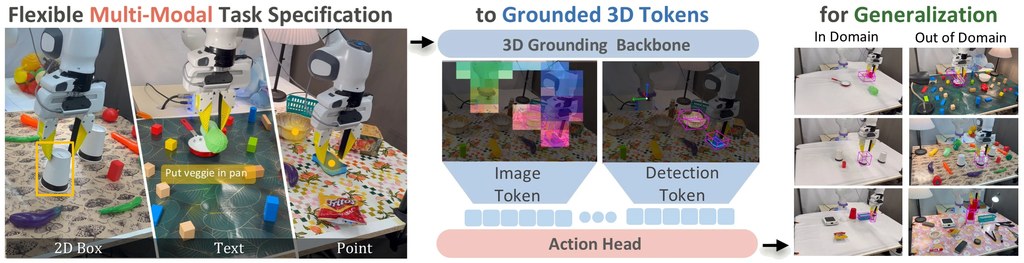
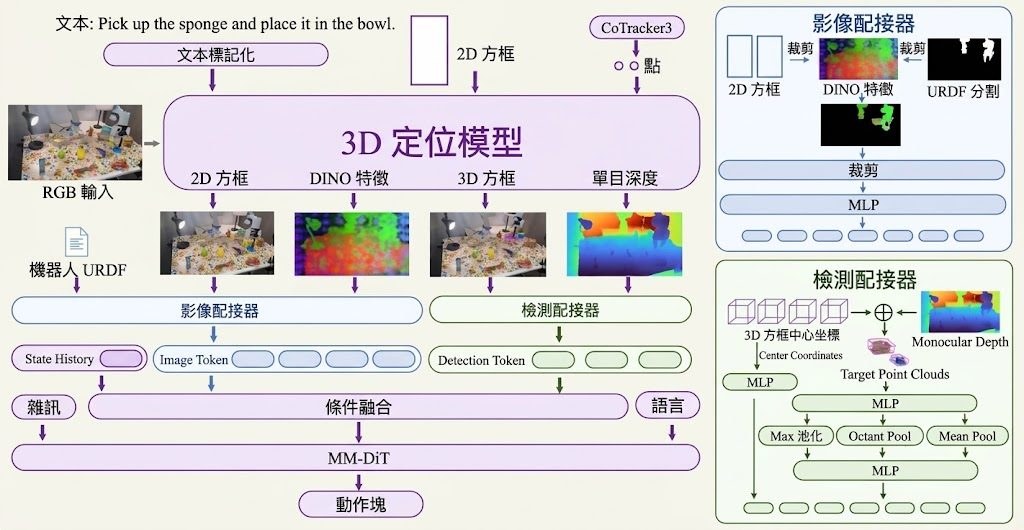
A language instruction, a 2D point or a 2D box is resolved by a pretrained 3D grounding model into image tokens and dete

面對物件被移位、場景重新排列,機械臂未必只需要更長的指令,而是要準確知道目標在哪裏。Grounded Action Model(GAM)屬於機械人基礎模型,透過 3D grounding 將語言、2D 點或 2D 框選轉成同一套以物件為中心的觀察,再預測連續動作。

GAM 使用凍結的 promptable 3D detector,提取目標物件的視覺特徵和 metric geometry,並與機械人狀態歷史交給 multi-stream transformer,輸出 action chunks。相較於由 Vision-Language-Action Models(VLAs)或 World-Action Models(WAMs)從示範中隱性學習位置關係,GAM 把 3D 位置直接放進控制流程,也可由高層 planner 透過不同提示方式控制,支援較長流程和需要記憶的操作。

A language instruction, a 2D point or a 2D box is resolved by a pretrained 3D grounding model into image tokens and dete

目前可參考的結果包括:
– RoboTwin 2.0 的 50 項任務平均成功率為 55.3%,場景隨機化時為 47.6%。
– LIBERO-PRO 的 16 種擾動設定平均成功率為 61%,目標重新放置時改善較明顯。
– 雙臂 YAM 面對視覺變化仍成功 17/20 次;Franka 配合 Molmo2 planner,長流程任務的 OOD step completion 為 49.8%。

Grounded-Action-Model 適合研究機械人操作、視覺變化和高低層控制協作的團隊,但目前 GitHub 仍只有論文與項目頁面,training and inference code、pretrained checkpoints 及 real-robot setup 尚待公開,因此暫時不能按儲存庫直接安裝或重現結果。數據主要來自指定基準和兩款機械人,能否延伸到其他硬件與未見過的操作,仍要等待程式碼及更多測試。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, 微軟, VLA, World-Action Model, Robotic, 3D, 庫

ActionPiece:設計動作分詞器,幫機械人學得更穩

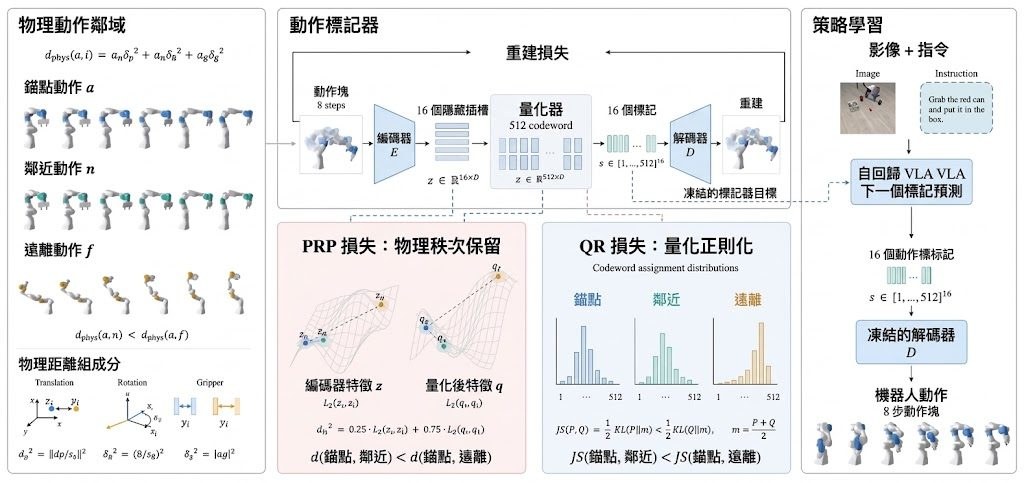
可以把 ActionPiece 理解為一個專給視覺語言動作模型用的動作編碼器,特別針對自回歸生成時動作細節流失的問題,強調保留物理距離的先後關係。

DeepCybo, Zhongguancun Academy, and Zhongguancun Institute of Artificial Intelligence

當自回歸視覺語言動作模型(VLA)把機械人動作切成離散 token 再一個個吐出來,最大的隱性成本往往不是單一動作的誤差,而是相鄰動作之間的物理距離被打亂。ActionPiece 正是針對這個卡位設計:它把動作切成一塊八步的短序列,每塊壓成 16 個離散 token,並要求 tokenizer 不只重建動作,還要保留「物理排序一致性」(physical rank consistency, PRC)。換句話,兩個本來很接近的動作,編碼後的距離也要維持接近;兩個本來很遠的動作,編碼後也要維持較遠。這種監督讓 token 表徵本身帶有物理結構,而不是純粹的重建損失。

在 Libero、Libero-Plus、SimplerEnv 與 VLA-Arena 四組基準上,ActionPiece 配合 Qwen3-VL-4B 作為策略骨幹,跑出 94.8%、68.8%、71.9%,以及 VLA-Arena L0 至 L2 平均 51.5% 的成功率。Libero-Plus 的訓練刻意排除其示範數據,因此這項成績更能反映遷移表現,而不是單純記住示範。從結果可以看到,重建保真度與 PRC 之間並非完全等價:有些 tokenizer 重建得很好,但鄰近關係一塌糊塗,部署成功率也跟著掉。ActionPiece 把「物理排序保留」與「碼字分配的量化正則化」綁在一起訓練,正好同時壓住這兩個問題。

這個項目的實際意義,是給正在做 VLA 研究的團隊一個可直接替換的動作 tokenizer,無需重寫策略架構。對關注 SimplerEnv 真實遙操作或 VLA-Arena 跨平台泛化的工程師來說,這類保留物理關係的分詞方式,會比純重建式 tokenizer 更貼近控制任務的需求。PhysBrain 1.5 也採用了 ActionPiece 作為動作 tokenizer,顯示它已不只在論文層面,而是走進實際模型發佈。

要真正評估它,比較合理的做法是把它接進自己的 VLA 流程,比對換 tokenizer 前後的策略成功率與 PRC;單看 Libero 94.8% 容易被低估,因為重建誤差小的 tokenizer 不一定保留鄰近結構。原始程式碼與 PhysBrain 1.5 的權重將在官方頁面釋出,想搶先試的人可以先讀論文並鎖定後續更新。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, VLA, Robotic, Dataset 數據集

Page 1 of 5
1 2 3 … 5