teardown:把機器原理變成可拆解的 3D 模擬器

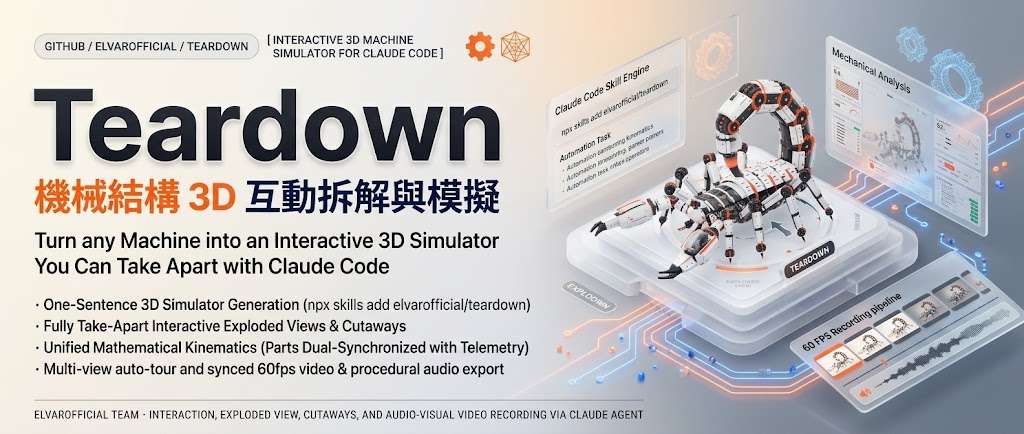
想了解引擎、手錶或挖掘機怎樣運作,可以讓 Claude Code 生成一頁式模擬器,邊看機器運轉,邊拆開部件追蹤數值。

Mellis HB-7 robotic bee simulator

想弄清楚四衝程引擎如何運作,單看文字或靜態圖解未必容易掌握部件之間的關係。teardown 是一項 Claude Code skill,會按自然語言指示生成離線 HTML 3D 模擬器,讓機器在畫面中央運轉,周邊面板同步顯示數值,亦可按鈕打開正在工作的部件。

使用者可在 Claude Code 以日常語句描述想了解的機械,例如機械手錶或液壓挖掘機臂,再要求生成模擬器;項目亦附有 V8 引擎、Cessna 飛機和 Strandbeest 機械生物三個例子,可用 Node.js 建成單一 HTML 頁面。安裝需要 Node.js 20 或更新版本,以及 Playwright 的 Chromium;影片輸出另需 ffmpeg,聲效製作則需 Python。主要使用方式是透過 Claude Code 提出描述。

生成的頁面會把 three.js 和字體內嵌,方便離線開啟;模擬器閒置時會自動巡覽,亦可把畫面逐格輸出成 60 fps MP4,並配上時間軸聲效。相較只提供動畫的展示頁,它把機械運作、即時數值與可拆解部件放在同一介面。

較適合製作互動式教學素材、概念展示或機械原理解說的教育工作者、設計師和工程團隊。要留意,生成品質會受描述與 Claude Code 產出影響;若內容用於工程驗證或安全判斷,仍需另行核實模型設定與數據。

  • 以自然語言要求 Claude Code 建立機械 3D 模擬器。
  • 單一離線 HTML 頁面包含機器動畫、數值面板和部件拆解互動。
  • 可將模擬器畫面輸出為 60 fps MP4,並加入程序化聲效。
  • 內附 V8 引擎、Cessna 飛機及 Strandbeest 三個示例。
  • 文件未提供物理準確度評測,生成結果不宜直接當作工程驗證。

GitHub

Categories: 開源, AI productions, 模型, Video, 教學, 3D, Python, 安全, Anthropic, 動畫, 聲效, Skill 技能

Project Suncatcher 太空軌道上的 TPU 首次 AI 回覆

Google 的原型衛星首次從軌道上的資料中心級 TPU 傳回 AI 回應。

Og image

把 AI 運算設備送上軌道後,能否收到它傳回的回應?Google 的 Project Suncatcher 原型衛星已達成這項「Hello World」里程碑:軌道上的資料中心級 TPU 首次送出 AI 回應,證明相關設備至少完成了一次在太空中的運算與通訊。

這次成果處理的是太空運算的一個基本環節:不只把設備送入軌道,還要讓它執行 AI 工作並把結果傳回。對研究人員而言,這提供了測試軌道運算鏈路的起點;對一般使用者而言,暫時還不是可直接使用的服務。

Our first response from the Project Suncatcher prototype satellite.

目前公布的資訊聚焦於首次成功回應,未交代長時間運作表現、運算規模、通訊穩定性或成本。因此,這項里程碑不能單獨證明太空資料中心已具備商業可行性,後續仍要看設備能否持續運作,以及整體系統如何擴展。

• 原型衛星在軌道上搭載資料中心級 TPU。
• TPU 首次傳回 AI 回應,達成「Hello World」里程碑。
• 公布內容未提供長期運作、成本或擴展能力的數據。

Project Suncatcher 目前呈現的是一次早期技術驗證,適合關注 AI 基礎設施、衛星及太空運算發展的讀者留意。它能否由單次回應走向可靠、可持續的運算服務,仍有待更多測試結果。

項目主頁

Categories: Google, Gemini, 新聞, 安全

CVE-2026-98432:修補 Linux TCP 遠端攻擊風險

Linux 核心 TCP 子系統被揭發高風險漏洞,遠端攻擊者或可在無需登入下取得系統控制權,維運團隊需同步檢查修補與網絡防護。

Linux 伺服器面對的風險不只在應用程式,核心處理 TCP 連線建立的程式碼同樣可能成為遠端入侵入口。CVE-2026-98432 被描述為競態條件(Race Condition)及記憶體釋放後重用(Use-After-Free, UAF)漏洞,國家漏洞資料庫(NVD)評分達 9.8,攻擊不需要帳戶或使用者互動。

漏洞涉及 Linux 核心 IPv4 TCP 連線處理流程,問題集中於 tcp_v4_syn_recv_sock() 處理連線選項轉移時,inet_opt 與 ireq_opt 的釋放及複製未有受到適當保護。來源指稱,攻擊者或會利用核心位址外洩繞過 KASLR,再嘗試改寫回呼指標以達成遠端代碼執行(RCE)。

受影響範圍據稱涵蓋 Linux 4.4 以來的大部分主流核心架構,Ubuntu、RHEL、OpenShift、Amazon Linux 2023、Debian、SUSE 及 Oracle Linux 等環境需要按自身核心版本核對公告。不同發行版的修補進度並不一致,不能只按作業系統名稱判斷是否安全。

• 核心問題:TCP 連線選項處理中的競態條件與 UAF
• 風險特性:可由網絡遠端觸發,且不需驗證
• 維運重點:盤點核心版本,優先套用官方安全更新
• 緩解方向:檢查防火牆及更新 Suricata 等入侵防禦規則
• 來源提及:MikroTik 可透過 RAW 規則暫時封鎖異常 IPv4 TCP 選項封包

在官方修補完成前,邊界防火牆和入侵防禦系統只能作為降低暴露面的臨時措施,並不能取代核心更新。文章未提供各發行版完整修補版本清單,管理員仍應以供應商安全公告及自身測試結果作最後判斷。

項目主頁

Categories: Linux, 安全

Open-H3-Regenerate-2K:把 MiniMax H3 影片提升至原生 2K

[YouTube 影片]NVIDIA 的 Open-H3-Regenerate-2K 可在 ComfyUI 將 480p MiniMax H3 草稿提升至 2K,並提供兩種測試方法。

Og image

將 480p 影片提升至 2K,往往要在畫面細節、運算成本與輸出穩定性之間取捨。NVIDIA Open-H3-Regenerate-2K 把這項流程帶入 ComfyUI,針對 MiniMax H3 產生的影片草稿進行高解像度重建,適合需要改善輸出尺寸而又想保留原有動態內容的影像工作流程。

影片示範以三個步驟完成處理,並測試兩種方法,相關檔案亦附有連結。不過,提供的原始資料沒有列出具體工作流程、模型檔案名稱、安裝方式或硬件要求,使用者仍需按影片內容及項目檔案確認 ComfyUI 節點、顯示卡記憶體和運算時間。

  • 將 480p MiniMax H3 草稿提升至原生 2K 影片
  • 以 ComfyUI 組合 NVIDIA Open-H3-Regenerate-2K 流程
  • 示範三步處理方式及兩種測試方法
  • 適合影片生成後的放大、修復及高解像度輸出
  • 硬件規格與安裝細節未在原始資料中提供

對內容創作者而言,這個項目可用於先以較低解像度製作草稿,再把選定結果交由高解像度流程處理,減少一開始便以 2K 生成所帶來的資源壓力。它較適合已經使用 ComfyUI、MiniMax H3 或 NVIDIA 影片模型工作流的使用者。

YouTube 影片介紹

Categories: ComfyUI, AI productions, 模型, NVIDIA, Video, Image, Content Creator, 安全, MiniMax

Hycli 將網站變成可操作的 CLI 工具

Hycli 把網站包裝成 typed CLI 與 MCP 工具,讓 AI agent 讀取、搜尋及修改內容,同時把 cookies 留在本機。

Hycli — Websites, ready for AI.

網站操作之所以難交给 AI agent,往往不是模型不懂流程,而是登入狀態、網站結構與寫入風險都混在一起。Hycli 是開源 CLI 與 MCP server 生成工具,會從網站文件、前端 bundle 及瀏覽器網絡流量建立 typed CLI,涵蓋讀取與寫入操作,並沿用真實瀏覽器登入狀態。

它的差異不在於讓 agent 多一層包裝,而在於把「探索網站」與「執行變更」分開。三個 AI workers 會檢查文件、程式碼和 live traffic,建立工具規格期間不會執行 mutation;即使路徑或 GraphQL body 隱藏了寫入行為,也會被攔截。新 CLI 預設 writes: false,首次寫入前要求用戶確認,亦可隨時撤銷權限。

  • 用 hycli prepare 探索網站並產生 CLI 規格
  • 透過 CLI 或 MCP 讀取、搜尋、建立及編輯網站內容
  • cookies、localStorage、sessionStorage 與 API keys 儲存在本機 vault
  • 寫入失敗不會自動重試,避免重複下單或發文
  • 匯入登入狀態時只讀取指定網域的資料

瀏覽器憑證不會放入 LLM prompt,模型只會看到帳戶標籤、storage key 名稱及已遮蔽的 response schema;真正的 secret 由本機在執行時注入,並從輸出與日誌中移除。OS keyring 分別支援 Windows Credential Manager、macOS Keychain 與 Linux Secret Service,亦備有只限擁有者讀取的檔案權限。

Hycli 適合需要反覆處理後台、內容平台或內部網站介面的團隊,也適合已使用 MCP 的 AI agent 工作流。它不是通用網頁爬蟲,重點是為特定網站建立可重用的 typed 操作介面;實際效果仍取決於網站是否提供可辨識的文件、前端 bundle 或網絡 API,以及該網站是否容許相關自動化操作。

GitHub

Categories: 開源, Agentic, MCP, 模型, API, 工具, Mac, Linux, 安全

三分鐘攪掂 PHP2Shell 漏洞

完全解決管方已停止更新的版本!PHP2Shell 可讓未驗證攻擊者接管伺服器。Ubuntu 管理員應停用舊版 mod_php,並將 PHP 升至已修補版本。

這方案 針對所有 Ubuntu PHP 舊版本已停止更新,能馬上修復 Ubuntu、Apache 與 mod_php 的網站。避免因 PHP2Shell 面臨未經身分驗證的遠端程式碼執行風險。這項問題涉及 CVE-2026-109618 及 CVE-2026-109619,CVSS v4.0 評分為屬嚴重級別 9.2。

問題是 PHP 8.1 及更舊版本已停止支援,而漏洞源自 PHP 核心記憶體管理,攻擊者可透過特定惡意請求觸發 Use-After-Free,並利用記憶體耗盡等而取得程式執行能力。當 Apache 透過 mod_php 與 PHP 共用行程及記憶體時,影響範圍可擴至整個網頁伺服器,遠端程式碼執行(Remote Code Execution,RCE)風險尤其直接。

安全處理方發是把執行環境切換至已修補版本。我們以 Ubuntu 22.04 為例,加入 Ondřej Surý PPA、安裝 PHP 8.3 及所需擴充套件,再停用 php8.1、啟用 php8.3,並重新啟動 Apache;實際環境亦要按原有版本及網站套件調整。

  • 受影響編號:CVE-2026-109618、CVE-2026-109619
  • 建議版本:至少 PHP 8.2.35、8.3.36 或 8.4.27
  • 高風險組合:Apache mod_php 加未修補 PHP
  • 關鍵動作:停用舊模組、檢查版本、重啟服務

驗證不能只看 CLI 輸出,也要確認 Apache 實際載入的新模組及網站依賴的擴充套件。涉及 PHP 8.1 的環境應先安排相容性測試;安全版本要求與頁面所示 PHP 8.3 範例亦應分開核對。

項目主頁

Categories: 軟件, 工具, Linux, 庫, 安全

3dcodeverse 讓 AI 以程式碼建立可驗證 3D 世界

3DCodeVerse 將可執行程式、空間檢查與視覺評審接成工作流,讓 AI 產生的 3D 內容不止能看,亦能修改和驗證。

3DCodeVerse

由幾百行 Blender Python、Three.js 或 GLSL 生成互動場景,內容仍可編輯和檢查,正是 3DCodeVerse 的實用定位。它屬於面向 coding agents 的 3D 研究生態系,處理文字要求轉化為可執行 3D 程式的問題,而不是只輸出一張渲染圖。

核心資料集 3DCodeVerse-2M 收錄約 2.03M 個 code-condition pairs,來自 269,597 個可執行程式,涵蓋 bpy、CadQuery、OpenSCAD、Three.js、URDF、GLSL、OpenGL 七種語言或 runtime,並分為物件、可動物件、場景及圖形渲染四條軌道。每個項目附有程式、所需資產、指令描述、視覺描述、建構步驟和驗證記錄,較適合訓練及測試,而非只作展示素材。

3DCodeVerse Harness 以多智能體和 DAG 結構規劃 3D 項目,再交由空間工具、MCP 服務及確定性檢查驗證連接、介面合約、關節掃描和畫面指標;VLM 評審則用二元缺陷清單及程式上限評分。讀者可先在項目網站瀏覽器執行示例,再從 Hugging Face 取得資料集;自行運行則要準備相應的 Blender、Three.js、OpenGL 等 runtime,不能只靠單一推理套件完成。

開放模型部分提供 Qwen 的 LoRA、DPO 微調配方,並列出 27B 模型在 3DCodeBench 的執行率由 51.9% 提升至 92.9%;項目亦列出相對同一 Claude Opus 5.5 backbone 的 90% 人類偏好結果。這些數字反映訓練資料和驗證流程的價值,但仍應留意評測設定、成本及不同 runtime 對結果的影響。

  • 可生成可修改的程式化 3D 物件、場景和渲染效果
  • 以 DAG Harness 串連規劃、執行、空間檢查和視覺評審
  • 2.03M code-condition pairs 支援模型訓練與基準測試
  • Qwen 微調配方兼顧執行成功率和偏好評審

對研究 3D 生成、coding agents、程式化建模或模型微調的團隊,這個項目提供由資料集、工具鏈到模型配方的完整起點。限制在於工作流程依賴多個 3D runtime,評審仍可能受視覺品質和規則覆蓋範圍影響。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 視覺模型, 模型訓練, Qwen, Google, 工具, 3D, Python, 編程, 安全, Anthropic, Dataset 數據集, LoRA

Gemini 4 Argon 解決更複雜問題

Gemini 4 Argon 正式向開發者、企業、科研人員及一般用戶開放,主打處理高難度問題。

Og image

面對需要更強分析能力的工作,Google 現已開放 Gemini 4 Argon 使用。這款 frontier model 面向開發者、企業、科學家及一般消費者,讓不同場景的用戶都能接觸 Google 最新一代 Gemini 模型。

Gemini 4 Argon 定位為處理「最艱難問題」的模型。

主要亮點

  • 原生多模態 MoE:支援文字、圖片、音訊及影片輸入。
  • 統一 1M-token 視窗:輸入、thinking tokens 與輸出共用約 104 萬 tokens,單次輸出亦可超過以往的 64K 限制。
  • 可調推理深度:API 提供 low、medium、high thinking levels,方便平衡速度、成本與解題能力。
  • 偏向深度工程工作:Google 展示了跨數百個檔案重構,以及讓 Agent 無人值守執行整晚的案例。
  • API 型號:gemini-4-argon,可透過 Gemini API、Google AI Studio 及 Google Antigravity 使用。

價格與限制

2026 年 11 月 30 日前,API 推廣價為每百萬 input tokens 2 美元、output tokens(包括 thinking tokens)10 美元;12 月 1 日起分別加至 4 美元及 20 美元,而且沒有免費 API tier。

項目主頁

Categories: 模型, Google, Gemini, 安全

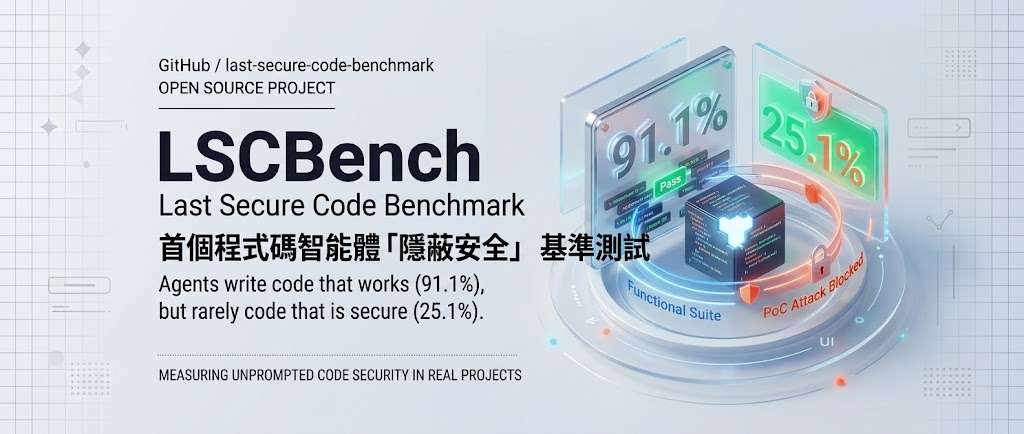
LSCBench 揭示 AI 編程代理安全盲點

LSCBench 以不提安全的真實漏洞重建任務測試編程代理,結果顯示能正常運作與同時安全的程式碼仍有明顯距離。

Qwen

當編程代理只收到功能規格、完全沒有被提醒要處理安全問題時,能否自行避開已知漏洞?Last Secure Code Benchmark(LSCBench)正是用來回答這個問題的開源基準測試項目:它從真實項目移除曾經包含漏洞的程式碼,再要求代理按規格重建,最後以功能測試及重現原有攻擊的安全測試共同評分。

LSCBench 共設 450 個任務,涵蓋 150 個漏洞情境,包括 115 個 Common Vulnerabilities and Exposures(CVE)案例及 35 個專家編寫的 Java 應用程式,支援 C、C++、Go、Java、JavaScript、PHP 和 Python。每個情境分成 function、file 及 repo 三種粒度,分別測試代理修補最小函式、相關檔案,以及較完整程式庫的能力。

六個模型在 450 個任務中大多能產生可運作程式碼,但同時通過功能和安全測試的比例最高只有 25.1%。Claude Fable 5 配合 Claude Code 取得最高 Func∧Sec 比例,GPT-5.6-Sol 的安全測試通過率則以 25.8% 稍高;Kimi-K3 雖然功能通過率達 91.3%,兩項測試同時通過的比例只有 16.4%,反映功能完成度與安全性並非同一件事。

  • 測試焦點:編程代理沒有收到安全提示,必須自行辨認風險。
  • 評分方式:功能測試確認程式可運作,安全測試重播原有攻擊。
  • 資料範圍:450 個任務、150 個漏洞情境、7 種程式語言。
  • 粒度差異:同一情境會在 function、file、repo 三個層次出現。

LSCBench 屬於面向 Computer-use agents(CUAs)及 coding agents 的安全基準測試,實際解決的是「生成的程式碼能否在沒有安全提示下仍然避免已知漏洞」這個評估缺口。對模型開發團隊、安全工程師及採用 AI 輔助編程的團隊而言,項目提供了比單看功能通過率更接近真實風險的檢查方式;不過,測試結果只涵蓋指定漏洞與攻擊重現流程,不能取代完整 code review、模糊測試及正式安全審計。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, 模型, Qwen, OpenAI, DeepSeek, Python, 庫, 編程, 安全, Anthropic, Dataset 數據集, Kimi

DeepMind Sierra AI 原生即時語音

Google DeepMind 與 Sierra AI 討論原生音訊模型,聚焦即時語音互動的速度、自然度與工程限制。

Og image

語音助手要做到自然對話,關鍵不只是把文字轉成聲音,而是要在用戶說話期間理解內容、掌握語氣,並快速作出回應。Google DeepMind 的 Valeria Wu 與 Sierra AI 的 Soham Ray 透過對談,介紹原生音訊模型如何處理這類即時語音 AI 的核心問題。

討論內容集中於 native audio models,以及建立更流暢即時語音系統時遇到的挑戰。相較於把語音先轉成文字、再交由文字模型處理的流程,原生音訊模型直接處理音訊訊號,有機會保留更多語調、停頓和對話節奏;但系統仍要兼顧理解準確度、回應延遲和運算成本。

內容涵蓋的重點包括:
– 原生音訊模型如何支援更自然的語音互動
– 即時對話中延遲與回應流暢度的取捨
– 建立高質素 voice AI 所面對的工程挑戰
– Google DeepMind 與 Sierra AI 對下一代語音體驗的觀察

這段內容適合關注語音介面、客服自動化、AI agent 和多模態模型的讀者。影片沒有提供完整技術規格或獨立效能測試,因此較適合作為理解發展方向與產品設計難題的入門材料,而不是部署指南。

影片介紹

Categories: Agentic, AI productions, 模型, 多模態模型, Google, Gemini, Video, Audio, 語音, 安全

Page 1 of 7
1 2 3 … 7