把 15 個領域科學家親自為自己論文提出的延伸方向交給 AI Agent,要求 Agent 真的把研究做出來並寫成後續論文。
與其請 AI 寫摘要、改改 bug,「Into the Unknown」要求 Agent 從零完成一段小型研究:閱讀一篇科學家寫的論文,再依據科學家親自提出的延伸方向,跑實驗、收集結果,最後交出一篇誠實且完整的後續論文。15 道題目橫跨不同學科,每一道都來自真正做研究的人對自己工作的下一步構想,而不是從公開資料庫拼湊出來的人工題。
針對想做比較的人,配套已經齊備:Hugging Face 上釋出資料集與 Agent 完整軌跡、檔案系統與產出論文,網站設有排行榜,歡迎提交新 Agent 的論文。Agent 端支援 Claude Agent SDK(opus-4.8、opus-5、opus-5.5、fable-5)、OpenAI Codex 系列(sol-5.6、astra-6),以及以 OpenHands 為底層的 glm-5.3。
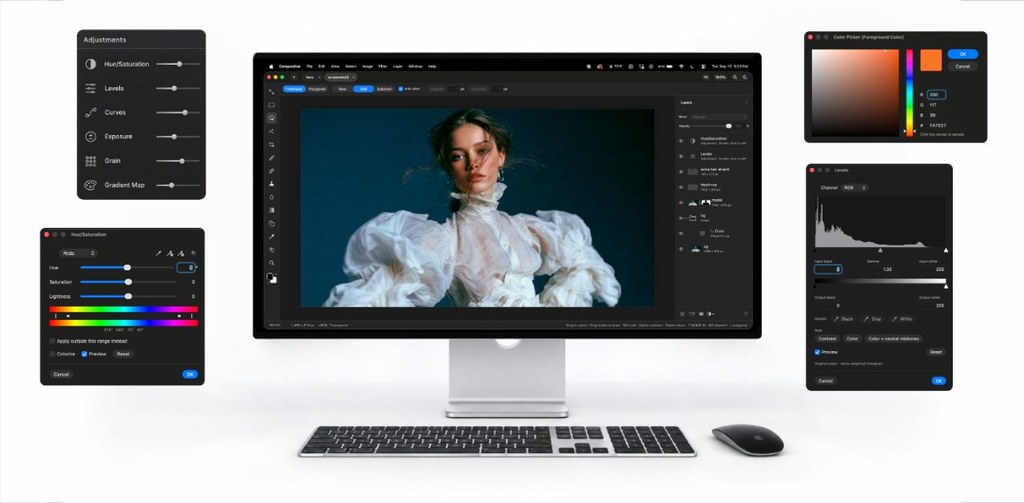
它與 PicsArt、Pixelmator Pro 等同類差異,在於完全開源、零訂閱,並允許直接下載 Xcode 項目插手改功能;代價是目前僅支援 macOS、依賴 Apple 生態,而且由個人維護,更新節奏未必追得上 Adobe。輸出預覽、批次處理、Camera RAW 等專業模組暫未見於 README,較適合個人創作、學生與中小型設計團隊作為主力或副機。
安裝方式以桌面應用為主,官方已提供下載、文件同 troubleshooting,理解上接近本地 AI studio,而唔係單一模型倉庫。現有資料未見統一基準分數或嚴格 benchmark,對聲音相似度、延遲同穩定性,仍要視乎你選用邊個 engine、樣本質素,同埋會唔會改用 local or remote inference;但作為把多語音模型、克隆流程同輸入輸出控制整合起來嘅開源項目,它已經比只提供單點功能嘅工具更接近可長期放入工作流。
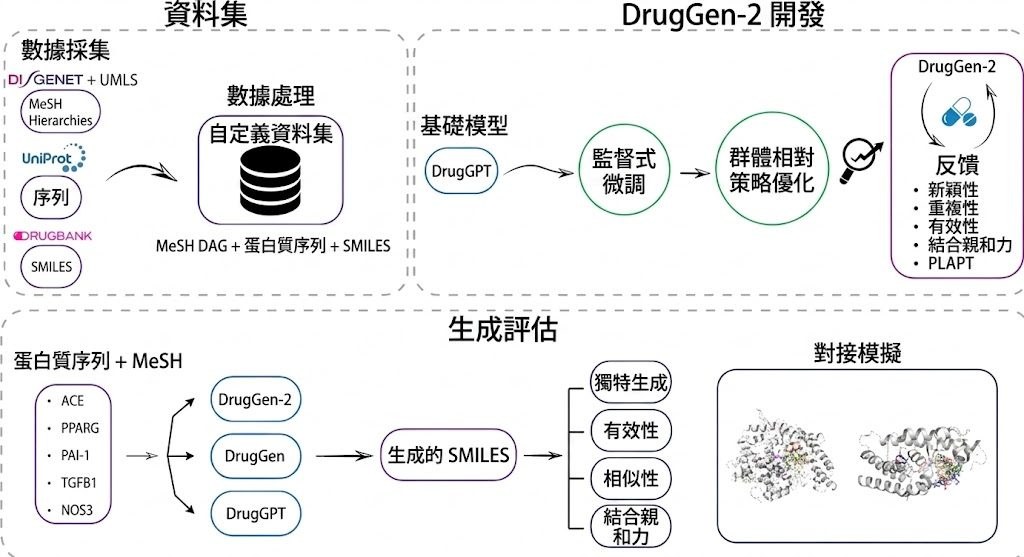
很多老牌分子生成模型只盯着單一蛋白靶點或通用化學性質做條件生成,往往忽略了同一個靶點在不同疾病背景下行為可能完全不同。DrugGen-2 正是針對這個落差而來,它是一個用 MeSH DAG(疾病本體層級結構)加上蛋白序列做條件輸入的語言模型,輸出端直接給出 SMILES 結構,既支援 de novo 設計,也能用於藥物再利用篩選。
這個項目屬於開源模型與訓練框架的混合體,背後以 liyuesen/druggpt 為基底,先做 Supervised Fine-Tuning(SFT),再用 Group Relative Policy Optimization(GRPO)做強化學習微調,整個流程跑在 Hugging Face transformers 與 TRL 上。作者認為舊做法把疾病與靶點切割看待,於是提出以疾病為錨點重新組織資料的 framing,這也是它和同類工具最大的差異點。
對做計算化學、藥物篩選前期探索或想快速做假說驗證的研究團隊來說,這類輸入比直接丟一個蛋白 ID 更貼近真實用藥情境。要部署的話只要 clone 倉庫、安裝 requirements,再透過 Python API 或 CLI 餵入疾病名稱、MeSH ID 與 Uniprot 序列即可生成候選分子,預訓練權重已放在 Hugging Face 上方便取用。