DiffusionOPSD:將自我蒸餾影像獎勵轉為可更新訓練目標

DiffusionOPSD 將影像級獎勵轉成可反覆更新的中間目標,補上 diffusion 訓練中間步驟的監督空白。它適合想在有限訓練預算下,改良生成質素同可診斷性的團隊。

DiffusionOPSD qualitative gallery

DiffusionOPSD(ByteDance Seed) 主攻的是 diffusion 模型後訓練時,只有最終圖片分數、欠缺中間步驟指引的問題。它屬於一套用於模型後訓練的開源方法,透過 on-policy self-distillation,把影像級 reward 轉成可直接學習的中間目標。

它的做法不是單純追分,而是先用凍結的 behavior policy 收集低噪聲查詢狀態,再用 reward gradient 建出正負兩種 bounded target,最後由可訓練 policy 去擬合這些切斷計算圖的目標。這種安排把目標品質和模型更新分開處理,亦令 supervision 可以隨住模型演化持續刷新。

實作層面,公開版本支援 SD3.5-M 512²,同時覆蓋原生 few-step 的 Z-Image-Turbo 1024² 設定;文件亦提到可做單一 reward 或多個 reward 的加權訓練。原文未提供完整安裝流程或逐步使用指引,只能確認它有項目頁與程式碼釋出,適合自行拉取後依研究環境配置。

它和同類 diffusion reward optimization 的主要分別,在於用 on-policy 查詢配合 EMA 持續重建 supervision,而不是只依賴離線或固定噪聲替代狀態。官方結果聲稱在多個 evaluator 與兩種 backbone 上都有較強的最終 held-out 表現,亦以較少 GPU-hours 完成訓練;這令它特別適合做生成模型後訓練、獎勵對齊與方法比較的研究團隊。

  • 將 image-level reward 轉成可學習的中間目標
  • 用 EMA 反覆刷新 trajectory、anchor 與 target
  • 支援 SD3.5-M 與 Z-Image-Turbo 兩種 backbone
  • 可做單一 reward,亦可做多 reward 加權
  • 適合研究 diffusion 後訓練同 reward alignment 的團隊

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 字節跳動, 模型訓練, Image, 影像處理, txt2img, 框架

[技術文章] pixel-space 模型可以追平甚至超過 latent-space 對應模型

研究聚焦 pixel-space text-to-image diffusion models 的訓練卡位,找出點樣喺大規模條件下兼顧畫質同速度。作者用 latent-to-pixel 策略,令 pixel-space 模型更接近甚至超過 latent-space 表現。

Hero image preview

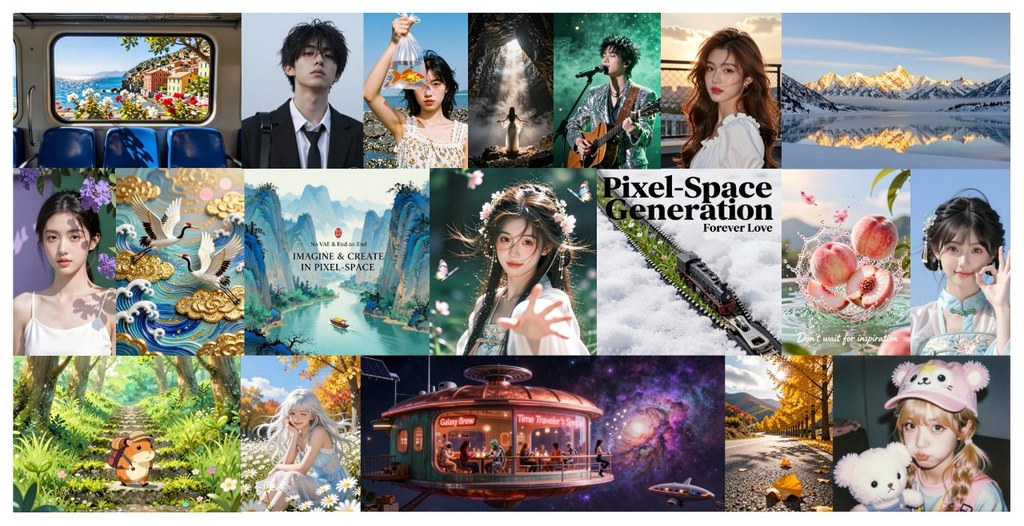
上圖是透過 pixel-space text-to-image diffusion models 的方法訓練的 Z-Image-Turbo (Pixel) 產生的圖像。在企業級 H800 GPU 上,推理延遲僅約 0.2 秒。

Pixel-space text-to-image diffusion models 一直有兩個吸引位:直接生成像素,唔受 VAE 壓縮上限限制,亦可以省去解碼步驟。但喺大規模訓練下,佢哋收斂速度明顯慢過 latent-space 模型,令「畫質、效率、可訓練性」三者之間嘅平衡一直唔夠成熟。

呢篇工作針對嘅正係呢個落差。作者先比較 pixel-space 同 latent-space 喺大規模 pre-training 下嘅行為,再提出 latent-to-pixel 策略:先喺 latent space 學到生成先驗,再轉去 pixel space 做 post-training,避免一開始就喺難度更高嘅像素空間硬推。

佢哋亦系統研究咗多個轉換設計,包括 weight initialization、data composition、prediction target、decoder architecture 同 noise schedule,整理出一套可行做法。結果顯示,做法調整得當之後,pixel-space 模型可以追平甚至超過 latent-space 對應模型,推理端仲有 3.18 到 4.75 倍嘅速度提升。

  • 直接處理 pixel-space diffusion models 喺大規模訓練時收斂慢嘅問題
  • 用 latent-to-pixel 路線,先學先驗,再轉入像素空間微調
  • 檢視多個關鍵訓練選項,搵出實用 recipe
  • 在畫質不退讓之下,換取更快的 end-to-end inference
  • 對想做高效文生圖系統、又在意生成細節保留嘅團隊最有參考價值

Paper

Categories: 香港科技大學, 南京大學, 阿里巴巴, 模型, 模型訓練, Image, txt2img, 香港

Context Scaling 把文生圖提示詞帶到結構化階段

寫得更長未必更準,關鍵反而是提示詞有幾多可對應畫面的結構資訊。Context Scaling 把這件事量化,連帶改寫文生圖訓練與編輯流程。

Text prompt scaling law overview

文生圖卡住的位置,很多時不是模型不夠大,而是提示詞交代得唔夠可計算。Context Scaling 聚焦影像生成中的文字條件 scaling law,屬於一個結合研究、模型與工作流程設計的項目,處理的是提示詞怎樣更有效描述構圖、屬性同空間關係,令 diffusion model 更容易學到、亦更容易按要求生成。

它最值得留意的判斷,是 caption 長度本身跟效果關係唔算緊密,反而 structured language 的資訊量更重要。團隊用兩個指標去量度這件事:white-box likelihood metric 的 GPG,同 black-box attribute metric 的 ED;受控訓練結果顯示,converged diffusion loss 會隨 GPG 近線性下降,亦會跟 ED 呈 power law 關係。

Context Scaling: Scaling Properties of Text Conditioning in Visual Generation

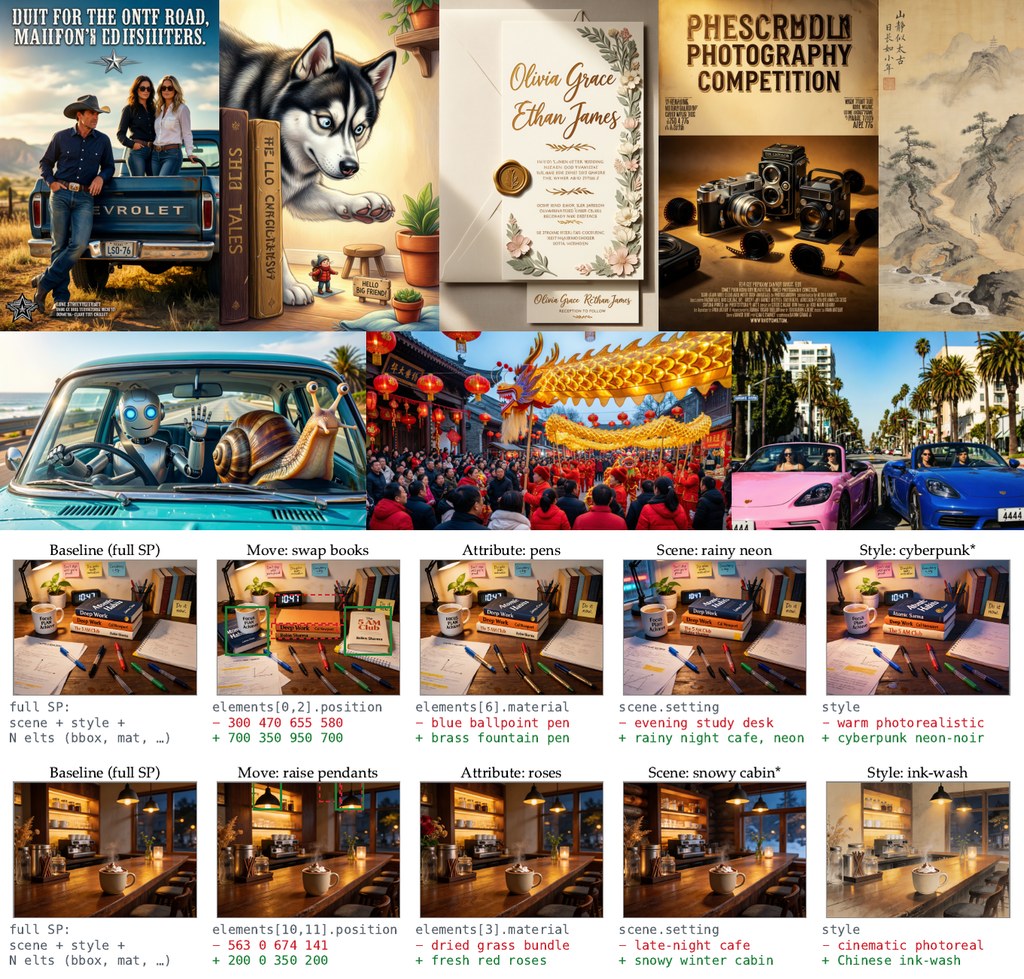
這個方向不只停留在分析。項目把 Structured prompts(SP)做成帶 semantic 與 geometric fields 的 JSON schema,再配合 trainable LLM prompter + captioner,將用戶要求或者輸入圖片轉成更有結構的描述;zero-shot structured editing 亦因此變得可行,因為每個可編輯因素都被拆成命名欄位,改其中一部分時,其他構圖元素較容易保留。

  • 重點不在提示詞有幾長,而在畫面資訊有幾可對齊
  • GPG 與 ED 為提示詞資訊量提供兩種量化方法
  • Structured prompts(SP)直接補強 compositional、reasoning、world-knowledge 類生成
  • prompter 經 supervised fine-tuning、cold-start、verifier-gated on-policy distillation 訓練
  • 已公開 Code、Models 與 Demo,理解路線可先看 project page,再到 Hugging Face collection

跟同類做法相比,它的取捨相當清楚:不是單靠更大模型或更長自然語言描述去碰運氣,而是先提升 captions 對影像的可監督性,再訓練 prompter 去穩定產生這類結構。官方說法指出,系統在多個 compositional、reasoning 與 world-knowledge benchmark 上超越全部已評測 open-weight models,並在多數評測追平或超過最強 closed-weight models;不過公開資訊仍以研究結果為主,部署細節與完整安裝流程未算多,現階段較適合做方法研究、提示詞工程、影像編輯流程設計,以及評估下一代文生圖介面的團隊參考。

項目主頁 · GitHub · 模型

Categories: 開源, 字節跳動, 模型, 模型訓練, Qwen, 影像模型, txt2img, Dataset 數據集

NVIDIA FastGen 平行解碼的加速擴散生成訓練

NVIDIA 團隊把擴散模型加速訓練與蒸餾流程整理成同一套框架,重點不止是跑得快,亦方便跨影像與影片任務重用方法。

Watch the video

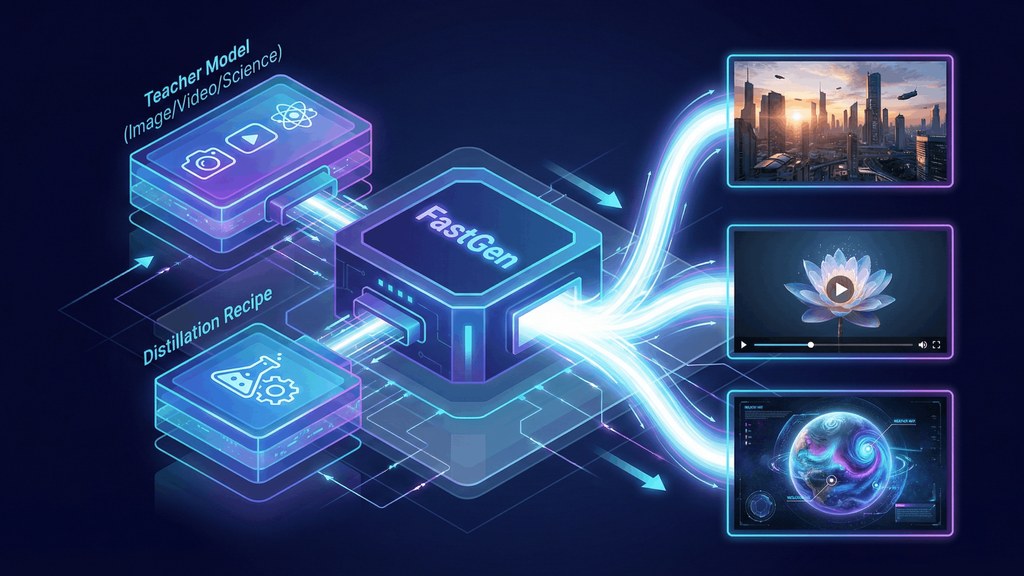
由 NVIDIA 團隊主導,Weili Nie、Julius Berner、Chao Liu 與 Arash Vahdat 是署名作者,核心貢獻者亦包括 Weili Nie、Julius Berner、Chao Liu。這個項目放在 NVlabs 名下,定位很明確:它不是單一生成模型,而是用 PyTorch 建成的訓練框架,集中處理 diffusion models 的加速與蒸餾,讓影像與影片生成可以用較少步數完成推理,同時保留大規模訓練能力。

與一般只提供某一種加速技巧的研究代碼不同,FastGen 把 consistency models、distribution matching distillation、self-forcing、KD 等方法放進同一套結構,並且覆蓋 T2I、I2V、V2V 多種任務。這種設計的價值,在於研究團隊可以在相近配置與資料流程下比較不同蒸餾路線,而不是每試一種方法就重砌整套訓練管線。

基本理解方式:代碼庫包含 datasets、methods、networks、trainer 與 scripts,顯然以訓練、推理、評測三部分分開整理;環境方面建議用 Docker,也保留 conda 安裝路線,並支援 W&B 記錄。不過公開資訊未有列出完整 quick start 細節、現成模型清單或基準成績,現階段較像面向研究與工程團隊的基礎框架,而不是開箱即用的消費級生成工具。

Prompt:
4 NFE PDD on Wan2.1 14B: A joyful child, 
with a big smile and arms spread wide, 
swings energetically on a rusty old swing set in a sunlit backyard. The swing set, with peeling paint and creaking chains, 
contrasts against the vibrant green grass and blooming flowers surrounding it. 

The child's laughter echoes as they swing higher and higher, 
their feet barely touching the ground at the bottom of each arc.
 
The scene is captured from a low angle, 
emphasizing the height of the swings, 
with the sun casting a warm glow over everything.
Medium shot focusing on the child and the swing set.
  • 屬於框架型項目,處理的是 diffusion models 如何更快生成,而不只是再訓練一個新模型
  • 支援 ≥10B 參數的大規模訓練,較適合有多卡資源的團隊
  • 任務涵蓋 T2I、I2V、V2V,對跨模態生成研究較有吸引力
  • 方法層同時納入 consistency models、distribution matching distillation、self-forcing 等路線,方便做橫向比較

配合 NVIDIA 研究頁面的 FastGen-PDD 脈絡來看,這個項目也像是承載後續加速生成方法的底座,尤其面向 image 和 video generation 的 parallel decoding distillation。對想建立自家快速生成訓練流程、測試不同蒸餾策略,或者需要把大型 diffusion 項目整理成可維護代碼庫的團隊,FastGen 的參考價值高;但想直接下載即用、立刻看到完整評測結論的人,現有公開資料仍然偏少。

項目主頁 · GitHub · Paper

Categories: 開源, 視頻模型, NVIDIA, Video, Image, txt2img, Python, 語音

Microsoft Mage:4B 多模態輕量路線

想做影像生成、編輯,甚至進一步研究多模態模型,但運算資源有限,Mage 會係一個值得留意的方向。它把 4B 規模壓到夠細,同時仍然追住更大模型的表現。

gallery

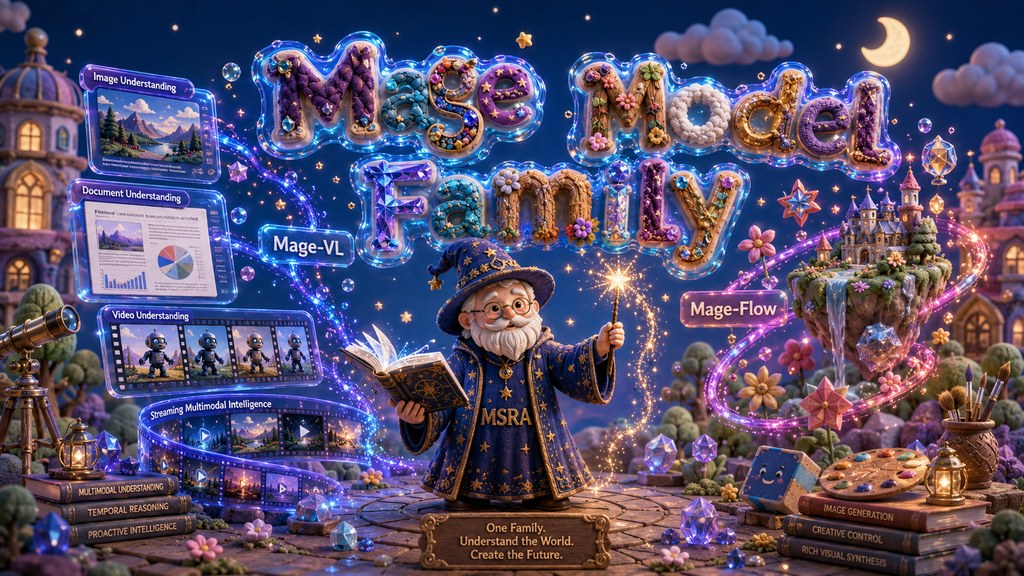
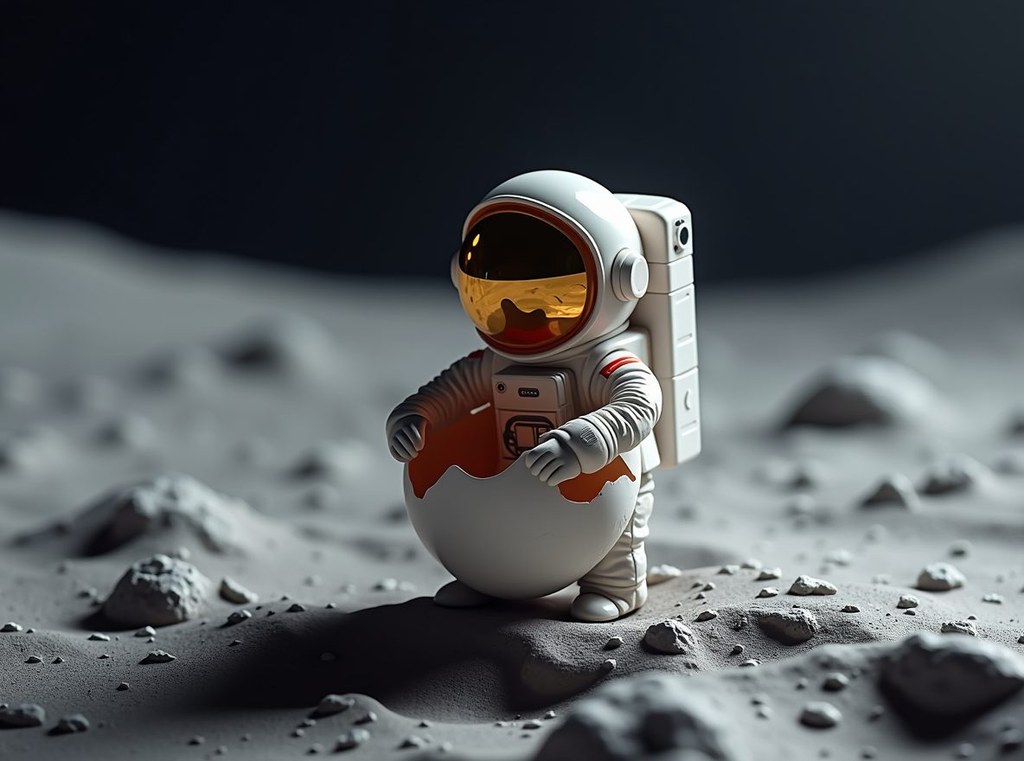
當你想喺有限 GPU 預算下做影像生成、編輯,甚至延伸到影像與影片理解,Mage 這個開源模型家族的定位就相當直接:用固定 4B 參數規模,處理多模態理解與生成兩條路線,目標唔係堆大模型,而係保留研究可控性同部署可行性。

Mage 目前最完整的是 Mage-Flow,屬於模型家族中的生成與編輯分支。它把 Mage-VAE 同 Native-Resolution Multimodal Diffusion Transformer 組合起來,前者負責更高效率的 latent tokenizer,後者負責文字生圖與指令式修圖;同時提供 Base、RL-aligned 同 4-step Turbo 版本,方便按畫質、對齊程度與速度取捨。另一條線 Mage-VL 對準 image/video understanding,但程式與權重細節仍待釋出。

同類開源影像模型很多都靠更大參數量換效果,Mage 的判斷明顯不同:它把重點放喺 codec-aligned efficiency,同一個 checkpoint 已可覆蓋 512 到 2048、不同長闊比,連 4:1 這類極端尺寸都原生支援,減少多套模型或額外縮放流程。它在生成、編輯表現上可與 Qwen-Image 20B、FLUX.2 32B、FireRed-Image-Edit 20B 等較大型開源系統競爭,但取捨是 Mage-VL 仍未完整開放,整個家族現階段更適合關注研究與工作流整合的人先行評估。

Super fast Image Edit model Mage-Flow on 8GB VRAM
  • 固定 4B 規模,主打可訓練、可微調、可部署
  • Mage-Flow 已覆蓋 text-to-image 與 instruction-based image editing
  • Mage-VAE 以更低 encode/decode MACs 減輕高解析度瓶頸
  • 單一 checkpoint 支援 512–2048 與多種 aspect ratio
  • Turbo 版本強調速度,1024² 在單張 A100 有明確推理數字

部署與測試方面,現有資料顯示 Hugging Face 已提供多個 Mage-Flow 與 Mage-Flow-Edit 權重,適合先用現成 checkpoint 驗證生成、修圖與速度,再決定是否進一步做微調。對做垂直領域影像項目、想研究後訓練方法,或者需要把高解析度生成放入較實際算力條件的人,Mage 的吸引力不在花巧包裝,而在它用一條輕量路線,把研究、性能與部署成本拉回較平衡的位置。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 多模態模型, Qwen, 微軟, Stable Diffusion, Video, Image, 影像模型, 影像處理, txt2img, Medical醫學

TBSM 想把一步生成變得更實用

想要快,但又唔想靠冗長採樣或額外教師模型,TBSM正正瞄準呢個矛盾。它用一步生成處理影像與 text-to-image,取向相當鮮明。

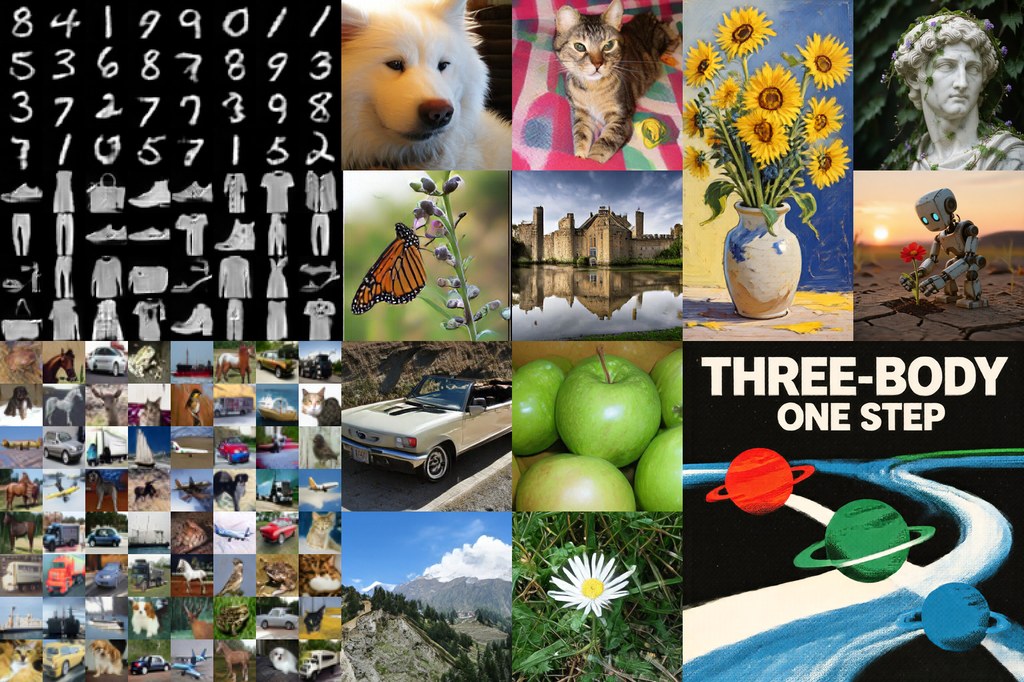
TBSM one-step samples across handwritten digits, fashion items, CIFAR-10, ImageNet, and text-to-image generation.

生成模型一路追求更快出圖,但速度一提升,訓練往往就變得更複雜。TBSM 把焦點放在one-step generation,而且唔係靠 adversarial critic、teacher queries,亦唔需要 batch-wide all-pairs field 去撐住整個流程;它屬於生成模型方法,處理的是怎樣用較直接的監督,把一次生成做得可訓練又可擴展。

這個項目的判斷重點,在於它不只是講快,而係試圖避開幾條常見路線的代價:GANs 容易受 adversarial min-max objective 影響,AR / Diffusion 要逐步解碼或反覆採樣,Drifting Models 會受 batch 規模拖高成本,diffusion distillation 又常常連帶額外模型、loss 或訓練技巧。TBSM 用 three-body scattering 連到 distributional energy,目標是把分佈層面的學習,壓成 sample-level supervision,令一步生成唔使再背住咁重的系統負擔。

它已展示多種資料與輸出空間,包括 handwritten digits、fashion items、CIFAR-10、ImageNet,以及 1024×1024 的 text-to-image。這代表它較像研究型項目而唔係即裝即用產品:你會先從 paper、示意圖與 quick start 去理解訓練與生成流程,再按資料集或任務類型測試效果,較適合有模型訓練環境的研究團隊、影像生成項目,或者想研究 one-step generation 取捨的人。

  • 核心賣點是一跳生成,不靠多步採樣換品質
  • 設計上避開 adversarial critic、teacher model 同 batch 全配對成本
  • 已展示多個資料集與 text-to-image,覆蓋面比純玩具示範更廣
  • 現階段更接近研究實驗框架,部署前要先消化方法與訓練設定

它吸引人的地方,在於把「生成速度」同「訓練系統複雜度」一齊拉入取捨表,而不只是追某個指標。現有資訊未見完整效能數字與部署細節,表示讀者現階段應把它看成值得追蹤的生成模型研究方向:概念清晰、定位明確,但要判斷是否適合生產環境,仍然要等更完整的評測與開源內容。

GitHub

Categories: 開源, Qwen, Image, txt2img

JoyAI-Image 想做懂空間的影像模型

JoyAI-Image唔只想生圖,仲想令模型真正理解畫面入面物件點擺位、點互相關聯。對要做指令修圖、排版生圖同多視角內容的人,呢個方向幾有參考價值。

Repository image for jd-opensource/JoyAI-Image

改圖最怕模型聽得明文字,卻改壞原本場景結構;生圖亦常見字排得唔準、物件關係走位。JoyAI-Image就係朝住呢個痛點落手,定位屬於多模態基礎模型,把影像理解、text-to-image 生成同指令式編輯放入同一個模型家族,重點處理空間理解不足帶來的失真與失控。

唔係把理解模型同生成模型鬆散拼埋,而係用 8B Multimodal Large Language Model (MLLM) 配 16B Multimodal Diffusion Transformer (MMDiT),強調理解、生成、編輯之間的閉環協作。換句話說,模型唔只讀圖後再畫圖,仲會利用視角變換等生成結果反過來補強空間推理,呢點令它在 grounded generation、關係定位同可控編輯上有更鮮明方向。

現有公開內容顯示,部署路線算完整,已提供 Hugging Face 權重、Diffusers 版本、ComfyUI 原生支援,同埋可直接參考的 workflow;另外亦有 Spatial Edit 同 General Edit 示範空間。對內容製作、電商視覺、設計流程或者研究多模態編輯的人,較值得留意的是它不只處理單次修圖,仲想處理長文字排版、版面忠實度、多視角生成,以及「指定物件移去指定位置」呢類容易出錯的操作。

JoyAI Image Edit Plus in ComfyUI - How Does it Compare?
  • 把理解、生成、編輯整合到同一條多模態流程
  • 核心賣點係較強的 spatial intelligence,而不只是畫面更靚
  • 已有 Diffusers 與 ComfyUI 兩條使用路線,測試門檻較研究原型低
  • 延伸到 OpenSpatial data engine 同 OpenSpatial-3M dataset,反映它連資料與訓練配方都一併公開
效能方面,儲存庫描述集中在能力展示與訓練設計,現階段較適合把它理解成一個方向清晰、工具鏈逐步成熟的開源影像模型項目。最吸引之處唔係單一指標,而係它把空間理解當成生成與編輯的核心能力,對需要更穩定版面、關係同位置控制的工作流,確實比單講畫質更實用。

GitHub · 模型

Categories: 開源, ComfyUI, 模型, 視覺模型, 多模態模型, Qwen, Image, txt2img, Dataset 數據集

Sana 把高解像生成壓到快 100 倍

想做高解像圖片或影片生成,又唔想計算成本高得難以落地,Sana 提供了一條幾實際的路。它把訓練、推理到不同變體放在同一套代碼庫,重點放在速度與畫質之間的平衡。

logo

高解像圖片同影片生成最常見的卡位,不是效果做不到,而是算力、延遲同部署成本太難接受。NVlabs/Sana 屬於生成模型代碼庫,集中處理這個矛盾:在維持高解析輸出的前提下,把訓練與推理做得更省、更快,並且一路延伸到圖片、影片、世界模型等多條分支。

這個項目唔係單一模型,而是一個家族。SANA 主打最高到 4K 的 text-to-image,README 直接給出「比 Flux-12B 細 20 倍、快 100 倍」的定位;SANA-1.5 進一步處理訓練期與推理期的 compute scaling;SANA-Sprint 則把重點放在 one/few-step 生成,官方數字提到 H100 上 1024px 圖片可做到 0.1 秒級。取向很清楚:不是一味追最大模型,而是用效率換取更可部署的生成流程。

影片部分同樣值得留意。SANA-Video 與 SANA-Video 2.0 把焦點放在 720p 長序列生成,做法上用 hybrid linear attention 配合 Attention Residuals,目的是減少 full-softmax attention 的成本,同時盡量保住畫質與長序列表達能力。公開資料提到 SANA-Video 2.0 在單張 H100 上,720p/5 秒影片可做到 13.06 秒,VBench 總分 84.30,也強調比 Wan 2.2 14B 有大幅速度優勢,但這類數字仍要連同硬件、步數與設定一齊理解。

  • 同一庫內含 SANA、SANA-1.5、SANA-Sprint、SANA-Video、SANA-WM、SANA-Streaming、Sol-RL
  • 提供完整 training 與 inference pipeline,唔止展示模型效果
  • 可透過官方 demo、Hugging Face、ComfyUI 整合去理解生成表現與部署方向
  • 重點不是極限參數量,而是高解像生成的速度、成本同可擴展性

部署與測試路線相對清晰:已有官方文件、網頁 demo、Hugging Face 集合,亦見到 ComfyUI、SGLang、Replicate 等接點,代表它較適合研究團隊、影像工作流開發者,以及想把高解像生成放進產品流程的人。 SANA-WM 的 2.6B controllable world model、6-DoF camera control,同 Sol-RL 的加速收斂能力,則顯示這個項目不只做靜態出圖,而是朝更完整的生成系統推進。

項目主頁 · GitHub

Categories: 開源, ComfyUI, AI productions, 世界模型, 模型訓練, NVIDIA, Stable Diffusion, Video, Image, txt2img

Facial-Expression-Prompting:幫 AI 影片角色演得更可信的提示詞 Skill

想拍角色反應戲,但提示詞只寫到情緒名?這些 Skill 會把動機、微表情同鏡頭節拍補完整,令 AI 影片生成更似一場表演。

Repository image for zhouwei713/facial-expression-prompting

情緒寫得太粗,AI 影片角色往往只會交出一個「表情」,而唔係一段有起伏的反應。呢個 GitHub 項目定位好明確:它係一個為人物表演而設的提示詞 Skill,專門把模糊情緒拆成可拍、可生成、可放入文生視頻與圖生視頻模型的演出指令,處理的是角色點樣由看到事件、壓住反應,再慢慢洩露情緒。

最有用的地方不只是擴寫字數,而係先補足角色點解會有反應。它用五個問題建立因果鏈,再把眼神、眼瞼、眉間、嘴角、下顎、呼吸、姿態同聲音排成時間軸,連鏡頭、光線、時長同負面約束都一併整理。對 Seedance、Kling、Runway、Veo 呢類模型來講,呢種寫法比單一句「她很傷心」更容易生成連貫畫面。

同類做法常見是堆情緒形容詞,或者直接放大表情強度;呢個項目反而重視克制、遞進同角色自我控制,所以特別適合特寫、關係戲、對白反應同微表情場景。代價亦好清楚:它偏向劇情演出導向,唔係追求高速出稿的萬用提示詞模板,使用者最好本身知道角色處境,先能發揮得更準。

  • 支援完整視頻模式同表演片段模式,前者補全整段提示詞,後者可插入既有腳本
  • 適合 Seedance、Kling、Runway、Veo 等 AI 視頻模型
  • 重點唔在誇張表情,而在可見的情緒轉折、微表情同鏡頭配合
  • 會按表演節拍決定時長,而唔係固定把每段反應寫成同一秒數

這個 Repo 可理解成一個可直接複用的 Agent Skill/提示詞模板項目,而唔係獨立模型或推理服務。它較適合內容創作者、短片導演、角色動畫設計者,或者要反覆修改人物反應戲的團隊;當目標係令 AI 生成的角色「有心事」而不只是「有表情」,呢個項目的取向相當實用。

GitHub

Categories: 開源, Agentic, AI productions, Video, txt2img, 提示詞, Skill 技能

SpectraReward:用 MLLM 反讀圖片做文生圖獎勵

想提升文生圖結果,但又唔想另外訓練獎勵模型,SpectraReward提供了一條更直接的路。它用預訓練 MLLM 反過來讀圖還原提示詞,作為生成好壞的依據。

Og image

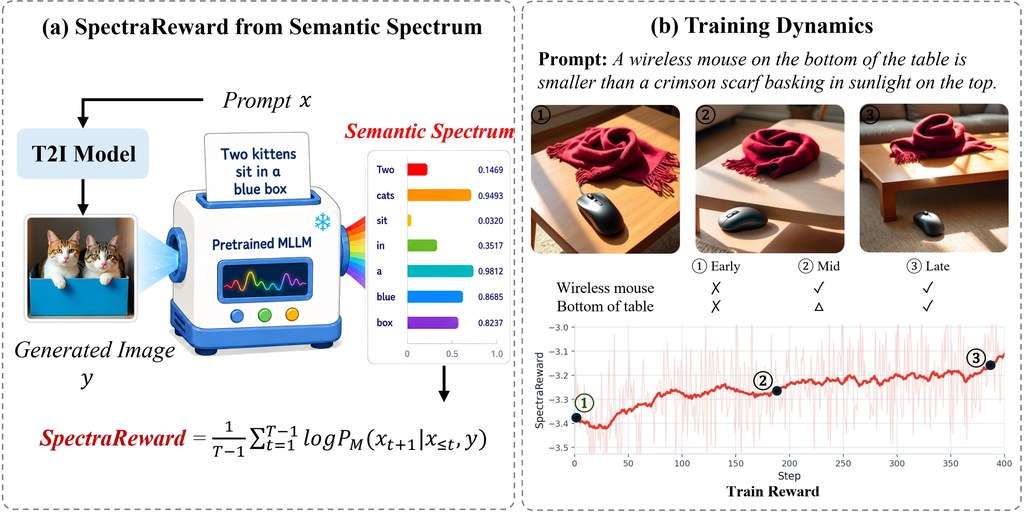
文生圖訓練最麻煩的一環,往往不是生成本身,而是怎樣穩定判斷圖片有冇跟足提示詞。SpectraReward 屬於影像生成 reinforcement learning 的獎勵方法,處理的正是這個問題:它不靠人工偏好標註,也不用再微調 reward model,而是借用預訓練 Multimodal Large Language Models(MLLMs)本身已有的圖文對齊能力,直接替生成結果打分。

核心做法很直觀:先讓 MLLM 看生成出來的圖片,再檢查它能否把原本的 prompt「讀返出嚟」。SpectraReward 用一次 image-conditioned、teacher-forced forward pass,計算 prompt 的平均 log-likelihood,數值越高,代表圖片越能還原文字意圖。相比常見做法要模型直接評分、回答拆解後的驗證問題,這個方法少了額外訓練步驟,也減少了設計評分流程的負擔。

項目亦提出 Self-SpectraReward,對 BAGEL 這類 unified multimodal models(UMMs)尤其有意思。做法是讓同一個模型的 understanding branch,為 generation branch 產生的樣本評分,形成 self-reward。這種安排的重點不在模型愈大愈好,而在 reward 與 policy 是否真正對齊;資料指出,這種內部對齊效果有時可追平,甚至超過更大型的外部 MLLMs。

  • 不需要 preference labels,也不需要 reward-model fine-tuning
  • 只用一次 MLLM forward pass,就可計出 training-free reward
  • 把「圖片能否還原 prompt」變成可量化的獎勵訊號
  • Self-SpectraReward 適合 BAGEL 類 unified multimodal models(UMMs)

從結果描述來看,reward 提升時,複雜場景生成質素也同步改善,表示這個訊號不只理論上合理,亦能推動可見的畫面進步。對正在做 text-to-image generation、影像模型強化學習,或想減少外部獎勵模型依賴的讀者來說,SpectraReward 提供了一種更省步驟、但仍保留語義判斷能力的路線。文中提到的模型包括 MLLMs,以及 BAGEL 這類 unified multimodal models。

項目主頁 · GitHub

Categories: 香港大學, 北京大學, 字節跳動, 多模態模型, 模型訓練, Image, 影像模型, txt2img, 香港

Page 1 of 3
1 2 3