OpenWAM-α 把世界模型與動作模型拆開重組

來自XPolicyLab等團隊的開源研究棧OpenWAM,把世界–動作模型(World-Action Models)拆解成可替換模組,並以約6,400小時第一人稱與機器人資料訓練出OpenWAM-α,在八個模擬基準與真機實驗均取得頂尖表現。

OpenWAM

如果你是做機器人策略或世界模型研究,大概都有過這種經驗:想換一個視覺編碼器、想試不同動作頭的耦合方式,結果整個訓練流程都要重寫,因為生成骨幹、視覺表示、架構、推論步驟和訓練資料全綁在一起。OpenWAM正是針對這種「綁死」的痛點而來。它是一個開源研究棧,把世界–動作模型(World-Action Models,簡稱WAMs)的設計空間拆成可組合模組,並用統一介面串接訓練、推論、部署與評估。

這個項目分成三層。OpenWAM-Infra提供模組化基礎設施,讓研究者可以像堆積木一樣替換模型、表示、訓練與評估設定;OpenWAM-Study則透過控制變量實驗,回答三個核心問題:應該從什麼預訓練骨幹繼承知識、世界學習與動作學習如何耦合、以及兩者如何隨規模擴展。基於這些結論,作者訓練出OpenWAM-α,一個以約6,400小時(5.185億幀)第一人稱人類與機器人資料預訓練的開放模型,並在涵蓋單臂、雙臂到靈巧手的八個模擬基準,以及真機實驗中維持頂尖水準。

架構由Hydra配置檔驅動,預設採用wan22 ti2v 5B作為影片骨幹,並搭配獨立的動作頭(如ActionDiT或共享動作骨幹),視覺編碼器則可在VAE、DINOv3、V-JEPA 2.1之間切換。基準測試覆蓋RoboTwin、LIBERO、LIBERO-plus、RoboCasa365、RoboCasa GR1、VLABench等主流環境,研究者可以直接用提供的評估客戶端跑對比。

  • 定位:開源研究棧,專門解決世界–動作模型設計選擇難以分離比較的問題
  • 核心貢獻:把生成骨幹、動作頭、視覺表示等模組化,並用控制實驗歸納出三條設計原則
  • 預訓練模型:OpenWAM-α基於約6,400小時第一人稱與機器人資料訓練,在八個模擬基準及真機均表現頂尖
  • 適用對象:機器人策略學習、世界模型研究團隊,以及需要可重現基準對比環境的從業者
  • 配套資源:模型已上傳Hugging Face,並提供完整的訓練、推論、部署腳本
項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港大學, 模型, 世界模型, 模型訓練, Video, World-Action Model, , Dataset 數據集

CosmoH2G 將人手示範轉成機械夾具軌跡

CosmoH2G 針對旋轉、翻轉等複雜空間動作,把人手示範轉換成機械夾具可執行的軌跡;其資料集包含 6,189 組配對示範。

dataset

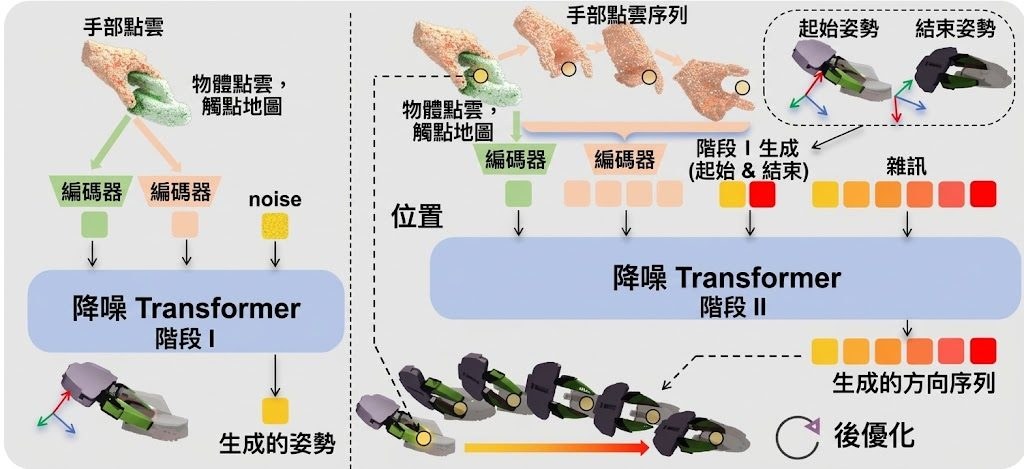
人手示範雖然直觀,但當動作包含旋轉、翻轉或複雜空間路徑時,機械夾具往往難以直接模仿。CosmoH2G 是一套面向機械人操作的資料集與基準方法,專門處理 hand-to-gripper transfer:研究團隊同步記錄人手和手持機械夾具的動作,建立可配對的 RGB-D、3D 物件點雲、手部網格及夾具動作資料。

資料集共有 6,189 個配對示範、涵蓋 1,254 件物件,規模足以支援複雜空間操作的研究。與只適合平面移動的做法相比,CosmoH2G 把重點放在細緻的手部姿勢和空間運動,並以手持夾具示範減少人與機械裝置之間的動作轉換落差。

方法分兩階段處理完整軌跡。Stage I 先預測起點和終點等稀疏關鍵幀,把複雜動作濃縮成較容易學習的目標;Stage II 再以關鍵幀為條件生成連續的夾具姿態序列。系統亦保留夾具姿態的學習結果,再利用抓取啟發式與運動學一致性修正位置,減少旋轉和翻轉過程中的累積偏差。

在模擬及真實機械人實驗中,能穩定轉移旋轉等複雜動作,並明顯勝過傳統基準。適合研究機械人模仿學習、操作資料集、3D 手部追蹤,以及需要處理非平面夾具運動的團隊。程式碼和資料集在項目網站標示為即將推出,現階段較適合先評估方法和收集流程,部署細節仍要等官方發佈。

  • 6,189 組人手與夾具配對示範,涵蓋 1,254 件物件。
  • 專注旋轉、翻轉和其他細緻空間軌跡,而非平面搬運。
  • 兩階段先學關鍵幀,再生成完整連續動作。
  • 以抓取啟發式和運動學一致性降低累積漂移。
  • 適合機械人模仿學習、資料集研究及操作策略開發。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 視覺模型, 模型訓練, Robotic, 3D, Dataset 數據集

Mask Forcing:雙重遮罩幫影片擴散模型

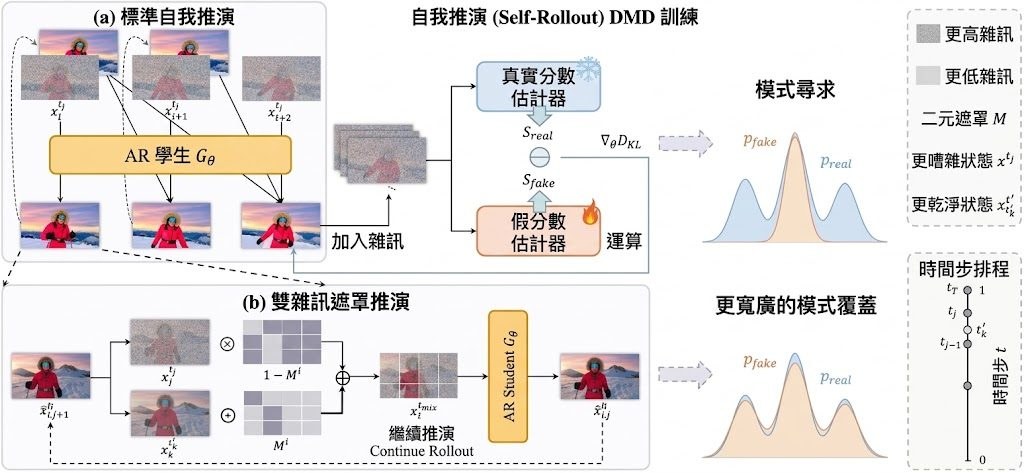
Mask Forcing 針對自回歸影片擴散蒸餾中嘅模式塌縮問題,利用雙重雜訊遮罩嘅 rollout 策略,令學生模型分佈覆蓋更多教師模式,同時唔使額外影片資料或後訓練。

Mask Forcing pipeline

用 DMD(Distribution Matching Distillation)把雙向影片擴散模型蒸餾成自回歸(AR)學生模型時,影片往往出現過度飽和同過度平滑嘅情況,背後成因係 reverse-KL 目標嘅 mode-seeking 傾向,令學生分佈容易塌縮到教師模型嘅少數模式之上。Mask Forcing 嘅切入點正正係呢個矛盾:佢喺 AR 蒸餾嘅 self-rollout 過程中,沿空間同時間軸隨機遮罩、注入較乾淨嘅 token,藉此擾動 rollout 軌跡,令學生有機會探索教師分佈嘅更多區域。

呢個做法同時帶來兩個好處:擾動令 DMD 嘅學習訊號唔再局限於學生已經覆蓋嘅模式;而較乾淨嘅 token 亦可以作為引導,協助同一 chunk 入面較嘈雜嘅 token 去噪,等中間過渡更穩定,從而減少錯誤喺後續 denoising step 同 chunk 之間累積。整個方法唔需要真實影片監督、唔需要額外後訓練階段,亦唔會增加推論成本,純粹改動訓練期嘅 rollout。

Mask Forcing 屬於一種蒸餾增強策略,主要服務於想把 AR 影片生成做快、但又想避開 DMD 視覺質素下降嘅團隊,例如做實時或近實時影片生成嘅研究同產品線。佢同一般做法嘅取捨清晰:放棄模式集中所帶來嘅短期穩定,換取分佈多樣性同中間步預測嘅可靠性。

  • 針對 AR 影片擴散蒸餾中 DMD 嘅 mode-seeking 問題,用雙重雜訊遮罩擾動 rollout
  • 不需真實影片監督或額外後訓練階段,唔改動推論流程
  • 令學生分佈覆蓋更多教師模式,並以較乾淨 token 引導較嘈雜 token 去噪
  • 適用於追求實時影片生成、又想提升視覺質素嘅研究同產品場景

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港科技大學, AI productions, 模型, 模型訓練, Video, 影像模型

Motion-Omni:「講嘢」同「做嘢」視為同一件事,直接生成全身動作

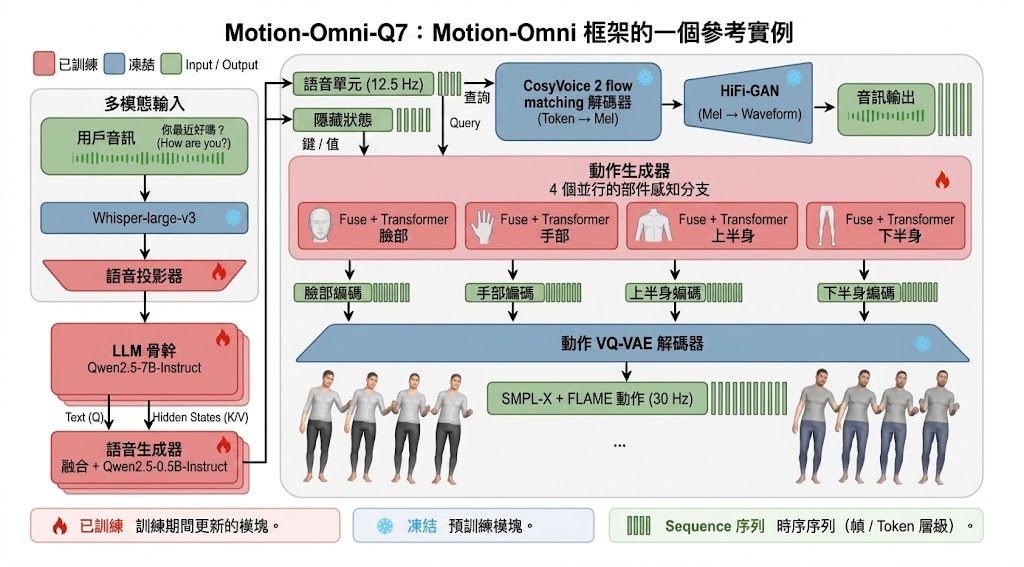
Motion-Omni 把語音和全身動作綁在同一個模型,講一句話就能即時生成對應嘅身體動作、表情同手势,適合需要邊講邊做嘅虛擬角色。

Motion-Omni framework

試過睇虛擬角色傾偈,個口形郁但身體硬晒,或者要逐段人手配動作?Motion-Omni 想解決嘅就係呢種「聲有、體無」嘅唔自然感。佢係一個端到端嘅多模態模型,輸入一段語音,輸出唔只有語音本身,仲有頭部、表情、手势以至全身姿態,全部喺同一個框架一齊生成,避免傳統做法分開處理再硬砌嘅斷裂感。

Motion-Omni 用咗一個統一嘅 tokenizer 把語音、文本同動作 token 化,配合 LoRA(Low-Rank Adaptation)adapter 等輕量微調技術,令模型可以同時學語音同肢體表達。生成嘅動作涵蓋手部、軀幹、面部表情,適合需要即時互動嘅場景,例如 AI 助手、虛擬客服、遊戲 NPC、語音驅動嘅動畫原型。

傳統動畫要先錄關鍵動作、再做 lip-sync 後製,而坊間部分開源方案往往只能控制頭部或者手部其中一樣。Motion-Omni 嘅做法係將「講嘢」同「做嘢」視為同一件事,所以動作會跟語氣、節奏同步變化,唔使額外人手調整。佢同時支援文字輸入,等開發者可以更直接控制角色行為。

對做 AI 角色、互動內容、語音動畫嘅團隊嚟講,呢種端到端做法可以慳唔少配動作同後製嘅工序,尤其適合需要快速原型嘅項目。讀者可以透過官方頁面睇影片 demo,評估生成動作嘅自然度同延遲表現,再判斷適唔適合自己嘅工作流。

重點摘要

  • Motion-Omni 係一個端到端多模態模型,同時輸出語音、表情同全身動作
  • 用統一 tokenizer 加 LoRA adapter 處理語音、文本同動作 token
  • 覆蓋頭部、手部、軀幹同面部表情,適合即時互動角色
  • 傳統做法分開配音同配動作,呢個模型將兩者合併生成
  • 適用於 AI 助手、虛擬客服、遊戲 NPC、語音動畫原型等場景

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 北京大學, AI productions, 模型, 多模態模型, Video, 框架, 語音, 動畫

SolarWM 開放視頻世界模型全流程基建

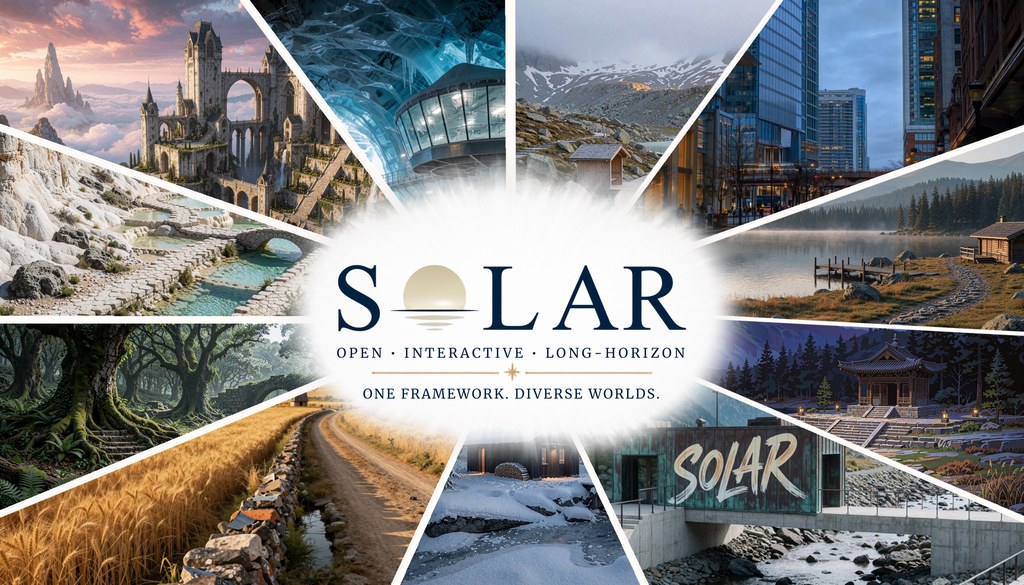
SolarWM 不只公開模型權重,連數據處理、訓練流程和長時推理方法一併開放,目標是降低互動式視頻世界模型的研究門檻。

SolarWM teaser: one framework for diverse interactive worlds

從數秒訓練片段推演出長達數分鐘甚至更長時間的互動視頻,一直是世界模型(World Model)發展中的難題。SolarWM 把焦點放在整個研發鏈條,而不只是單一模型,結合開放數據管線、訓練框架與推理流程,形成一個面向互動式視頻世界模型的完整研究基礎設施。

項目屬於世界模型訓練框架與開放研究基建,處理的問題是如何把不同來源的視頻資料整理成一致格式,並在不同模型骨幹之間建立可擴展的長時推理能力。團隊將來自 14 個資料集、約 143 萬段影片統一整理,讓資料準備與訓練配方可以分離,研究人員毋須重複建立資料處理流程。

與許多只圍繞單一架構設計的方法不同,SolarWM 強調保留原生骨幹能力,同時支援 Wan2.2、LTX-2.5 與 MiniMax-H3 等不同模型家族,涵蓋 5B 至 33B 規模。研究團隊提出三階段訓練流程,包括雙向適應、結合 AnyFlow 的教師強制訓練,以及長時互動推理策略,希望在不依賴超長訓練影片的情況下維持世界演化一致性。

  • 開放釋出資料處理管線、資料集及模型權重
  • 支援多個主流視頻生成骨幹,而非綁定單一架構
  • 利用約五秒片段訓練,目標達成分鐘級甚至小時級推理
  • 涵蓋 143 萬段影片與約 25TB 數據規模
  • 提供可重組資料配方與不同訓練策略組合

適合世界模型研究團隊、互動式模擬系統開發者,以及探索 World-Action Model 與長時視頻生成的學術機構。SolarWM 的價值不只在單次生成效果,而在於把過往難以重現的資料處理和訓練步驟公開,讓不同研究單位更容易比較方法與建立可重複驗證的實驗流程。長時間推理的一致性仍有待更多公開基準驗證,但這套框架已經把世界模型研究由單一模型競賽推向完整基礎設施層面。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, 世界模型, 模型訓練, NVIDIA, World-Action Model, 3D, LTX, Dataset 數據集, MiniMax

UrbanGround 開源:真實香港城市級 3D 沙盒多模態智能體

UrbanGround 是一個以香港全境 3D 地理數據搭建的城市級模擬環境,可直接用第一人稱遊玩,亦可讓 MLLM 智能體透過程式介面操作同一個世界。

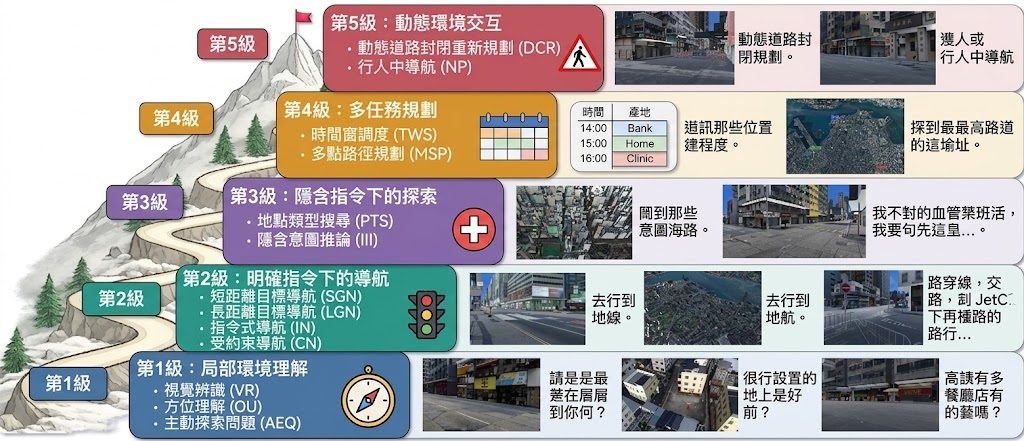
UrbanGround: From Local Perception to Spatial Agency in a Real-Scale City

UrbanGround 由一個學術團隊在 GitHub 上開源,整個項目的野心在於把「真實城市規模」這件事帶進多模態智能體(Multimodal Large Language Model, MLLM)的研究裡。它以香港的 3D Visualisation Map 為底層地理數據,搭配 Unity 場景提供第一人稱連續移動、碰撞與日夜、天氣、行人等動態變化,使用者可以直接以 WASD 鍵盤操作在城市裡行走、爬樓梯、找地點、切換視角,亦可以交由 AI 智能體透過程式介面(HTTP API)取得 RGB 觀察、物理動作與地圖資訊,自行決策。

這個環境和過往以小型合成場景或封閉遊戲引擎為主的做法相比,核心差異在於「規模」與「真實地理閉環」:智能體看到的不是抽象方塊,而是一座真實城市的街道、樓宇、地形,並且觀察、動作、地圖三者來自同一個介面,方便研究者設計貼近真實導航、空間感知與任務規劃的測試。整個項目同時釋出網頁版、macOS、Windows 與 Linux 原生版本,並附上多個由五個能力層級組成的評測任務,供 MLLM 在感知與行動兩端做系統性比較。

對研究 MLLM 空間智能、城市導航或數字孿生的團隊來說,UrbanGround 提供了一個比手工搭建的小場景更貼近現實的測試場;對一般玩家或開發者而言,它也是一個能在瀏覽器直接探索香港街景的實驗性沙盒。需要留意的是,網頁版首次載入完整 Unity 場景在繁忙時段或慢速網絡下需時約 3 至 5 分鐘,作者建議從 GitHub 下載並在本地網絡提供 tile 數據以加快速度。目前場景仍有「模糊或不完整幾何」以及「車輛與行人種類有限」等已知限制,相關修正在路線圖中。

重點摘要:

  • 真實城市規模:以香港全境 3D 地理數據驅動,非抽象小型合成場景。
  • 雙操作介面:第一人稱玩家與 MLLM 智能體共享同一套 RGB 觀察與動作 API。
  • 跨平台發佈:提供網頁版與 macOS、Windows、Linux 原生應用。
  • 結構化評測:內建多層級任務,用於量度多模態智能體在感知與行動上的能力。
  • 已知限制:場景幾何仍有缺損,車輛與行人種類待擴充。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 多模態模型, API, 香港, Mac, 3D, Linux, Dataset 數據集

Video-IFBench:跟足要求的影片評測

Video-IFBench 用來量度多模態大語言模型在影片理解場景中的指令跟隨能力。它把單步、多步、選擇和嵌套指令拆開測,直接看模型能否按條件做對。

Overview of the Video-IFBench construction and evaluation pipeline

Video-IFBench 是一個用來評測多模態大語言模型(Multimodal Large Language Models, MLLMs)在影片理解場景中是否跟足指令的資料集與基準。它處理的不是單純看懂影片,而是模型能否在複雜限制下,依照影片證據作出正確分支判斷、完成多重要求,並保持輸出格式一致。

這套基準把任務分成 Single、Multi、Selection 和 Nested 四類,覆蓋由簡單到層層加條件的情境。項目建構流程結合影片標註、任務與限制採樣、複雜指令生成、checklist、程序化處理和人工驗證,適合拿來測試模型在真實工作流裡會否因為條件一多就失手。

和一般只看整體問答正確率的影片基準相比,Video-IFBench 更著重嚴格遵循指令的程度。資料集同時提供 TCSR 和 TISR 兩種指標,結果顯示即使是頂級商用模型,遇到條件累積或需要按證據選分支的題目,分數也會明顯下滑;開源模型的差距更大,尤其在 Nested 類別。

對做影片理解、視覺問答、agent 評測,或者需要檢查模型能否按規則輸出內容的團隊,這個基準很有參考價值。它不只看模型「知唔知」,而是看模型「有冇照做」,這正是很多落地應用最容易出問題的位置。

  • 覆蓋影片理解中的四種指令型態,從單步到嵌套條件都有測。
  • 以 checklist 和人工驗證強化標註可靠度。
  • 用 TCSR 與 TISR 分開看內容命中與指令跟隨。
  • 商用模型整體較強,但複雜條件下仍有明顯失分。
  • 開源模型在多條件、分支選擇和格式遵循上差距更大。

項目主頁 · GitHub · 數據集

Categories: 開源, 香港中文大學, 字節跳動, 騰訊, Agentic, 視覺模型, 多模態模型, Video, Dataset 數據集

VoiceMem 讓語音 AI 記住你的情緒與偏好

VoiceMem 以流式雙腦架構處理事實記憶、情緒與人格,讓語音智能體在對話中更懂使用者,同時控制延遲與成本。

VoiceMem Logo

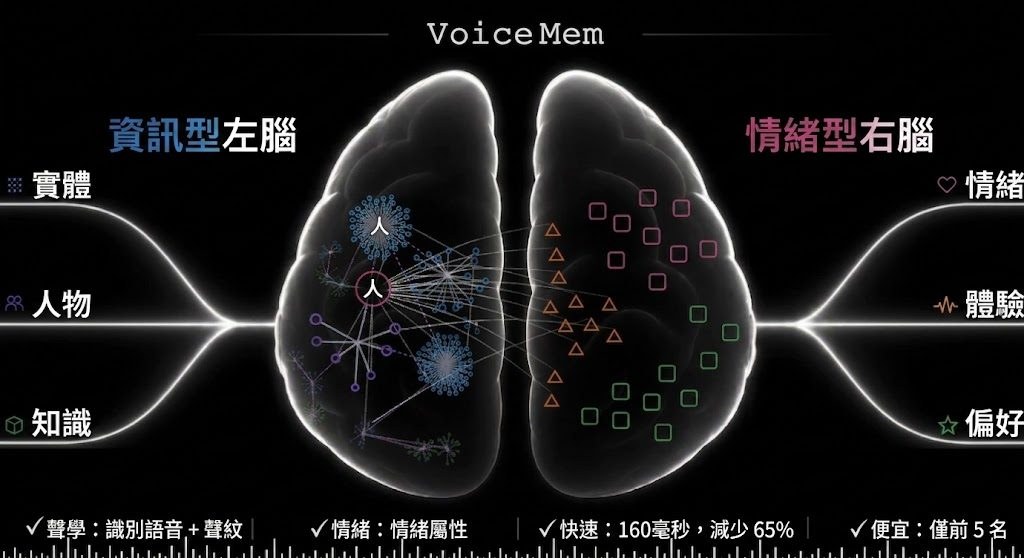
語音智能體要記住「我是素食者、對堅果過敏」,並不只是保存轉錄文字,還要分辨人物、情緒、偏好與性格。VoiceMem 屬於語音 AI 記憶引擎及可整合的庫,處理音訊輸入、記憶抽取、檢索和回應前的上下文注入,讓長期個人化對話不必每次重新建立背景。

它採用 VoiceMem Dual-Brain Streaming Architecture(流式雙腦架構):左腦以 schema 與 entity 組織事實記憶,右腦獨立管理情緒、偏好和人格,亦維護跨 entity 的關聯。音訊仍在輸入期間,系統已經分段、轉錄、抽取資料並寫入記憶圖;查詢時先路由及排序,只把 Top-K 記憶放入上下文,減少語音回應需要處理的內容。

  • 左腦在 Top-3 限制下維持 Mem0 的滿載性能
  • 右腦加入長短期情緒歸因及交叉節點
  • 透過壓縮資訊、分層儲存和流式查詢降低等待時間
  • 單輪查詢約需 300 token,架構及底層記憶引擎可替換

VoiceMem 內置 ASR(Automatic Speech Recognition)、聲紋、場景、情緒感知及本地 embedding 元件,亦提供離線記憶引擎和 streaming interface。倉庫資訊包含 Python 庫、互動式網頁 demo、VoiceMem_Default_Models_Env 模型環境,以及可選的 Qwen 回應模型;但完整硬件要求、服務依賴和模型授權仍需按連結內容逐項確認,不能單靠 README 推斷。

ChatMem-400K 以記憶世界構建、SLM 驗證的 online on-policy distillation 和人工修訂三階段製作,配合 VoiceMem Model Families 的 Qwen3 6 35B A3B Qlora 模型系列。這令項目較適合需要長期語音陪伴、個人助理、客服或具情緒連續性的 voice agent 團隊;對只需短對話轉錄的工作流,雙腦記憶層會增加整合和維護成本。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 清華大學, Agentic, Embedding, 多模態模型, Qwen, Python, , 語音

GameXpert-Bench | Coding Agents for Game Development

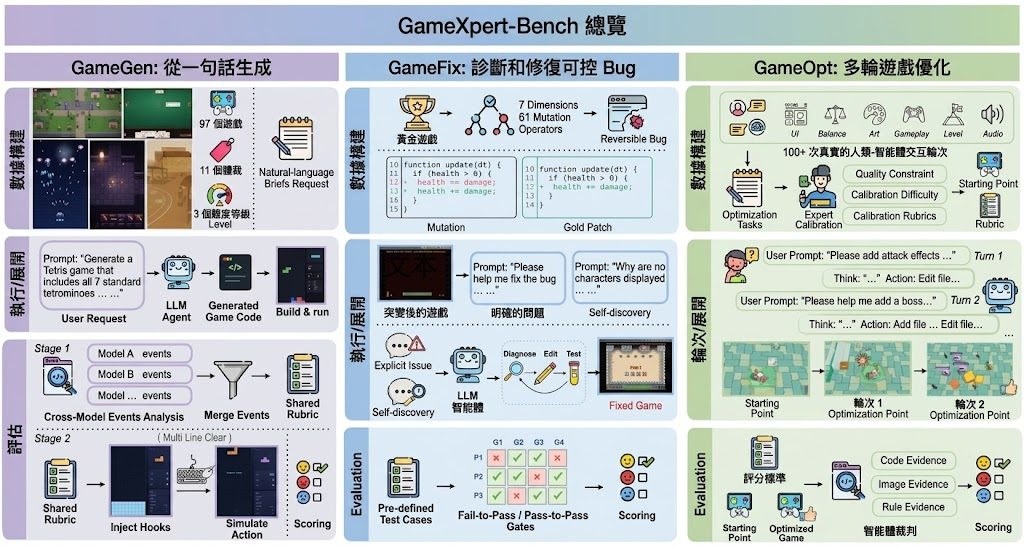
騰訊團隊聯同多間院校提出 GameXpert-Bench,專門看 Coding Agents 能否做出、修好再優化可玩遊戲。它把生成、修復同多輪改進放入同一條流程去評估。

Og image

騰訊 Hunyuan Team、Lightspeed Studios,聯同 CASIA、清華大學、香港科技大學、香港中文大學深圳等團隊,提出 GameXpert-Bench,用來檢驗 Coding Agents 在遊戲開發上的真實能力。它不只看程式碼寫得像不像,還看能否真的做出可玩遊戲、找出錯誤,並在多輪修改後保持功能完整。

這個項目處理的是一個很實際的落差:很多代理可以生成看似合理的程式,但一到互動、畫面、音效、介面同可玩性要同時成立,就容易出問題。GameXpert-Bench 把整個生命週期拆成三條軌道,分別測首次生成、修復缺陷,以及連續優化,逼近真實開發流程。

  • GameGen 測試從零開始生成可玩遊戲,沒有預設引擎或素材
  • GameFix 測試對已知缺陷的診斷與修復,亦包括自行發現問題的情況
  • GameOpt 測試多輪改進時能否保住核心玩法與既有功能
  • 評估不只看程式,還結合互動行為、代碼檢查同人工判斷

目前公開資料提到共有 97 個生成任務、100 個修復任務,以及 17 條多輪優化鏈,涵蓋 2D 和 3D 遊戲。整體結果指向一個清楚結論:寫出看似合理的實作,比起交出經過驗證、又唔會在後續修改中壞掉的遊戲容易得多。

對做 Coding Agents、遊戲工具鏈、或研究 agentic software engineering 的讀者,這個基準特別有參考價值。它把「能寫」和「能交付」分開,令模型在真實工作流中的短板更容易被量度出來。

項目主頁

Categories: 香港中文大學, 香港科技大學, 清華大學, 騰訊, Agentic, Audio, 軟件, 3D, 編程, Dataset 數據集

4DAnyone 把單鏡頭影片重建 4D 多視角

由一段普通單鏡頭人物影片開始,4DAnyone 生成具一致性的多視角影片,再交由 4DGS 重建可動人物。

4DAnyone

由未校準的 monocular video 出發,4DAnyone 可以為同一個人物生成多個目標視角,接着交給 4D Gaussian Splatting(4DGS)建立可渲染的 4D 人物。這個 GitHub 項目屬於 4D 人物重建工具,處理的是拍攝時沒有多部相機、相機內參或姿態資料,卻想取得多視角動態素材的問題。

它不只把畫面轉成另一個角度,而是嘗試維持不同視角之間的時間和外觀一致性,讓後續 4DGS 重建不必直接面對單鏡頭資料的視角缺口。相較於需要 rig、校準相機或固定三腳架的流程,這個方法換來的是對輸入影片質素和人物動作的依賴。

使用 inference.py 讀取影片,再以 views_per_layerlayer_pitchesstart_yawyaw_span 控制相機層數、上下角度及水平覆蓋範圍。儲存庫提供 Python 3.11、requirements 和第三方 GVHMR 元件的安裝安排,缺少的模型及例子會在首次使用時自動取得;原始資料沒有交代硬件需求、推理時間或量化性能,因此不能把速度表現視為已被驗證。

  • 支援全身或上半身、畫面只包含一人的影片
  • 可生成 6、24、48 個或自訂數量的目標視角
  • 兼容輕微鏡頭移動,以及未知相機內參和姿態的素材
  • 可選 FlashAttention-3 或 SageAttention 加快推理

研究展示內容集中於不同人物影片、動作和場景的泛化能力。需要製作 4D 人物、研究自由視角影片,或建立動態人像資料的團隊;只想快速套用濾鏡或要求即時輸出的使用者,仍要先確認硬件、模型取得方式和影片條件是否符合要求。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, AI productions, 數字人, 視頻模型, Video, Python, 語音

Page 1 of 7
1 2 3 7