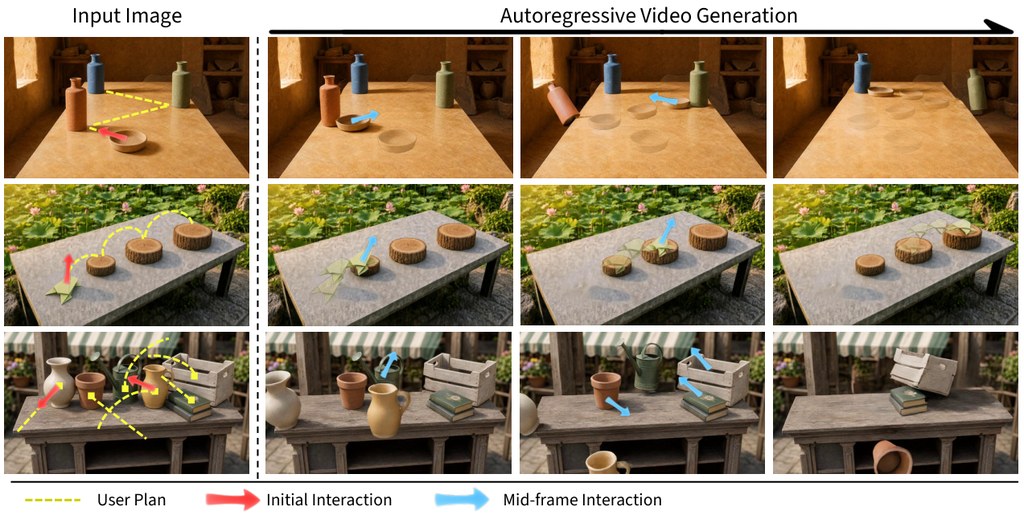
以往想用 AI 生成一段符合物理規律的影片,往往需要在生成前就設定好整個控制排程,而且很多方法只懂在像素層面指定物件位置,未必真正理解「力」與「速度」這類物理量。PhysStream 的切入點正正落在這個空隙:它是一個自回歸的物理導向圖生影片模型,支援中途互動,容許用戶在生成過程中隨時拉動物件,改變它的運動方向。
核心做法分兩個階段。先用一個雙向模型做微調,加入速度增量(velocity increment)這類稀疏信號作控制條件,讓模型學到背後的動力學;再訓練一個因果自回歸模型,引入結構化場景記憶,記錄位置圖與物件追蹤圖,使每一幀生成都能參考歷史畫面的一致狀態。同時解決了「中途介入」與「物理一致性」兩個難題。
PhysStream 把運動分佈距離(FVMD)降低 33%、軌跡誤差降低 12%,而且在真實場景的人類評測中,超過 85% 的對比都獲得偏好。在多物件桌面剛體場景裡,這種邊生成邊控制的能力是目前其他方法做不到的。對做特效、動畫預覽或物理模擬預演的團隊來說,這種「拉到邊做」的互動模式會比較貼近日常工作流。
重點摘要:
- 中途拖動控制:生成過程中可隨時改變物件運動方向,毋須事先設定控制排程
- 物理導向信號:採用速度增量而非像素位置,讓模型學習真正的動力學
- 結構化場景記憶:以位置圖與物件追蹤圖維持長影片一致性
- 兩階段訓練:先雙向微調學控制條件,再因果自回歸強化物理一致性
- 評測表現:FVMD 降 33%、軌跡誤差降 12%,人類評測偏好率逾 85%