SolarWM 開放視頻世界模型全流程基建

SolarWM 不只公開模型權重,連數據處理、訓練流程和長時推理方法一併開放,目標是降低互動式視頻世界模型的研究門檻。

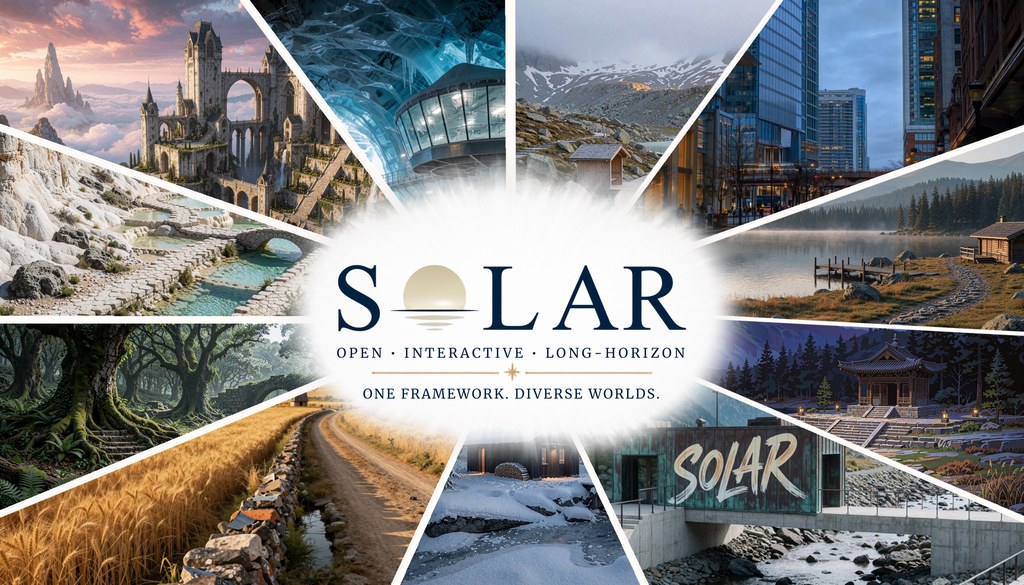
SolarWM teaser: one framework for diverse interactive worlds

從數秒訓練片段推演出長達數分鐘甚至更長時間的互動視頻,一直是世界模型(World Model)發展中的難題。SolarWM 把焦點放在整個研發鏈條,而不只是單一模型,結合開放數據管線、訓練框架與推理流程,形成一個面向互動式視頻世界模型的完整研究基礎設施。

項目屬於世界模型訓練框架與開放研究基建,處理的問題是如何把不同來源的視頻資料整理成一致格式,並在不同模型骨幹之間建立可擴展的長時推理能力。團隊將來自 14 個資料集、約 143 萬段影片統一整理,讓資料準備與訓練配方可以分離,研究人員毋須重複建立資料處理流程。

與許多只圍繞單一架構設計的方法不同,SolarWM 強調保留原生骨幹能力,同時支援 Wan2.2、LTX-2.5 與 MiniMax-H3 等不同模型家族,涵蓋 5B 至 33B 規模。研究團隊提出三階段訓練流程,包括雙向適應、結合 AnyFlow 的教師強制訓練,以及長時互動推理策略,希望在不依賴超長訓練影片的情況下維持世界演化一致性。

  • 開放釋出資料處理管線、資料集及模型權重
  • 支援多個主流視頻生成骨幹,而非綁定單一架構
  • 利用約五秒片段訓練,目標達成分鐘級甚至小時級推理
  • 涵蓋 143 萬段影片與約 25TB 數據規模
  • 提供可重組資料配方與不同訓練策略組合

適合世界模型研究團隊、互動式模擬系統開發者,以及探索 World-Action Model 與長時視頻生成的學術機構。SolarWM 的價值不只在單次生成效果,而在於把過往難以重現的資料處理和訓練步驟公開,讓不同研究單位更容易比較方法與建立可重複驗證的實驗流程。長時間推理的一致性仍有待更多公開基準驗證,但這套框架已經把世界模型研究由單一模型競賽推向完整基礎設施層面。
項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, NVIDIA, Agentic, 3D, 模型訓練, 世界模型, World-Action Model, MiniMax, Dataset 數據集, LTX

LightNav-0:一句說話驅動四種機械人零樣本導航

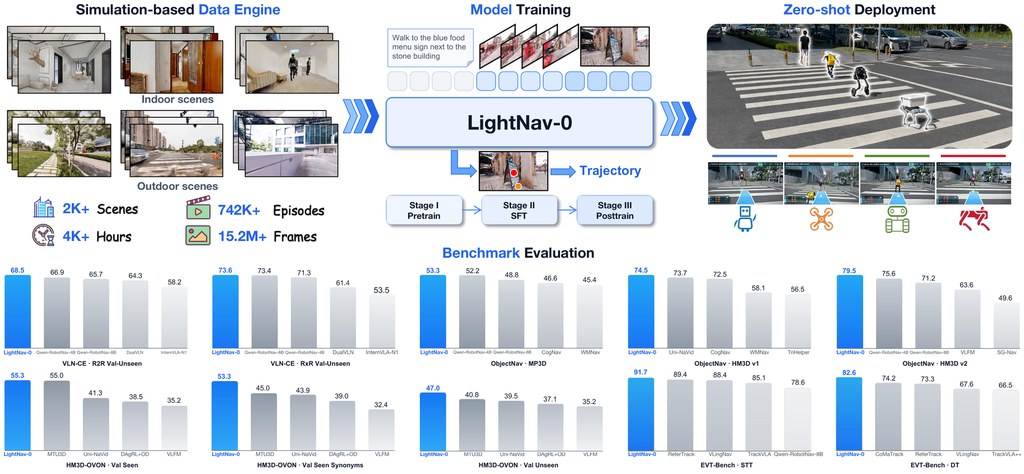
LightNav-0 是一個通用導航模型,把預訓練視覺語言模型 Qwen3-VL 的空間認知能力對齊到導航任務,無需任務專用頭即可同時處理指令跟隨、開放詞彙物件導航與視覺追蹤,並零樣本遷移到人形、四足、輪式及空中機械人。

LightNav-0 overview: a simulation-based data engine, three-stage model training, zero-shot deployment onto four robot em

你叫一部機械人「去到公園入口嗰張長椅」,佢就要自己搵到、避開障礙、仲要處理自己對眼睇到嘅畫面——LightNav-0 就係針對呢類跨場景、跨形態嘅導航需求。佢屬於模型類項目,核心想解決嘅問題係:傳統導航系統每換一種機械人或場景就要重新訓練或加任務頭,零樣本泛化能力薄弱。LightNav-0 選擇唔加 waypoint predictor、唔加任務專用動作頭,淨係擴展詞表,加入雙通道指向 token 同 RVQ 動作 token,等空間推理同動作編碼都直接由 Qwen3-VL-4B-Instruct 原有嘅自回歸 LM head 解碼。

要做到呢點,訓練數據係關鍵。項目用咗一套 Real2Sim2Real 數據引擎,將 2,000 幾個互聯網收集嘅真實場景轉成可重複使用嘅模擬環境,產生 4,000 幾個鐘嘅視覺語言動作經驗,再分三階段訓練:Embodied Reasoning 中訓練、Embodied SFT、Online RL。呢種做法繞過咗真實遙操作收集速度慢、成本高嘅瓶頸。

同典型做法比,差異在於用模擬合成代理真實經驗,再透過統一 token 介面讓指令跟隨、開放詞彙物件導航、視覺追蹤共享同一模型,部署時直接零樣本落地到四種機械人形態,唔需要逐個微調。結果方面,官方指 LightNav-0 喺十個模擬設定上取得 state-of-the-art,並喺人形、四足、無人機同輪式機械人上完成真實遷移測試。

做機械人通用導航研究嘅團隊、要做具身 AI 落地嘅初創,或者關注 Physical AGI 路線嘅研究者,會最容易從中受惠。對一般開發者嚟講,理解入口係 Hugging Face 上嘅模型權重、論文同項目頁提供嘅模擬評測結果。

重點摘要:

  • LightNav-0 係以 Qwen3-VL-4B-Instruct 為骨幹嘅通用導航模型,無任務專用預測頭
  • 用統一 token 介面同時覆蓋指令跟隨、開放詞彙物件導航同視覺追蹤
  • Real2Sim2Real 數據引擎將 2,000+ 真實場景轉化為 4,000+ 小時訓練經驗
  • 三階段訓練流程:Embodied Reasoning 中訓練、Embodied SFT、Online RL
  • 零樣本遷移至人形、四足、輪式及空中機械人,喺十個模擬基準宣稱達到 SOTA

項目主頁 · GitHub

Categories: 開源, Qwen, 多模態模型, 視覺模型, Robotic, AGI, World-Action Model

PhysCaP 讓機械人用互動摸清物件物理特性

當視覺無法分辨重量或軟硬,PhysCaP會主動安排互動,讓機械人用更少動作完成操作任務。

Og image

由國立台灣大學、NVIDIA Research、Google DeepMind 及國立陽明交通大學研究人員組成的團隊,推出 PhysCaP,將物理資訊探索加入 Code-as-Policy 機械人代理。

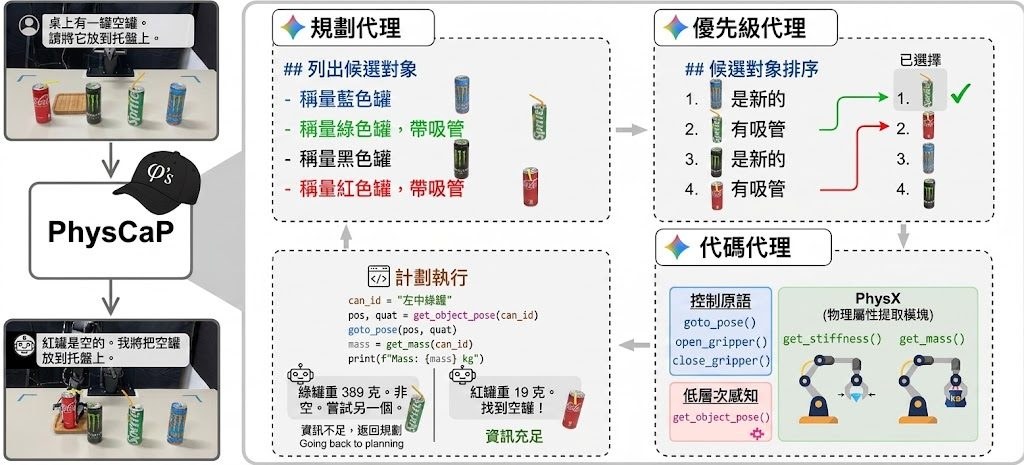
當機械人只靠相機無法分辨哪罐是空的、哪個牛油果已熟,PhysCaP會主動安排提起、夾取等互動,從動作反應推斷隱藏的重量與硬度。這個 physics-informed Code-as-Policy agents 項目,針對被動視覺不足時的機械人操作問題加入主動感知能力。

PhysCaP以雙代理探索框架配合可執行程式碼。Planner先判斷視覺資訊是否足夠,Prioritizer再按預期 information gain 排序互動,過濾不合理或重複的動作,最後呼叫 PhysX(physical property extraction modules)中的 get_massget_stiffness

  • 透過 joint-torque 差異及 end-effector Jacobian 估算物件質量
  • 根據 gripper displacement 和 normalized motor effort 分類硬度
  • 無需額外感測硬件,直接利用 robot proprioception
  • 涵蓋找藍色方塊、辨認空罐和挑選熟牛油果
  • 模擬與真實任務中,部分結果達到 9/10 成功率

測試亦包括 LIBERO Empty Can 模擬環境。研究結果指,這種按資訊價值選擇互動的方式,在多項 benchmark 中較被動方法和直接進行互動的方法取得更高任務成功率,同時減少互動次數及執行時間;不過,推斷質量和硬度仍取決於固定提舉軌跡、重複測量及機械人本身的 proprioception。

項目主頁

Categories: Google, NVIDIA, Agentic, 模型訓練, Robotic, 框架, Dataset 數據集, World-Action Model

NVidia Hydra-0 以人類動作統一機械人訓練

Hydra-0把機械人動作轉成畫面上的像素流,讓同一個世界模型學習不同機械人形態,並支援模擬、策略評估及真機控制。

Og image

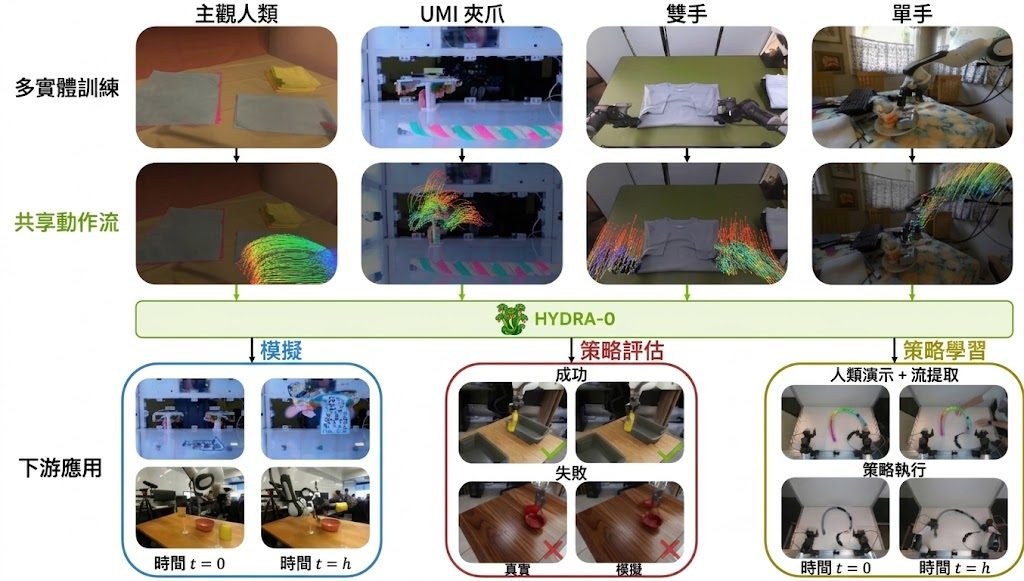
機械人面對不同手臂結構、夾具和操作環境時,動作通常以各自的關節或末端執行器座標表示,令資料難以共用。Hydra-0以 Action Flow 將可見的機械人運動表示成影像平面上的像素流,建立跨形態、任務和環境的共同控制介面,屬於面向通用控制的 world model。

Hydra-0在運行時採用 hybrid simulator:physics engine 負責移動機械人,learned video model 則預測動作對場景造成的變化。模型可從 egocentric human demonstrations、handheld UMI grippers、single-arm robots 和 bimanual robot arms 等互動影片學習,減少依賴單一機械人平台資料的限制。

Forward mode會根據 gripper flow 預測未來場景,生成的結果可用於 open-loop policy evaluation;inverse mode則由目標物件的 flow 推導相容的機械人運動,再透過 supervised readout 轉換成可執行動作。把模擬、策略測試和控制放進同一套模型流程。

• 以像素流統一四種不同 embodiment 的互動資料
• 同時支援世界預測、策略評估及機械人控制
• 以 physics engine 和 learned video model 組成 hybrid simulator
• 最佳配置令 robot-motion error 降低90.4%,object-motion error 降低60.2%,比較基準為 action-conditioned baseline

Hydra-0適合需要整合多來源示範影片、先在模擬環境測試策略,再連接真實機械人的研究和開發工作。它仍然依賴動作影片、像素流表示和模型預測的準確度,跨形態轉移能否在更多任務中保持穩定,仍要配合完整數據和真機測試判斷。

項目主頁

Categories: NVIDIA, Video, Image, 視覺模型, Robotic, 世界模型, World-Action Model

τ₀-VLA:為長程機械人任務補上分層推理

τ₀-VLA 把長程機械人操作拆成高層規劃與低層執行,先想下一步,再落到實際動作。它特別針對多步驟、要記住進度又要回復失誤的場景。

τ₀-VLA overview

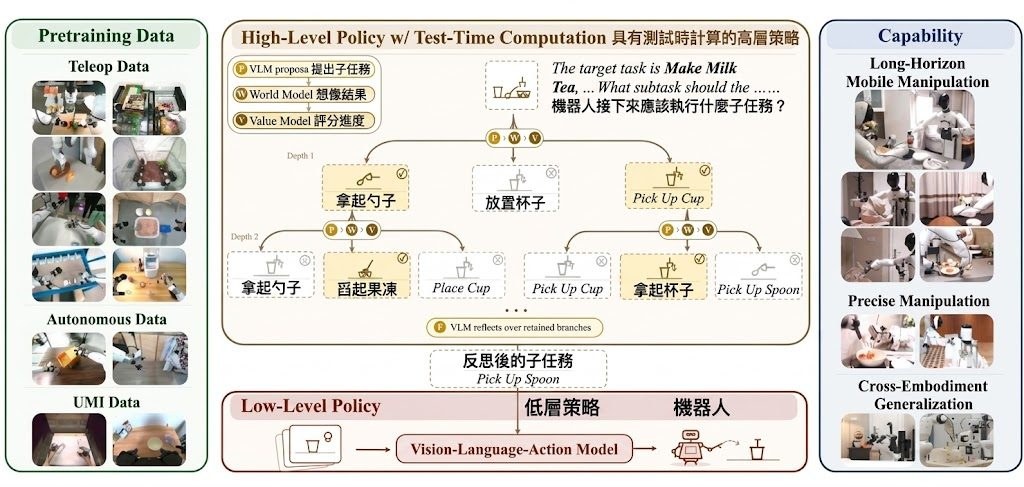
τ₀-VLA 是一個機械人基礎模型,主打長程操作任務,例如清理房間、準備食材和沖奶茶這類要連續完成多個步驟的工作。它先用帶記憶的高層策略決定下一個子任務,必要時再用 world-model-guided test-time computation 比較不同做法,然後交由低層策略執行。

這種分層方式比單次前向推理更適合處理長流程,因為模型不只要做動作,還要跟進已完成進度、預測結果,再決定下一步。對需要機械人跨場景操作的團隊來說,比只處理單一步驟的控制模型更接近真實工作流程。

  • 高層負責規劃子任務,低層負責具體控制
  • 會在需要更多推理時做分支搜尋,不是即時拍板
  • 低層策略結合 Qwen3.5 vision-language backbone 與 Mixture-of-Transformers action expert
  • 訓練資料來自 40,115 小時真實機械人數據,涵蓋多模態協同訓練
  • 目前公開 v1 只支援 joint-control checkpoints,EEF serving 未提供

官方提供 Python 3.11、CUDA 12.8、PyTorch 2.7.1 的參考環境,也有 example_data 同配置的 post-training 例子,可用來接入自己的資料集或機械人設定。文中四個長程任務涵蓋 13 至 25 個步驟,重點不只是在動作準確,還包括進度保持、結果驗證和失誤後恢復。

對做機械人研究、具身智能系統,或要把語言理解和實體控制接起來的團隊,這個項目提供了一個較完整的分層基線;限制也很明確,公開版本先集中在 joint-control,較適合有相應訓練與部署條件的環境。

項目主頁 · GitHub · 模型

Categories: 開源, Qwen, NVIDIA, Python, 多模態模型, 模型訓練, World-Action Model, VLA

ForgeWM 把遊戲世界模型推向 72 FPS 即時互動

由中大、騰訊等團隊開發的 ForgeWM,將遊戲畫面生成壓縮至一至四步,讓鍵盤、滑鼠及手掣輸入能即時改變虛擬世界。

ForgeWM

中香港中文大學、騰訊 PCG、復旦大學、上海人工智慧實驗室及香港科技大學的研究團隊,將 ForgeWM 做成開源的 action-conditioned video world models 訓練項目,處理遊戲輸入與連續畫面生成難以兼顧的問題。它以 Matrix-Game 2(MG2)為基礎,讓模型根據鍵盤、滑鼠或 gamepad 操作即時推演遊戲畫面。

ForgeWM 的價值在於把生成步數降至 1、2 或 4 步,換取更低延遲的互動體驗;取捨是畫面質素、控制準確度與推理速度仍要依賴訓練資料和硬件。相較只展示影片生成的做法,ForgeWM 直接處理 frame-aligned 的動作訊號,並將同一套流程移植到另一個 gamepad 驅動的 FPS 領域。

  • 一套四階段流程:bidirectional SFT、teacher-forced causal AR、consistency distillation、on-policy DMD
  • ForgeWM-1、ForgeWM-2、ForgeWM-4 分別對應一、二及四步生成
  • 單張 H20、352×640 畫面下,1-step 模型最高達 72 FPS
  • 完整公開 weights、training code 及 pre-encoded data

模型並非各自獨立訓練:Stage 0 先對目標遊戲作 bidirectional fine-tuning,之後固定為教師;Stage 1 將生成器改成 causal AR,Stage 2 壓縮 sampling trajectory,Stage 3 再用學生自行 rollout 的結果進行 on-policy matching。這個結構讓 ForgeWM-1、-2、-4 可從相同基礎流程按步數預算建立。

研究、遊戲 AI 及需要即時互動生成的團隊較容易受益,尤其適合測試鍵鼠控制的 Minecraft 或 gamepad FPS。資料提供的指標包括 168 ms per chunk、72 FPS 及 8×H20 完整訓練配置;模型及數據連結整理環境,要預留 8 張 H20 重現完整訓練流程。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, 騰訊, Video, 模型訓練, 世界模型, 上海人工智慧實驗室, World-Action Model

HumanTracker 想解決人形動作評測失真

影片睇落穩唔穩,未必等於關節誤差低。HumanTracker把人類偏好納入評測,補回人形動作追蹤最常被忽略的一段。

HumanTracker

只看關節角度誤差,往往會把腳滑、落地時機錯、支撐不穩這些觀感上很明顯的問題沖淡。HumanTracker屬於資料集加評測工具類型,核心不是再做一個追蹤模型,而是替 humanoid motion tracking 建立更貼近人眼判斷的 benchmark,讓 teleoperation 與 whole-body imitation 的結果不只「數值過關」,影片也更可信。

它的價值在於同時補兩個缺口:一邊擴大測試覆蓋,另一邊重寫評分方法。項目收錄約 153 小時光學動作資料、來自 24 位專業表演者,整理成四類動作家族,專門拉開日常步態、高動態、互動動作與接地穩定性之間的差異;再用 12K human-labeled preference pairs,訓練出偏好對齊的 HumanScore,去判斷哪條 tracker trajectory 更接近人會接受的效果。

跟 MPJPE 這類逐幀 kinematic 指標相比,HumanScore 重點不在每一幀有幾準,而在整段軌跡有沒有出現長時間滑步、抖動、漂移與失去平衡。官方提供的結果顯示,HumanScore 在測試集對人類偏好的對齊率達 90.83%,比較強的傳統診斷指標高 6.78 分;README 亦保留 Succ、MPJPE 與 HumanScore 幾種分數,代表它不是取代舊指標,而是把「物理上站不站得住」這件事補回評估流程。

  • 約 153 小時新採集 optical motion,涵蓋 25K 級別標註片段
  • HumanScore 來自 trajectory reward model,學的是人對整段動作的偏好
  • 儲存庫提供 evaluation harness、HumanScore reward model 同數據處理工具
  • 適合做人形機械人追蹤、模仿學習、teleoperation 評測的研究團隊使用

這個 GitHub 儲存庫比較像研究評測基建:重點是下載資料集、跑 evaluation harness、再用 HumanScore 與傳統指標一起看結果,而不是即開即用的終端產品。受益最大的會是做人形控制、動作追蹤與模仿策略比較的團隊,因為它能幫你分辨模型究竟只是把姿勢角度擬合得好,還是真的把接觸、穩定與動作連貫度處理好。限制也很明確:它主要提升的是評測可信度,不等於直接改善 tracker 本身能力。

項目主頁 · GitHub

Categories: 開源, World-Action Model, Dataset 數據集, 北京大學, 清華大學

StateFlow 把預視化變成可反覆編修 3D 世界

想像先搭好一個可重用的3D世界,再慢慢改鏡頭、物件同事件。StateFlow想處理的,正是生成式預視化最常見的連貫性問題。

StateFlow teaser

影像預視化最麻煩的地方,往往不是生成一條片,而是改完場景、換完鏡頭之後,前後內容仲要講得通。StateFlow屬於面向 previsualization 的 3D world-state modeling 框架,它把場景視為可持續保存的 3D world states,令同一個世界可以反覆建構、演化、再取用,而唔使每次修改都由頭生成。

呢個做法先處理內容一致性,再處理畫面輸出。StateFlow用 object-centric structured 3D state 去描述世界,每個物件都帶有 geometry、spatial pose 同 semantic attributes,將底層世界內容同最終 render observations 分開,於是場景結構、物件關係、動態事件同 cinematic camera direction 可以分步調整。

整個流程分成三段。State Construction 針對 2D 內容提升到 3D 世界時容易出現的歧義,用 prior-guided、conflict-aware dual-view initialization 建立較一致的起始世界;State Evolution 把使用者修改轉成 structured state transitions,保留 world memory,避免每次編修都重建整個場景;State Access 則配合 render-feedback reflection,把鏡頭意圖修正成視覺上可行的 cinematic trajectories。

  • 把一次性影片生成,改成可編修、可重用的 persistent world
  • 同一套世界狀態可支援 video production 同 3D game prototyping
  • 重點不只是生成畫面,而係保住場景結構、物件關係同時間上的連貫性
  • 鏡頭控制加入 render-feedback reflection,提升拍攝路徑的可行性

使用場景相當清楚:要先做分鏡、試鏡頭、試事件節奏的創作團隊,或者想由 3D scene 快速走到 playable prototype 的遊戲項目,都會較受用。現有內容著重方法展示、應用示例同與 baselines 的 3D scene generation 對比,但未見完整論文與量化細節公開,所以目前較適合視為一個值得留意的工作流方向,而唔係已完全定型的產品規格。

項目主頁

Categories: Video, 3D, 視頻模型, 北京大學, 框架, World-Action Model

round-trip-consistency:雙向 diffusion 幫長序列預測錯誤

遇上長步數 rollout,最難不是生成下一步,而是知道幾時開始唔可信。round-trip-consistency 用一次來回推演,直接估計模型當下誤差。

Bidirectional round-trip consistency overview

長序列 rollout 最棘手的位,在於錯誤會一路累積,但部署之後偏偏冇真值可以對照。round-trip-consistency 針對的正正是呢個缺口:它屬於一個研究型模型項目,用單一 conditional latent diffusion model 同時向前、向後推演 dynamical system,然後用來回一次嘅落點差距 round-trip consistency 當成自監督誤差訊號,判斷當前預測仲值唔值得信。

相比靠 ensemble、外部觀測、保留測試資料,甚至依賴 governing equations 去估可信度,呢個做法嘅取捨幾直接:代價係多做一次反向 rollout,換來唔需要額外真值。模型關係亦唔複雜,高維輸入先經 VAE 壓到 latent space,再由同一個 bidirectional latent diffusion model 配合 direction flag 做 forward 或 backward rollout,所以 backward 不只是檢查工具,亦順手變成 inverse solver。

現有資料已經講清楚它較適合點樣理解和測試:重點唔係即裝即用嘅應用介面,而係跟隨論文與程式碼重現 rollout、計算 C_i(Confidence Interval),再觀察它同真實 rollout error 嘅關係。對做科學模擬、時序生成、物理場預測,或者想為 autoregressive generative model 加一層 test-time trust signal 嘅研究團隊,呢類方法比單純看步數深度更有參考價值。

  • 用 forward 再 backward 嘅差距作為無需量測嘅 test-time error signal
  • 同一個 bidirectional diffusion model 包辦雙方向推演,訓練成本冇因雙向設計而上升
  • 在 MHD、turbulent Navier-Stokes 同 CelebV-HQ 呢類資料上驗證,覆蓋物理場與影像序列
  • 可用來做 error ranking、OOD flags 同 selective prediction,而唔止係生成結果本身

結果 C_i 在 held-out MHD trajectory 與 rollout error 有高相關,固定深度下 Spearman 可達 0.91 至 0.98;面對 out-of-distribution 的 Orszag-Tang vortex,AUROC 達 0.98,到 depth 10 去到 1.0。它亦能在 80% coverage 下將 incurred error 降低 15%,而在 LE-PDE-UQ 的 benchmark,一個 bidirectional model 已接近十模型 ensemble 嘅水位,訓練成本只係十分之一。不過呢個項目仍然偏研究原型,價值最大嘅場景係替長 rollout 模型補上「幾時應該停、幾時可以信」呢個判斷層,而唔係即時提供完整產品化流程。

項目主頁 · GitHub

Categories: 開源, , Dataset 數據集, World-Action Model