REA:讓機械人執行動作時不必等待 AI 思考

機械人控制常要在慢速推理與即時動作之間取捨,REA 透過路由與復原機制,讓執行中的控制政策不必停下來等候大腦回應。

Og image

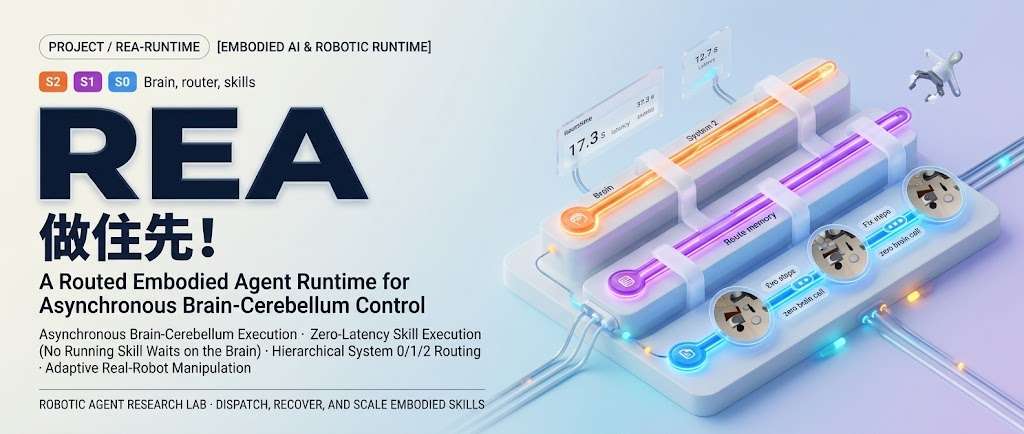
機械人執行動作時,若每一步都要等 AI 完成較慢的推理,控制就可能停頓。REA(Routed Embodied Agent Runtime)是為具身智能代理設計的執行框架,讓負責推理的「大腦」與快速控制的「小腦」非同步協作,並在需要時路由任務或復原執行流程。

這種安排適合需要連續動作、同時又要處理複雜指令的機械人工作流。REA 可協調 VLA(Vision-Language-Action)模型與程式控制政策,讓系統按任務選用不同控制方式;推理延遲不會直接令正在執行的控制政策停下來。

評測結果包括:在 3,000 個 LIBERO-Pro 測試回合中取得 95.9%,控制步數減少 25%;在 RoboTwin 2.0 中,結合 VLA 與程式政策取得 86%。頁面亦稱,REA 在 BEHAVIOR-1K 與真實 Unitree G1 測試中解決的回合數最多,但沒有提供這兩項測試的具體數字。

  • 推理與快速控制非同步進行,執行中的政策毋須等待大腦回應。
  • 透過路由與復原機制,協調不同類型的控制政策。
  • RoboTwin 2.0 評測結合 VLA 與程式政策,結果為 86%。
  • 項目頁需啟用 JavaScript 才能查看互動圖表;提供的內容沒有安裝或下載步驟。

REA 適合研究機械人長流程任務、異質控制政策協作,以及推理延遲如何影響動作連續性的團隊。現有內容提供多項基準測試結果,但未列出各項實驗設定與比較基線,閱讀數字時仍需留意這些資訊限制。
項目主頁 · 模型

Categories: Agentic, 模型, 視覺模型, 多模態模型, VLA, Robotic, 框架, Discord

從影片理解世界:統一 Video World Models 的四種能力

一份涵蓋 669 篇參考文獻的調查,整理影片模型如何讀取、生成、共享及互動於不斷變化的世界。

Og image

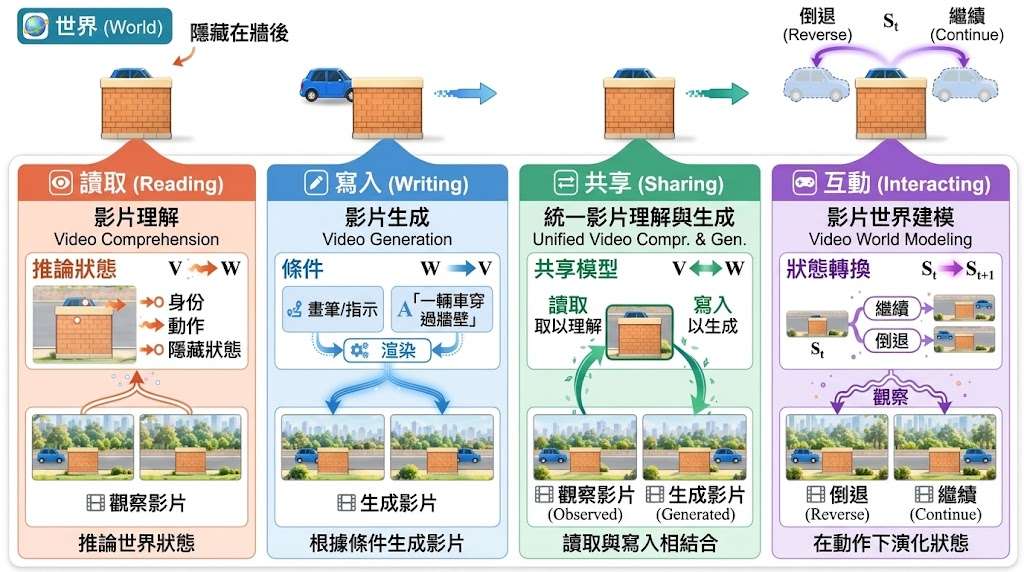
當模型要由片段影片理解場景、推演未來,甚至回應外部行動時,單純辨認畫面中的物件並不足夠。這份影片世界模型調查以影片與世界狀態的關係為主線,整理 Video Foundation Models 如何處理觀察不完整、時間變化和因果推理等問題。

調查將能力分成四個互相關聯的操作:Reading 從影片讀取語意、空間、時間、物理及因果資訊;Writing 生成可能發生的未來;Sharing 建立可供不同任務共用的表示;Interacting 則把感知結果連接到行動、控制和環境回應。內容涵蓋影片表示學習、Video-LLMs、影片生成、影片代理及世界預測等方向。

影片只是世界的部分記錄,而且可能遺失被遮擋的物件、視角以外的資訊或事件之間的因果關係。調查因此區分 temporal coherence 與 world consistency:畫面可以連續流暢,但物件再次出現時未必保持同一身份;鏡頭突然切換,也不一定代表世界狀態中斷。

• 以世界狀態統一影片理解與生成
• 覆蓋 2017 至 2026 年的研究發展時間線
• 比較 contrastive、masked、predictive 及 generative learning
• 關注長片段、串流觀察與影片代理的證據累積
• 收錄 669 篇參考文獻及多個尚待解決的研究問題

這份材料適合研究影片模型、World Models、多模態模型和 Computer-use agents 的讀者,也可作為設計影片理解、未來預測、模擬環境或機械人互動工作流時的索引。它屬於調查項目,並非可直接下載或安裝的單一模型;原始資料亦沒有提供具體使用流程。

項目主頁

Categories: Agentic, AI productions, 模型, 多模態模型, 世界模型, Video, Discord, 動畫

ArtCraft 以 Rust 重做七款 Adobe 創作工具

ArtCraft 把影像、影片、PDF、排版等工作整合到七款原生工具,檔案留在本機,亦方便接入自動化流程。

Og image

由影像編輯、向量繪圖到影片、PDF、動態圖像和頁面排版,ArtCraft 正以 Pure Rust 打造七款原生、開源及免費的創作應用,處理創作者需要在不同工具之間切換,以及雲端往返檔案的工作流程問題。項目涵蓋 PhotoCraft、VectorCraft、FilmCraft、LightCraft、PdfCraft、EffectCraft 和 DesignCraft。

這套工具的差異不只在於功能範圍,而在於每款應用都直接編譯成 macOS、Windows 和 Linux 桌面程式,不依賴 Electron 或 web views。檔案在本機處理,介面、工具和快捷鍵則沿用專業創作軟件較熟悉的操作方式;PhotoCraft、VectorCraft、LightCraft、PdfCraft、EffectCraft 和 DesignCraft 亦可透過 WebAssembly 在瀏覽器執行。

目前 PhotoCraft 和 PdfCraft 屬於 Early alpha,其餘多數工具仍在 In development,不能視為已完成的商業級套裝。不同應用的安裝程式已涵蓋多個平台。

項目亦預留了自動化和 AI agents 的接入方式,可透過 CLI、JSON control channel 或 MCP server 操作應用,適合需要批量處理素材、建立創作流程,或希望自行檢視和修改程式碼的使用者。

  • 七款工具涵蓋影像、向量、影片、攝影、PDF、VFX 和排版
  • 以 Rust 從頭開發,採用原生桌面程式架構
  • 開源程式碼放在 GitHub,並使用 permissive licenses
  • 檔案留在本機,部分應用同時支援瀏覽器和 WebAssembly
  • 多數工具仍在早期開發階段,成熟度各有不同

項目主頁

Categories: 開源, Agentic, AI productions, MCP, 視頻模型, Video, Image, 影像模型, 教學, 軟件, 工具, Content Creator, Discord, Mac, Linux, 庫

Meta 開源 Muse Gadgets SDK:把 ESP32 與樹莓派變成 AI 配件

Meta 把 Muse 的硬體擴充 SDK 放到 GitHub,讓你手邊的 ESP32 與 Linux 開發板直接接駁 AI 助理。從屏幕、音訊到感測器,開源玩法交給社群自己拼。

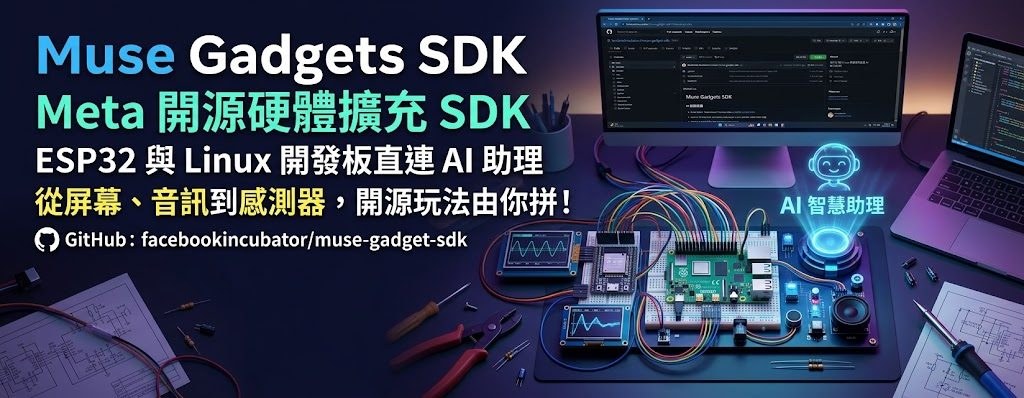
Muse gadgets: a Waveshare round AMOLED, an M5Stack StickS3, Muse Home Link, a Raspberry Pi and a Seeed reTerminal e-ink

想讓家裏的 ESP32 或樹莓派直接跟 AI 助理對話嗎?Meta 旗下 facebookincubator 開源的 Muse Gadgets SDK,正是針對這種「自製 AI 配件」場景而設的開發工具包。項目分為 ESP32 與 Linux 兩條主線,分別對應 MicroPython 級別的微控制器,以及樹莓派或一般 Linux 單板電腦,開發者可以按自己手邊的硬件選擇對應 SDK。

每塊板配對 Muse 應用前需要先在 gadgets.muse.ai 申請 SDK token,並開啟 App 內的 Developer mode,掃描「MuseGadget」前綴的裝置即可連線。ESP32 路線主打屏幕顯示、I/O 音訊與各類感測器,Linux 路線則偏向讓 Muse 處理 Home Assistant 自動化或系統管理指令,等於把語音助理變成 Home Lab 的遙控器。

項目定位屬於「工具+框架」混合體,核心價值是降低自製硬件的門檻,但要求開發者有一定焊接與刷機經驗,因為 README 已經明言副作用包括「bricked boards」、保養失效甚至電壓跌落。相對於坊間封閉式智能家居配件,它勝在完全開源並允許自定義指令,但又需要自備 token 與相容硬件,部署成本不低。

硬件玩家、Home Assistant 玩家,以及想用 AI 助理串連感測器或自製機械按鈕的開發者,最容易從中受惠。每個子目錄都附上 README.md 與供 AI 編程助手如 Muse Code 使用的 AGENTS.md,社群則集中在 Discord 交流改機心得。

項目重點摘要

  • 支援 ESP32 與 Linux(樹莓派)兩條開發路線,各自獨立 SDK
  • 配對 Muse App 需先申請 SDK token 並開啟 Developer mode
  • 涵蓋顯示、音訊、感測器、Home Assistant 自動化等多種擴充方向
  • 程式以 Apache 2.0 開源,第三方組件如 minimp3 保留上游 CC0-1.0 許可
  • 社群交流集中在 Discord,文件內附 AGENTS.md 方便 AI 編程助手介入

項目主頁 · GitHub

Categories: 開源, Agentic, API, Audio, 框架, Discord, Linux, 編程, 語音, Meta

MiniMax H3 4-bit 量化保留原生影音生成

MiniMax H3 壓縮至 4-bit 後,仍保留影片與音訊生成能力。

Og image

要在較有限的硬件資源下製作影片,又不想放棄同步音訊,MiniMax H3-QuantFunc-4bit 提供了一個量化選擇。頁面將它定位為 MiniMax H3 的 4-bit 量化版本,而非獨立微調模型;原始基礎模型可確認為 MiniMax H3,但未交代更完整的 base model 訓練資料或微調流程。

模型把核心權重精度由 16-bit 降至 4-bit,官方稱壓縮幅度約為 4 倍,並宣稱角色細節、風格一致性及快速動作仍可維持。它支援 text-to-video、image-to-video,以及原生 video+audio generation;附真人演出、動畫追逐、高速汽車及風格化角色展示生成結果。

FL2VA 在相同提示詞及 seed 下,QuantFunc INT4 對 BF16 基準取得約 23.7 dB PSNR。這個數字可用作重建品質參考,但屬項目方的內部測試,未有列出測試硬件、影片設定、速度或顯存用量,因此不能單憑該指標推算日常生成體驗。

  • 標籤包含 svdquant、int4、quantized 及 comfyui,但沒有交代量化演算法細節。
  • 頁面未提供 GGUF 檔案名稱、檔案大小、mmproj、上下文長度或推薦量化級別。
  • 未列明 llama.cpp、Ollama 或 LM Studio 支援,也沒有硬件需求及 MTP draft speculation 資訊。
  • 項目連結 ComfyUI-QuantFunc,較適合配合相關工作流探索;授權為 MiniMax H3 Community License,使用前應查閱條款。

模型

Categories: 開源, ComfyUI, AI productions, 模型, 視頻模型, 模型訓練, Video, Image, 影像模型, 影像處理, Audio, 提示詞, Discord, LLaMa, Ollama, 動畫, MiniMax

Meridian 讓 MiniMax H3 將時間與鏡頭重新編排 – Bullet time

Meridian 可從影片或單張圖片重新設計鏡頭路徑,重訪同一事件的不同視角。

Og image

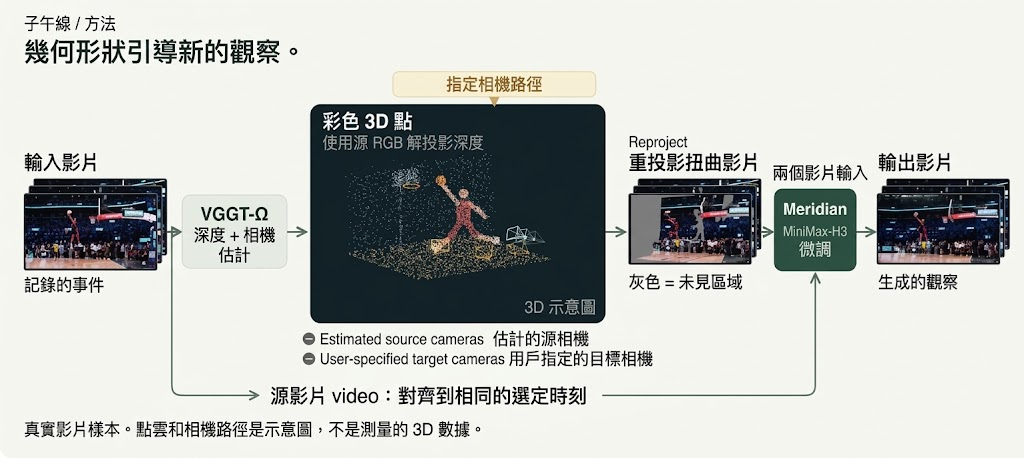
想將一段已拍攝的動作改成全新鏡頭,甚至暫停某個瞬間再繞行拍攝,Meridian提供了影片到影片(video-to-video)的處理方式。它基於 MiniMaxAI/MiniMax-H3,以 adapter 形式加入幾何控制能力,並結合 VGGT-Omega 幾何資訊,亦支援由單張圖片建立鏡頭移動。

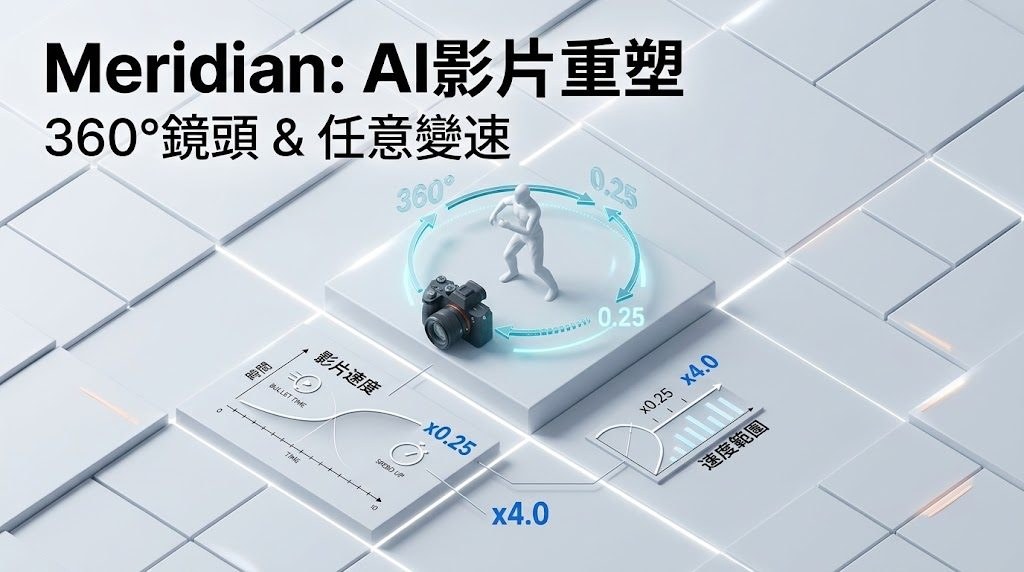
Meridian 處理的是空間與時間的共同編排:鏡頭可沿指定路徑移動,原有動作則可繼續、放慢或暫停。Bullet time 只是其中一種時間與鏡頭組合,並非模型的邊界;要加快或放慢動作,應先重新調整輸入影片的時間,再按該時間軸設計 camera path。

頁面提供的例子包括以原片重新觀看 NBA 灌籃、在草莓片段中暫停動作並移動鏡頭,以及以芭蕾單張相片產生鏡頭運動。這種做法適合重構已有事件的觀察角度,但生成畫面與原片如何銜接、遮擋區域能否保持一致,仍取決於輸入內容與指定路徑。

  • 基礎模型:MiniMaxAI/MiniMax-H3;模型關係標示為 adapter
  • 幾何元件:VGGT-Omega
  • 任務標籤:video-to-video、novel-view-synthesis、camera-control、re-camera
  • 提供 installation.md 連結

項目主頁 · 模型

Categories: 開源, AI productions, 模型, 視頻模型, Google, NVIDIA, Video, Image, 框架, 教學, Discord, LLaMa, Ollama, Python, 蘋果, MiniMax

小米公開 CodeMidas 強化學習訓練進度

小米以即時指標公開 mimo-v2.6-pro 與 mimo-v2.6-flash 的強化學習訓練狀態,並連結至程式編碼代理研究。

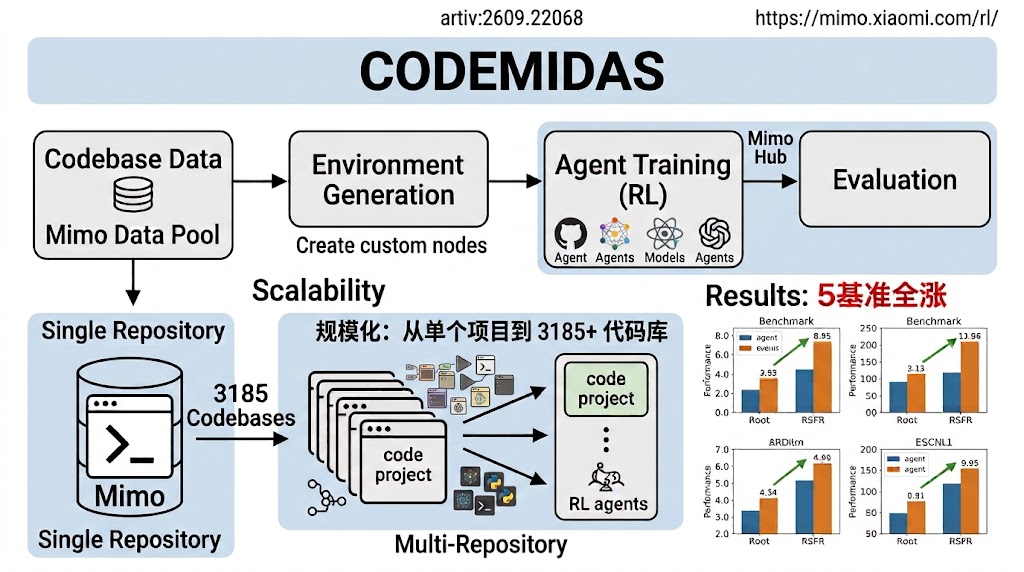
CodeMidas 把模型訓練過程帶到公開視野,展示 mimo-v2.6-pro 與 mimo-v2.6-flash 兩組 reinforcement-learning runs 的即時指標。對需要追蹤模型能力如何形成的研究者和開發者而言,這類介面可用來觀察訓練是否持續、何時中斷,以及不同模型版本的進度差異。

小米以 trainer 直接提供的 metrics 為主,未有完整列出指標定義、數值解讀或最終評測結果。因此,讀者可以把它視為訓練監察入口,而不是已完成模型的性能報告;畫面亦提示可能出現重新連線狀態,資料連續性仍需留意。

根據 CodeMidas 研究,mimo 從程式碼本身擴展 agentic coding reinforcement learning environments。這個方向處理的問題,是如何建立足夠多、又能反映真實編程任務的訓練環境,讓 coding agents 在程式修改、執行與驗證等流程中學習,而不只依賴靜態範例。

資訊:
– 同時追蹤 mimo-v2.6-pro 與 mimo-v2.6-flash 的強化學習訓練
– 指標由 trainer 即時更新,適合觀察訓練進程
– CodeMidas 聚焦由程式碼擴展 agentic coding RL environments

對模型研究、AI agent 和編程工具開發者來說,頁面提供了一個觀察訓練公開化的窗口;一般使用者則應等待正式模型說明和獨立評測,才適合判斷其編碼能力及穩定性。

項目主頁 · 模型

Categories: 開源, 香港大學, 北京大學, Agentic, 模型訓練, 工具, Discord, 編程, 小米-Xiaomi

VibeVoice-ASR-Streaming-7B 即時辨識與轉錄合而為一

Microsoft Research團隊將講者辨識加入串流語音轉錄,讓語音助手更快知道誰在說甚麼。

Hugging Face

Microsoft Research 聯同中國科學院大學及上海交通大學研究人員,開發VibeVoice-ASR-Streaming。

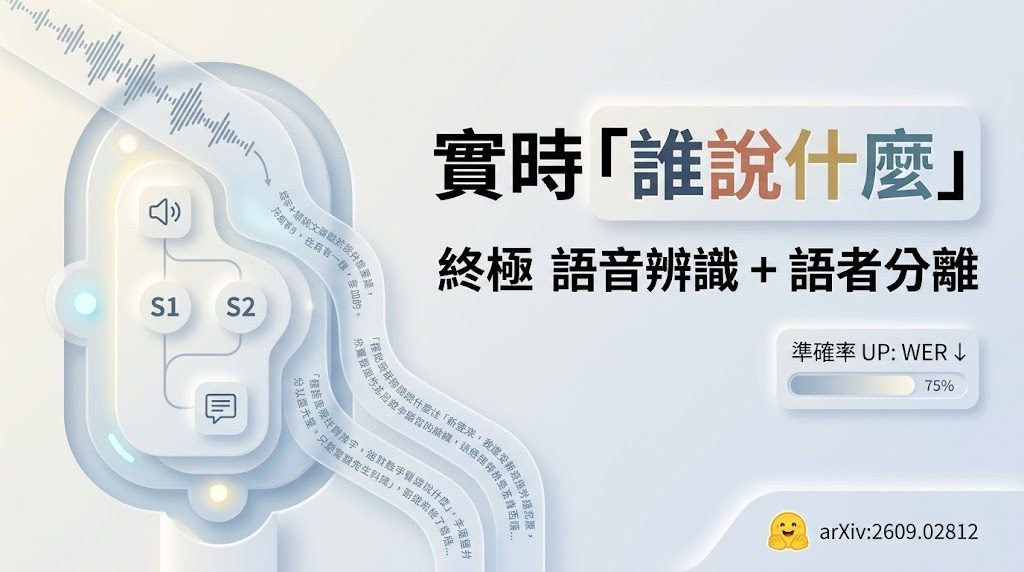
模型以 Large Language Model(LLM)為核心的端到端串流Speaker-Attributed Automatic Speech Recognition(ASR)系統,連續處理到達中的語音,同時輸出文字及講者身份。傳統流程通常把ASR與speaker diarization分開處理;此模型將兩項工作放進單一模型,針對即時語音助手及語音代理需要低延遲回應的場景,減少等待完整錄音後才分析的限制。

VibeVoice-ASR-Streaming 會交錯處理固定大小的audio chunks,並加入少量lookahead,讓模型在保留未來聲音片段作判斷的同時,逐步產生轉錄結果。固定分塊有助控制處理延遲,但lookahead 與分塊大小之間仍要取捨:前者越多,講者切換及語句判斷可能更穩定,回應時間亦可能增加。

  • 以單一LLM-based端到端模型同步處理ASR與speaker attribution
  • 使用固定大小audio chunks及少量lookahead支援串流輸出
  • 針對即時語音助手及agents的低延遲需求設計
  • 量化檔案、推論框架、硬體需求及效能指標尚未在提供內容中交代

項目主頁 · Paper · 模型

Categories: Agentic, 微軟, Audio, Discord, LLaMa, Ollama, 語音, Dataset 數據集

PalmClaw 把手機變成可落地 AI 助理

PalmClaw唔係把桌面代理硬搬上手機,而係直接把 Android 當成代理運行環境。想要私隱、速度同部署簡化兼顧,呢個方向幾有意思。

PalmClaw Line Logo (light mode)

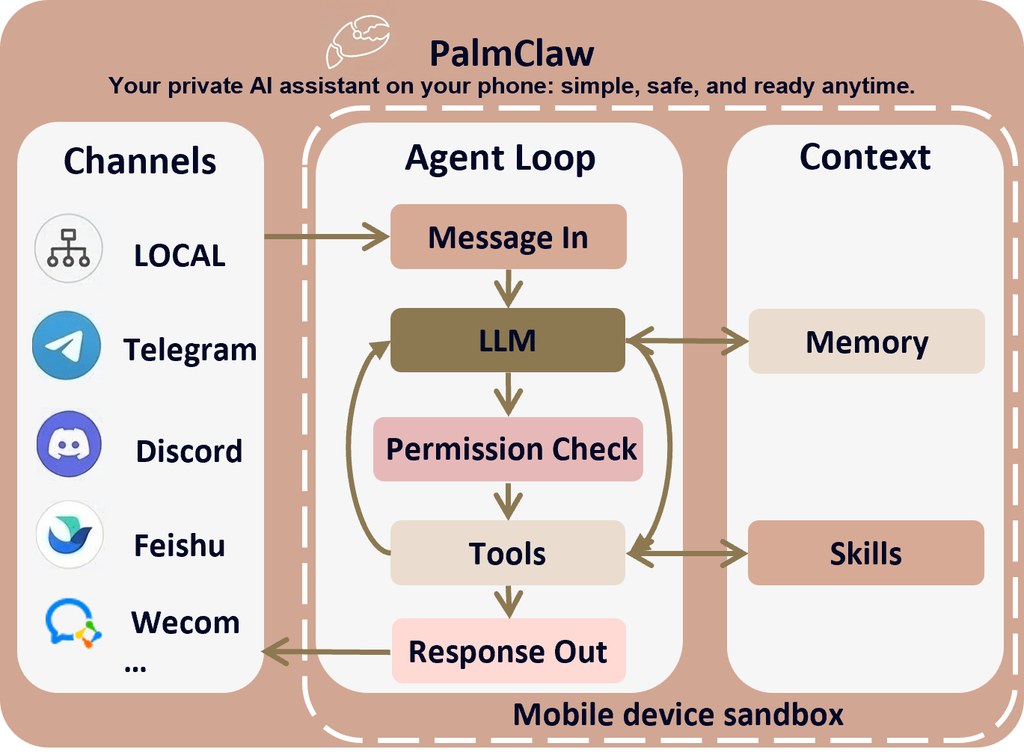
想在手機上跑 AI 助理,最大問題通常唔係模型夠唔夠聰明,而係行動流程太依賴點擊介面、太多步,又難清楚限制每次操作。PalmClaw 選擇唔跟 GUI 自動化嗰條路走,而係做成一個原生 Android 代理框架,直接在裝置內管理 session、memory、skills、tools 同 agent loop,處理的是「手機可唔可以自己成為代理執行環境」呢個問題。

同類做法很多會把手機當成一個要被點擊、滑動、輸入的目標畫面,PalmClaw則把裝置能力包裝成有明確參數同結構化結果的 device tools。呢個取向的好處很直接:動作邊界更清楚,執行鏈更短,亦較少受介面改版影響;代價是它偏向整合系統能力與通道,而唔係模擬人手操作所有 App 畫面。

安裝理解上亦算直接,項目已提供 APK,重點不是先搭 server,而是把代理本身部署到 Android。應用程式內可管理設定、工具同 channels,並連接 Telegram、Discord、Slack、Feishu、Email、WeCom 等通道;資料與硬件存取留在本機,較適合在意私隱、想減少雲端依賴的個人用戶,或者要做流動工作流驗證的小團隊。

  • 原生 Android 代理框架,重點在裝置內執行而非遙控手機介面
  • 沿用 OpenClaw 啟發,但定位更貼近直接 mobile deployment
  • 提供 APK,可在手機內完成設定、工具管理與通道連接
  • 論文數據提到,相比最強基線有 11.5% 相對任務成功率提升,完成時間減少 94.9%
  • 相關脈絡包括 OpenClaw,以及以 Large Language Model(LLM)agent 為核心的 session、memory、skills、tools 架構

PalmClaw最值得留意的地方,在於它把手機代理由「會操作畫面」改成「直接調用裝置能力」。對想把 AI 助理放進日常通訊與個人裝置流程的人來說,這種 local-first、明確工具邊界的設計,比純粹追求花巧自動化更接近可長期使用的方向;現階段平台重心明確落在 Android,跨平台與生態覆蓋仍要看後續發展。

項目主頁 · GitHub · Paper

Categories: 開源, 香港理工大學, Agentic, Gemini, 香港, Discord, OpenClaw, Anthropic, Skill 技能