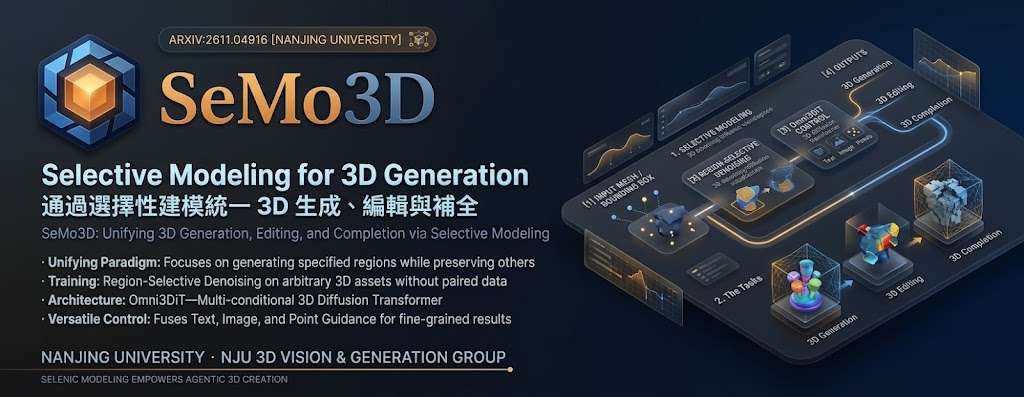
SeMo3D:只重建指定區域,統一 3D 生成、編輯

修改 3D 模型時,保留不需要改動的部分,可以減少整件資產重新生成造成的不一致。SeMo3D 將生成、編輯和補全整合到同一套選擇性建模流程,並支援文字、圖像與點雲引導。

SeMo3D logo

修改模型的局部區域時,整件資產重新生成可能令原本不需更動的內容也走樣。SeMo3D 是一個 3D 生成與編輯模型項目,透過只合成指定區域、保留其餘部分,統一處理生成、編輯和缺失區域補全,適合需要維持模型其他部分一致的創作者及 3D 工作流程團隊。

它把三種任務視為同一個問題:選出要建立或修改的區域,並沿用其餘內容。生成時選取完整區域,編輯時選取目標區域,補全時則選取缺失區域;因此,模型不必為每項任務各自重新生成整件資產。訓練亦毋須成對的編輯或補全資料,研究團隊可從一般 3D 資源切分出選取區域與周邊內容來訓練。

訓練方法稱為 region-selective denoising,只在隨機選取、大小各異的區域加上雜訊並計算損失,讓同一模型共同學習三項任務。架構 Omni3DiT 是多條件 3D diffusion transformer,負責分辨需要建立與保留的區域,並融合圖像、文字和點雲引導,提供較細緻的控制。

SeMo3D 在三個基準測試中,於生成、編輯和補全各項任務均勝過當時的先進方法;生成支援多模態控制,編輯與補全則著重一致性及準確度。

  • 一套模型統一 3D 生成、編輯與補全。
  • 只合成指定區域,保留其餘內容。
  • 以 region-selective denoising 從一般 3D 資源訓練,毋須成對編輯或補全資料。
  • Omni3DiT 融合圖像、文字與點雲引導。
  • 支援以自然語言互動的 agentic 3D 建模。

項目主頁 · GitHub

Categories: 開源, 南京大學, Agentic, 模型, 多模態模型, 模型訓練, Image, Content Creator, 3D

CoworkOS:2D/3D 網頁任務統一工作流

複雜項目往往要跨多日推進,也需要人手覆核和中途調整。CoworkOS 讓 AI 代理接手分工與持續監察,並保留進度、記錄及待審核成果。

CoworkOS: geometric wordmark, fixed OS frame and illustrated desktop workspace

從研究、文件到 CAD 和 Blender,CoworkOS 讓人與 AI 代理在同一工作空間協作,處理需要多步推進、跨日跟進的工作。它屬於開源 AI 協作執行框架,目標是把任務由規劃、分工一路帶到可檢查的成果;長時間運行的 Jobs 會保留狀態和日誌,遇到等待或中斷後仍可接續處理。

代理工作分成三層:Main Agent 制定計劃、分派任務及檢查成果;Coordinator Runtime 負責派送子任務並追蹤進度;可選用的 Subagents 則執行範圍明確的工作。模型負責決定任務策略,執行環境則維持協調、回饋和工作連續性,避免把多代理協作的管理全交由模型自行處理。

CoworkOS 把 CLI、搜尋、檔案和 MCP 接到文件編輯器、簡報、CAD 與 Blender 等工具,人和代理可以共同修改文件、模型及場景。階層式工作空間和語意記憶用來延續項目脈絡;候選修改會保留版本資訊,讓人先檢查再整合。這種做法適合需要覆核、追蹤及中途改方向的團隊,但可用工具和模型服務的實際配合仍會影響工作流程。

研究團隊也可用同一套機制建立長期監察迴圈,例如分析模型失誤、改善訓練資料、執行訓練及驗證結果。配套研究報告記錄了 Qwen3.6-35B-A3B 經五輪後訓練後,在八個基準的平均分由 33.19 升至 42.95;這是特定實驗結果,各任務仍有升跌,不能直接視為其他模型或工作流程的保證。

  • Jobs 保留長時間任務的狀態與日誌,方便中斷後繼續監察。
  • Main Agent、Coordinator Runtime 和 Subagents 分別負責規劃、協調與執行。
  • 人與代理可共同處理文件、簡報、CAD 模型及 Blender 場景。
  • 候選修改可先經人手檢查,再整合到項目成果。

CoworkOS 面向使用 macOS 的研究人員及需要多工具協作的團隊,支援 Apple Silicon,並要求 macOS 14 或以上及 Node.js 22.19.0 或以上。儲存庫資料提及可透過 npm 安裝,亦提供文件、展示及即時示範連結,開始部署前,仍需查閱項目文件確認模型服務與工作空間的配置方式。

項目主頁 · GitHub

Categories: 開源, 北京大學, Agentic, MCP, 模型, 模型訓練, Qwen, 框架, 工具, Mac, 庫, 中國, 蘋果, Dataset 數據集

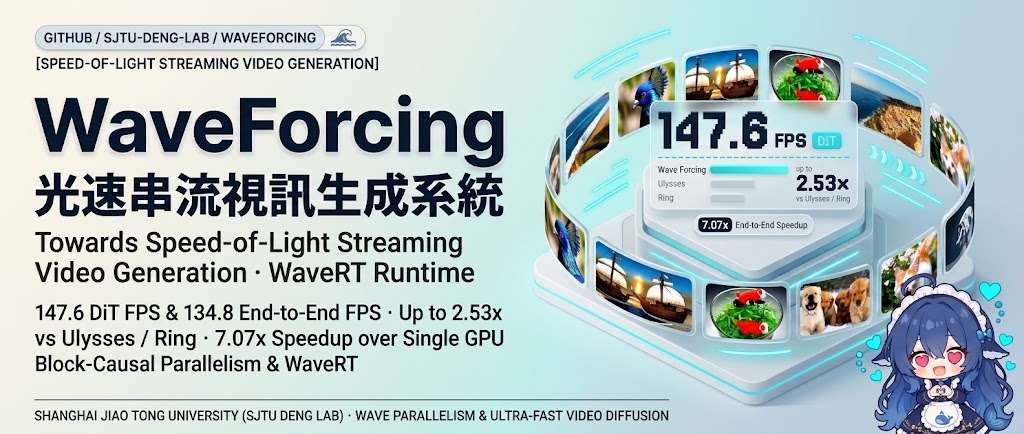
WaveForcing:讓多步影片生成每秒 134.8 幀

WaveForcing 讓多段影片同步去噪,持續輸出畫面;高速度背後,仍要付出多張高階 GPU 的成本。

Wave Forcing logo

WaveForcing 讓影片不同片段同步去噪,毋須逐段完成才繼續。這套串流影片擴散方法在流水線填滿後,每輪前向運算便輸出一個片段,適合研究連續影片生成的團隊。

Wave Parallelism 讓各張圖形處理器(Graphics Processing Unit,GPU)持有完整模型,分工處理不同片段與去噪階段,而非拆開模型。較嘈雜的新片段可參考較乾淨的舊片段,Wave Runtime(WaveRT)則把資料傳送與運算重疊,減少等待。

  • WaveForcing-1.3B 提供 4-step、5-step 權重。
  • 推理程式與 WaveRT 已開源。
  • 快速開始範例採用八張 GPU,並非單卡配置。

測試環境已驗證 Python 3.12、PyTorch 2.11.0+cu128、SGLang diffusion runtime 及 Hopper GPU。準備測試須下載基礎模型與 WaveForcing 權重。

4-step 版本在八張 H200、832×480 解像度下,連同解碼達每秒 134.8 幀。這個結果展示多卡串流吞吐量,不能當作單卡速度或首幀延遲;硬件成本仍是採用門檻。

項目主頁 · GitHub · 模型

Categories: 開源, 北京大學, AI productions, 模型, 視頻模型, Video, Python, 中國

CodeSpecWeave:寫碼容易,了解需求才是關鍵

CodeSpecWeave 將互相影響的軟件要求編織成可執行訓練任務,測試編程代理能否維持整體行為一致。

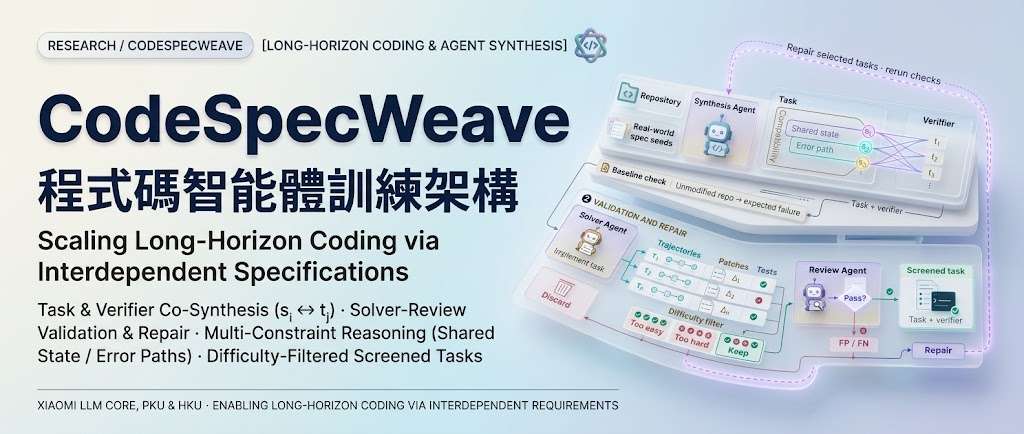
Paper pipeline: task and verifier synthesis, baseline check, solver trials, difficulty filtering, trajectory review, and repair followed by revalidation.

新增一項功能,可能同時改變狀態、介面、錯誤處理路徑和執行次序。CodeSpecWeave 是一個面向 Computer-use agents 的編程代理訓練與評測項目,處理的正是這類不能逐項解決的長流程編程工作,要求代理在同一份實作中兼顧互相牽動的限制。

項目建立更貼近真實軟體工程的任務,用來訓練與評估 AI 程式開發代理(coding agents)。它不是一般的寫程式工具或線上 IDE,而是一套「產生開發任務、建立驗證測試、訓練及評估 AI」的研究框架。

網站用交易分配功能作例子:AI 不只要依金額比例分配資源,還必須同時確保總量守恆、最低分配額、四捨五入順序穩定,以及保留舊版單一收款人的行為。某一項需求單獨看似做對,整個功能仍可能不符合規格。

CodeSpecWeave 因此刻意讓需求共享狀態、執行路徑及生命週期限制,測試 AI 能不能把整組約束一起處理,而不是只寫出局部正確的程式碼。

  • 將獨立要求連結成 shared decision space
  • 同時檢查功能語意、狀態一致性和介面兼容
  • 以 executable tests 評估跨要求的聯合推理
  • 涵蓋真實 repository 與保留作評測的工程任務

項目主頁

Categories: 北京大學, Agentic, 模型, 模型訓練, World-Action Model, 香港, 軟件, 編程, Dataset 數據集, 小米-Xiaomi

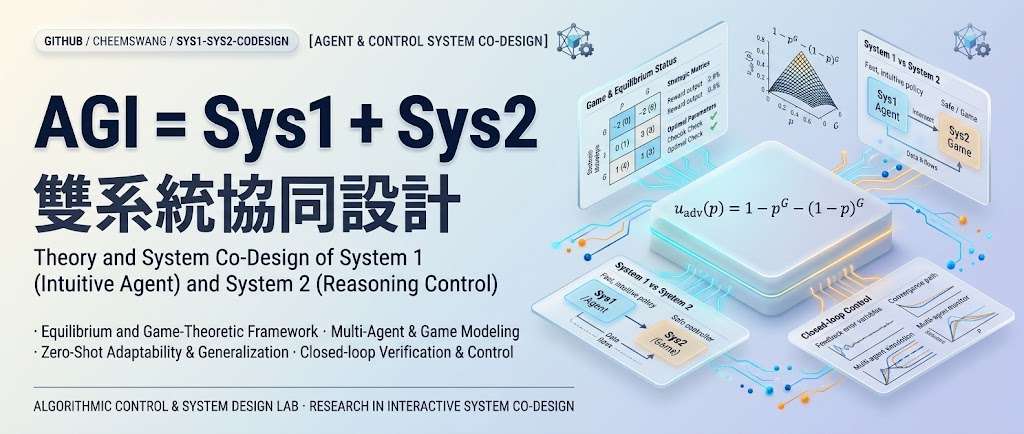
System 1+2:AGI 也要先估互動價值再花算力

多想幾步、多試幾次,都有成本。研究構想讓 AI 先估計哪些互動有價值,再投入資源執行。

Hero image preview

AI 代理搜尋資料、執行程式或讓機械人試走一步,都要付出成本,卻未必帶來有用結果。清華大學團隊提出 System-1/System-2 協同設計構想,希望在執行前先篩選值得投入的互動。

成本較低的 System-1 按預期價值排列互動的優先次序,再由成本較高的 System-2 執行較困難的工作。這個構想把資源分配提前,讓增加推理、訓練或探索次數之前,多一道價值判斷。

它涵蓋的場景包括:

  • 語言模型推理:判斷哪些推理步驟值得繼續投入。
  • AI 代理:篩選搜尋、程式執行及應用程式介面(Application Programming Interface,API)呼叫。
  • 機械人與強化學習(Reinforcement Learning,RL):優先探索可能提供學習訊號的經驗。

對互動成本高、數據取得慢的研究與開發工作,這個構想提供了分配預算的思路。不過,所提供節錄未交代價值預測器的具體實作或量化結果,仍未能判斷它能節省多少成本,以及會否錯過有用的探索。

項目主頁 · Paper

Categories: 清華大學, Agentic, 模型, 模型訓練, API, World-Action Model, Robotic, 框架, 軟件, 編程, AGI, 強化學習

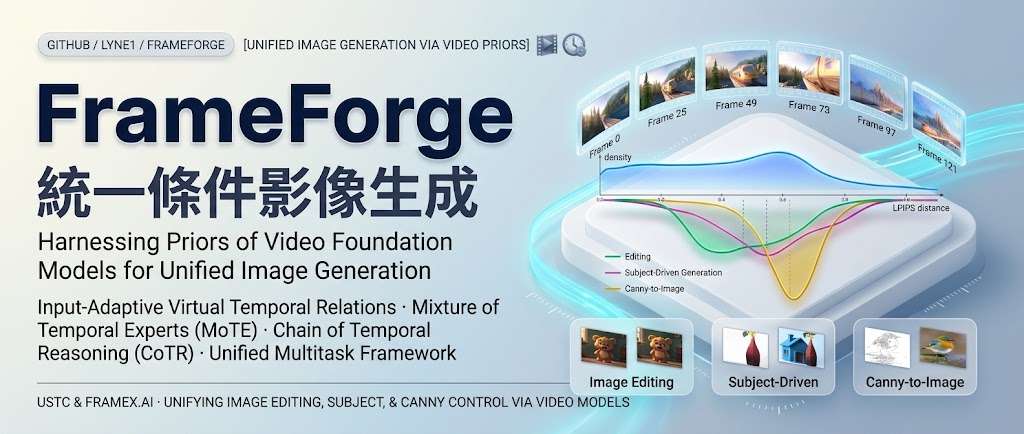
FrameForge「換場景、不換主角」統一三種影像生成

FrameForge 把 HunyuanVideo 1.5 的影片時間帶入影像生成,讓同一套模型處理主體生成、邊緣圖生圖和指令式編輯。

Repository image for Lyne1/FrameForge

同一張參考圖可以用來保留主體、遵循 Canny 邊緣結構,或按照文字指令改變內容,但三種任務對「要保留多少、要改變多少」的要求並不相同。

FrameForge 是一個「給它一張參考圖,再用文字指示生成或修改圖片」的 AI 研究專案。它的特色是借用影片模型理解畫面變化的能力,來處理靜態圖片。

它用同一個模型處理三種工作:

功能 你提供什麼 可以做什麼
參考主體生成 一張人物、動物或物件的參考圖,加上文字描述 保留主體的辨識特徵,重新生成不同場景,例如把同一隻狗放到海灘上
邊緣圖轉圖片 一張 Canny 邊緣圖,也就是描出物件輪廓的線條圖,加上文字描述 依照既有輪廓、姿勢與構圖生成完整圖片
文字指令修圖 原始圖片,加上修改指令 改變動作、加入物件或轉換風格,例如「把貓的動作改成睡覺」,同時盡量保留其餘內容

這三種功能分別適合「保留是誰/是什麼」、「保留畫面結構」以及「修改指定內容」的需求;不是每次都從文字重新生一張毫無關聯的圖。

技術上有兩個重點:
– MoTE:動態選擇不同的虛擬時間間隔,對應不同程度的畫面變化。
– CoTR:加入一個潛在中間狀態,作為原圖轉換到目標圖的中間路徑。

官方已提供推論程式及模型下載方式,環境需要 Linux、Python 3.10 和支援 CUDA 的 GPU;公開流程以 512 × 512 輸入及輸出圖片、50 次去噪步驟運行,部分模型下載也需要先申請存取權。

注意「同一個模型整合三類圖片工作流程」,可作為評估自建圖像生成/編輯服務的 PoC 起點。官網目前提供的是研究結果與部署入口,不能直接視為已具備完整產品能力。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, NVIDIA, Stable Diffusion, Video, Image, 影像模型, Linux, Python, 庫, 中國, LoRA

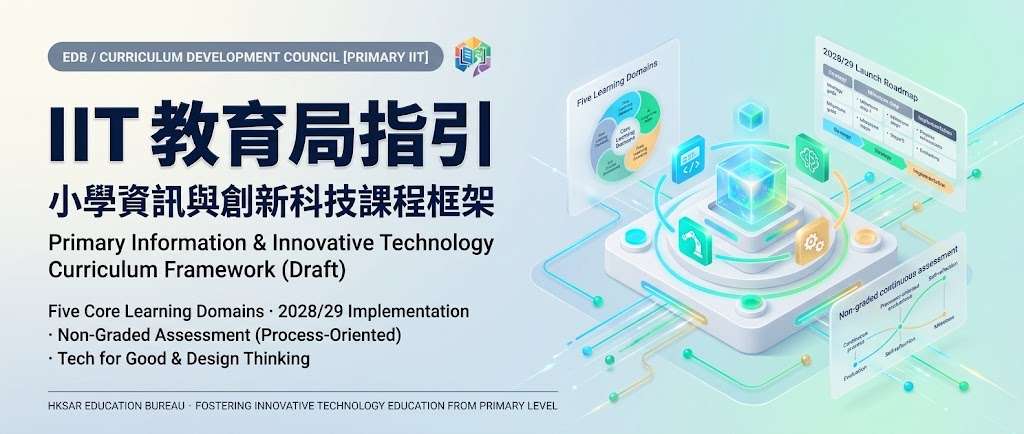
IIT:讓小學生用簡單指令與 AI 對話

香港小學將逐步引入 IIT,讓七歲學生以簡單提示或指令與 AI 交流。

Og image

七歲學生將有機會用簡單提示或指令,與人工智能(artificial intelligence,AI)作簡單「對話」;香港小學由 2028 年 9 月起逐步引入 Information and Innovation Technology(IIT)新科目,回應數碼素養、創意及創新科技學習需要。

課程《Information and Innovation Technology Curriculum Framework for Primary Schools (Provisional Draft)》,AI 是其中一項重點。學生先認識相關技術,再以簡單命令與 AI 互動,學習重點不只接觸工具,也包括培養好奇心及對創新科技的興趣。

對學校而言,IIT 提供一個讓學生較早接觸 AI 的課程位置;對學生而言,互動形式把抽象的 AI 概念拉近到提問、下指令和接收回應等熟悉行為。資料未有交代課堂會採用哪些 AI 系統、設備、評核方式或具體教學活動,亦未提供安裝、下載或使用流程。

  • 由 2028 年 9 月起在香港小學逐步推行
  • 學生年紀可低至七歲
  • 以簡單提示或指令與 AI 作基本互動
  • 目標包括提升數碼素養、創意及對創新科技的興趣

目前公布內容屬臨時課程框架草案,實際推行安排仍可能隨後續課程設計而調整。家長、教師和教育科技項目策劃者可先把它視為小學 AI 素養教育的方向訊號,但現有資料不足以判斷課程深度或學生可使用的系統範圍。

項目主頁

Categories: 框架, 教學, 香港, 工具, 新聞, 中國

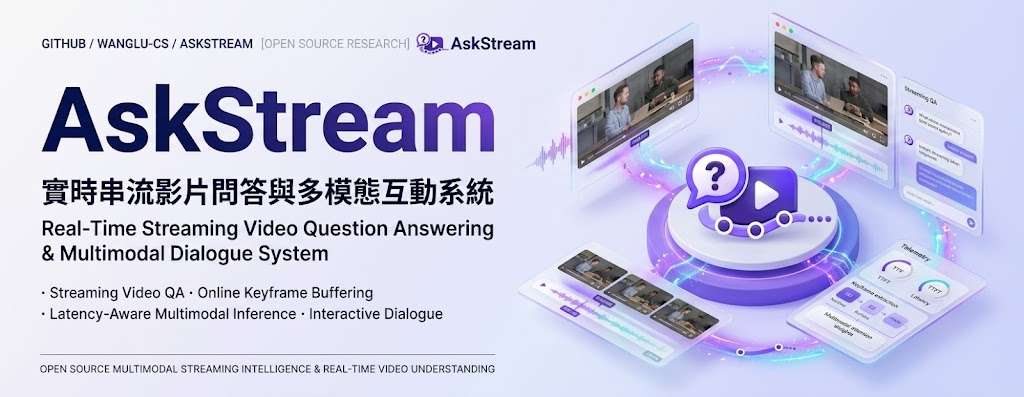
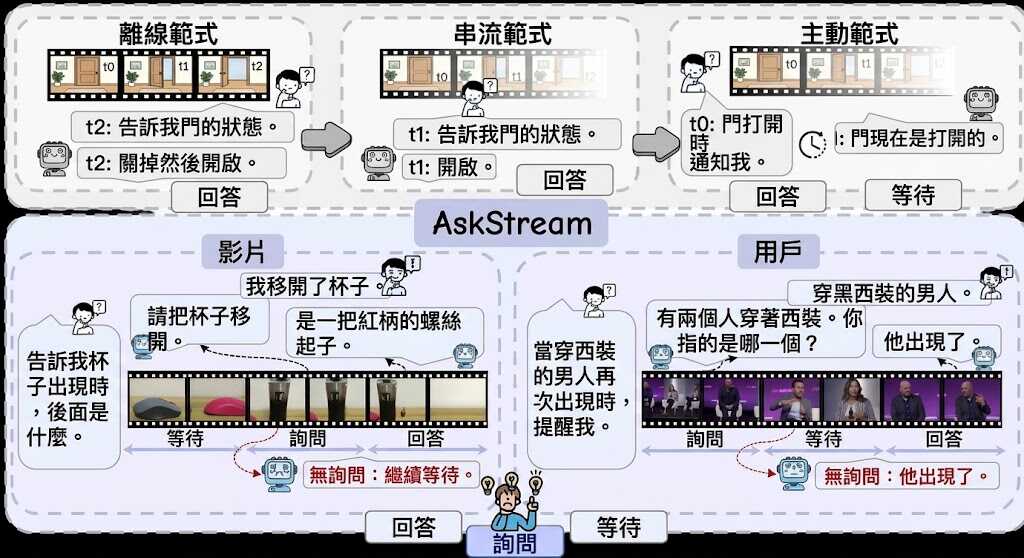
AskStream:讓模型主動追問影片的缺失資訊

串流影片未必會自然提供完整答案,AskStream 讓模型在等待與回答之外,判斷何時應該主動提問。

AskStream Logo

串流影片問答遇到畫面缺失、問題含糊或個人資料不足時,模型往往只能繼續等待,甚至猜出答案。AskStream 是一個串流影片理解 benchmark 與資料集,把 WAIT、ASK、ANSWER 放進多輪互動流程,實際測試模型能否找出不確定性、問對問題,再在資訊足夠時回答。

它涵蓋 Food & Dining、Sports、Clothing、Daily Life、Film & TV、Repair、Education、Travel 和 Technology 九類影片,共 438 段影片、1,401 條問題,以及 2,714 個人工標註的 frame-level time windows。每段影片平均有 3.2 個互動回合,資料再按 Video Uncertainty 和 User Uncertainty 拆成四類任務、八個 subtasks,適合檢查模型是只懂回答,還是懂得主動索取缺少的證據。

  • 同時評估 When to Ask、What to Ask、When to Answer 和 What to Answer
  • 支援 multiple-choice 及 open-ended 評測
  • Ask-F1 同時反映提問時機、提問內容和回答決策
  • 最強模型目前只有 52.18% Ask-F1,主動尋找資訊仍然困難

使用者可從 GitHub、Hugging Face dataset、論文及 project page 了解資料和評測入口;提供的資料沒有列出完整安裝流程、推理程式或硬件要求,因此不能據此承諾特定 GPU、記憶體配置或本地執行方式。研究團隊、影片理解模型開發者和多模態 agent 評測項目較適合採用它,尤其是需要處理直播、教學、維修或含個人背景問題的場景。它的價值不在單次答案準確度,而在揭示模型何時應該停止等待、向誰問甚麼,以及取得資訊後能否及時作答。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 多模態模型, Video, 教學, 中國, Dataset 數據集

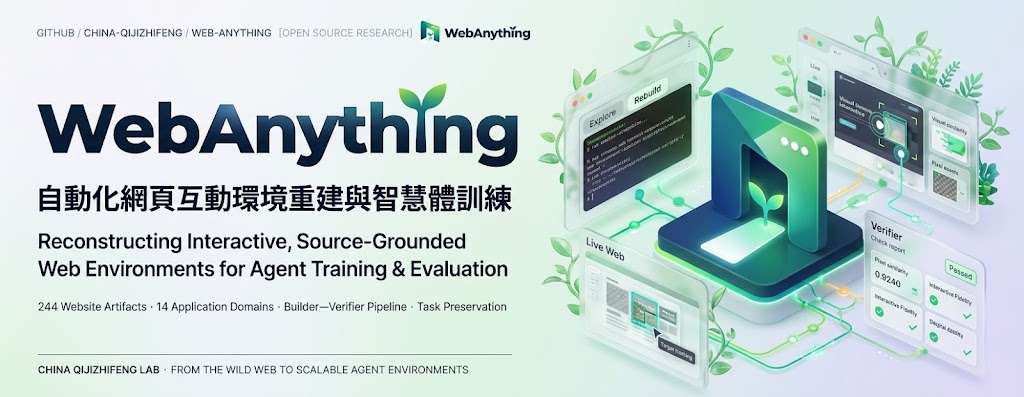
WebAnything 把真實網站重建成可重設的測試環境

從網站獲其內容重建互動網站,能在可重設的環境中完成任務。

WebAnything concept logo

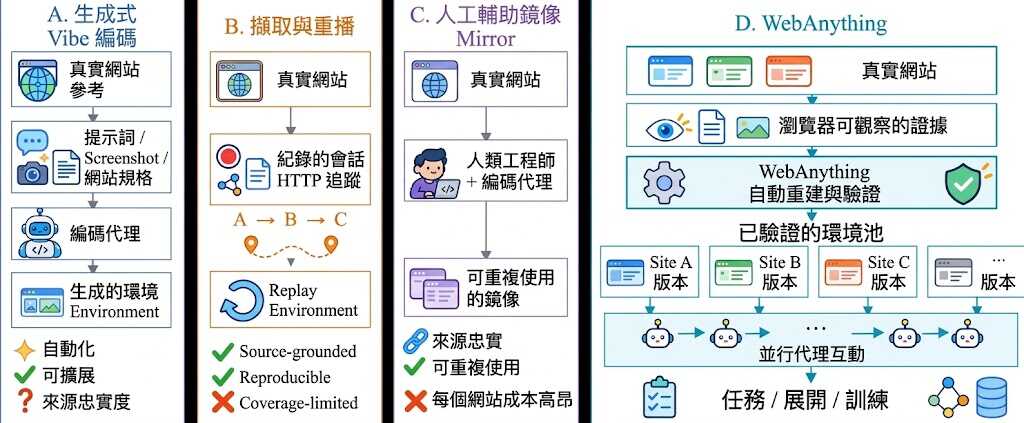
要訓練或評測 Web agent,截取網站畫面並不足夠,代理還要能操作控制項、切換頁面並完成多步任務。WebAnything 是一套研究程式碼,將網站證據轉成可執行、可重設的代理環境,目標是保留任務流程,而不只是重現畫面。

建構流程先由 Builder 透過瀏覽器探索網站,記錄頁面狀態、互動資料、DOM、畫面截圖及網絡資源,再重建環境。候選環境會先凍結,交由 Verifier 獨立檢查;發現實作錯誤或證據不足時,系統會針對問題修正。Full 模式適合追求較廣覆蓋,JIT 則按代理任務需要建構環境,兩者在完整度與建構成本之間作取捨。

項目分析了 6,172 個獲接納的來源任務執行紀錄,平均每個任務使用 10.4 個工具步驟,中位數為 8 步;34.7% 的任務超過 10 步,最長達 89 步。這些數字反映任務包含多步互動,但不能單獨代表重建保真度或代理能力;評估亦分別涵蓋歷史頁面狀態的保真度,以及模型在指定基準測試中的下游效用。

  • 適合研究 Web agent 訓練與評測、需要可重複網站任務環境的團隊。
  • Builder 和 Verifier 使用支援 Responses API 的模型服務;兩者需配置模型 ID、API URL 及 API key。
  • 本機需安裝 Chromium,瀏覽器操作由 Playwright 支援;代理亦需要終端機存取權。README 未列出最低 CPU、記憶體或 GPU 規格,不能據此判定具體硬件門檻。
  • 儲存庫提供建構流程及 244 個歷史網站項目的清單,但網站原始碼與第三方媒體存放在外部 artifact store,並未隨儲存庫附上。

Web agent 提供 Python 套件、命令列工具及設定流程,並可把本機 agent skill 安裝給 Codex 或 Claude Code;這個 skill 不是 MCP server。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 模型訓練, Qwen, API, 工具, Python, 庫, Anthropic, 中國, Dataset 數據集, Skill 技能

VibeGame:把文字變成可試玩的遊戲

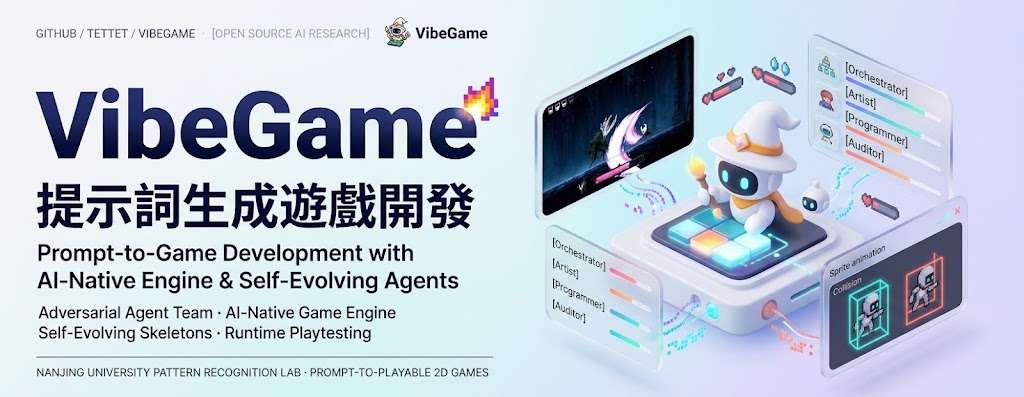
輸入遊戲構想後,VibeGame 會協調代理製作、審查及試玩,亦可按後續要求修改;目前聚焦 2D 網頁遊戲。

VibeGame system teaser

把文字構想變成可玩的 2D 網頁遊戲,再逐步修改玩法,是 VibeGame 這套多代理開發系統的工作。它適合遊戲原型製作,並非獨立模型;已開源的實作以 Phaser 為基礎。

Adversarial Agent Team 由統籌代理協調分工,將生成與審查分開,透過靜態審查及端到端執行驗證檢查成果。AI-native game engine 把項目表示為結構化文字,讓代理直接編輯,並以 frame-synchronous control 按自己的節奏逐幀試玩。

  • 支援 Claude Code 或 Codex,至少需要一款代理命令列介面(Command-Line Interface,CLI)。
  • Python 需要 3.12 或以上;未提供完整安裝流程。
  • 未列出處理器、記憶體、顯示卡或顯示記憶體需求,不能據此判定硬件門檻。

training-free self-evolution 會從成功項目提煉可重用骨架、模組及協作約定,累積開發知識而毋須重新訓練模型。示範涵蓋格鬥與地牢遊戲,但未提供量化成功率或效能比較;端到端 3D 製作仍屬待完成項目。

項目主頁 · GitHub

Categories: 開源, 南京大學, Agentic, 模型, 多模態模型, 模型訓練, 3D, Python, Anthropic

Page 1 of 20
1 2 3 … 20