Dr. Claw 把 AI 研究流程收進一個可審核工作台

一款開源 AI 研究助理,把文獻回顧、實驗、寫作整合在同一介面,讓人類決策與 AI 執行之間留下可追蹤的紀錄。

Dr. Claw

跑過 AI 研究的團隊都遇過同樣的痛:Claude Code、Gemini CLI 等命令行編碼代理(coding agents)能讀寫檔案、撐住長對話,但文獻回顧、構思、實驗、寫論文、投期刊這些步驟散落在聊天工具、IDE、終端機、寫作軟件之間,中間決策也難以回頭追溯。Dr. Claw(GitHub: OpenLAIR/dr-claw)針對的正正是這個碎片化問題——它不是另起爐灶造一個新代理,而是把現有命令行編碼代理(Claude Code、Gemini CLI、Codex,以及透過 OpenRouter 接入的數百個模型)包進一個可控、可審核、人在回路(human-in-the-loop)的工作流。

項目覆蓋 survey → ideation → experiments → paper writing → slides & promotion 整條研究生命週期,與只懂執行程式碼的 CLI 代理相比,差異在於「全流程編排層」。底層靠三個關鍵設計撐起這層:持久化狀態物件(persistent state objects)、可重用技能庫(reusable skill library),以及多執行器協調(multi-executor coordination),把計劃、執行、寫作綁成一條可恢復的循環。論文亦明確指出,比起只共享同一後端執行器的裸 CLI 代理,Dr. Claw 在研究完整性上得分更高,同時保留可審計、可回溯的過程痕跡。

對獨立研究者、AI 實驗室團隊、需要把研究流程制度化的單位而言,這套架構的價值在於把人類決策(目標、約束、驗收)與 AI 執行清楚分開,並透過 checkpoint 反饋(Verify / Revise / Retry / Handoff)保留介入點。它支援本地部署(自家機器、自家 GPU、自家資料),亦提供桌面版(.dmg / .exe)或 npx dr-claw 零安裝啟動,甚至能在終端機直接 dr-claw chat 跑 agentic 對話。

項目已被 EMNLP 2026 System Demonstrations track 收錄(arXiv: 2609.00365),並採用 AGPL-3.0 搭配上游 GPL-3.0 元件授權,免費、無訂閱。需要留意的是,它自定位為 Anthropic Claude Science 的開源、模型中立替代方案,主打全生命週期而非單純計算分析。
GitHub · Paper

Categories: 開源, Agentic, 模型, OpenAI, Gemini, 軟件, 工具, IDE, , 編程, Anthropic, Skill 技能

AREX-Skill 把 GitHub 知識變成可執行技能

AREX-Skill 將熱門 GitHub 儲存庫整理成可驗證、可執行的技能,讓 Coding Agent 在複雜機器學習研究任務中少走彎路。

AREX-Skill turns repository and paper knowledge into executable skills for coding agents and autonomous ML research

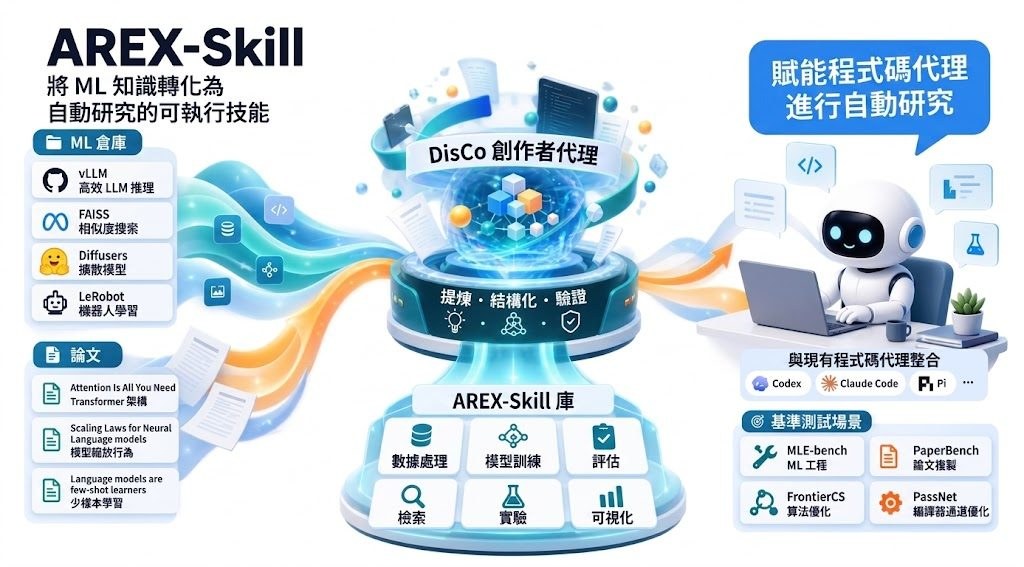
面對需要查閱多個儲存庫、重現研究流程和逐步驗證結果的工作,AREX-Skill 將分散在 GitHub 的操作知識整理成可重用程序、檢查方法和技能圖譜。它屬於面向 Coding Agent 的開源技能庫與工作流工具,實際處理的是代理有模型能力卻欠缺項目脈絡和操作經驗的問題。

AREX-Skill 已從 1,000 多個熱門機器學習儲存庫提煉超過 5,000 個經驗證、可執行的 skills,並可整合 Codex、Claude Code、Pi 等 Coding Agent。使用時可按任務由 router 從技能庫收窄至相關分支,再由代理執行;DisCo 則負責將儲存庫知識建立、驗證和匯出成技能。

  • 技能包含程序與檢查,而不只是文字說明
  • 技能圖譜協助代理處理跨學科機器學習研究
  • DisCo Meta Skills 支援挑選及使用 Creator meta skills
  • Refreshing Repo Skills 提供維護和更新清單

相較於每次由代理重新閱讀 README、程式碼和論文,技能化做法可把重複的操作步驟預先整理,並將預算集中到較困難的推理工作;代價是技能需要隨儲存庫更新而刷新,覆蓋範圍和驗證品質亦會直接影響結果。儲存庫目前提供 Demo、技能目錄、repository catalog 及 DisCo CLI 文件,適合研究團隊、Coding Agent 使用者,以及需要重現多個 ML 項目的開發者。

GitHub

Categories: 開源, Agentic, Vibe Coding, 編程, Anthropic, Dataset 數據集, Skill 技能

Ox Alpha 百萬 Token 上下文免費試用

Z.ai 最新模型 Ox Alpha 提供 1M-token context window,讓大型程式碼庫、圖像與影片可在同一個推理流程中處理。

Og image

面對大型程式碼庫、長篇規格文件或連續多步工作,Ox Alpha reasoning model(推理模型)可把最多 1M-token context window 的內容放在同一個脈絡中處理,減少反覆切分資料或遺失前文。它亦支援文字、圖像和影片輸入,適合除錯、重構及分析截圖或介面流程。

Ox Alpha 會先規劃和自我檢查,再產生答案,並以 visible thinking 展示推理過程。模型同時提供原生 tool calling、tool_choice,以及配合 response_format 的結構化 JSON 輸出,方便用於長時間運行的 agentic 工作流程。

網站列出的獨立測試涵蓋 10 項真實編程任務,Ox Alpha 完成 8 項,得分 80%;同一比較中,Fable 為 65%,GLM-5 為 62%,GPT-5 和 Grok 4 均為 52%。樣本只有 10 項任務,結果較適合作為參考,未足以代表所有編程場景。

• 1M-token context window,最高 131K tokens 輸出
• 支援文字、圖像和影片三種輸入
• 適合大型程式碼庫的 debugging 和 refactoring
• 原生 tool calling 與結構化輸出
• 免費試用、毋須登入,網站表示不會把聊天儲存在伺服器

項目主頁

Categories: Agentic, 模型, 多模態模型, Video, Image, 軟件, Python, 編程, 免費試用, UI/UX

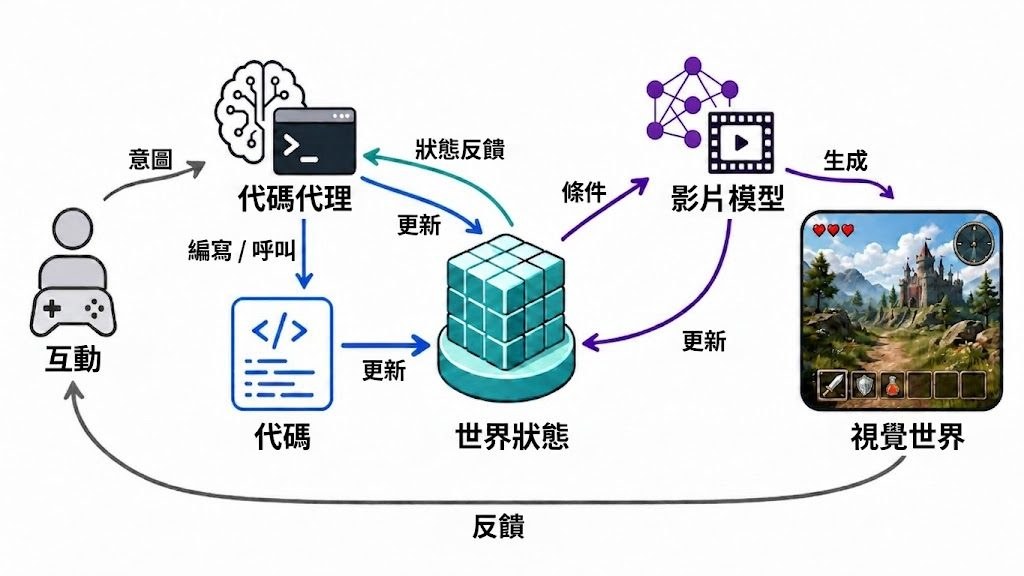
Code World Model:以 coding agent 當大腦,video model 演畫面,世界不再失憶

Code World Model 讓 coding agent 負責推演世界狀態,再由 video model 將結果呈現成影像,支援更持續的互動場景。

Pipeline of the proposed Code World Model

當影片模型只能呈現事件結果,卻難以記住規則、因果和長期後果,互動世界就容易變得不連貫。Code World Model 以 coding agent 作為「世界大腦」,透過可執行程式碼更新及控制世界狀態,再交由 video model 將狀態轉化為視覺觀察。

這種分工把世界演化和畫面生成拆開處理。coding agent 會根據事件推理後果、規劃變化並編寫程式;video model 則負責利用生成先驗呈現場景,讓同一個世界狀態可以延伸出不同視覺體驗。

項目展示了長時間生成及定期轉換風格的場景,包括海底港口、魔法學院、糖果運河和雲上海港等內容;展示中亦使用 RGB Proxy,並以約每60秒一次的節奏改變風格。這類架構適合研究開放式世界模擬、互動敘事,以及需要持續狀態和因果後果的視覺體驗。

• coding agent 負責規則、事件與世界狀態
• video model 負責將狀態實現為影像觀察
• 可支援較長時間的世界演化與持續後果
• 透過分離邏輯和畫面,減少只從影像學習動態的限制

目前資料集中於框架概念、展示場景及研究論述,因此不能視為已確認可自由下載的模型。使用者亦需要留意,視覺效果和世界狀態的一致程度仍會取決於 coding agent 的推理、規劃及編程能力,以及 video model 的生成能力。

項目主頁 · Paper

Categories: 開源, Agentic, 視頻模型, 世界模型, 模型訓練, Video, 框架, Vibe Coding, 編程, AGI, 動畫, MiniMax

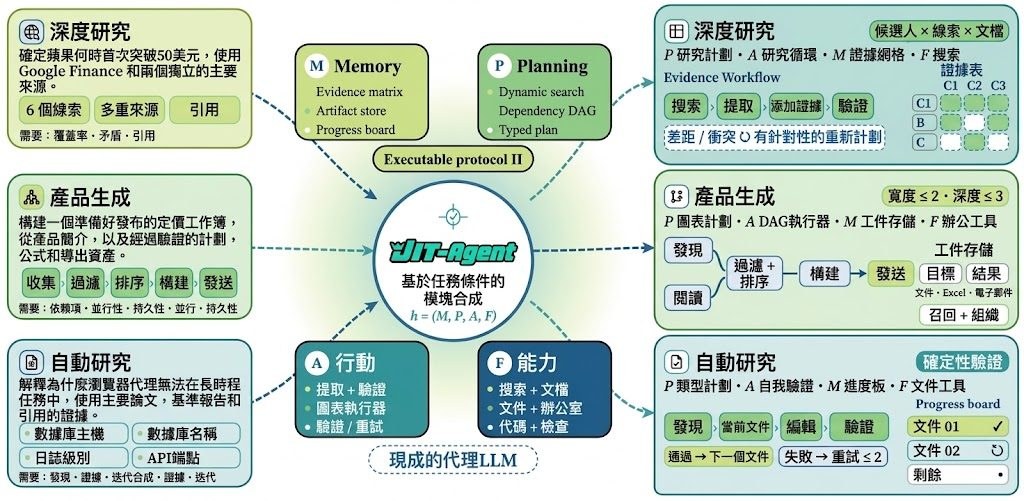
JIT-Agent:讓模型即時寫出專屬代理框架

JIT-Agent-27B會按任務即時組合可執行的代理框架,令同一個 Agentic LLM 更貼近研究、辦公及規劃工作。

JIT-Agent

面對深度研究、日常工作或工作區操作等不同任務,固定不變的代理框架未必能有效轉用。JIT-Agent 屬於一個 meta-agent 模型項目,接收任務規格、協議、工具及技能註冊表,再為現成的 agentic LLM 生成特定任務的可執行 harness,處理代理流程難以適配的問題。

JIT-Agent-27B 並非直接取代底層模型,而是負責組合包裝模型的工作方式。每個 harness 由 memory、planning、action 及 capability orchestration 四個模組組成,並透過 HarnessFactory 的共享介面輸出結構化程式碼,避免每次都由模型自由撰寫整套代理程式。

  • 按任務生成不同的記憶、規劃和行動流程
  • 可包裝不同的 off-the-shelf agentic LLM
  • 測試期間會根據 trace 與 feedback 修訂 harness
  • 生成器保持 frozen,改進內容寫入 harness archive
  • 涵蓋研究、辦公、規劃及 workspace 類代理基準

同類方案通常先準備一個通用 scaffold,再期待它在不同任務中轉移;JIT-Agent 將可轉移的能力放在 harness 生成與演化,而不是只依賴 base model 擴大。代價是系統需要任務規格、工具註冊表、過往 harness 及測試回饋,生成品質亦會受這些輸入影響。

JIT-Agent 把 jit/、scripts/、harness_factory/、benchmark/ 及 dataset/ 分開,涵蓋生成與修復提示、代理核心、評估器和基準適配器。 JIT-Agent-27B 在九個代理基準中領先八個。適合研究代理架構、需要為多類工作測試流程的團隊,以及想比較「擴大底層模型」與「改進 harness」效果的人員。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 框架, 編程, Dataset 數據集

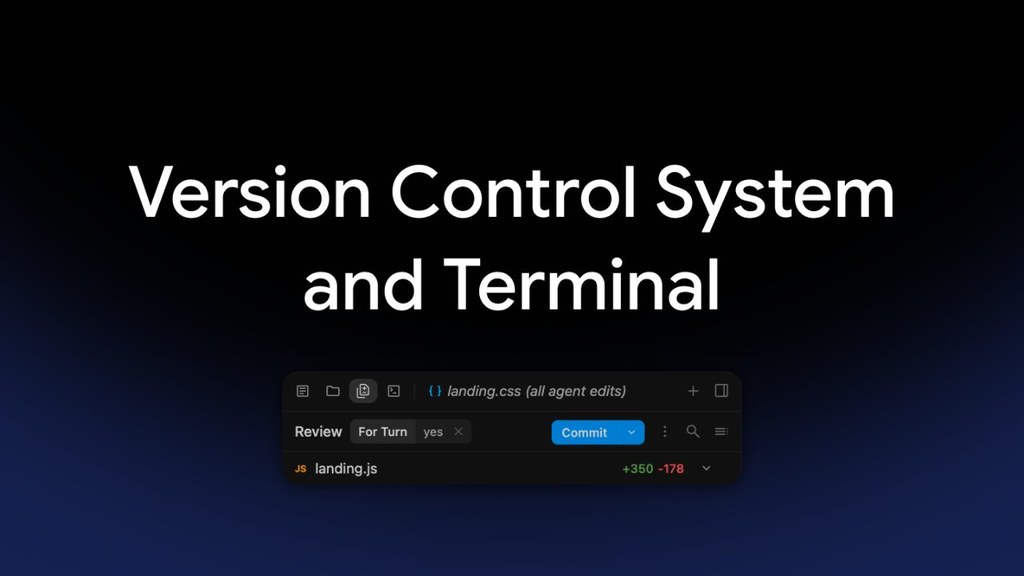
Google Antigravity 把版本控制與終端機帶入 AI 開發流程

Google Antigravity 將版本控制和終端機操作納入 AI 輔助開發,讓編程工作由單次指令延伸至可追蹤、可檢查的完整流程。

Hero image preview

當 AI 不只產生程式碼,還要修改檔案、執行指令及整理變更時,版本控制和終端機就成為確保工作可追蹤的關鍵。Google Antigravity 將這些開發工具納入同一套 AI 輔助流程,協助使用者管理由模型完成的程式編輯工作。

流程可以涵蓋檢視程式庫狀態、執行終端機指令,以及核對 AI 作出的檔案變更。使用者毋須只依賴對話內容判斷結果,而是可以配合版本差異和指令輸出,逐步確認每項修改是否符合預期。

這種安排適合需要反覆修改程式、測試結果及回溯變更的編程工作流。它處理的不是單純產生範例程式碼,而是 AI 參與開發後,如何保留人手審查、版本記錄和操作可見性的問題。

  • 將 AI 編程與版本控制流程連接
  • 支援透過終端機執行開發指令
  • 方便檢視及核對檔案變更
  • 適合需要測試、回溯和協作的項目

使用時仍然需要檢查指令內容、檔案差異和執行結果,尤其涉及刪除檔案、修改設定或操作外部服務的情況。版本控制可以降低回復成本,但不能取代開發者對變更風險的判斷。

項目主頁

Categories: Agentic, Google, Gemini, IDE, 編程

GameXpert-Bench | Coding Agents for Game Development

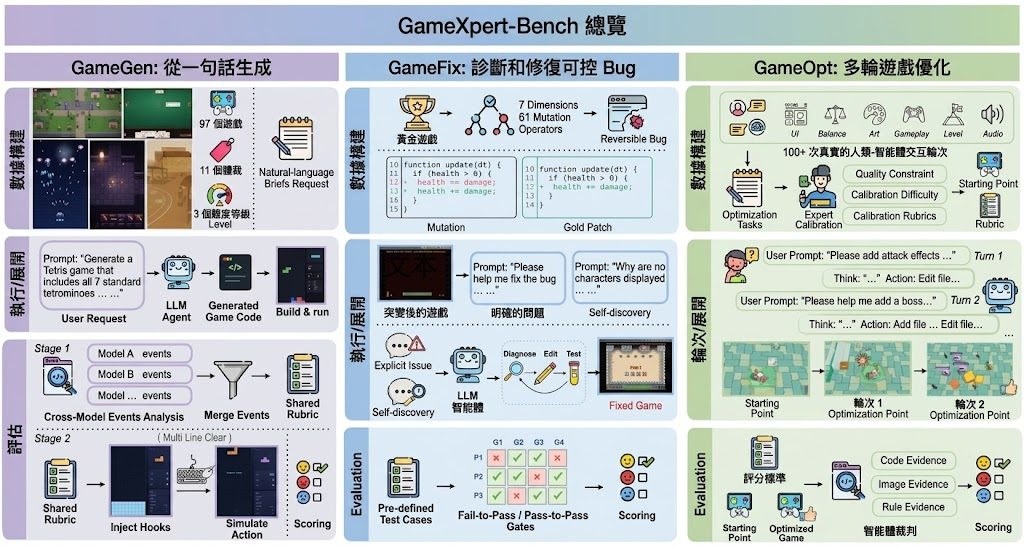
騰訊團隊聯同多間院校提出 GameXpert-Bench,專門看 Coding Agents 能否做出、修好再優化可玩遊戲。它把生成、修復同多輪改進放入同一條流程去評估。

Og image

騰訊 Hunyuan Team、Lightspeed Studios,聯同 CASIA、清華大學、香港科技大學、香港中文大學深圳等團隊,提出 GameXpert-Bench,用來檢驗 Coding Agents 在遊戲開發上的真實能力。它不只看程式碼寫得像不像,還看能否真的做出可玩遊戲、找出錯誤,並在多輪修改後保持功能完整。

這個項目處理的是一個很實際的落差:很多代理可以生成看似合理的程式,但一到互動、畫面、音效、介面同可玩性要同時成立,就容易出問題。GameXpert-Bench 把整個生命週期拆成三條軌道,分別測首次生成、修復缺陷,以及連續優化,逼近真實開發流程。

  • GameGen 測試從零開始生成可玩遊戲,沒有預設引擎或素材
  • GameFix 測試對已知缺陷的診斷與修復,亦包括自行發現問題的情況
  • GameOpt 測試多輪改進時能否保住核心玩法與既有功能
  • 評估不只看程式,還結合互動行為、代碼檢查同人工判斷

目前公開資料提到共有 97 個生成任務、100 個修復任務,以及 17 條多輪優化鏈,涵蓋 2D 和 3D 遊戲。整體結果指向一個清楚結論:寫出看似合理的實作,比起交出經過驗證、又唔會在後續修改中壞掉的遊戲容易得多。

對做 Coding Agents、遊戲工具鏈、或研究 agentic software engineering 的讀者,這個基準特別有參考價值。它把「能寫」和「能交付」分開,令模型在真實工作流中的短板更容易被量度出來。

項目主頁

Categories: 香港中文大學, 香港科技大學, 清華大學, 騰訊, Agentic, Audio, 軟件, 3D, 編程, Dataset 數據集

DeepSeek Harness 把多 Agent 協作變成可控工作台

[教學影片]DeepSeek Harness 讓 DeepSeek dsh 變成可啟動 Web UI 的開發者工作台,重點放在多個 Agent 並行處理、動態工作流同插件擴展。它適合要在複雜程式碼庫入手審計、協作同加速探索嘅使用場景。

Og image

DeepSeek Harness 把 DeepSeek dsh 做成一個可啟動 Web UI 的開發者工作台,處理的是複雜程式碼庫入面要同時分工、同步同收斂結果的問題。影片實測重點放喺並行只讀審計、動態派生 SubAgent,同埋最後將多路輸出整合返去。

它同一般單一路徑的助理做法不同之處,在於可以按工作內容拆成多個 Agent Teams,再根據任務需要即時調整流程。這種安排適合審查、分析同探索型工作,因為不同子任務可以同時展開,唔使一條線慢慢行。

片中亦提到插件開發門檻較低,代表它不只係拿來跑預設流程,仲可以按團隊習慣加功能。對要處理既有代碼、要快速驗證想法,或者想將 AI 工具接入日常開發流程的人,這種擴展性會更實用。

重點摘要:
– 以 Web UI 包裝 DeepSeek dsh,方便直接操作
– 支援多個 Agent 並行工作,減少單線等待
– 可動態派生 SubAgent,按任務拆分工作
– 插件擴展門檻較低,方便接入自訂流程
– 適合複雜程式碼庫審計、協作同探索任務

項目主頁

Categories: 開源, Agentic, DeepSeek, 教學, 編程, 安全, UI/UX

Agent Lightning v1.0:把代理訓練接回真實工具流

Agent Lightning v1.0 讓代理在保留工具、上下文和環境的情況下直接訓練。它也把 Kubernetes、程式編寫和獎勵防作弊流程一併整合起來。

logo

Agent Lightning v1.0 針對一個常見卡位:代理訓練往往要靠額外沙箱或改寫流程,令工具、控制流和環境脫節。這個項目把訓練直接接回真實 agent harness,代理可以經由 Agent Lightning v1.0 proxy 運作,而不用改動原本架構。

它的設計取向相當清晰,核心程式碼大約 3,500 行,重寫後把複雜度壓低。代理亦可直接作為 Kubernetes Jobs 執行,不必依賴外部 sandbox 服務,對要跑長時間 rollout 或分散式訓練的團隊會方便很多。

文檔同時提供完整的 coding-agent 訓練流程,涵蓋資料清理、reward-hacking 防護和訓練腳本。這代表它不只停留在概念層面,而是把一條可落地的訓練管線交到使用者手上。

  • 保留工具、上下文、控制流和環境在訓練迴圈內
  • 透過 proxy 接入現有 agents,減少改動成本
  • 原生支援 Kubernetes Jobs,部署更直接
  • 提供 coding agent 範例,連資料清理和防作弊流程都包進去
  • 適合做具互動工具、程式執行或多步推理的 agent 訓練

項目主頁

Categories: 開源, Agentic, 模型訓練, 微軟, DeepSeek, API, Vibe Coding, Python, 編程

playwright-skill 技能讓代理即寫即跑瀏覽器流程

這個項目把 Playwright 自動化包進 Agent Skill,適合要把瀏覽器操作變成可重跑程式的場景。它偏向 code-first,重點是把測試、截圖、網絡攔截和多步流程直接交給代理生成。

Repository image for lackeyjb/playwright-skill

面對要反覆驗證頁面流程、抓截圖、做網絡攔截,或者把操作保留下來重跑的情境,這個項目提供的是一套給 coding agents 用的 Playwright 自動化技能,並同時包成 Claude Code Plugin,安裝與接入都比較直接。

它不是單純的瀏覽器控制工具,而是讓代理按需要寫出真正的 Playwright 程式,再即場執行。官方也明講,若只是一般互動式瀏覽,Playwright CLI 或 playwright-mcp 會更合適;這個項目更適合 code-first 工作流,當自動化本身就是要保留的產物。

安裝方式以 Vercel 的 skills CLI 為主,支援全域或指定項目安裝;結構上把 skill 放在 plugin 的 skills 目錄,方便不同 agent 讀取。它也主打可見瀏覽器預設開啟、穩定的模組解析、臨時檔安全清理,以及按需載入完整 API,減少代理一次讀入太多內容。

  • 適合要寫、執行、重跑 Playwright 腳本的工作流
  • 支援單步頁面測試,也支援多步流程與多個 context
  • 可用於 screenshot、video、network interception 等任務
  • 和純工具式控制相比,更重視可保存的程式碼結果
  • 受益較多的通常是做自動化測試、爬取流程驗證、代理工作流的人

整體看來,這個項目把「讓代理操作瀏覽器」提升成「讓代理產出可維護的 Playwright 程式」。它的價值不在於包辦所有瀏覽器需求,而在於把可視化執行、程式化控制和可重用性放到同一條工作流裡。

GitHub

Categories: 開源, Agentic, MCP, API, 編程, Skill 技能

Page 1 of 11
1 2 3 11