Dr. Claw 把 AI 研究流程收進一個可審核工作台

一款開源 AI 研究助理,把文獻回顧、實驗、寫作整合在同一介面,讓人類決策與 AI 執行之間留下可追蹤的紀錄。

Dr. Claw

跑過 AI 研究的團隊都遇過同樣的痛:Claude Code、Gemini CLI 等命令行編碼代理(coding agents)能讀寫檔案、撐住長對話,但文獻回顧、構思、實驗、寫論文、投期刊這些步驟散落在聊天工具、IDE、終端機、寫作軟件之間,中間決策也難以回頭追溯。Dr. Claw(GitHub: OpenLAIR/dr-claw)針對的正正是這個碎片化問題——它不是另起爐灶造一個新代理,而是把現有命令行編碼代理(Claude Code、Gemini CLI、Codex,以及透過 OpenRouter 接入的數百個模型)包進一個可控、可審核、人在回路(human-in-the-loop)的工作流。

項目覆蓋 survey → ideation → experiments → paper writing → slides & promotion 整條研究生命週期,與只懂執行程式碼的 CLI 代理相比,差異在於「全流程編排層」。底層靠三個關鍵設計撐起這層:持久化狀態物件(persistent state objects)、可重用技能庫(reusable skill library),以及多執行器協調(multi-executor coordination),把計劃、執行、寫作綁成一條可恢復的循環。論文亦明確指出,比起只共享同一後端執行器的裸 CLI 代理,Dr. Claw 在研究完整性上得分更高,同時保留可審計、可回溯的過程痕跡。

對獨立研究者、AI 實驗室團隊、需要把研究流程制度化的單位而言,這套架構的價值在於把人類決策(目標、約束、驗收)與 AI 執行清楚分開,並透過 checkpoint 反饋(Verify / Revise / Retry / Handoff)保留介入點。它支援本地部署(自家機器、自家 GPU、自家資料),亦提供桌面版(.dmg / .exe)或 npx dr-claw 零安裝啟動,甚至能在終端機直接 dr-claw chat 跑 agentic 對話。

項目已被 EMNLP 2026 System Demonstrations track 收錄(arXiv: 2609.00365),並採用 AGPL-3.0 搭配上游 GPL-3.0 元件授權,免費、無訂閱。需要留意的是,它自定位為 Anthropic Claude Science 的開源、模型中立替代方案,主打全生命週期而非單純計算分析。
GitHub · Paper

Categories: 開源, Agentic, 模型, OpenAI, Gemini, 軟件, 工具, IDE, , 編程, Anthropic, Skill 技能

Diffusion Studio:智能影片剪輯工作流

Diffusion Studio 將時間軸剪輯與 SolidJS 程式碼互相同步,讓 AI agents 可以直接協助製作影片。

Diffusion Studio

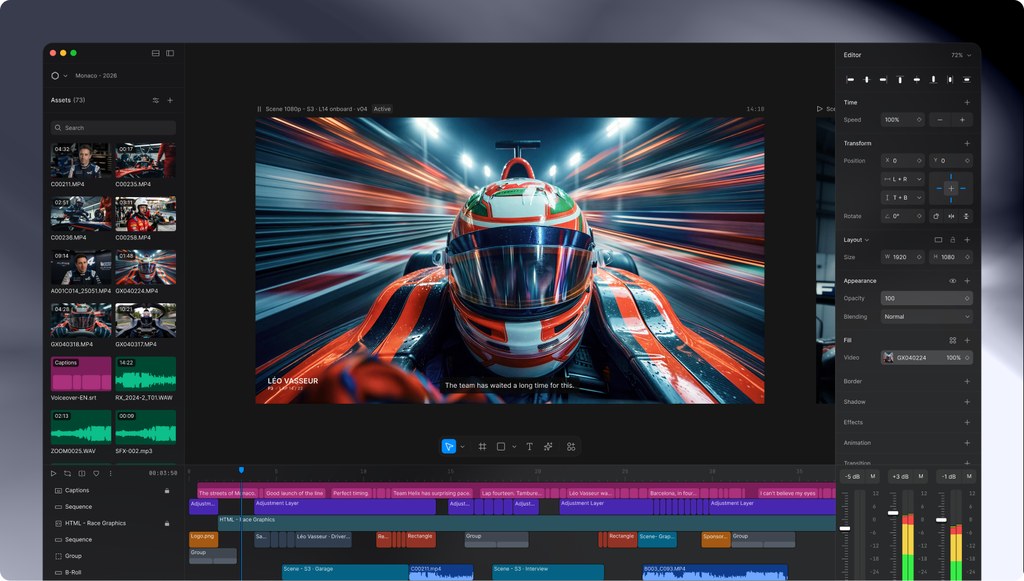
想用自然語言叫 AI 整理素材、剪出精華片段,甚至加入動態圖像和旁白,Diffusion Studio 提供了一條由命令列控制影片編輯器的工作流。它屬於開源影片編輯工具,核心是以 SolidJS modules 作為文件來源,處理由原始片段到成片的剪輯、合成和影片理解。

畫布與程式碼可以雙向修改:在畫布調整內容,變更會寫回程式碼;直接編輯程式碼,影片畫布亦會重新繪製。配合 dapi CLI,Claude Code、Codex、Cursor、Copilot 或 Gemini CLI 等 agents 能以文字指令操作時間軸,亦可要求系統摘要影片、搜尋場景,或找出附有時間戳的引述。

  • 影片剪輯、Motion graphics、社交平台短片重製
  • 以程式碼宣告圖片、影片和 voiceover,再合成到時間軸
  • 由命令列觀看及聆聽素材,交由 agents 協助處理
  • 可在 macOS Apple Silicon 使用桌面版本,並透過 skills 接入工作流

相比只在時間軸介面操作的編輯器,程式碼成為可保存、修改和交給 agents 處理的文件來源,較適合需要重複產出、批量改版或以生成式資產組成影片的團隊。代價是使用者要同時理解畫布、SolidJS modules 和 CLI 的關係;項目資料亦未提供獨立性能指標或完整平台支援範圍,不能單憑介紹判斷長片剪輯效率。

Diffusion Studio 連接 AI agents 之後可透過程式碼與影片時間軸進行編輯。內容創作者可先下載 macOS Apple Silicon 版本,再安裝官方 skills,透過自然語言要求建立影片,並在畫布中檢查結果;熟悉編程的團隊則可直接維護可重用的影片程式碼。

GitHub

Categories: 開源, Agentic, AI productions, IDE, Mac, 蘋果, Skill 技能

Google Antigravity 把版本控制與終端機帶入 AI 開發流程

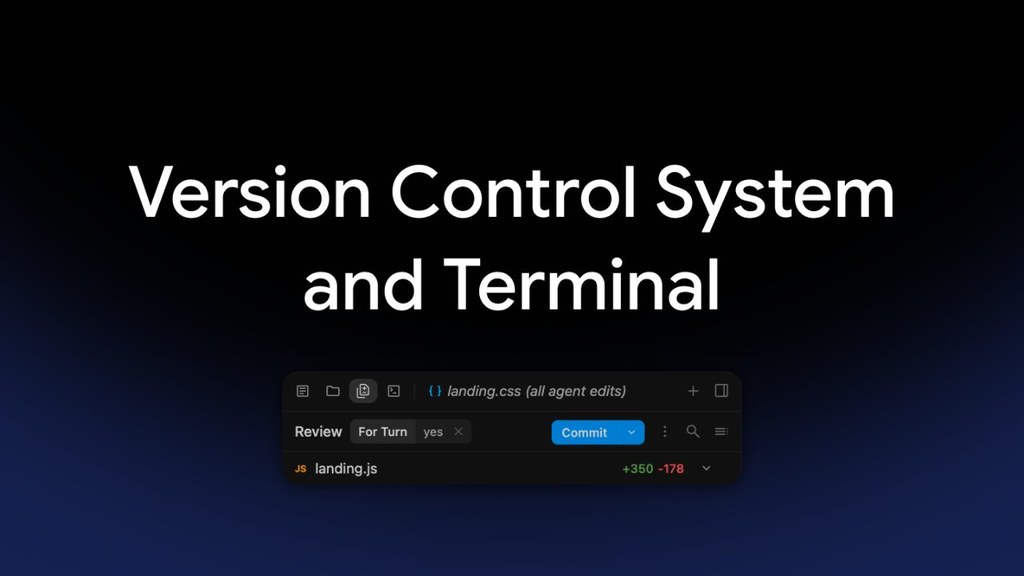
Google Antigravity 將版本控制和終端機操作納入 AI 輔助開發,讓編程工作由單次指令延伸至可追蹤、可檢查的完整流程。

Hero image preview

當 AI 不只產生程式碼,還要修改檔案、執行指令及整理變更時,版本控制和終端機就成為確保工作可追蹤的關鍵。Google Antigravity 將這些開發工具納入同一套 AI 輔助流程,協助使用者管理由模型完成的程式編輯工作。

流程可以涵蓋檢視程式庫狀態、執行終端機指令,以及核對 AI 作出的檔案變更。使用者毋須只依賴對話內容判斷結果,而是可以配合版本差異和指令輸出,逐步確認每項修改是否符合預期。

這種安排適合需要反覆修改程式、測試結果及回溯變更的編程工作流。它處理的不是單純產生範例程式碼,而是 AI 參與開發後,如何保留人手審查、版本記錄和操作可見性的問題。

  • 將 AI 編程與版本控制流程連接
  • 支援透過終端機執行開發指令
  • 方便檢視及核對檔案變更
  • 適合需要測試、回溯和協作的項目

使用時仍然需要檢查指令內容、檔案差異和執行結果,尤其涉及刪除檔案、修改設定或操作外部服務的情況。版本控制可以降低回復成本,但不能取代開發者對變更風險的判斷。

項目主頁

Categories: Agentic, Google, Gemini, IDE, 編程

Comfy-mcp:讓 AI 直接操控本地工作流

Comfy MCP 把本地 GPU、模型與自訂節點交給 AI 管理,令 ComfyUI 工作流可以用自然語言建立、執行及修改。

Comfy

由 MiniMac Code、Claude、Cursor、Codex 等 AI agent 用自然語言建立並執行本地 ComfyUI 工作流,正是 Comfy MCP 提供的核心能力。它屬於 Model Context Protocol(MCP)伺服器,透過 comfy-cli 連接使用者自己的 ComfyUI,處理模型、節點、工作流與輸出圖片之間原本較繁複的操作。

使用者需要先有本地 ComfyUI 及 Python ≥3.10,再把 Comfy MCP 設定到支援 MCP 的客戶端。連接後,AI 可以讀取目前安裝的節點、自訂節點、模型及 GPU,搜尋可用模板,驗證工作流圖表,修改模板欄位,提交非同步工作,監察、取消工作,以及收集輸出的 PNG 檔案。

它和只依賴固定模型目錄或靜態工作流範例的做法不同,會按本機真正載入的內容作判斷,亦能在下載模型前檢查硬件是否有足夠能力。這減少了模型版本、節點依賴和顯存不相容帶來的失敗,但生成速度、可用模型和成功率仍然取決於 GPU、ComfyUI 安裝狀態、自訂節點及工作流本身;項目資料未提供統一基準測試數據。

較適合經常製作影像或影片工作流、需要反覆試驗模型的創作者,以及想把本地 GPU 納入 AI agent 流程的開發團隊。Comfy Cloud 與本地連線可以同時使用,代理可按硬件和任務需要選擇位置,形成雲端彈性與本地模型控制之間的折衷。

  • 自然語言操作:建立、編輯、驗證及執行 ComfyUI 工作流。
  • 讀取本機環境:辨識 GPU、模型、模板及包括自訂節點在內的已載入節點。
  • 完整工作管理:支援提交、等待、監察、取消及讀取失敗結果。
  • 本地與雲端並用:同一個 MCP 連線可按任務需要配合兩種環境。

項目主頁 · GitHub · Skills

Categories: 開源, ComfyUI, Agentic, AI productions, MCP, IDE, Python, Skill 技能

dembrandt:把網站風格秒轉成可追蹤的設計 tokens

Dembrandt 直接把網站的 logo、色彩、字體和間距抽成 design tokens,方便你在 AI 工具或 CI 裡持續比對變化。它不只做擷取,還把每次改版的風格漂移記錄下來。

Dembrandt: Any website to design tokens

Dembrandt 係一個用來抽取網站設計系統嘅工具,重點係將 logo、色彩、字體、邊框、陰影等視覺元素整理成 design tokens,方便團隊快速理解一個網站嘅視覺規則。對做前端、設計系統或者品牌一致性檢查嘅人嚟講,佢可以省去逐頁抄資料嘅時間。

使用時要先準備 Chromium,因為它透過 Playwright 核心去驅動瀏覽器,唔裝 browser binaries 就冇得啟動。安裝後可以用 CLI 直接抽取,亦可以透過 MCP 接入 Claude Code、Cursor 或 Windsurf,令 AI 助手幫你讀出 tokens。

同類工具多數只做一次性擷取,Dembrandt 加入咗漂移追蹤同快照時間線,令你可以比較兩次發佈、兩個網站,或者同一個 domain 喺唔同時間嘅變化。佢仲提供視覺差異、分類分數同 baseline 比對,對 CI 監察改版影響特別有用。

  • 可把網站外觀整理成可重用嘅 design tokens
  • 需要先安裝對應 Chromium,否則無法運行
  • 支援 MCP,方便接入 AI 編程工作流
  • 可以記錄快照,持續追蹤設計漂移
  • 適合前端、設計系統同品牌檢查工作

如果團隊要維持多個頁面或多次發布之間嘅視覺一致性,呢個工具比單次擷取更有用。它將抽取、比較同追蹤放埋一齊,令設計變化唔容易悄悄走樣。

GitHub

Categories: 開源, MCP, IDE,

Grok Bot 登場:xAI 推出常駐 AI 同事,能自主操作電腦完成任務

Grok Bot 就像一隊永不登出的 AI 隊友,能登入你的軟件代勞長時間任務,從銷售外聯到支援工單都接力完成。

Og image

xAI 最新推出的 Grok Bot,把「Computer-use agents(CUAs)」這個概念包裝成一支可以分工的虛擬團隊。它擁有自己獨立運行的電腦環境,能像真人般登入 Zendesk 等 SaaS 工具、瀏覽網頁、操作軟件介面,並在背景 24 小時不中斷地接力完成任務。對需要處理大量例行工序的小團隊或一人公司來說,這類 agent 最直接的價值是把「等人按掣」的等待時間壓縮到接近零。

Grok Bot 強調幾個工作流設計:你可以同時叫多個 Bot 進入同一個對話串,分頭負責研究、公關、差旅等不同環節,Bot 之間會自行交接工作;只要你親自示範一次流程,它就能把步驟記成「routine」自動重複執行,並隨時間累積記憶,例如記下某客戶只簽年約、誰是決策人。對需要批量生成銷售名單、處理支援工單或長期追蹤項目進度的使用者而言,這種「邊做邊學」的能力比單純的 prompt 工具更貼近實際工作節奏。

定價方面,Grok Bot 綁定在 Cursor Ultra 月費 200 美元的方案內,包含其專屬電腦環境、跨裝置使用與排程執行;團隊版則額外提供 SSO 與共享用量分析。xAI 將其定位為企業 SaaS 的入口代理,但實際上能否取代 ClickUp、HubSpot 等內建自動化,仍要視乎它對接工具的覆蓋率與執行成功率。

重點摘要

  • 擁有獨立電腦,能像人類登入並操作 SaaS 工具完成長時間任務
  • 支援多 Bot 協作,在同一對話串內自行分工與交接
  • 用戶示範一次流程後,Bot 可記為 routine 自動重複執行
  • 隨時間累積記憶,保留客戶偏好、決策人等脈絡
  • 透過 Cursor Ultra(200 美元/月)方案提供,團隊版含 SSO 與共享分析

項目主頁

Categories: Agentic, API, 工具, 線上服務, IDE, Mac, 免費試用

Ouroboros 把 AI 代理變成「自我演化」

它不只會接任務,還會記住自己做過什麼,甚至改寫自己。對想長期運行 AI agent 的團隊,呢種設計幾有吸引力。

Terminal-Bench 2.1: Ouroboros against Claude Code, Codex CLI, Cursor CLI, and Hermes on matched models, with a same-harn

一次性完成指令的 AI agent 已經不少見,但能夠跨任務、跨重啟保留身份、記憶同歷史,仲可以持續修改自己運行方式的並不多。Ouroboros 屬於開源通用型 AI agent,處理的是長週期工作會斷線、失憶,同埋難以持續改進代理本身的問題。

它不是單純能開多個 specialist agents,而是保留「同一個負責任主體」去協調研究、建構、驗證同審查。呢種做法對外部程式碼項目、需要長時間追蹤證據的工作流特別有用;代價是系統野心很大,對使用者來說亦意味要接受一個會動到自身程式碼、prompt、tools 甚至 dependencies 的代理。

Ouroboros 可當原生桌面程式使用,也可走 headless CLI,Windows x64 同多種 Linux 發行版都有發佈版本。執行期會把 repository、durable memory、history 同介面留在本機,模型推理則可接駁你自行設定的遠端 API,或者用本地 GGUF 模型,對想保留資料控制權的人較有吸引力。

  • 開源通用型 AI agent,重點在持續身份、durable memory 與自我修改
  • 可協調一組 specialist agents,但最終責任仍由單一 root agent 承擔
  • 支援桌面 app 與 CLI,適合長時間運行或接手外部程式碼項目
  • 本機保存記憶與歷史,模型可用遠端 API 或本地 GGUF 格式在本地執行推理
  • 官方列出 Terminal-Bench 2.1、OSWorld-Verified、CL-Bench 的 self-reported 成績

Ouroboros 公開了在 Terminal-Bench 2.1、OSWorld-Verified 同 CL-Bench 的 self-reported 結果,並以 matched model 或公開排行榜對照 Codex、Claude Code、Cursor、Hermes。呢類數字有參考價值,但仍要留意它屬自報結果;較可取的是,項目同時強調 traces、evidence 同可重現性,顯示它想把重點放在可檢查的過程,而不只是最終分數。

整體來看,Ouroboros 適合研究型開發者、想建立長記憶 agent 的團隊,以至需要代理長期接手軟件工作流的人。它吸引人的地方在於把 agent 由「一次性助手」推向「可延續個體」,但同時也把風險一併帶進來:自我演化愈強,愈需要清楚邊界、驗證流程同責任歸屬。

項目主頁 · GitHub

Categories: 開源, Agentic, API, IDE, Mac, Linux, Dataset 數據集

free-claude-code:一個代理層打通 Claude Code 與 Codex

想保留原生開發代理體驗,又想自由換模型與供應商,free-claude-code 正正補上這個缺口。它把 Claude Code、Codex 同 Pi 接到同一個可管理入口。

用開 Claude Code 或 Codex 的人,最在意通常唔係再裝多一個聊天介面,而係可否繼續用原生 model picker、串流回應、tool use 同 image input,同時改用自己揀的模型供應商。free-claude-code 就係一個 proxy 工具,把 Claude Code、Codex、Pi 及其 IDE 擴充功能接到自管入口,處理多供應商切換同路由分發。

它的價值在於工作流幾乎唔使重學。你可以照用 fcc-claudefcc-codexfcc-pi 啟動對應代理,Windows 同 macOS 亦可放在背景執行,再到本地 Admin UI 揀選並驗證供應商。可在 31 個 cloud 與本地 providers 之間切換,亦可把 Fable、Opus、Sonnet、Haiku 同 fallback 流量分別導向不同模型,這點對想控制成本、速度同能力分工的團隊幾實用。

跟直接綁死單一 API 的做法相比,這個項目押注在「保留原生客戶端體驗,再用 proxy 抽換後端」。代價是相容性要靠代理層維持,所以它明確強調只會在兼容模型上保留 streaming、tool use、reasoning 同 image input;換句話說,模型可揀得更自由,但不是每個後端都保證功能完全一致。

  • 支援 Claude Code、Codex、Pi,同時保留各自原生 model picker
  • 透過本地 Admin UI 管理與驗證 31 個 cloud/本地 providers
  • 可把不同流量類型分流到不同模型,方便平衡成本與能力
  • 適合想用本地模型、付費模型或免費模型混搭的開發團隊

安裝與測試方式偏向開發者工具鏈:項目以 Python 3.14、uv、Pytest、Ruff、Ty 組成,部署重點不是雲端託管,而是先在本機跑起 proxy,再讓代理客戶端經它連線。現階段最適合已經在用 Claude Code 或 Codex、又想統一管理模型入口的人;追求零設定即用的讀者,會覺得它比較像一層需要自己維護的基建。

GitHub

Categories: 開源, NVIDIA, API, Image, 工具, IDE, Mac, Python, 編程, Anthropic, UI/UX

FunASR 工業級語音辨識:支援廣東話

想在本地架一個 OpenAI 相容嘅語音轉文字 API?ModelScope 嘅 FunASR 將 SenseVoice、Paraformer、Fun-ASR-Nano 等模型收喺同一個 Python 接口,仲支援 vLLM 加速同 MCP 接入 AI Agent。

Repository image for modelscope/FunASR

如果你做過語音相關項目,大概率遇過呢種情況:開源模型散落喺唔同倉庫、部署方式各異、要接入 Agent 仲要自己寫 WebSocket 中間層。FunASR 就係針對呢類工程痛點嘅工業級語音識別工具包,屬於開源框架,由阿里達摩院維護,提供統一 Python 接口,將 ASR、VAD、標點恢復、說話人分離、情感偵測同音訊事件辨識串成一條流水線。

旗艦模型 Fun-ASR-Nano 係基於 LLM 嘅解碼架構,覆蓋中、英、日三語以及中文方言群組;針對 31 種語言嘅場景可以用 Fun-ASR-MLT-Nano-2512;鍾意多語言又有 LLM 解碼能力嘅,亦有 Qwen3-ASR(52 種語言、0.6B/1.7B 參數)。如果想要更輕量、非自迴歸嘅選擇,Paraformer 同 SenseVoice 仍係穩陣起點,前者適合生產線串流,後者額外送情感同音訊事件標籤。

funasr-server 一行指令就可以拉起 OpenAI 相容嘅轉寫 API,本地聽返 localhost:8000,配合 vLLM 仲可以做到 2-3 倍 LLM 解碼加速同 tensor parallel 批次推理。Agent 整合係另一個重點:MCP Server 可以直接接入 Claude 或 Cursor,OpenAI API 接口又同 LangChain、Dify、AutoGen 無縫對齊。最近幾個版本(v1.3.18 至 v1.3.22)就專門執緊 SRT/字幕分段、長時 WebSocket 連線、verbose_json 回傳呢啲工程細節。

要留意嘅取捨係:Fun-ASR-Nano 需要 GPU;新環境第一次 import funasr 已唔再強行依賴 PyTorch,但用 AutoModel 仍然要先裝 torch。FunASR 比較適合需要私有語音 API、字幕生成、長會議轉寫、或想將語音能力塞入 Agent 工作流嘅團隊開發者。

重點摘要:

  • 統一 Python 接口整合 ASR、VAD、標點、說話人分離、情感偵測
  • Fun-ASR-Nano 旗艦模型支援 31 種語言及中文方言,Fun-ASR-MLT-Nano 覆蓋更廣
  • funasr-server 提供 OpenAI 相容 API,搭配 vLLM 可達 2-3 倍加速
  • 內建 MCP Server 支援 Claude/Cursor,亦可接入 LangChain、Dify、AutoGen
  • 近期版本持續優化字幕分段、WebSocket 長連線、verbose_json 回傳等工程細節

以下是其對粵語支持的詳細信息:

  • UniASR模型:這是一個專為粵語設計的語音識別模型,能夠處理簡體中文的粵語語音識別任務。
  • ITN模型:用於對粵語語音識別結果進行擬文本正則化後處理,以提高識別結果的準確性。
  • VAD模型:語音端點檢查模型,用於檢測長語音片段中有效語音的起止時間點,這對於粵語方言的語音識別同樣重要。
  • 訓練語料:為了提高模型的準確性和適用性,通常會使用大量的粵語語料進行訓練,以便模型能夠更好地理解和識別粵語中的特有詞彙和表達方式。
  • 離線功能:Funasr提供了離線語音識別模型,這意味著即使在沒有網絡連接的情況下,也能夠進行粵語語音識別。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, Qwen, NVIDIA, API, IDE, LangChain, Python, 語音, Dataset 數據集

Kimi K3 把開源大模型推到 3T 級別

想要一個同時處理寫碼、長文件同推理工作的模型,Kimi K3值得留意。它未追平最強閉源模型,但已把開源模型的上限再推高一截。

Kimi K3 hero visual

長上下文、程式開發同知識工作往往要分開交畀不同模型處理,Kimi K3嘗試把這幾件事收在同一個開放模型內。它屬於大型多模態模型,重點是處理長流程 coding、長篇資料閱讀與推理之間的切換成本,並提供原生 vision 能力與 1M context。

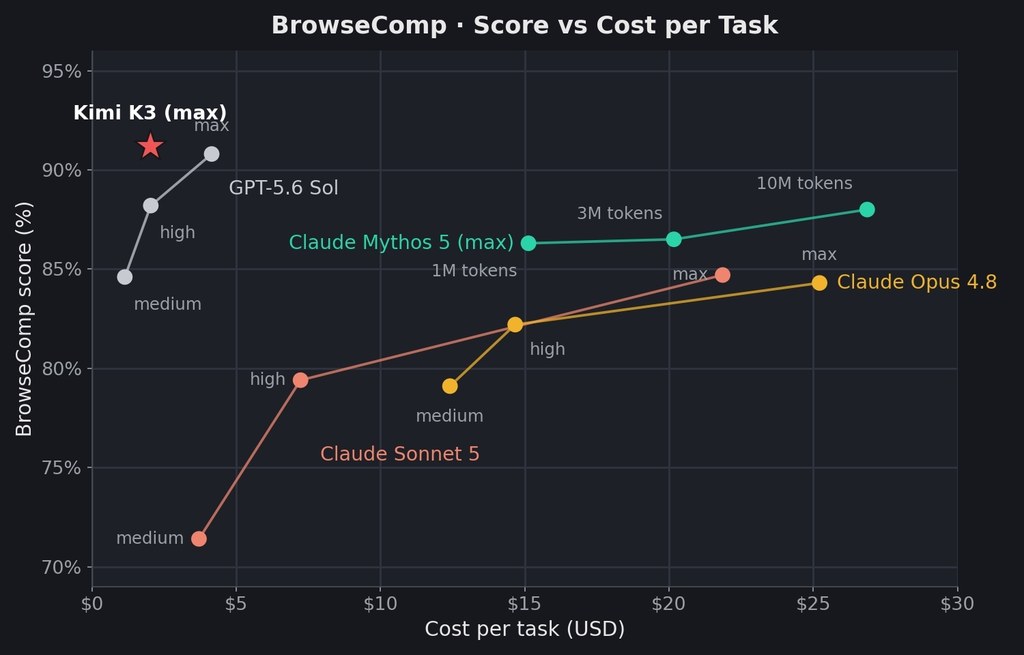
Kimi K3 的定位,不是單靠參數規模取勝,而是想在開源路線上逼近 frontier intelligence。資料提到它有 2.8T parameters,屬於首個 open 3T-class model,整體表現仍落後於 Claude Fable 5 和 GPT 5.6 Sol,但在自家 evaluation suite 內已持續超過其他被測模型,顯示它在開源陣營有明顯競爭力。

技術上,這個模型建基於 Kimi Delta Attention(KDA)同 Attention Residuals(AttnRes),目的是改善資訊在長序列與深層網絡中的流動方式;同時也擴大了 Mixture of Experts(MoE)sparsity。這種做法反映它要處理的核心矛盾:一邊維持超長 context 與多類任務能力,一邊控制推理與訓練效率。

  • 首個 open 3T-class model,規模達 2.8T parameters
  • 原生支援 vision,並提供 1M context window
  • 目標場景包括 long-horizon coding、knowledge work 同 reasoning
  • 採用 Kimi Delta Attention(KDA)、Attention Residuals(AttnRes)與 Mixture of Experts(MoE)
  • 已在 Kimi.com、Kimi Work、Kimi Code 同 Kimi API 提供使用

對開發者、研究者同需要長文檔工作流的人來說,Kimi K3最有吸引力的地方,在於它把「夠長、夠廣、夠開放」放在同一個項目裡。現階段可確認的限制也很清楚:它未到最強閉源模型的水平,而完整權重、架構與訓練細節仍要等後續 technical report 與正式釋出。

項目主頁

Categories: 開源, Agentic, 多模態模型, API, Vibe Coding, 教學, 線上服務, IDE, Mac, 編程, OpenClaw

Page 1 of 3
1 2 3