CoSTA:壓縮語音生成序列,提升對話模型推理速度

語音對話模型可以先產生較短的語音 token 序列,再還原成原有格式的合成波形。CoSTA 在中英文基準測試中提升生成速度,並保留原有語音 tokenizer 和 decoder。

CoSTA separates compressed speech-token generation from original-token synthesis.

語音對話模型要逐個生成語音 token,序列較長時會拖慢回應。CoSTA 是一套語音模型適配方法,透過壓縮生成序列加快推理,同時保留原有語音 tokenizer 和 decoder,讓壓縮後的 token 可在合成波形前還原。

CoSTA 使用 byte-pair encoding(BPE)學習合併語音 token,並以原有 token 的 embedding 和 LM head 權重平均值初始化新增詞彙。適配分階段進行:先訓練發音,再調整語音對話輸出,讓模型生成交錯的文字與語音內容。它改變的是生成時使用的 token 空間,而非取代負責語音合成的原有元件。
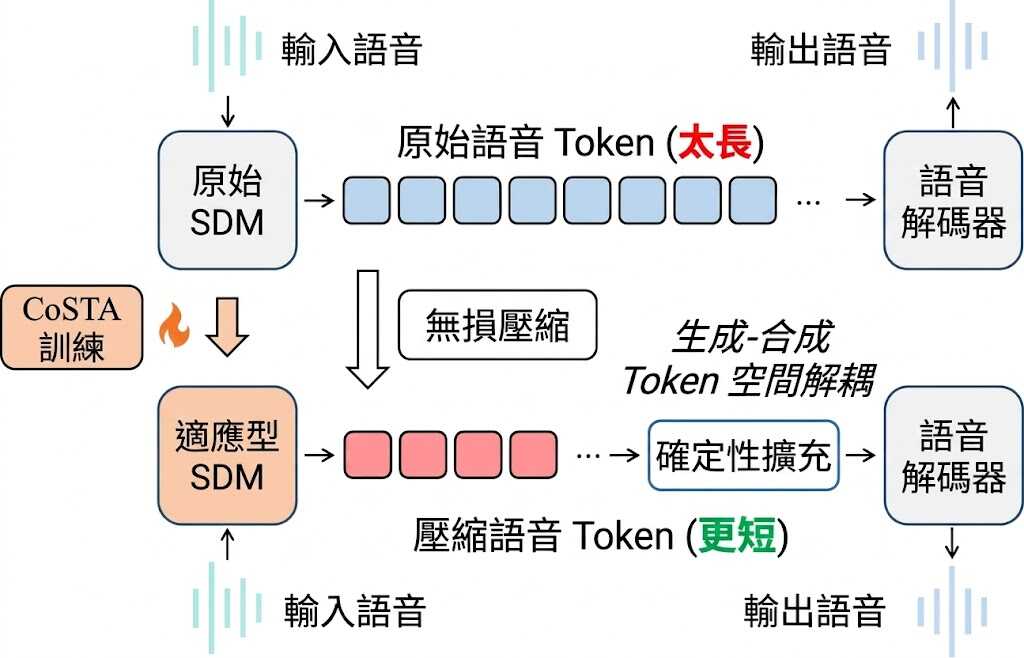
在中英文基準結果中,CoSTA-ZH 的壓縮序列保留原 token 數量的 66.81%,擴展後語音 token 生成速度為每秒 101.99 個;CoSTA-EN 分別為 70.17% 和每秒 99.05 個。兩者相對 Step-Audio 2 mini 的速度為 173.63% 和 165.94%;這些結果反映特定基準測試,不能直接當成所有模型或硬件上的延遲保證。

對已有語音對話模型、希望提高回應速度而不重建語音合成流程的研究團隊,CoSTA 提供了一條可評估的適配路徑。GitHub 提供程式碼與論文連結,但模型權重及資料集仍標示為即將推出,現有資訊亦未列出完整安裝及測試流程。

  • 壓縮自回歸生成用的語音 token 序列,再於合成前確定性還原。
  • 保留原有語音 tokenizer 和 speech decoder。
  • 中英文基準測試均報告高於 Step-Audio 2 mini 的生成速度。
  • 權重與資料集尚未提供,現階段難以直接復現完整流程。

項目主頁 · GitHub

Categories: 開源, Embedding, 模型, 模型訓練, Audio, 語音, Tokenize

Deepseek Recipe 幫本地推論後端連接多格式 API

在本地跑 DeepSeek 模型、想同時提供 Messages、Chat Completions 與 Responses 三種 API 格式?這個 Rust + Python 工具庫把格式轉換、prompt 渲染與 token 編碼一條龍包辦。

DeepSeek

對想自建 DeepSeek 推論服務嘅開發者來說,最頭痛往往唔係模型本身,而係點樣令自家後端兼容外界各種 API 格式。deepseek-recipe 就係針對呢個痛點而來——它用 Rust 寫核心邏輯,再提供 Python bindings,專門負責將 Messages、Chat Completions 同 Responses 三種主流請求格式統一轉換成 DeepSeek 內部嘅 Conversation 結構,再渲染成模型識讀嘅 prompt,最後用附帶嘅 tokenizer 編碼成 token ID。

呢個庫定位相當清晰:佢只處理格式轉換同 prompt 拼裝,模型推論、工具執行、HTTP 傳輸呢啲都交返俾呼叫方自己負責。換句話講,開發者可以揀任何推論引擎,再喺外面搭一層 recipe 做「翻譯員」,咁就可以用同一個後端撐起多個對外 API 端點。對於正在從 Ollama、vLLM 或自家 CUDA 服務過渡到 DeepSeek 模型嘅團隊嚟講,等於慳咗大量重複開發。

它對 DeepSeek V4 同 V4.1 有針對性處理:V4.1 支援圖像(會用 OpenCV 預處理),V4 則會把圖片替換成 [Unsupported Image] 字串,避免下游出錯。Thinking mode 方面亦照顧周到,無設定時自動補 8192 tokens,開啟 thinking 預設 65536,開到 max effort 就去到 131072。Structured output 同樣齊全,Chat Completions 嘅 json_schema、regex,以至 Responses 嘅 text.format 都做咗驗證同轉寫,並會喺 InferenceOptions 揀選對應嘅 OutputConstraint,畀呼叫方決定要唔要開 constrained decoding。

工具支援亦係重點之一。Function tools 全部覆蓋,V4.1 仲額外支援 Messages 嘅 deferred tool loading 同 Responses 嘅 client-executed tool search,對做 agent 框架嘅人特別有用。串流方面,token usage 會回報 reasoning_tokens,logprobs 喺 Responses 格式下亦會被轉成 InferenceOptions。不過要留意,圖片抓取組件 ReqwestImageFetcher 預設連任何地址都得,如果服務面向不可信來源,記得裝返 DestinationFilter。

GitHub

Categories: 開源, Agentic, 模型, NVIDIA, DeepSeek, API, Image, 框架, 工具, Ollama, Python, 庫, Tokenize

MT-Forcing:多輪改圖守住細節唔再走樣

連續改同一張圖時,主體、紋理與構圖往往會慢慢偏離;MT Forcing 以多輪訓練與教師引導改善這類累積錯誤。

MT Forcing teaser

連續要求「改杯色、加條紋、再調光線」時,圖片往往未到最後一輪已經失真。MT Forcing 是針對多輪圖像編輯的訓練框架,配合自迴歸擴散模型,減少每輪修改帶來的漂移。

方法把單輪 DMD(Distribution Matching Distillation)與 Teacher-Forcing Guidance 結合:學生模型逐步編輯自己生成的歷史,凍結的單輪教師則從原圖一次套用累積指示,提供分布層面的引導。參考真實編輯軌跡後,模型既要改善畫質,也要維持跨輪次內容關係。

  • 以自身多輪輸出作為訓練歷史
  • 引入單輪 DMD 改善視覺品質
  • 用 Teacher-Forcing Guidance 減少誤差累積
  • 展示最長十五輪及八輪編輯比較

官方程式碼要求 Python 3.11.13、NVIDIA CUDA GPU,以及指定 checkpoint、架構資源和擴充 U1.5 tokenizer;配置完成後,可在同一工作階段依序執行多個編輯提示。公開資料未交代完整硬件門檻、推理速度或標準化定量結果,因此較適合作為需要 NVIDIA GPU 的研究重現工具,而非直接比較成本已知的消費級服務。

它以 SenseNova-U1.5 作為相關基礎模型,並在多輪比較中加入 MT Forcing。對需要逐步修訂產品 concept、人物姿勢或場景細節的設計團隊,單輪教師可作品質參照。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 清華大學, 模型, 模型訓練, NVIDIA, Image, 影像模型, 框架, 工具, Python, Tokenize

SCOPE 讓文字提示詞按語意學習

文字轉圖像不再把同一分數平均分給每個字詞,SCOPE 按物件、數量與關係調整提示詞優化方向。

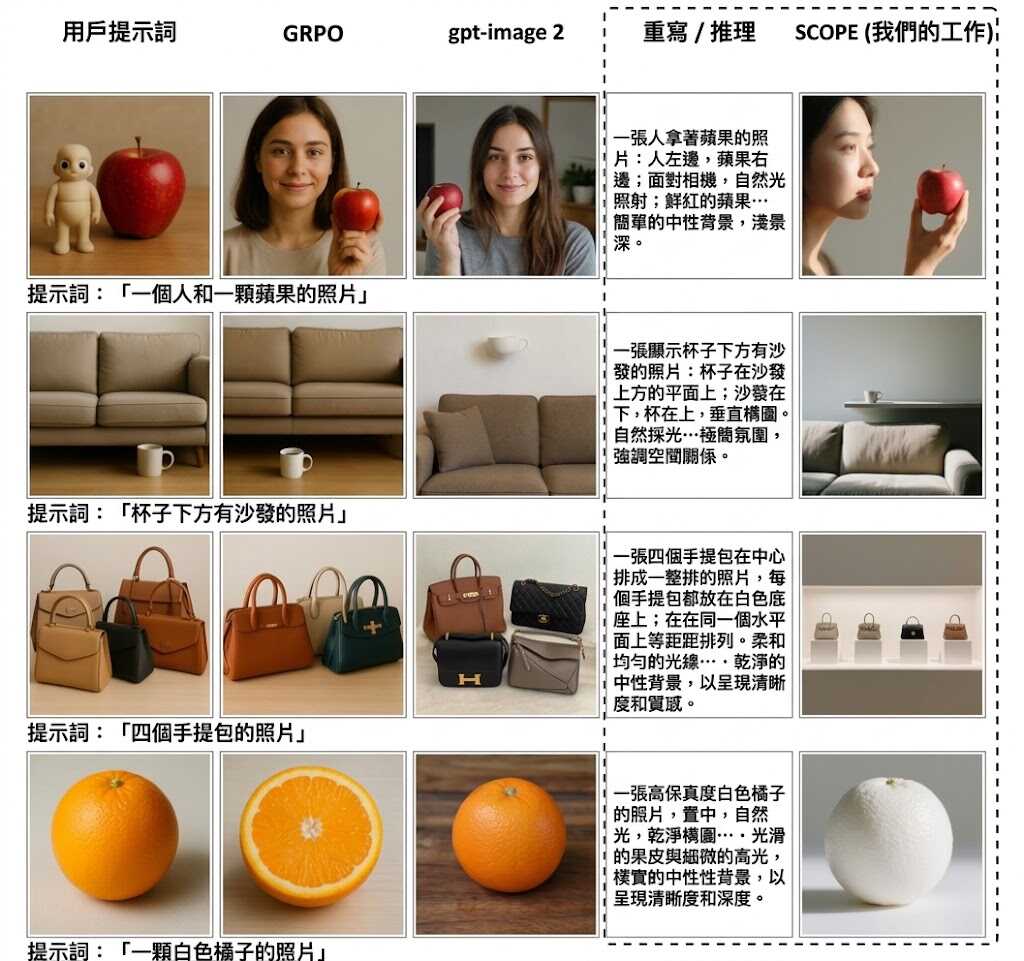
Uniform token GRPO versus SCOPE span credit.

當提示詞包含物件、數量、屬性和關係時,逐個 subword token 套用同一個圖像分數,往往難以知道哪段文字真正需要修改。SCOPE 是一個開源的文字轉圖像提示詞優化項目,利用 GRPO(Group Relative Policy Optimization)讓語言模型重寫提示詞,同時保留凍結的圖像生成器作評分基準。

每組提示詞會由 pi_theta 產生 N-1 個改寫版本,並加入原始提示詞作第 N 個成員;預設 N 為 8。Qwen-Image 以同一個 diffusion seed 生成 512 x 512 圖像,使用 20 steps 和 CFG 4.0,再由 GenEval 回傳 0 或 1,減少不同隨機結果對比較造成的干擾。

SCOPE 的差異在於把回饋由 token 層面提升至語意片語。項目會在每個 phrase 內池化 log pi_theta 與 log pi_old 的差值,將 span coefficient 限制在 0.8 至 1.2,再把片語 token 權重正規化至平均值 1;tags 和垂直線則維持權重 1。原始提示詞分數低於預設 tau 1 時,採用截斷 reward gap;達到門檻後,改用改寫群組的 clipped z-score。

  • 訓練流程:原始提示詞會參與評分及 advantage 計算,但不直接更新參數。
  • 策略穩定性:pi_old 是上一個 optimizer step 的凍結副本,第一步會與 pi_theta 相同。
  • 適合情境:需要改善物件數量、屬性或空間關係表達的文字轉圖像研究與實驗。

測試時可觀察 reward service 產生的圖像、logs/node-RANK/內的安裝與訓練記錄,以及每項工作使用的 service.token;該 token 權限設定為 0600。項目更接近研究型訓練框架,而不是即開即用的圖像生成介面,使用者需要準備 Qwen-Image、評分服務及足夠的生成資源,亦要留意 GenEval 的二元分數未必能涵蓋所有美學或語意品質。

GitHub

Categories: 開源, 模型, 模型訓練, Qwen, Image, 提示詞, 框架, Mac, Python, Tokenize

Multics:開源多玩家世界模型

Multics 是騰訊 ARC Lab 與港大合作的多玩家影片生成世界模型,靠分層通訊機制讓同一個訓練版本直接推廣到 6、8、10 人,玩家與鏡頭控制互不干擾。

Repository image for TencentARC/Multics

打機時如果有 4 個、6 個甚至 10 個玩家走在一起,畫面要保持連貫,又要讓每個人各自控制鏡頭與動作,舊做法往往一加人就 O(N²) 爆計,或出現互相干擾。Multics 正是針對這個卡位:來自騰訊 ARC Lab 與香港大學的開源世界模型,採用 Player → Group → Global 的分層通訊,動態根據最近鏡頭軌跡分組,限制無關事件直接混合。共享的 group-token 參數令用 4 人數據訓練的模型,可以直接推廣到 6、8、10 人而毋須重新訓練。

對於做多人遊戲原型、模擬訓練環境或敘事影片的團隊,這個項目直接省掉「人數一變就要重訓模型」的麻煩,同時降低自注意力計算量,GPU 開銷壓得較低。它的代價是依賴 NVIDIA GPU、CUDA 12.8 與 Linux 環境,安裝需用 uv 同步依賴,並從 Hugging Face 下載包含 VAE、tokenizer 與 4-player checkpoint 的完整推理包。

Repository 提供 inference.py 配合 YAML 配置,可選擇 4-player 範例或擴展到多人數測試,原始資料未列出具體的玩家數上限驗證結果,只說明同一個 4 人 checkpoint 能支援 10 人輸出。代碼以 Apache 2.0 授權,研究與商業應用皆可改作。

重點摘要:

  • 騰訊 ARC Lab 與香港大學共同開發的多玩家影片生成世界模型
  • 分層通訊機制降低注意力計算成本,避免無關玩家互相干擾
  • 共享參數設計讓 4 人訓練版本直接支援 6、8、10 人,毋須重新訓練
  • 推理需 Linux + CUDA 12.8 + NVIDIA GPU,模型權重經 Hugging Face 發佈
  • 適合多人遊戲畫面合成、模擬訓練、互動敘事等需要可擴展多視角的工作場景

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 騰訊, 模型, 世界模型, 模型訓練, NVIDIA, Video, 香港, Linux, Tokenize

GroundingPI 以 4B 視覺基礎模型連接感知與機械控制

GroundingPI 把視覺定位轉成可供機械系統使用的點和框,主打複雜場景下的精準感知與控制效率。

GroundingPI

要讓自動駕駛或機械人準確知道「要處理哪件物件、位置在哪裏」,單靠一般視覺語言模型仍可能在雜亂畫面和細小物件上失準。GroundingPI 屬於視覺 grounding foundation model,以 4B 參數模型處理定位問題,輸出可供後續控制使用的視覺結構。

模型以 visual primitives 為核心,將點和框表示成 shared vocabulary 中的 quantized coordinates,再配合 vision-language model、tokenizer、processor 和 custom model code。這種做法針對 VLA(vision-language-action)及 WAM(world-action models)常見的感知瓶頸,並讓 perceptual foundation 可以轉移到 autonomous driving 和 robotic manipulation。

  • 定位方式:同時支援點與框,適合指定目標及描述空間位置。
  • 模型規模:4B 參數,目標是在能力與運算成本之間取得平衡。
  • 評測結果:涵蓋 34 個 grounding benchmarks、11 種感知能力,對比 44 個基準模型平均達 73.68%,高於 GPT-6 Astra 的 71.54%。
  • 轉移價值:在 ID 和 OOD 評估,以及 action-data efficiency 方面,展示對自動駕駛和機械人操作的幫助。

對研究團隊而言,GroundingPI 不只是單次定位模型,亦可作為 System-1 foundation-model 的感知層,補足未必擅長精準 grounding 的通用視覺模型。項目提供 Hugging Face 模型及 Demo,並列出 vLLM、Transformers backend、OpenAI-compatible API 和 JSONL batch annotation 工作流;不過提供的儲存庫資料未交代完整硬件需求,部署前仍需按文件確認環境。

研究重點同時放在 pretraining scale 和 data composition 如何影響 grounding 及轉移效果。需要即時視覺定位、閉環控制或希望減少 action data 的自動駕駛、機械人及 embodied AI 團隊,會較容易從這個模型的感知能力受益;純文字或一般影像分類工作則未必能直接發揮其價值。

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 香港科技大學, 北京大學, 清華大學, 模型, 視覺模型, 多模態模型, 模型訓練, API, Image, VLA, World-Action Model, Robotic, 香港, 庫, Tokenize

TokenRouter 讓多個模型逐 Token 協作

同一個回答可按 Token 在大小模型之間切換,TokenRouter 以專用服務引擎處理路由、交接與批次調度。

TokenRouter Logo

同一個回答需要小型模型快速生成,亦要大型模型處理指定 Token 時,服務系統要同時應付模型切換、不同步解碼和不規則請求。TokenRouter 屬於開源 serving system,專門處理 token-level LLM routing,讓多個模型在單次回應內協作。

開發者只需透過 route()、send() 和 receive() 描述路由邏輯,系統便負責請求交接、Tokenization、Detokenization、批次調度及模型執行。它採用獨立 subserver、非同步 model-centric execution 和 delayed batching,讓快模型繼續解碼,慢模型處理被路由的 Token;Python 3.10、YAML 配置、OpenAI-compatible chat completions 和 Python engine 則提供了較直接的測試入口。

  • 支援同一回應內按 Token 或片段切換模型
  • 內置 scheduler、model executor 及 CUDA graph 支援
  • 可用單機或跨節點配置不同模型
  • 涵蓋五種路由算法、三類工作負載及多組模型配對

測試結果顯示,TokenRouter 在不同算法、工作負載和模型配對下,解碼吞吐量較現有系統高 2.01–64.15 倍。這個差距會受硬件、批次規模、路由頻率及模型組合影響,不能直接視為所有場景的固定提升;項目提供的 Qwen3-0.6B 與 Qwen3-32B 配置,較適合用來理解小型與大型模型協作的流程。

需要研究 token-level routing、測試推理工作流,或營運多模型服務的團隊會較容易受益。TokenRouter 把路由策略與執行引擎分開,保留較大彈性,但亦意味着使用者仍要自行設計算法、準備模型節點和調校分散式通訊,並非即插即用的模型服務平台。

項目主頁 · GitHub

Categories: 開源, 模型, Qwen, NVIDIA, Python, Tokenize

ProAR 讓影片模型先想目標再生成

ProAR 把自回歸影片生成變成視覺推理流程,兼顧最終目標與中間步驟的合理性。

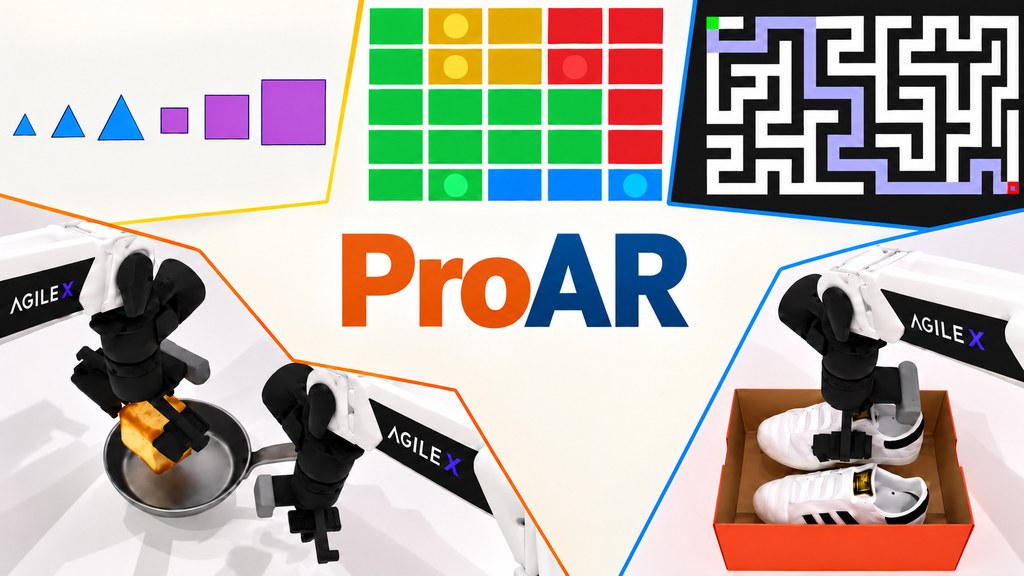
ProAR overview

當影片模型只按過去畫面逐步預測,畫面即使局部合理,也未必能完成指定任務。ProAR 屬於自回歸影片模型項目,透過 prospective reasoning 預測未來視覺狀態,處理長程目標與中間轉換容易失控的問題。

ProAR 以 Wan2.2-TI2V-5B 作為共享 backbone,加入兩條互補機制:outcome guidance 會一同預測未來 goal frame,讓目前 chunk 參考目標信念;transition guidance 則在訓練期間利用 predictor,令目前 hidden states 對齊乾淨的 next-chunk representation。前者偏向長距離規劃,後者補足短距離的狀態銜接。

• Outcome guidance 幫助生成結果符合任務目標
• Transition guidance 鼓勵中間步驟遵守時間及物理邏輯
• 推理時不需要真實未來畫面,訓練用 predictor 會移除
• 項目提供模型 checkpoint、ProAR-test 數據集及 VBVR-10Tasks 實驗配置

要測試項目,需要 Python 3.10、PyTorch 2.8.0,並把 Wan2.2-TI2V-5B 權重、VAE、T5 編碼器及 tokenizer 放到指定本地路徑;flash-attn 屬於可選的加速元件。這套流程較適合研究視覺推理、物理推演及 embodied intelligence 的團隊,未必是即裝即用的影片創作工具。

提供的資料確認了 AR 與 ProAR checkpoint,以及 VBVR-10Tasks 和測試數據集,但未列出足夠的數值結果,難以單憑儲存庫內容判斷提升幅度。推理時間會增加,換來模型在生成前預測目標及未來轉換;取捨是否合理,要視乎任務是否重視步驟有效性多於生成速度。

項目主頁 · GitHub · 模型

Categories: 開源, 香港理工大學, AI productions, 模型, 模型訓練, 微軟, Video, 香港, 工具, Python, 庫, Dataset 數據集, Tokenize

Cloudflare Clef 多模態決策模型:直接輸出分類、路由與審核概率

Clef 將文字、JSON、影像或影片轉成結構化概率,毋須生成答案再解析。

Og image

面對發票分類、服務故障分流或影像核查等工作,Clef 可以直接為每條問題的可選答案計算概率,省去生成自由文本及再解析輸出的步驟。這個 27B 多模態決策模型基於 Qwen/Qwen3.8-27B 微調而成,能同時處理文字、JSON、影像及影片,並以單次 forward pass 回傳結果。

模型保留 Qwen/Qwen3.8-27B 的語言及視覺 backbone,再接上 joint schema head。這個小型 Transformer head 會讀取 backbone 的最終 hidden states,把狀態中的證據路由到每條問題,然後聯合計算所有選項的 logits;每條問題獨立套用 softmax 後,便可取得各選項概率。輸出不是自然語言,而是 choice、score 或 noul(true/false)等結構化結果,適合交由工作流程或 API 直接使用。

  • state 可接受字串或 JSON,問題支援 choice、有序的 score 及 noul。
  • images 和 videos 可與文字資料混合,文字及多模態記錄亦可放在同一批次處理。
  • encode_record 預設 max_length 為 16,384 tokens,亦可透過 max_state_tokens 限制狀態長度。
  • 模型檔案包括分片 safetensors、joint_head.safetensors、處理器設定及 joint_schema_model.py。

官方測試環境是單張 H200,配合 torch 2.11、transformers 5.10.2 及 pillow。

Clef 的取捨在於輸出控制性高,但用途受制於預先定義的問題、選項及 criteria,並非通用聊天模型。它與原始 Qwen/Qwen3.8-27B 的差異,是加入 joint schema head、記錄編碼及 SystemOne 介面,將生成式模型改造成可批量回答固定決策問題的模型;較小、較快的 Clef-Flash 則另行提供,頁面沒有交代兩者的參數規模或精度差異。Apache-2.0 授權及 Jev/SystemOne 相容 API,令它較適合整合到分類、路由、合規檢查及多模態審核流程。

模型

Categories: 模型, 多模態模型, Qwen, Tokenize

YuE2 補上真實音訊 Tokenizer,支援歌曲翻唱微調

YuE2取得音訊編碼與真實錄音適配能力,可將自家錄音轉成語義碼,再微調歌手風格。

Og image

當你餵給 YuE 一段參考音訊(例如某歌手的演唱片段或特定樂器風格,要求接續生成)時:必須先用 Tokenizer 將參考音訊「壓成代碼」傳入模型。若 Tokenizer 品質不佳,音色在第一步壓縮時就失真了。

這個 v4 工具能更高保真地將輸入聲音轉為 Token,讓後續模型捕捉到的音色特徵更貼近原音。

錄音轉換、歌手風格微調和歌曲翻唱,原本受限於 YuE2 沒有隨附的 audio → semantic-token encoder。這個項目基於 m-a-p/YuE2-3B 及 m-a-p/MERT-v2-FullSong,加入音訊 Tokenizer 與 NAR-branch LoRA,讓 YuE2-3B 可以處理自家錄音,並以真實製作音訊調整解碼效果。

Tokenizer 取用 MERT-v2-FullSong 第 20 層特徵,先按音軌作 instance normalization,再以 8 層、d=512 的 Transformer,在 512-frame 視窗內轉換成 32,768 種 YuE2 semantic codes,特徵率為 25 Hz。留出歌曲測試的 top-1 exact match 為 16.1%,但近似 code 產生的聲音接近,NAR round-trip 聽感測試約達 95%。

  • tokenizer_head_joint_v4.pt、.safetensors、.bf16.safetensors:音訊編碼 head
  • nar_lora_joint_v4.pt、.safetensors、.bf16.safetensors:NAR 解碼分支 LoRA
  • _comfyui.safetensors:配合 ComfyUI 的 YuE2 權重布局
  • LoRA rank 為 32,覆蓋 28 層 NAR attention、MLP,以及完整替換的 vae2llm 和 llm2vae

.bf16 版本約為完整精度檔案的一半,head 與 fp32 的輸出一致率為 98.6%。項目附有 scripts/ckpt_io.py、訓練迴圈和推論腳本;ComfyUI 可把 LoRA 載入 YuE2 checkpoint 的 MODEL 輸出,強度設為 1.0,CLIP 輸入不受影響。頁面沒有提供 GGUF 檔案、檔案大小、上下文長度、Ollama、LM Studio、llama.cpp 或 MTP draft speculation 支援資料,亦沒有列出可供選擇的量化級別。

模型先以 4,765 首 YuE2 自行生成歌曲訓練,再適配真實音訊;因此它的價值集中於提升真實錄音的編碼與 NAR 解碼,而非取代 YuE2-3B 的完整生成能力。授權為 CC-BY-NC-4.0,商業用途需要另行確認授權條件。

模型

Categories: 開源, ComfyUI, 模型, 模型訓練, Audio, 工具, 廣東話, Tokenize