CoSTA:壓縮語音生成序列,提升對話模型推理速度

語音對話模型可以先產生較短的語音 token 序列,再還原成原有格式的合成波形。CoSTA 在中英文基準測試中提升生成速度,並保留原有語音 tokenizer 和 decoder。

CoSTA separates compressed speech-token generation from original-token synthesis.

語音對話模型要逐個生成語音 token,序列較長時會拖慢回應。CoSTA 是一套語音模型適配方法,透過壓縮生成序列加快推理,同時保留原有語音 tokenizer 和 decoder,讓壓縮後的 token 可在合成波形前還原。

CoSTA 使用 byte-pair encoding(BPE)學習合併語音 token,並以原有 token 的 embedding 和 LM head 權重平均值初始化新增詞彙。適配分階段進行:先訓練發音,再調整語音對話輸出,讓模型生成交錯的文字與語音內容。它改變的是生成時使用的 token 空間,而非取代負責語音合成的原有元件。
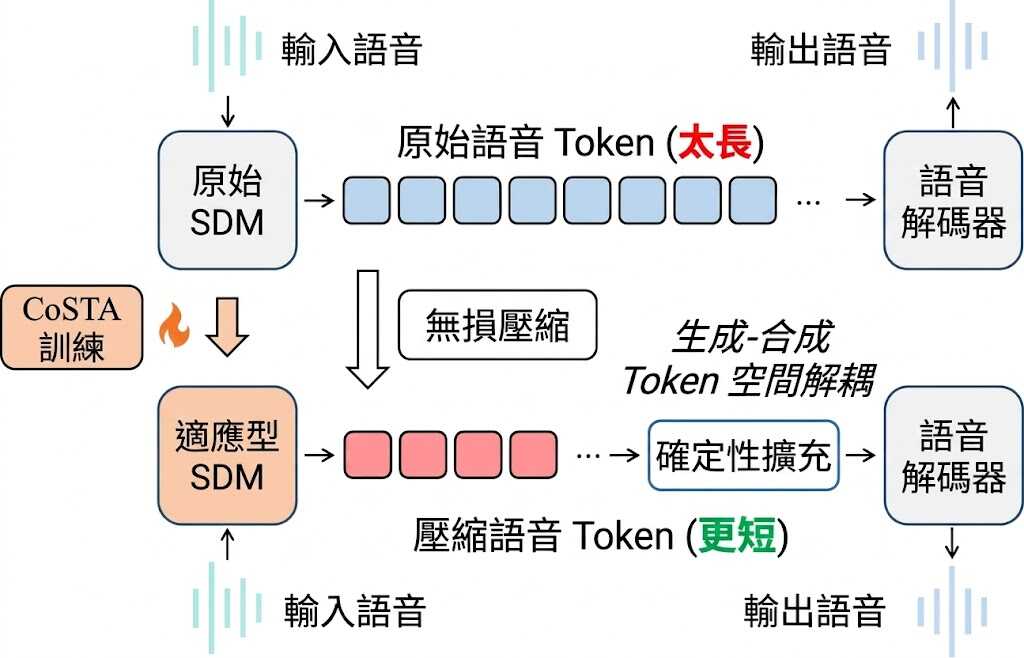
在中英文基準結果中,CoSTA-ZH 的壓縮序列保留原 token 數量的 66.81%,擴展後語音 token 生成速度為每秒 101.99 個;CoSTA-EN 分別為 70.17% 和每秒 99.05 個。兩者相對 Step-Audio 2 mini 的速度為 173.63% 和 165.94%;這些結果反映特定基準測試,不能直接當成所有模型或硬件上的延遲保證。

對已有語音對話模型、希望提高回應速度而不重建語音合成流程的研究團隊,CoSTA 提供了一條可評估的適配路徑。GitHub 提供程式碼與論文連結,但模型權重及資料集仍標示為即將推出,現有資訊亦未列出完整安裝及測試流程。

  • 壓縮自回歸生成用的語音 token 序列,再於合成前確定性還原。
  • 保留原有語音 tokenizer 和 speech decoder。
  • 中英文基準測試均報告高於 Step-Audio 2 mini 的生成速度。
  • 權重與資料集尚未提供,現階段難以直接復現完整流程。

項目主頁 · GitHub

Categories: 開源, Embedding, 模型, 模型訓練, Audio, 語音, Tokenize

Google Foresight:會議筆記與個人資料留在 Mac

Foresight 在 Mac 本地聆聽會議、整理筆記,亦能按你的檔案即時回答問題。

開會時只需記下零碎提示,Google AI Edge Foresight 便可配合本機轉錄內容整理成較完整的會議筆記。工具支援 Google Meet、Zoom,以及面對面或離線對話,音訊和文字都在 Mac 處理,不必上傳雲端。

Foresight 亦能連接本地項目資料夾、Google Drive、參考文件、圖表、網頁連結和日曆,建立與工作相關的背景資料。對話期間,它可透過聊天檢索內容;Live Assistance 更會聆聽問題,在相關資料出現時主動顯示附有引用來源的 context cards,減少會議前準備和反覆確認資料的時間。

技術核心包括 740M 參數的 EmbeddingGemma 2。這個 on-device multimodal embedding model 會把文字、圖片、影片和音訊映射到同一向量空間,支援跨模態語意檢索;配合 Gemma 4,可在裝置上建立即時的 Retrieval-Augmented Generation(RAG)流程,避免網絡延遲。

  • 會議轉錄、音訊與檔案留在 Mac
  • 支援影片會議、面對面及離線對話
  • 可把速記提示整理成完整筆記
  • 支援跨文字、圖片、影片和音訊檢索
  • 具備聊天及 Live Assistance 兩種取用資料方式

頁面提供 macOS 下載入口。需要高度重視資料私隱、又經常在多個本地檔案之間切換的人,較容易感受到這種本機 AI 工作流的便利。

項目主頁

Categories: AI productions, RAG, Embedding, 多模態模型, Google, Gemini, Video, Image, Audio, 工具, Mac

ScientificSlop:AI 論文不只要讀得順,也要檢查證據是否接得上

SciSlop 把焦點放在 AI 論文的論證、結構與研究材料,並以 390 組人類與 AI 論文測試能否辨認科學內容中的空洞之處。

Repository image for yerimoh/ScientificSlop

一篇論文即使句句通順,論點、方法和證據仍可能接不上。SciSlop 是一套衡量 AI 生成論文科學內容品質的評估工具,從結構、論證和研究材料三個面向檢查六種問題,而不是只判斷文字像不像 AI 所寫。

配套的 SciSlopBench 收錄 390 組 AI 生成論文與人類撰寫論文,讓研究者比較不同評分方法分辨兩者的能力。已釋出的分數中,SciSlop 的配對準確率為 0.859;作為基準的 Binoculars 為 0.687。這是特定測試集上的結果,不能直接解讀成工具能判定任何論文真偽。

另一部分 SciSlopHarness 會引導固定的大型語言模型修改論文,但只在實驗紀錄能支持修改時才動筆。這個限制有助避免模型為了讓文字看起來更好而擅自改變研究主張;不過,現有說明沒有提供足以判斷修改品質的完整數字。

儲存庫同時提供基準資料、評估程式、比較用的偵測器與自動審稿系統,以及分析 2017 至 2026 年 ICLR 審稿分數和決策的程式。資料以三個 Parquet 表格釋出;安裝 Python 依賴後,可先讀取分數表重算配對準確率與 AUROC,再按文件流程重跑部分確定性指標。GPU 套件屬可選項,模型相關指標則可能需要外部模型呼叫。

  • 六項指標涵蓋結構、論證與研究材料。
  • SciSlopBench 包含 390 組配對論文。
  • 公開分數中的配對準確率為 0.859,高於 Binoculars 的 0.687。
  • SciSlopHarness 只在實驗紀錄支持時才修改內容。

對研究團隊而言,這套工具適合用來檢查 AI 輔助寫作是否削弱論證連貫性,也能作為研究論文評估方法的測試材料。項目應視為研究用途,不能取代專家對方法、證據及引用的審閱。

項目主頁 · GitHub

Categories: 開源, Embedding, 模型, 工具, Python, 庫, Dataset 數據集

Audio8 ASR Infinite:持續運行語音轉錄

Audio8 ASR Infinite 以可調音訊時鐘和延遲,處理長時間串流轉錄的反應速度與記憶體增長問題。

Repository image for Edge0-AI/Audio8-ASR-Infinite

長時間錄音、直播字幕或語音助理最怕轉錄愈跑愈慢,甚至因上下文累積而出現漂移。Audio8 ASR Infinite 屬於原生串流語音識別模型,透過 rolling KV cache 將記憶體和延遲維持在有界範圍,支援 24/7 連續轉錄;目前支援中文及英文。

模型可在 80、120、160 ms 音訊時鐘之間選擇,每秒作出 12.5、8.3 或 6.25 次決策,並可將 transcription delay 設於 240 至 560 ms。延遲愈低,回應愈快;較長延遲則有較多時間累積語境。Semantic VAD 亦會分辨思考停頓、口吃和真正句末,減少傳統 acoustic VAD 過早截斷語句的問題。

架構承接 Voxtral realtime audio architecture 和 DSM-style streaming:Causal Audio Tower 以 Voxtral Realtime 4B 為初始權重,Audio Projector 及 Frame Length Embedding 由隨機初始化訓練,Decoder 和 LM Head 則採用 Qwen2.5-3B-Instruct。項目仍屬 preview release,後續會在同一 frame grid 加入即時語義感知。

  • 適合直播字幕、長時間會議紀錄及持續運行的語音介面
  • 可按硬件資源和回應要求調整音訊時鐘及延遲
  • 目前資料未提供完整安裝流程、硬件需求或公開 benchmark 數據
  • 使用 adapted vLLM build 才能對應無限長度串流運行

對需要低延遲、不中斷轉錄的團隊,這個模型的價值在於把速度、延遲可調性和長時間穩定運行放在同一個架構內,但正式採用前仍要自行測量廣東話支援、GPU 佔用及不同時鐘組合的辨識準確度。

項目主頁 · GitHub · 模型

Categories: 開源, Embedding, 模型, 模型訓練, Audio, 語音, Dataset 數據集, 廣東話

tactile:讓電子皮膚學懂接觸位置的拓撲感知模型

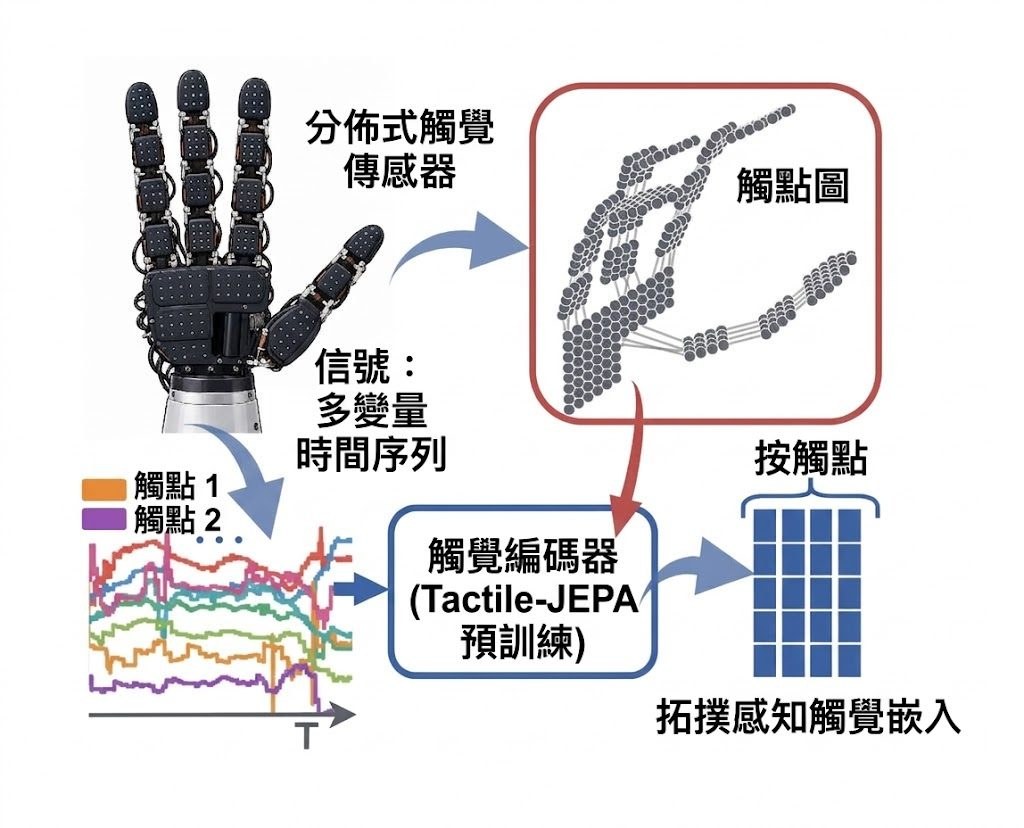
Tactile-JEPA 把分散式觸覺感測器的連接關係納入預訓練,令同一套表徵可支援力量、姿態及動作判斷。

Tactile-JEPA maps distributed tactile signals to topology-aware per-taxel embeddings using the taxel graph during pretra

電子皮膚面對的難題,不只是讀取感測數值,而是要理解哪些 taxel 彼此相鄰、接觸訊號如何在感測表面分布。Tactile-JEPA 屬於觸覺表徵學習模型,透過感測器拓撲預測被遮蔽的 taxel embedding,將原本分散的時間序列轉成可供下游任務重用的表示。

它沒有把感測面硬套成規則影像網格,而是沿着 sensor connectivity graph 抽取局部及全局遮罩;預設組合包含兩個 local masks 和兩個 global masks,兼顧局部接觸細節與整個表面的狀態。模型由 context encoder、exponential-moving-average (EMA) target encoder 和 predictor 組成,predictor 預測隱藏 embedding,再以 mean squared error 對齊 target encoder 輸出;預訓練完成後,凍結的 target encoder 可配合 task-specific heads 使用,而下游編碼不再需要圖結構。

項目涵蓋 Xela magnetic hand skins、piezoresistive tactile socks,以及雙手 DECO-50 等不同感測器形態,支援 force estimation、in-hand 及 full-body pose estimation、object/action classification 和 visuo-tactile policy learning。首頁報告指,模型相對各任務最強基線,in-hand orientation error 減少 20.8%,force estimation error 減少 6.3%,但預訓練模型及論文連結仍標示為 TBD,結果重現程度要視乎後續資源是否補齊。

測試需要 Linux、Conda 及具 CUDA-compatible driver 的 NVIDIA GPU,並由儲存庫建立環境、以 editable package 方式安裝。三個資料集合共涉及數百個 taxels,下載及整理成本不低,較適合研究觸覺感知、機械人操作或 visuo-tactile learning 的團隊;只需要單一感測器分類器的工作,未必能抵銷圖結構整理及 GPU 預訓練成本。

  • 以拓撲遮罩取代影像式規則遮罩,貼近不規則電子皮膚的實際排列。
  • Local 與 global targets 同時捕捉接觸細節及整體感測狀態。
  • 預訓練 encoder 可服務力量、姿態、物件及動作等多種下游任務。
  • 圖結構只參與預訓練,之後的編碼流程較容易接入不同任務。

項目主頁 · GitHub · 模型

Categories: 開源, Embedding, 模型, 模型訓練, Robotic, 庫, Dataset 數據集

LTX-2.5 加入多圖與聲音參考控制

想令影片中的人物、物件和聲音更一致,這個 ComfyUI 擴充項目把多重參考整合到同一條工作流程。

Repository image for liconstudio/ComfyUI-LTX2.5-MSR

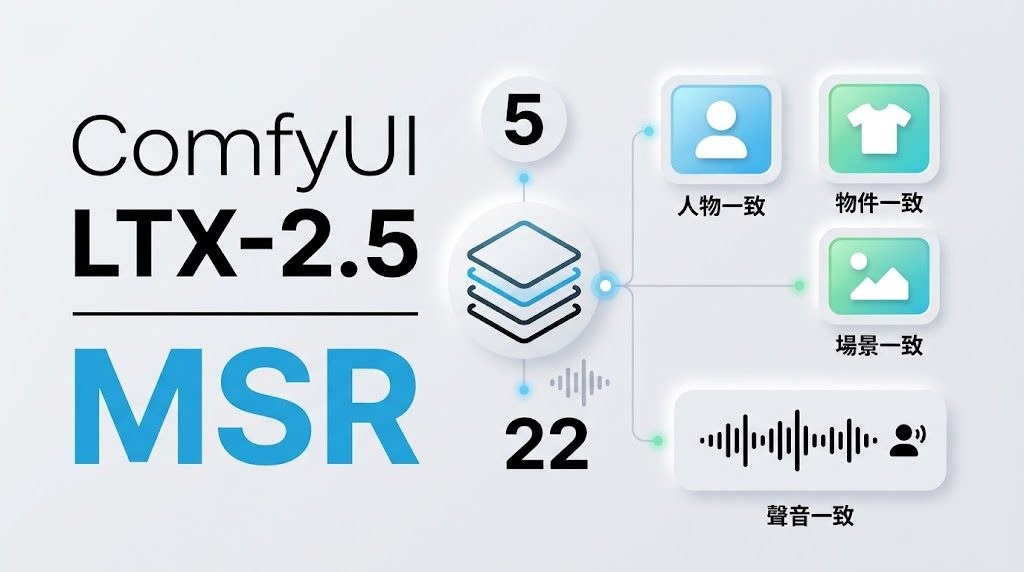
要在 LTX-2.5 生成影片時維持多個人物、物件或場景的連貫性,單靠文字提示往往不夠。ComfyUI-LTX2.5-MSR 是一個 ComfyUI 擴充工具,透過 MSR LoRA 把最多五張獨立編碼的參考圖片加入影片 latent;配合 AVref LoRA,還可為最多兩位說話者加入聲音參考。

它處理的不是普通圖片拼接,而是保留 MSR(Multiple Subject Reference)的訓練方式:每個參考影像都有 learned slot embedding,參考 token 會預先加入模型輸入,並配合固定排序及連續負時間位置,讓 LTX-2.5 的 self-attention 讀取人物、衣物、物件和場景資訊。參考圖片會自動調整大小、置中裁剪及以白色填補,亦支援 tiled VAE encoding。

v1.2.2 將圖片和聲音參考集中到同一個 LoRA loader 及 Reference Guide。兩個 audio latent 可分別配對 pic1 和 pic2;缺少某段聲音時,對應時間窗會保持空白,不會令後面的參考位置前移,並可選擇 25 或 33 幀的圖片參考長度。README 同時提供 V2 範例工作流程,展示加入聲音參考的兩階段 sampling 及 latent-upscale refinement。

使用前需要 LTX-2.5 原生模型、符合要求的 MSR 或 AVref LoRA,以及 ComfyUI 的模型、conditioning、latent、VAE、sampler 和 AV 節點。LoRA 必須包含 reference_slot_embedding 權重,普通 LoRA 會被拒絕;項目資料未提供完整安裝指令或硬件性能測試,因此生成速度、顯存需求及最終一致性仍要按本地模型、解析度和參考數量自行驗證。

  • 最多五張圖片參考,支援人物、物件、背景等不同角色
  • AVref LoRA 可加入最多兩位說話者的聲音參考
  • 稀疏 audio slots 保留絕對時間位置,不會重新排列後續參考
  • 適合單階段生成,也可接入兩階段 latent-upscale 工作流程

GitHub · 模型

Categories: 開源, ComfyUI, AI productions, Embedding, 模型, 模型訓練, Google, NVIDIA, Video, Image, Audio, 工具, 語音, LTX, 蘋果, LoRA

Dream-RSI:讓 AI 先在探索紀錄中演練,再投入昂貴的搜尋

Dream-RSI 把 AI 過往探索過程變成可重播的模擬環境,讓新策略先離線比較,再挑選勝出者投入下一輪搜尋,減少試錯成本。

Google

當 AI 要花數千輪提出和評估方案,探索方向選得不好,計算資源便會浪費在無效搜尋上。Dream-RSI 是一套用來改進 AI 探索策略的遞迴自我改進框架,讓策略先在既有探索紀錄中演練,再決定是否投入昂貴的線上搜尋。

它不另建一個學習出來的世界模型,而是把代理過往建立的探索樹當成可重播的模擬器。系統在線上收集搜尋歷史,再離線測試多個候選策略;選出的策略才會部署到下一輪,並帶回新的探索紀錄,逐步擴大可供演練的經驗池。這做法省去逐一實跑候選策略的成本,但模擬範圍受限於過往探索到的路徑,未曾出現的情況仍須在線上驗證。

目前公布的測試涵蓋演算法工程、數學最佳化及 GPU kernel 工程,共八項任務。在演算法工程中,與 Recursive Fixed Exploration 相比,下游執行速度提高 1.22 倍,探索計算量減少 1.74 倍,呼叫次數比 SimpleTES 少 162 倍;GPU kernel 的四項測試全部改善,同等預算下效能提高 2.09 倍。數學最佳化則有三項中的兩項達到或超越所選基線,結果仍需按任務解讀,不能視為所有搜尋問題都會有相同收益。

這套方法較適合需要長時間、多輪探索的演算法與工程研究團隊,尤其是每次線上評估成本高昂的工作。程式碼仍在準備發布,現階段可閱讀技術報告與論文了解方法和結果;儲存庫尚未提供可直接安裝執行的公開版本。

  • 探索樹被重用為策略演練環境,不必為每個候選策略重新執行完整搜尋。
  • 每輪勝出的策略會投入線上搜尋,並補充新的探索歷史。
  • 已測試三個領域、八項任務,GPU kernel 測試四項全有改善。
  • 模擬器只涵蓋已探索的搜尋空間,公開程式碼仍在準備中。

項目主頁 · GitHub

Categories: 開源, Embedding, Google, Gemini, 框架

Flash-dLLM 讓擴散式語言模型解碼更快、更省記憶體

Flash-dLLM 把 KV-cache 管理和並行解碼放在同一套推理框架處理,減少擴散式語言模型反覆搬移資料造成的速度損失。

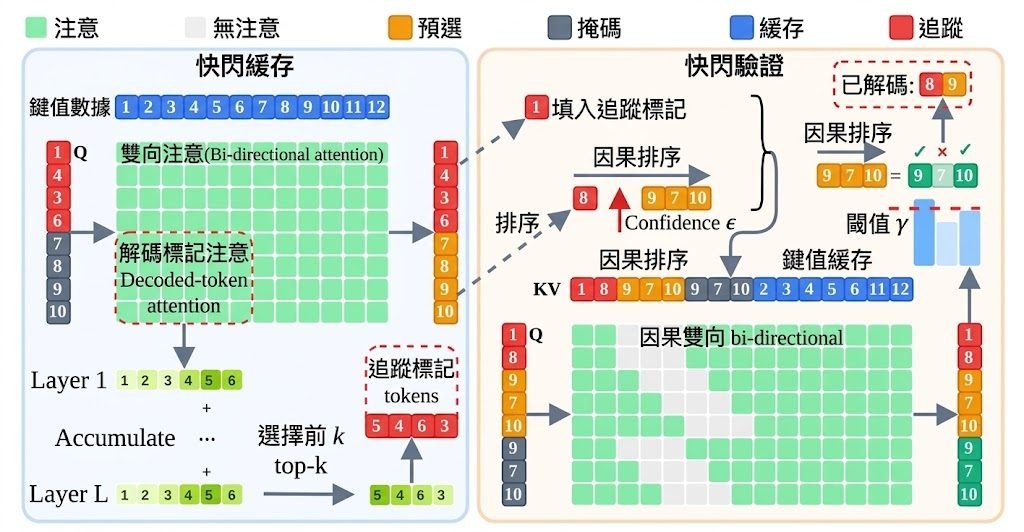
Flash-dLLM overview: Flash-Cache selectively refreshes tracked tokens, while Flash-Verify checks draft predictions using

擴散式語言模型每輪去噪都可能同時產生多個 token,但反覆更新 KV-cache 會令 GPU 花大量時間讀寫資料。Flash-dLLM 屬於免訓練推理加速框架,針對這個記憶體瓶頸提升解碼速度,亦保留可調校的準確度與吞吐量取捨。

Flash-Cache 以融合式 Triton kernel 一次處理 QKV projection、rotary positional embedding(RoPE)及 cache writes,並透過 block-scheduled attention 支援批次內不同查詢長度。它只刷新新解碼 token 及按 attention importance 選出的少量關鍵位置,避免每輪重算全部內容。

Flash-Verify 再利用同一個 diffusion model 同時擔任 drafter 和 verifier,毋須額外模型或訓練;draft token 與 [MASK] token 會透過兩種視圖驗證,符合信心門檻的預測可一併接受。

• LLaDA-1.5 測得 148–211 tokens/s
• 比無 caching 的 greedy decoding 快 22.3 至 148.2 倍
• GSM8K 和 HumanEval 比 Elastic-Cache 快 5.1 倍及 11.0 倍
• GPU 記憶體約比 Fast-dLLM 少 48%,可擴展至 batch size 32

這個項目適合研究 diffusion LLM 推理、GPU kernel 或高吞吐量服務的團隊。使用前需按儲存庫提供的環境及模型設定進行安裝和 evaluation;結果會受 GPU、批次大小、信心門檻及模型支援程度影響,數字未必能直接套用到其他 dLLM。

項目主頁 · GitHub

Categories: 開源, Embedding, 模型訓練, 框架, 庫

physics:拆解 Wan2.1 的物理失誤

籃球彈跳變成半空漂浮,問題可能早在去噪頭幾步由注意力決定。這個研究以 RoPE 調整改善影片動態。

teaser

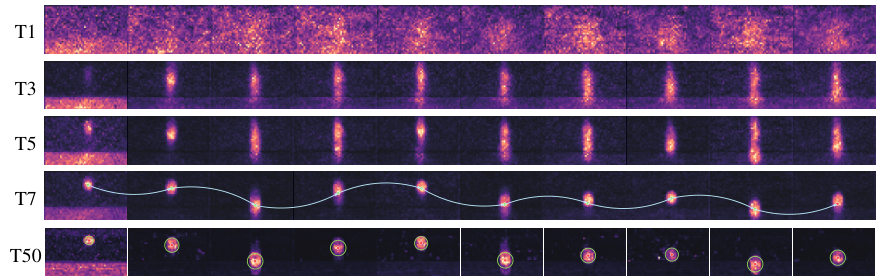
一個籃球由半空跌落後,理應撞地再彈起,Wan2.1-T2V 卻可能生成漂浮、突然停頓或半空反彈。這個 GitHub 項目屬於影片生成模型的可解釋性研究,實際處理的是 text-to-video diffusion models 如何在早期去噪階段規劃物件軌跡,以及錯誤位置為何會一路鎖定。

研究把視線集中在 Wan2.1-T2V-1.3B 的最初五個去噪步驟,透過 video-to-object-token cross-attention 追蹤物件位置,再配合 convergence speed 和 causal contribution 找出負責形成軌跡的 attention heads。分析指出,Self-attention 中的 Rotary Position Embedding (RoPE) 會令空間注意力衰減過快,早期錯誤候選位置因此壓過鄰近影格較合理的路徑。

修正方法不依賴外部物理模擬器或額外 foundation-model teacher,而是在早期步驟降低 height/width RoPE frequency,測試時前五步使用 λ^{h/w}=0.70;需要訓練時則以只作用於 self-attention 和 cross-attention 的 Low-Rank Adaptation (LoRA) 配合 λ^{h/w}=0.75。LoRA 設定為 r=64、alpha=32,並以首 10% 去噪步驟佔 0.9 機率的混合 timestep sampler 加強早期學習。

測試這個項目時可沿用 Wan 官方模型與提示詞,以不同 random seeds 比較原模型、training-free 頻率調整及 LoRA 版本的籃球跌落等片段;程式透過 runtime monkey patches 修改行為,不需要改動官方 Wan source。提供的資訊確認有 training-free 和 training-based 實驗,但未列出完整數值指標,因此更適合視為機制分析與可重現的研究原型,而非已證明能處理所有物理場景的通用修補方案。

  • 物件軌跡主要在最初五個去噪步驟形成
  • Cross-attention 負責引入物件語義,self-attention 協助選擇候選區域
  • RoPE 空間衰減過強,會令錯誤位置過早固定
  • 可用早期頻率縮放,或加入只改注意力層的 LoRA
  • 適合研究影片生成、模型可解釋性及物理一致性的團隊

項目主頁 · GitHub

Categories: 開源, AI productions, Embedding, 模型, 視頻模型, 模型訓練, Video, 提示詞

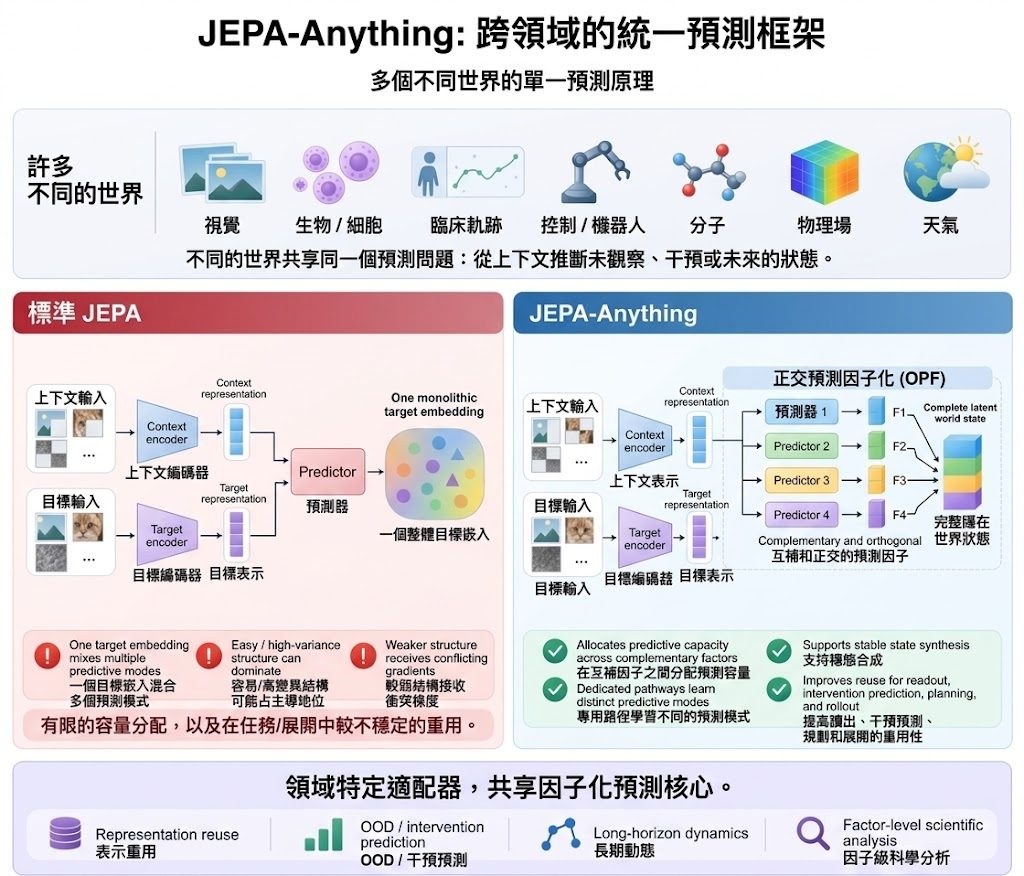
JEPA-Anything 一套預測框架打通不同世界模型

JEPA-Anything 提出 domain-agnostic 框架,把細胞、分子、物理場、控制環境、臨床軌跡等差異極大的世界,交給同一套預測原理學習。它用 Orthogonal Predictive Factorization 取代單一目標表徵,嘗試讓跨領域的世界模型有共享接口。

JEPA-Anything overview: cross-domain predictive learning and Orthogonal Predictive Factorization

世界模型的難題之一,是不同領域看似南轅北轍,卻共享同一個核心問題:能否用同一套預測學習原則,去處理完全不同的世界?Gen-Verse 的 JEPA-Anything 瞄準的正是這個長期卡位。它以 joint-embedding predictive architectures(JEPAs)為基礎,把傳統那塊「單一、整塊」的目標表徵拆開,改由一種叫 Orthogonal Predictive Factorization(OPF)的做法,把潛在的 world state 切成多個互補的預測因子,每個因子各自走一條預測路徑,最後再重組回完整狀態,作為下游讀取、干預預測、規劃與多步 rollout 的接口。

對研究者與工程團隊而言,它的價值在於允許不同領域保留各自的觀測、context–target 結構與編碼器,卻共享同一個預測核心與潛在狀態接口。換句話,領域不必共用同一個編碼器,也不必共用同一組權重,卻仍能復用同一套建模邏輯。框架內部除了可重用的 projection、objectives、baselines、representation diagnostics 外,也提供任務規格驗證與實作 scaffold 工具,並附上一個可控動力系統作為起步範例,方便團隊在自己的領域落地。

相較於針對單一領域訓練的 world model,JEPA-Anything 取捨的方向是放棄「一套權重打天下」的野心,改為提供一個結構化的共享接口與預測路徑。它對於需要把生物干預、物理定律等實驗訊號接回模型內部做分析的場景尤其有用,同時讓 out-of-distribution 預測與長程 rollout 有更清楚的表示基礎。模型權重與評估可在 Hugging Face 上的對應頁面取得。

GitHub

Categories: 開源, Embedding, 世界模型, 模型訓練, 框架, 工具

Page 1 of 6
1 2 3 … 6