SeMo3D:只重建指定區域,統一 3D 生成、編輯

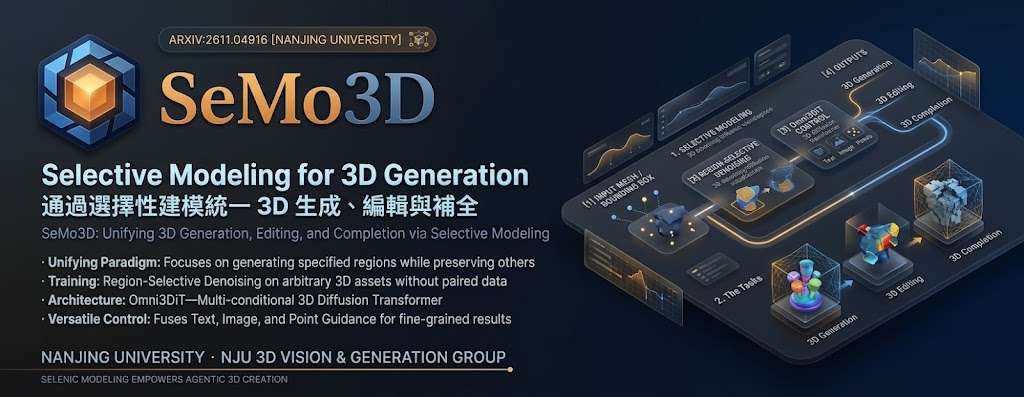
修改 3D 模型時,保留不需要改動的部分,可以減少整件資產重新生成造成的不一致。SeMo3D 將生成、編輯和補全整合到同一套選擇性建模流程,並支援文字、圖像與點雲引導。

SeMo3D logo

修改模型的局部區域時,整件資產重新生成可能令原本不需更動的內容也走樣。SeMo3D 是一個 3D 生成與編輯模型項目,透過只合成指定區域、保留其餘部分,統一處理生成、編輯和缺失區域補全,適合需要維持模型其他部分一致的創作者及 3D 工作流程團隊。

它把三種任務視為同一個問題:選出要建立或修改的區域,並沿用其餘內容。生成時選取完整區域,編輯時選取目標區域,補全時則選取缺失區域;因此,模型不必為每項任務各自重新生成整件資產。訓練亦毋須成對的編輯或補全資料,研究團隊可從一般 3D 資源切分出選取區域與周邊內容來訓練。

訓練方法稱為 region-selective denoising,只在隨機選取、大小各異的區域加上雜訊並計算損失,讓同一模型共同學習三項任務。架構 Omni3DiT 是多條件 3D diffusion transformer,負責分辨需要建立與保留的區域,並融合圖像、文字和點雲引導,提供較細緻的控制。

SeMo3D 在三個基準測試中,於生成、編輯和補全各項任務均勝過當時的先進方法;生成支援多模態控制,編輯與補全則著重一致性及準確度。

  • 一套模型統一 3D 生成、編輯與補全。
  • 只合成指定區域,保留其餘內容。
  • 以 region-selective denoising 從一般 3D 資源訓練,毋須成對編輯或補全資料。
  • Omni3DiT 融合圖像、文字與點雲引導。
  • 支援以自然語言互動的 agentic 3D 建模。

項目主頁 · GitHub

Categories: 開源, 南京大學, Agentic, 模型, 多模態模型, 模型訓練, Image, Content Creator, 3D

VibeGame:把文字變成可試玩的遊戲

輸入遊戲構想後,VibeGame 會協調代理製作、審查及試玩,亦可按後續要求修改;目前聚焦 2D 網頁遊戲。

VibeGame system teaser

把文字構想變成可玩的 2D 網頁遊戲,再逐步修改玩法,是 VibeGame 這套多代理開發系統的工作。它適合遊戲原型製作,並非獨立模型;已開源的實作以 Phaser 為基礎。

Adversarial Agent Team 由統籌代理協調分工,將生成與審查分開,透過靜態審查及端到端執行驗證檢查成果。AI-native game engine 把項目表示為結構化文字,讓代理直接編輯,並以 frame-synchronous control 按自己的節奏逐幀試玩。

  • 支援 Claude Code 或 Codex,至少需要一款代理命令列介面(Command-Line Interface,CLI)。
  • Python 需要 3.12 或以上;未提供完整安裝流程。
  • 未列出處理器、記憶體、顯示卡或顯示記憶體需求,不能據此判定硬件門檻。

training-free self-evolution 會從成功項目提煉可重用骨架、模組及協作約定,累積開發知識而毋須重新訓練模型。示範涵蓋格鬥與地牢遊戲,但未提供量化成功率或效能比較;端到端 3D 製作仍屬待完成項目。

項目主頁 · GitHub

Categories: 開源, 南京大學, Agentic, 模型, 多模態模型, 模型訓練, 3D, Python, Anthropic

Socratic-Skill-Learning:Agent 技能能否真正跨任務重用?南京大學提出 SSL

SSL 讓 Agent 在導師指導下自行練習及編寫技能,並以新任務測試 transferable Skills 是否真正遷移。

NJU-LINK

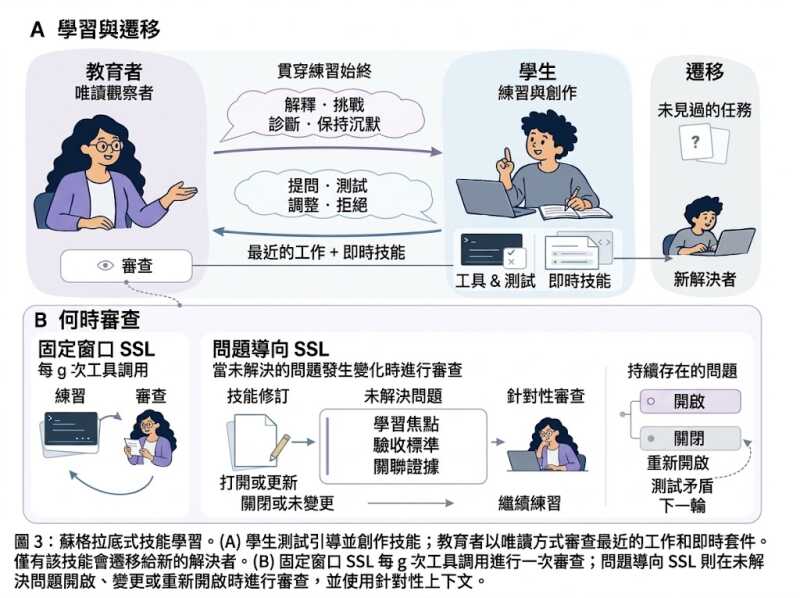
Agent 從一次任務學到的做法,未必能直接套用到新情境;SSL(Socratic Skill Learning)把這種「學會與重用」拆開,讓 Student 練習、提問及編寫 Skill,再由全新的 solver 接手未見任務。南京大學 NJU-LINK 將它定位為可重用 Agent Skills 的學習框架,關鍵不是複製完整答案,而是保留程序及其適用條件。

流程由 Educator 介入指導,但 Student 仍是環境操作者及 Skill 作者,可以質疑、測試和修改建議。Fixed-Window SSL 會按固定間隔檢視進度;Issue-Guided SSL 則追蹤仍未解決的問題,隨 Skill 版本變化集中檢視,避免每輪都重新教訓。

評測工具 SkillTransferBench 涵蓋 35 個任務系列、408 個可執行個案及 6 個領域;主評估使用 22 個系列、155 個 held-out cases,並以新 solver session 測試遷移。Fixed-Window SSL 的 utility 為 0.801,高於無 Skill 的 0.723、Trace2Skill 的 0.761,以及 SKILL-KD 的 0.751;Issue-Guided SSL 達 0.805,較 Fixed-Window SSL 節省 61.7% Educator tokens,但整體流程仍需 Node.js 22.19+、Docker 及 OpenAI-compatible API 支援。

  • 讓 Agent 自己提問、測試和修訂 Skill
  • 以未見任務及新 solver 檢查技能是否可遷移
  • 比較固定間隔與問題導向兩種複核方式
  • 提供跨 Qwen、DeepSeek、Kimi 等模型的評測

這套方法較適合研究 Agent 教學、技能記憶及長期工作流程的團隊,而不只適合聊天機器人。它沒有直接把大型模型換掉,而是處理更實際的問題:如何把一次成功任務轉成可攜、可審核的 Skill,同時控制導師介入所帶來的額外成本。

GitHub · 數據集

Categories: 開源, 南京大學, Agentic, 模型, Qwen, OpenAI, DeepSeek, API, 框架, 教學, 工具, Dataset 數據集, Kimi, Skill 技能

SWIFT 把擴散模型的訓練誤差轉成性能優勢

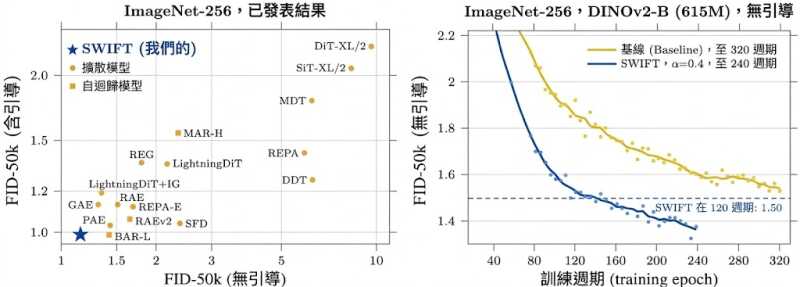
有限訓練令擴散模型偏離理想預測,SWIFT 從較弱模型找出偏差方向,再把訓練目標推向更準確的位置。ImageNet-256 上,它在不改採樣器的情況下取得具競爭力的 FID。

Og image

擴散模型訓練時間有限,預測結果往往未能到達理想的後驗平均值;SWIFT(Self-guided Weak-to-strong dIFfusion models via Target extrapolation)利用這種可預測的偏差,改善模型生成影像的能力。它適合關注影像生成品質、又希望保留原有推理流程的研究者與模型開發者。

SWIFT 先使用一個凍結的弱模型,估計目前模型會在哪個方向偏離理想預測,再把訓練目標沿相反方向外推。訓練時改變的只有預測目標,損失函數、權重、網絡架構及採樣器都維持不變;使用時無須更換原有採樣器。

在 ImageNet-256 評測中,SWIFT 不使用 guidance 時的 FID 為 1.15,使用 guidance 時為 0.99。研究亦在配對的 DINOv2-B 設定下比較訓練進度,SWIFT 在訓練過程中持續領先基準模型。

  • 以凍結的弱去噪模型估計訓練偏差方向。
  • 將乾淨樣本與弱模型預測之間的差距用來外推回歸目標。
  • 保留原有模型架構、損失設定及採樣器。
  • ImageNet-256 的 FID 為 1.15(無 guidance)及 0.99(有 guidance)。

這種方法針對的是有限訓練預算下的模型誤差,並非更改生成時的採樣流程。現有內容未提供完整安裝或使用步驟,採用 SWIFT 前仍需查閱論文及相關資源確認實作細節。

項目主頁

Categories: 南京大學, 阿里巴巴, 模型, 模型訓練, Image

VideoJev 加速影片理解,問答推理快逾百倍

VideoJev 把時間定位與選擇題影片問答放進同一個評分介面,減少生成式回答的延遲。

VideoJev

處理長片段、重複提問或需要找出事件時間的工作時,VideoJev 不必逐字生成答案,而是直接比較候選時間區間和答案選項。這個項目屬於影片理解模型,實際處理 temporal grounding 與 multiple-choice video QA,並將兩項任務放進同一個決策介面。

它以共享影片計算配合 Cached inference 和 Joint inference:前者保留已處理的視覺資訊,方便後續查詢;後者讓多條問題在一次 forward pass 中完成。相較依靠 autoregressive decoding 的 video multimodal large language models,直接候選評分較適合大量、結構清晰的判斷,但不負責自由生成長篇答案。

  • VideoJev-4B 建基於 Qwen3.5-4B,VideoJev-35B-A3B 建基於 Qwen3.6-35B-A3B
  • 兩個模型均提供 BF16、Safetensors 權重及 Hugging Face checkpoint
  • 三個 temporal grounding benchmark 的 mIoU,較各自 backbone 分別提升 6.7 和 10.8 分
  • 四個影片問答 benchmark 在 Thinking mode 維持相近表現,推理速度提升超過 100 倍

研究結果亦量得 temporal grounding 約 2.8 至 3.1 倍加速,顯示它較適合影片搜尋、內容索引、監控片段定位,以及需要連續提出多條問題的視覺代理工作流。試用可按儲存庫提供的環境設定,透過 Transformers 的 AutoModel、AutoProcessor 載入 Hugging Face 權重,再以示範影片測試;不過儲存庫資料未交代硬件門檻,BF16 模型的記憶體需求仍需按部署環境自行確認。

項目主頁 · GitHub · 模型

Categories: 開源, 南京大學, AI productions, 模型, 多模態模型, Qwen, Video, 庫, Dataset 數據集

Spatial Memory Intelligence:讓世界模型記住空間關係

長影片生成愈往後,舊畫面愈難整理,也容易出現空間前後不一致。SMI 以理解能力管理長期空間記憶,現時仍未公開程式碼與模型權重。

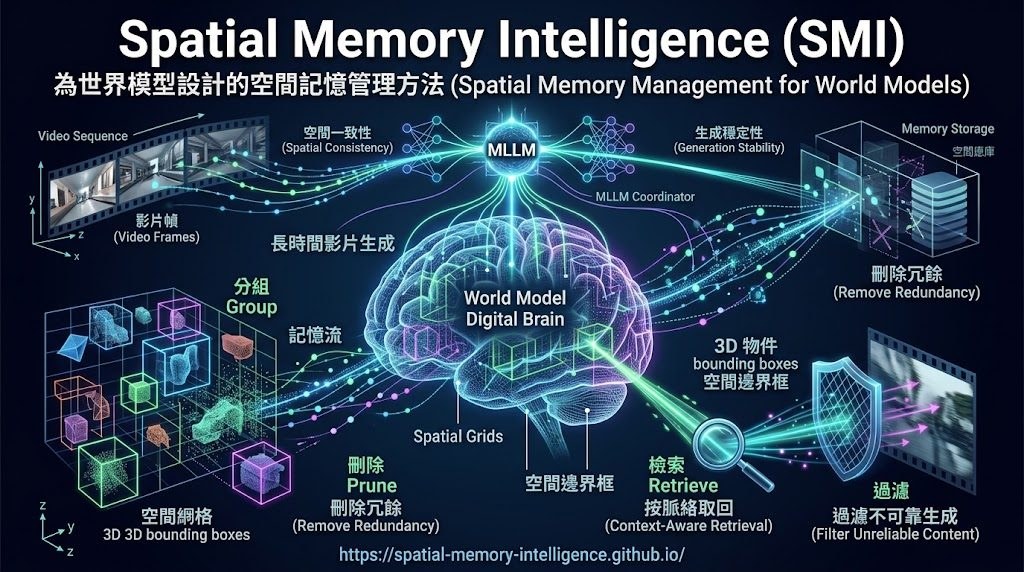
SMI overview: organizing spatial memory, retrieving relevant observations, and improving consistency and stability.

長影片生成要延續物件位置與場景結構,不能只靠不斷累積舊觀察;記憶太多會帶來冗餘,也可能把不可靠內容帶進後續生成。Spatial Memory Intelligence(SMI)是為世界模型設計的空間記憶管理方法,目標是改善記憶精簡度、空間一致性與生成穩定性。

SMI 以具語義與空間理解能力的多模態大型語言模型(MLLM)協調四項操作:把相關觀察分組、刪除群組內冗餘內容、按近期脈絡及下一步動作取回記憶,並過濾不可靠的生成觀察。它不只整理記憶,也會在生成過程中更新及提取資料,適合研究長時間影片生成與世界模型記憶管理的團隊。

項目網站提供 HY1.5 與 Wan2.2 的同步影片比較,主要對照 SMI 與 Base;部分案例亦列出 FramePack、Deep Forcing、MoC、VMem 及 MemFlow。紅框標示部分空間或結構不一致之處,方便檢視案例,但目前沒有公開可供核對的量化指標,不能單靠示範影片判斷改善幅度。

  • 記憶管理涵蓋分組、精簡、檢索與可靠性過濾。
  • 檢索會考慮近期上下文及下一個使用者動作。
  • 網站可觀看 HY1.5、Wan2.2 的影片比較。
  • 訓練、推理及評估程式碼、資料集與模型權重仍在準備發布。

目前 GitHub 儲存庫主要提供項目介紹與示意圖,尚未能據此安裝或自行重現結果。研究人員可以先查看網站示範及論文,待程式碼、資料集和權重公開後,再測試它能否在不同世界模型與長片段生成任務中維持空間一致性。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 南京大學, 阿里巴巴, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, Video, 香港, 庫, Dataset 數據集

OneStreamer 讓串流影片懂得記憶與適時回應

影片畫面離開視窗後,OneStreamer 仍可保留具時間線索的證據,並自行判斷何時已有足夠資訊回應問題。

OneStreamer

直播影片一閃即逝,畫面離開模型的視覺視窗後,之後的提問仍可能需要引用那些細節。OneStreamer 屬於串流影片大型語言模型,處理的正是記錄證據、理解新畫面,以及在資料足夠時主動回應之間的取捨。

它以 Qwen3-VL-4B-Instruct 為基礎,OneStreamer-4B 透過 Proactive Hierarchical Caption Memory(PHCM)保存局部細節和已完成事件摘要,再配合近期畫面作答,減少重看歷史影片特徵的需要。Proactive State Transition Learning(PSTL)則保留輸出錨點,挑選具代表性的狀態變化與持續狀態,只有 27.5% 標註狀態 tokens 需要監督。

你可從 Hugging Face 取得 OneStreamer-4B 模型及 OneStreamer-1M 數據集,配合串流影片、問答或字幕資料測試;儲存庫目前提供模型、數據集和示範頁面,但完整推理指令未在提供內容中列出,因此部署前仍需確認執行框架、硬件需求和輸入格式。OneStreamer-1M 合併串流字幕、串流 QA 及整理後的開源資料,共有 1.16M 筆互動記錄。

八項涵蓋線上感知、記憶和主動回應的基準測試中,OneStreamer-4B 在比較方法中取得最高的整體結果;這對需要持續觀看教學、監控或家庭影片的團隊較有參考價值,但生成式記憶仍可能受字幕品質、延遲和錯誤累積影響。

  • PHCM 同時保留局部細節與完成事件摘要
  • PSTL 針對回應時機和重複等待狀態作訓練
  • 模型、數據集及示範頁面均已公開
  • 八項基準測試涵蓋感知、記憶與主動回應
  • 適合研究串流影片理解及長時間上下文的團隊

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 南京大學, AI productions, 模型, 視覺模型, 模型訓練, Qwen, Video, 框架, 教學, 庫, Dataset 數據集

阿里 WanPE 用 397B 參數重寫電影級提示詞

阿里 Wan Team 推出 397B 參數嘅電影級提示詞增強模型 WanPE,專門幫影片生成模型把簡單描述擴寫成導演級腳本。

Wan logo

用文字寫出導演水準嘅提示詞係一道高牆。普通用戶多數只會輸入「一個人喺森林行」,但頂級模型需要更細緻嘅鏡頭語言、動作編排同節奏控制,先至能夠生成高質素嘅 30 秒成片。阿里 Wan Team 推出嘅 WanPE,正正瞄準呢個痛點:佢會將用戶輸入嘅簡短描述,自動擴寫成包含鏡頭運動、燈光變化、動作節奏嘅電影級分鏡腳本,再交俾下游影片模型執行。

WanPE 採用「Video-grounded reverse construction」做法,先從真實影片反向建構出鏡頭規劃,再學習點樣由提示詞出發重建同樣嘅結構,比起由前向改寫提示詞更能保留導演意圖。同時,佢透過 Semantic-Consistency GRPO(SC-GRPO)訓練方法,確保長鏡頭、多分鏡之間嘅語意唔會走樣。整個模型以約 105 萬條真實影片訓練而成,參數量達到 397B。

沒有 WanPE

使用 WanPE 之後

團隊構建咗人類標註嘅 WanPEval 測試集,覆蓋 5 至 30 秒唔同時長同意圖粒度,並用約 11,000 組盲測配對評分做對比。當配搭 Wan3.0 影片生成器時,WanPE-397B 喺 5 至 15 秒影片將人類偏好分數提升 10.7 至 18.8 分;喺 30 秒嘅長片場景,偏好分數更大幅躍升 50.9 分。喺 5 至 15 秒組別,佢領先所有受測嘅商業方案;30 秒組別則與 Seedance 2.5 保持競爭水平。

對內容創作者、短影片團隊或者想做 AI 廣告片嘅人嚟講,呢類自動「導演助手」能夠省卻大量分鏡草稿時間;對開發者而言,佢亦可作為外掛增強模組,套用到 LTX-2.5、MiniMax-H3 等其他生成器身上做格式適配。

重點摘要

  • 397B 參數專職寫分鏡:WanPE 將用戶簡短提示擴寫為導演級電影腳本,再交俾下游影片模型執行
  • 逆向建構 + SC-GRPO:從真實影片反向學習鏡頭規劃,並透過強化學習保持長片語意一致
  • WanPEval 評測:人類標註、5 至 30 秒覆蓋、約 11,000 組盲測配對評分
  • 30 秒長片偏好激升:搭配 Wan3.0 時,人類偏好分數提升 50.9 分
  • 可遷移:經格式適配後,可應用於 LTX-2.5、MiniMax-H3 等其他生成器

項目主頁 · Paper

Categories: 南京大學, 清華大學, 阿里巴巴, AI productions, 模型, 模型訓練, Video, 提示詞, Content Creator, LTX, 中國, Dataset 數據集, MiniMax

HarnessVLN:不訓練也能走的統一導航框架

HarnessVLN 把視覺、語言、空間證據交給一套 Agent Harness 統籌,用零訓練方式處理多任務導航,並以層化記憶與時空圖解決長程失敗。

Repository image for AgibotGeneral/harnessvln

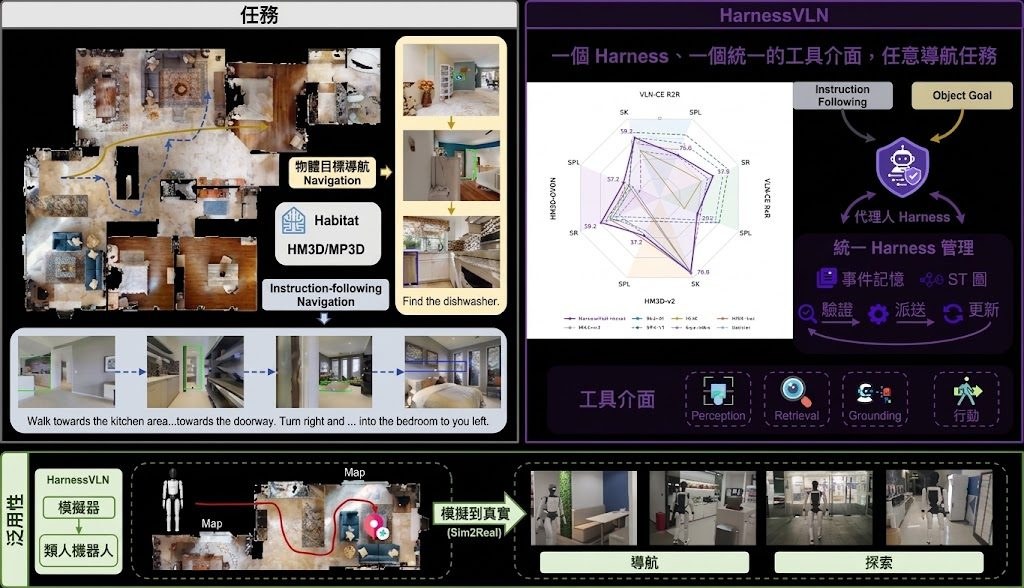
Embodied Navigation 過去依賴大規模訓練與任務專用流程,但不同場景的 pipeline 各自為政,難以共享空間證據與錯誤紀錄。HarnessVLN 把這個痛點攤開:現有 training-free 方法雖然借助多模態大語言模型,卻缺乏把「提案」與「空間證據、任務進度、執行失敗」對齊的機制,於是同一個 agent 在長時序任務中容易重複犯錯、難以回收。

作為一個訓練無需更新的 agent harness,HarnessVLN 用統一工具介面串接感知、檢索、定位、導航、恢復與終止,並透過層化事件記憶與持久化時空圖(Spatiotemporal Graph)保留可重用的空間證據與失敗標註,讓跨子目標的經驗真正沉澱。提案不再直接落地,而是先被 Agent Harness 結合幾何可行性與過往失敗做驗證,再分派給工具執行。

在 R2R、RxR、HM3D-v2、HM3D-OVON 等基準上,HarnessVLN 報出 60.8、53.9、76.0、59.3 的 SR%,覆蓋 instruction navigation 與 online exploration 兩種形態,並提供真機 demo 與模擬環境。對機器人團隊、具身 AI 研究者與需要快速驗證導航策略的工程師來說,它提供一個不必從零訓練就能橫向比較的底層框架。

重點摘要

  • 訓練無需更新:以 Agent Harness 統一感知、檢索、定位、導航、恢復與終止工具
  • 層化事件記憶 + 時空圖:把子目標進度與空間證據沉澱為可重用資產
  • 提案先驗證再執行:用幾何可行性與失敗紀錄把 LLM 操作提案過濾一次
  • 覆蓋 R2R、RxR、HM3D-v2、HM3D-OVON 等多項導航基準
  • 同時提供模擬與真機 demo,適合做跨任務導航策略的快速評測

對在意長時序導航穩定性、想避開昂貴 fine-tuning 的團隊,這套來自南京大學、清華大學與 AGIBOT 合作的方案,給出一條「不訓練也能走得更穩」的工程化路線。

項目主頁 · GitHub · Paper

Categories: 開源, 南京大學, 清華大學, Agentic, 多模態模型, 模型訓練, Robotic, 框架, 工具, Dataset 數據集

OmniAssistBench:以多輪互動評測即時影片助手的表現

OmniAssistBench 以 LLM-as-a-Judge 固定互動路徑測試 Omni-LLMs 的多輪影片助手能力,涵蓋685組開放式問答、7類任務,影片含自然語音、打字或手寫提示。評分顯示 Gemini-3-Pro 以66.4分領先。

OmniAssistBench proposes an annotation pipeline which allows annotators to build test samples from existing Internet vid

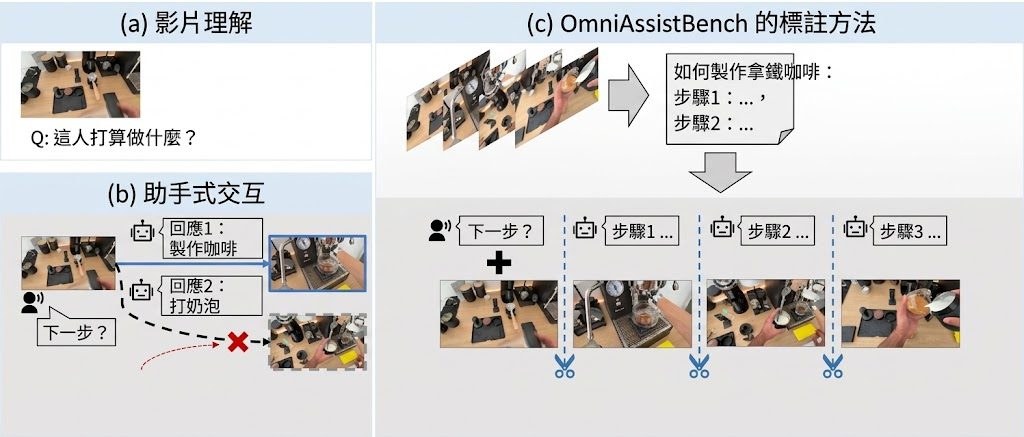
當影片助手的回答會改變使用者下一步行動,傳統只對固定影片問答的測試便難以反映真實體驗。OmniAssistBench 屬於 Omni-LLMs 的影片助手評測基準及數據集,透過固定互動路徑,處理多輪對話中影片內容會隨模型回應變化的問題。

項目涵蓋 685 組開放式問答,分成 Basic Tier 與 Advanced Tier,涉及社交理解、時間感知、手勢提示、程序指導及主動回應等 7 類主要任務和 16 類細分任務。影片取材自運動、煮食、講課、DIY 及談話節目,另有 3 個自行拍攝案例,每個平均超過 15 輪互動;問題會以自然語音、打字或手寫方式嵌入影片,而不是只放文字提示。

  • 以影片連同對應音訊輸入模型,再按互動回合回答問題
  • 由專家先整理影片步驟,再剪輯片段及加入字幕,固定測試路徑
  • 評分採用 LLM-as-a-Judge,原始 0 至 5 分再換算為 0 至 100
  • 建立數據集耗用超過 1,000 小時專家工時

這種做法比靜態影片問答更貼近助手場景,但固定路徑亦代表其他合理回應未必能在同一測試中獲得充分反映。Project homepage 的排行榜顯示,Gemini-3-Pro 整體得分為 66.4,Gemini-2.5-Pro 為 64.6,商用及開源 Omni-LLMs 都只達部分正確,反映可靠的即時影片助手仍有明顯改進空間。

研究團隊來自南京大學、南開大學及 University of Waterloo。測試者需要按照項目提供的評測流程處理影片和音訊,相關 Dataset、Project Page 及評估程式碼可供查閱;正式採用前應先確認版本、存取權限及評分流程是否已更新。

項目主頁 · GitHub

Categories: 開源, 南京大學, 字節跳動, Qwen, Gemini, Dataset 數據集

Page 1 of 2
1 2