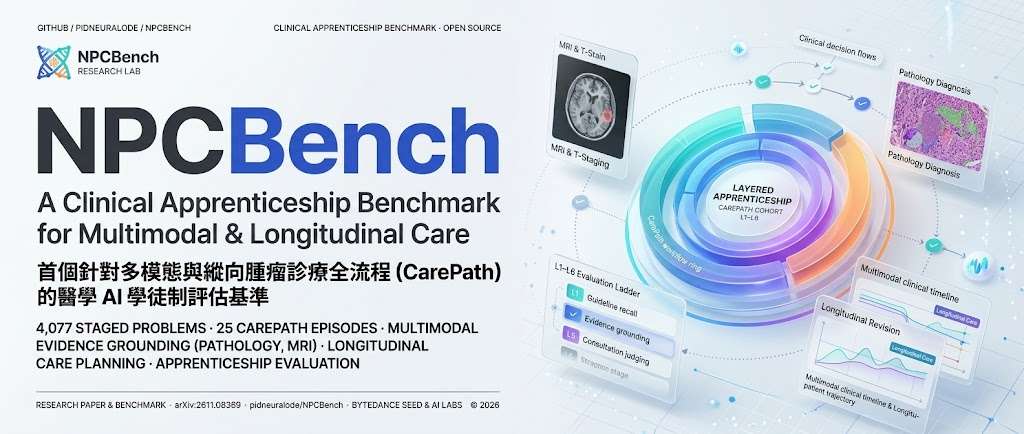
NPCBench:檢測模型能否串連鼻咽癌診療全程

模型答對單題,不代表能為同一位病人作出前後一致的診療判斷。NPCBench 把鼻咽癌知識、影像、治療決策與病程追蹤放進同一套評測。

NPCBench overview

答對鼻咽癌知識題,未必代表模型能制定合適方案,或隨病情變化修正判斷。NPCBench 是一套醫療 AI 評測基準,涵蓋指引知識、影像判讀、臨床決策及專科諮詢,嘗試檢驗模型能否把這些能力連接到病人的診療流程中。

不少醫療基準把能力拆成知識問答、單張影像判讀或靜態病例題,逐題計分;這種方式較難看出模型能否整合多模態證據,或在病程改變時更新決策。NPCBench 改以近似專科培訓測試,並加入縱向病例與 CarePath 評估,要求同一病人的病理、MRI T 分期及各項照護決策全部正確,才算聯合成功。
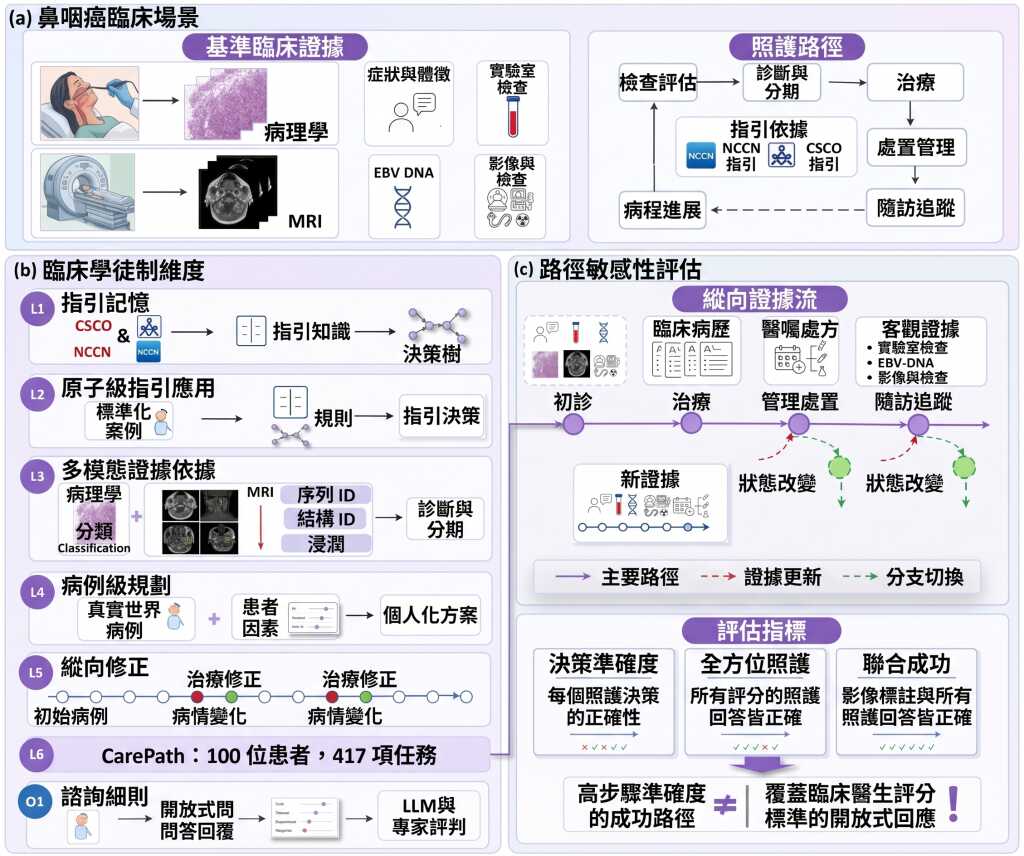
資料集包含 4,777 項分階段及諮詢題目,另有 100 名病人的 CarePath 病例,共 417 項診斷與照護評分任務。項目亦提供 MRI 延伸評測指南、醫師一致性校準,以及可用已發布預測結果重現主要結果表的 CPU 指令;研究比較了 30 個模型,並以配對控制檢視證據依據、病程中的判斷修正及諮詢評分。

結果反映單項能力與完整診療流程之間存在落差:在 21 個多模態模型中,嚴格 CarePath 聯合成功率最高為 23%。這令 NPCBench 適合研究醫療模型評測、腫瘤照護工作流程及多模態臨床推理的團隊;但它聚焦鼻咽癌,分數不能直接推廣至其他疾病或真實臨床成效。

  • 評測範圍由指引知識延伸至影像、決策、病程追蹤及專科諮詢。
  • CarePath 以病人為單位,要求多項診斷與照護答案同時正確。
  • 研究比較 30 個模型,並納入配對控制與醫師一致性校準。
  • 嚴格 CarePath 評估中,多模態模型最高成功率為 23%。

使用者可按任務下載相應題目,為每題提交模型答案,再以提供的評分工具輸出分數;Python 3.10 或更新版本即可執行。多選題需要提交完整選項集合,L1、L2、L4 等任務有各自的題目檔與評分命令,MRI 延伸測試則另有資料處理及推理設定指南。
GitHub · Paper

Categories: 開源, 香港理工大學, 多模態模型, Image, 香港, 工具, Medical醫學, 中國, Dataset 數據集

SAE Interprets MoE:拆解混合專家的分工

只看 MoE 專家被路由多少次,未必能知道它真正為模型輸出帶來甚麼。這項研究把專家貢獻連到可解讀特徵,分析 Qwen3-30B-A3B 的專長如何細分。

Repository image for ByteDance-Seed/SAE-interprets-MoE

要了解 MoE 模型裏每個專家實際負責甚麼,單計它被選中的次數並不足夠:路由頻率不等於它對輸出的貢獻。SAE Interprets MoE 提供重現研究實驗的程式碼與數據,透過稀疏自編碼器(Sparse Autoencoder,SAE)分析 Qwen3-30B-A3B 第 4、30、46 層的專家分工。

研究利用 SAE 編碼器的仿射特性,把每個特徵的啟動值精確拆分到 MoE 層中被啟動的專家,再按語料彙總貢獻比例,建立專家與特徵之間的「主導圖」。這與按預設領域標籤統計路由不同,分析焦點是專家真正推動了哪些特徵;研究結果指出,多數特徵主要由一至兩個專家主導。

第 30 層的分析顯示,專家可在較大的領域內形成細分分工,例如 Java 與前端網頁、幾何與算術。研究亦比較專家貢獻的集中程度、主導特徵重疊,以及各專家的領域標籤;這些結果描述的是特定模型與層,不宜直接推廣到所有 MoE 模型。

重現流程從計算專家對 SAE 特徵的貢獻統計開始,再執行排名、主導圖、詞雲與領域分析等實驗。項目提供每項實驗的執行腳本及已整理的解釋、標籤和判斷資料;模型權重可從 Hugging Face 下載,也可指定本地檔案。計算需求不低:Qwen3-30B-A3B 的 bf16 權重約需 61 GB,單層 fp32 SAE 編碼器另需約 8 GB,同時追蹤三層則需要兩張 80 GB GPU。

  • 分析範圍為 Qwen3-30B-A3B 的第 4、30、46 層。
  • 以特徵貢獻而非單看路由頻率判斷專家分工。
  • 提供可重現實驗的程式碼、SAE 權重連結及整理後的研究資料。
  • LLM 領域分析需要 OpenAI 相容 API;完整追蹤流程亦需要高記憶體 GPU。

這套方法適合研究 MoE 可解讀性、專家專長與特徵分工的團隊,也方便重現的分析。它提供的是針對特定模型的研究工具與證據,不是可直接替任意模型標註專家的通用服務;解讀結果仍取決於 SAE 特徵與自動解釋流程。

項目主頁 · GitHub · 模型

Categories: 開源, 字節跳動, 模型, Qwen, OpenAI, API, 工具

RelayVSR:用稀疏關鍵幀加速 4×影片超解像

RelayVSR 讓大型生成模型只處理稀疏關鍵幀,再交由輕量網絡完成串流放大,兼顧細節、速度與記憶體用量。

RelayVSR overview from the paper

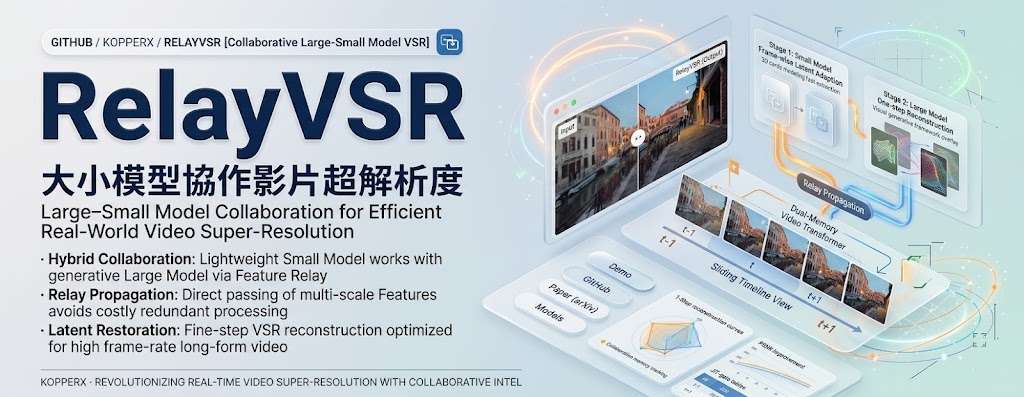
低清影片要放大四倍,往往要在細節真實感與處理速度之間取捨。RelayVSR 屬於影片超解像模型項目,讓大型 Wan 模型產生稀疏參考,再由輕量 Dual-Memory Video Transformer 重建其餘畫面,減少逐幀使用生成模型的成本。

RelayVSR 的流程不只是把兩個模型串起來:Video-Aware Reference Optimization(VARO)以影片層面及關鍵幀層面的獎勵,透過強化學習改善參考品質,降低錯誤關鍵幀在後續畫面累積的風險。輕量模型會結合關鍵幀細節與近期影片內容,支援有限前看及雙端點條件。

在單張 NVIDIA A100 80GB、1080p 及 15 幀關鍵幀間隔下,雙端點 RelayVSR 達到 29.29 FPS,峰值 GPU 記憶體為 13.82 GB,首幀模型延遲 0.327 秒;FlashVSR-Tiny 則為 7.80 FPS、24.447 GB 及 2.83 秒。這個比較反映它把速度和記憶體壓力放在系統協作,而非單一大型模型硬撐。

  • 支援 4×輸出,保留輸入影片 FPS
  • Linux、Python 3.11–3.13 及 NVIDIA GPU
  • Wan 與 Flash 兩個 safetensors 權重分開載入
  • 可處理 MP4 或按順序排列的圖片資料夾
  • 不會複製原影片音訊,長片可用 --max-frames 限制處理量

要試用項目,需要先取得兩個 Hugging Face 權重,再以 inference.py 指定輸入影片;預設每 15 幀產生參考端點,也可調整 --window-size。它較適合需要串流處理、長影片放大或受 GPU 記憶體限制的研究者與影像工作流程,但輸出沒有音訊,亦仍依賴 NVIDIA GPU,未必適合一般消費級電腦直接處理高解像長片。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視頻模型, NVIDIA, Video, Image, Audio, Linux, Python, 中國, 強化學習

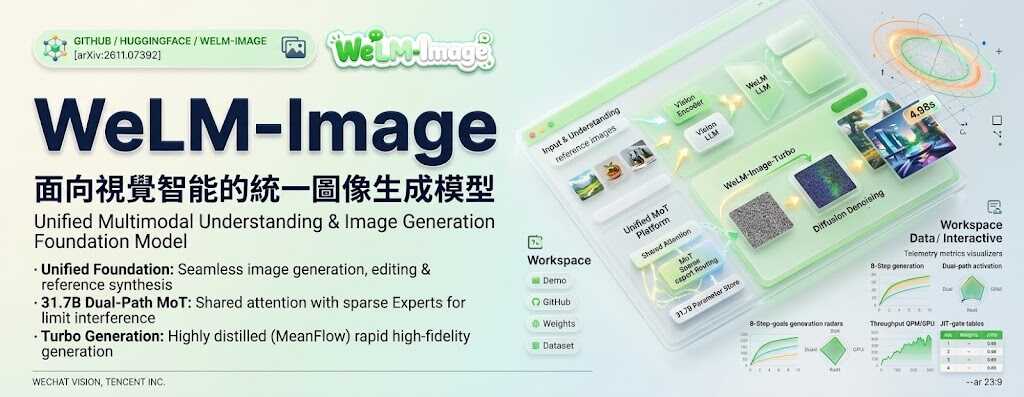
[技術文章] WeLM-Image:把生圖、指令編輯與多圖合成整合一個模型

從文字生圖、按指令修改圖片,到合併多張參考圖,WeLM-Image 嘗試用同一模型處理多種視覺創作需求,並支援單張 GPU 執行。

Hero image preview

創作時要由文字描述生成圖片、再修改姿勢或移除路人,甚至合併幾張參考圖,WeLM-Image 都可用文字指令處理。這個騰訊 WeChat Vision 團隊推出的統一圖像模型,亦支援在圖片中加入或替換文字,面向 WeChat 的消費者應用設計,目標是在單張 GPU 上部署。

常見做法會把圖像理解與生成分成不同模型或參數路徑,處理多種任務時可能互相干擾。WeLM-Image 把文字、參考圖像與目標圖像的潛在表示交錯放進同一序列,再以 Mixture-of-Transformers(MoT)共用注意力、分開理解與生成參數,並用 Mixture-of-Experts(MoE)提供稀疏運算容量。

訓練資料涵蓋雙語標註與經核實的編輯範例,並逐步訓練至原生 1.5K 解像度。團隊分別針對生成與編輯使用評分規準及檢查清單設計獎勵,再以感知雜訊的 on-policy distillation 整合兩條路徑。

報告指出,1,536 解像度版本在 PRISM-Bench、Qwen-Image-Bench 及 UnicBench 的受測開源模型中排名第一。加速版本 WeLM-Image-Turbo 則以 MeanFlow 蒸餾,在單張 NVIDIA H20 GPU 上用八步生成 1024 × 1024 圖像,耗時 4.98 秒。

  • 同一模型涵蓋文字生圖、指令編輯與多參考圖合成。
  • 可處理姿勢調整、風格轉換、物件增刪及畫面文字修改。
  • MoT 分開理解與生成參數,MoE 提供稀疏模型容量。

Paper

Categories: 開源, 騰訊, 模型, 多模態模型, Qwen, NVIDIA, Image, 影像模型, txt2img

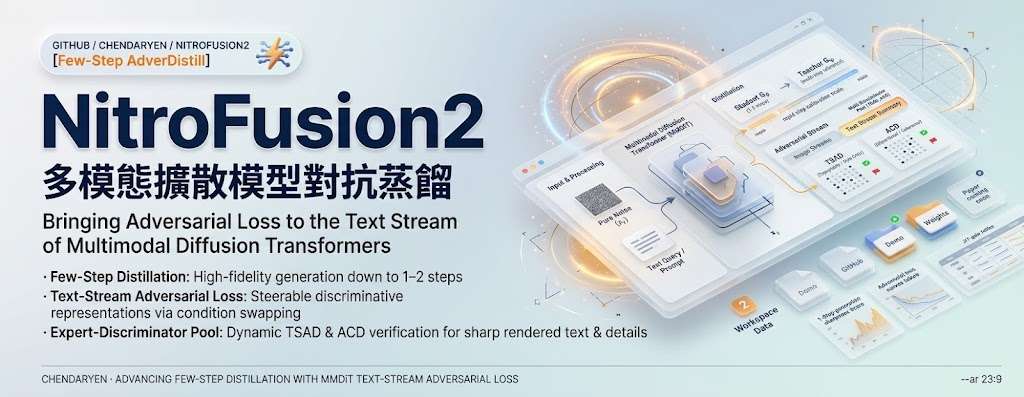
NitroFusion2:讓文字生圖一步生成清晰細節

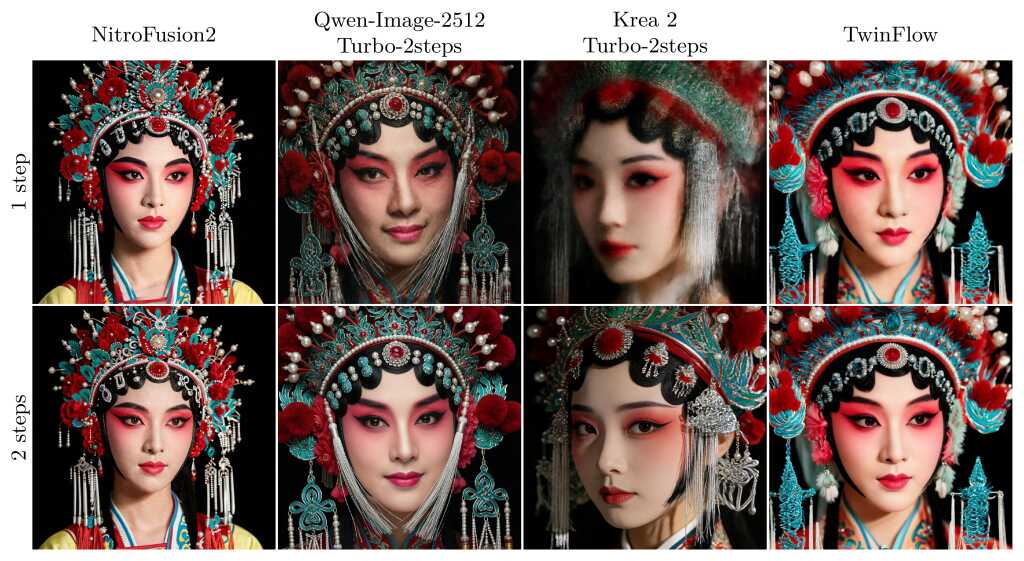
想快速生成帶有清晰文字和細節的圖片,NitroFusion2 把生成步數壓到一至兩步。它以 Z-Image-Turbo 為基礎,也提供減少瑕疵的兩步工作流程。

compare opera

需要快速出圖,又不想犧牲圖片中的文字與細節,NitroFusion2 以一至兩步生成作出回應。這個文字轉圖片模型建基於 Z-Image-Turbo,將對抗損失加入多模態擴散 Transformer(Multimodal Diffusion Transformer,MMDiT)的文字串流,讓模型在一步生成時也能呈現銳利文字和細節。

它的做法不只依賴圖片特徵判斷生成結果。MMDiT 的文字 token 經過共同注意力層後已讀取圖片資訊,因此 NitroFusion2 也利用文字串流中的中間狀態進行對抗式蒸餾;訓練方法還會按物件、文字排版或動作等提示,調整判別器關注的內容。這讓單一步生成兼顧速度和細節,但兩步流程仍可能出現瑕疵。

ComfyUI 使用者可直接載入項目提供的一步或兩步 workflow;兩步流程建議先以 0.5 強度套用 de-distillation LoRA,將 NitroFusion2 拉回 Z-Image-Turbo,再於第二步單獨執行 NitroFusion2,以減少部分瑕疵。項目亦提供 Diffusers 推理程式和 GGUF 權重,量化版本由 2.0 GB 至 7.2 GB,方便按可用儲存空間選擇;文件未列出不同版本的品質或速度測試數據。

  • 一步生成,主打清晰文字與細節。
  • 兩步流程可配合 de-distillation LoRA 減少部分瑕疵。
  • 提供 ComfyUI workflow、Diffusers 程式及線上示範。
  • GGUF 權重有多種大小,適合需要量化模型的使用者。

對需要快速製作含文字圖片的設計者,或想在本地工作流程試用少步數生成的開發者,NitroFusion2 提供了直接測試的模型與 workflow。若重視兩步生成的穩定度,應按建議加入 LoRA;生成速度與畫質仍需以依賴提示詞和硬件作驗證。

項目主頁 · GitHub · 模型

Categories: 開源, ComfyUI, 模型, 模型訓練, Image, 提示詞, LoRA

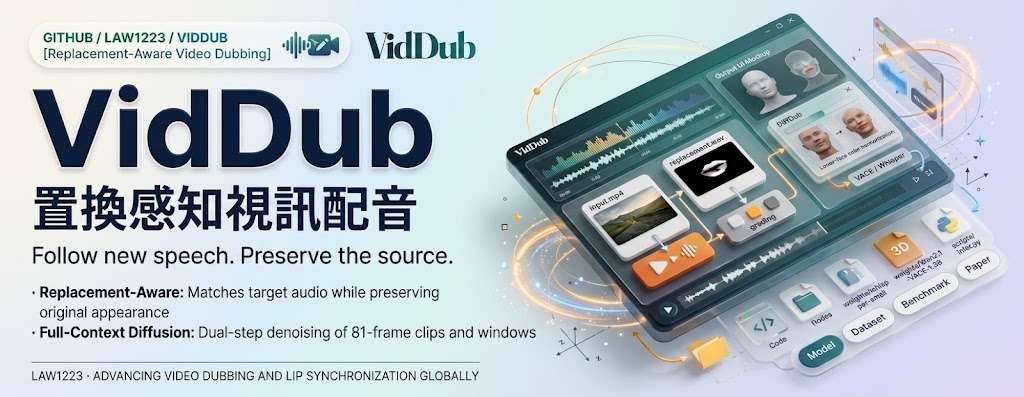
VidDub:用兩步去噪讓影片嘴形跟隨新配音

換了配音,嘴形也要跟着改。VidDub 嘗試保留人物與場景,同時縮短影片生成所需步驟。

VidDub

替訪談或角色影片換上新配音,VidDub 這套音訊驅動影片配音系統會調整嘴形,目標是保留原有人物、頭部姿態與背景,適合需要沿用原片表演的創作流程。

原音重建訓練會要求模型重現錄下的嘴形,換成另一段說話後便可能形成衝突。VidDub 以 replacement-aware cross-audio supervision,在替換語音樣本中遮蔽原嘴部的重建監督,改由聲畫同步訊號引導發音動作。

完整上下文教師模型再經蒸餾訓練出兩步去噪學生模型,壓縮生成步驟。項目報告單張 H20 達 11.3 FPS,但限於輸入已完成預處理的測量,不能視為端到端即時速度。

  • 長片透過重疊窗口推理。
  • 提供模型權重與訓練程式碼。
  • 可透過社群示範或 OpenDub 應用體驗。

三個訓練種子的實驗中,移除衝突嘴部監督令替換音訊 Sync-C 同步評分提升 0.833±0.04。配音團隊仍宜用自己的素材檢查嘴形、人物一致性及長片接縫;同步分數不足以代表整段成片品質。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 多模態模型, 模型訓練, NVIDIA, Video, Audio, 語音, Dataset 數據集

EmoReward:讓影片生成按情境調整情緒評分

情緒表達沒有唯一標準答案,固定評分模型容易忽略不同影片中的細微線索。EmoReward 會按影片內容調整各類獎勵訊號的可信度,並把訓練經驗帶到下一輪。

EmoReward logo

生成影片要呈現特定情緒,不能只靠一個固定分數判斷做得好不好。EmoReward 是一套用於情緒影片生成強化學習的獎勵校準機制,會按影片中的情緒階段、面部表情、訊號衝突與細微線索,決定不同評分來源各自應佔多大比重,處理情緒主觀而且隨時間變化的問題。

透過 Reflective Reward Gating,在每段影片中調整面部動作、語意等不同獎勵訊號的可信度。完成一輪訓練後,RewardMemory 會整理哪些情境下的線索較可靠,轉成有上限的融合權重倍率,供下一輪訓練使用;記憶表在該輪訓練期間保持凍結,避免權重持續變動。

這種跨輪次校準適合研究情緒影片生成、強化學習後訓練,或需要整合多種評分模型的團隊。項目以 HunyuanVideo-1.5 為基礎模型,並採用 SAGE-GRPO 作為強化學習骨幹;實驗涵蓋三種影片強化學習算法及兩個影像骨幹,亦包括消融實驗與人類評估。

  • 按影片情境調整不同情緒評分訊號的權重。
  • 不改動獎勵模型參數,降低校準對模型本身的干預。
  • 把一輪訓練所得的線索可靠度帶到下一輪,訓練期間凍結記憶表。
  • 評估涵蓋三種影片強化學習算法、兩個影像骨幹及人類評估。

項目文件列出 PyTorch 2.6+、Transformers 4.57.1 與 Diffusers 0.35.0 等依賴。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 騰訊, AI productions, 模型, 多模態模型, 模型訓練, Video, Image, 香港, Python, 庫, 強化學習

DSH Go:Android 手機執行或遙控 DeepSeek Harness

DeepSeek Harness 的 Android 客戶端 DSH Go,讓你在手機安裝執行環境,或透過 SSH 遙控電腦和伺服器上的 DSH,並在手機處理對話與工具審批。

DSH Go:把 DeepSeek Harness 装进口袋

想在外出時繼續使用 DeepSeek Harness,或直接讓 Android 手機執行它,DSH Go 提供兩種做法:在 App 內安裝 Ubuntu、Node.js 和 DSH 執行環境,或連接電腦及伺服器上的 DSH。這款 Android 客戶端支援 Android 8 或以上,無需 Root,也不必另裝 Termux。

遠端連線可使用 SSH,亦可使用 DSHarness Remote。聊天介面支援切換模型、傳送圖片、語音輸入,以及處理工具審批和提問;需要不同操作方式時,也可切換至網頁模式。這令手機不只是查看對話的介面,亦能接續處理 DSH 的工作流程。

DSH Go 亦支援適配專用 SDK 的原生工具卡、表單和面板,項目提供 SDK、教學和示例,方便開發者製作手機介面。開啟權限後,本機引擎可以讀取屏幕、點按和輸入;這類操作涉及裝置控制,使用者應留意授權範圍,並可隨時停止操作。

  • 可在 Android 手機本機執行 DSH,或連線至遠端電腦及伺服器。
  • 支援圖片、語音輸入、模型切換、工具審批和網頁模式。
  • 原生工具卡、表單及面板可透過項目提供的 SDK 開發。

這個項目適合已使用 DSH、需要以手機接續工作的人,以及希望為 DSH 工具製作原生手機介面的開發者。

GitHub

Categories: 開源, 模型, DeepSeek, Image, 教學, 工具, Linux, 編程, 語音

VeriSpoof 偵測深偽語音並追查來源

VeriSpoof 不只判斷錄音是真是假,也能比對生成來源、定位合成片段,並用可核對的短句解釋判斷依據。

VeriSpoof: beyond real or fake

面對疑似深偽語音,單一真假分數往往不足以支援鑑證;調查者還要追查生成系統、比較兩段錄音是否同源,並確認結論依據。VeriSpoof 是一個語音鑑證音訊語言模型項目,以同一組權重處理這些問題,並將判斷寫成可對照音訊與資料標籤的短句。

它不另設偵測或來源驗證專用輸出頭,而是比較模型對不同答案句子的可能性,將差值用作分數。解釋可涵蓋頻寬、訊噪比、音量、聲道影響、合成片段位置與來源特徵;這令使用者能檢查模型提出的線索,而非只收到「真」或「假」的結論。

VeriSpoof-Plus 在 Speech-DF-Arena 的 14 個測試集取得 2.14% pooled EER,在 28 個系統中排第三,並在開放權重系統中排名第一。同一組權重亦能比較訓練時未見過的生成器來源,EER 為 6.2%;在 PartialEdit 測試中,經推理的理由能找出 99.6% 的局部偽造片段,一步作答則為 78.4%。

項目同時提供 VeriSpoof-Base 和 VeriSpoof-Plus 模型、推理套件、線上示範及 VeriSpoof-Bench 資料集;可先用示範查看錄音分析結果,再以推理套件離線處理測試音訊。訓練只更新 2.85B 參數中的 29.7M,項目稱可在一張 24 GB GPU 上完成訓練,但這不代表推理資源需求相同。

  • 一套權重支援真假判斷、來源比對與語音鑑證解釋。
  • 局部偽造定位有助檢查整段錄音中只被修改的部分。
  • 開放權重版本在指定基準取得具競爭力的結果,不能直接推論為適用所有語言、錄音條件或生成器。
  • 鑑證團隊與研究人員可用示範、離線推理套件及基準資料集檢查輸出;關鍵判斷仍應回到音訊與來源證據核實。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 模型訓練, Qwen, Audio, 語音, Dataset 數據集

Craft Anything:讓 AI 複製網站、應用程式與遊戲

描述想做的網站、應用程式或遊戲,Craft Anything 會檢查參考作品,再讓 AI 編碼代理建立新項目並比對結果。它預設不讀取原作程式碼或檔案,並提供逐項檢查與人工核准。

ArtCraft

想參照一個網站或遊戲製作自己的版本,難處往往不只是寫程式,還要反覆檢查外觀和功能是否接近。Craft Anything 是以 Rust 編寫的開源 AI 建置工具:它用檢查工具觀察目標,再交由編碼代理建立新項目、比對成果並逐步修正。

預設的 Clean room 模式不讀取原作的程式碼、檔案或頁面內容;使用者指定目標並描述需求後,系統透過檢查工具了解原作,再生成獨立的新項目。網站項目會逐項列出檢查結果和相似程度,計劃介面則顯示尚未完成的步驟;超出規則的操作會先要求使用者核准。這讓製作過程有明確的檢查點,但相似度不等於功能完全一致,仍需人工確認成果。

進階模式可查看完整工作台,包括工具、函式、字串與 pseudo-C;Deep 模式則會讀取目標程式的程式碼和檔案,適用於私人用途。兩種模式在可檢查資訊和資料界線上不同,使用者需要按目標來源及用途選擇,不能把 Clean room 的限制套用到 Deep 模式。

項目目前處於 early alpha,支援 macOS、Windows、Linux、FreeBSD 和 Web。文件沒有提供可供比較的效能測試或一致性分數,因此現階段較適合用來探索 AI 輔助複製介面與功能的工作流程,而非直接當成成熟的自動重建工具。

  • 可指定網站、應用程式或遊戲作參考,並以文字描述想建立的版本。
  • AI 編碼代理建立新項目後,系統會比對結果並協助修正。
  • Clean room 預設不讀取原作程式碼、檔案或頁面內容;Deep 模式會讀取程式碼和檔案。
  • 檢查結果、計劃進度及操作核准流程,讓使用者能追蹤建置狀態。
  • Rust 開源項目仍屬 early alpha,文件未列出效能基準。

GitHub

Categories: 開源, 工具, Mac, Linux, 編程

Page 1 of 187
1 2 3 … 187