ComfyUI-FL-YuE2:ComfyUI 內砌歌:FL YuE2 把樂譜編輯、AI 作曲、LoRA 訓練三件事接起來

ComfyUI-FL-YuE2 是一組節點,把 YuE2-3B 音樂模型包進 ComfyUI 工作流,讓你用鋼琴卷軸寫樂譜、灌歌詞,最後輸出 48 kHz 立體聲成品,亦支援 AR LoRA 訓練。

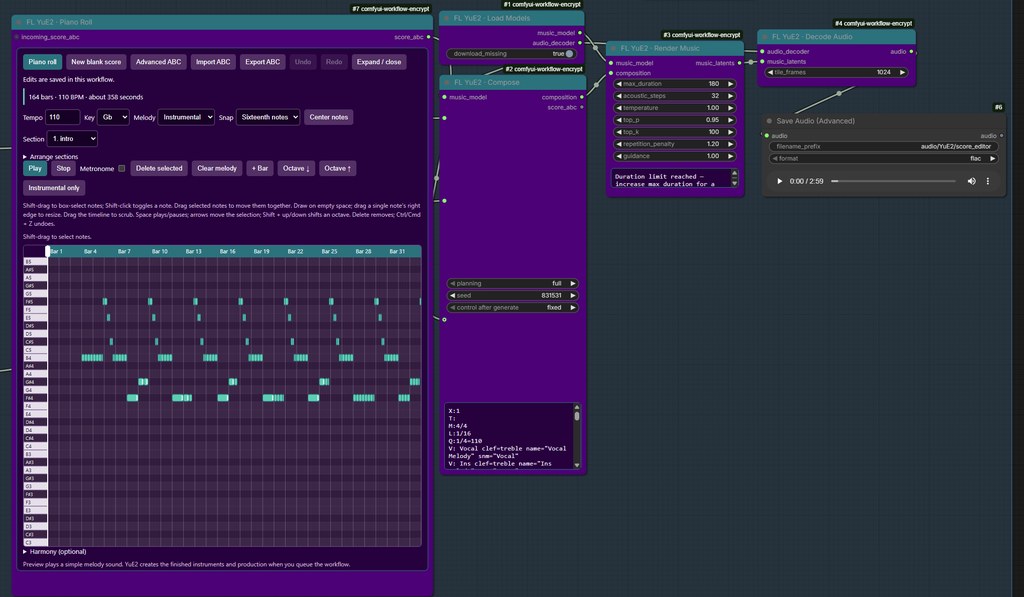
YuE2 inference workflow in ComfyUI

以往想在 ComfyUI 玩音樂生成,往往要面對幾個卡位:要自行接 YuE2 的推理指令、要另外找譜面編輯工具、想做 LoRA 微調更要跳出 ComfyUI 自己搞訓練腳本。FL YuE2 嘗試一次解決這三件事,把樂譜編輯、AI 作曲、AR LoRA 訓練全部接成節點流程,對熟悉 ComfyUI 圖形化工作流的用家算是頗順手的整合。

項目核心是一個可視化鋼琴卷軸編輯器,支援點擊加音、Shift 框選、箭頭鍵移動、Undo/Redo 等基本操作,並提供 Instrumental 或 Sung 旋律模式。和弦面板可摺疊,匯入的 ABC 樂譜會保留 slash chord 等進階標記。換 Key 時同時處理旋律與和弦根音,最短轉調、超出音域會直接拒絕而非裁切音高,設計上偏向「樂理正確」多於「暴力生成」。

音訊輸出走 YuE2-3B 加獨立 VAE 解碼器,產出 48 kHz 立體聲,內建瀏覽器合成器可預覽節段節拍,但並非最終成品音色。LoRA 訓練流程則提供數據集檢視與 checkpoint 預覽,方便用家挑選權重繼續微調。

重點摘要
– 屬於 ComfyUI 自訂節點套件,整合 YuE2-3B 音樂生成與樂譜編輯
– 鋼琴卷軸支援框選、群組移動、Undo/Redo,轉調按樂理而非裁切處理
– 推理與 AR LoRA 訓練共用同一組節點,方便迭代
– 需 NVIDIA GPU 支援 BF16,已驗證 RTX PRO 6000 Blackwell,其餘 24 GB 配置未經驗證
– 首次執行約下載 7.8 GB 模型權重,支援中斷續傳與離線模式

適合已有 ComfyUI 基礎,又想嘗試可控音樂生成或自訓風格 LoRA 的用家。注意目前僅在 Windows + Python 3.12 + Torch 2.11 環境驗證,跨平台或較舊 GPU 仍需自行測試。
GitHub

Categories: 開源, ComfyUI, 模型, 模型訓練, NVIDIA, Audio, Python, 音樂, Dataset 數據集, 廣東話

ComfyUI-DLSS5-Enhancer:強化影片材質細節

呢個 ComfyUI 節點包直接調用原生 D3D12 渲染管線,把遊戲級嘅 DLSS 5 Neural Rendering 套到影片幀上面,重建皮膚、頭髮同布料嘅材質反應,而不只是銳化。

Repository image for Blueforcer/ComfyUI-DLSS5-Enhancer

一般後製銳化或 AI upscale 工具處理嘅多數係邊緣同紋理,皮膚嘅次表面散射、頭髮嘅光線穿透呢類材質反應好難靠濾鏡模擬。Blueforcer/ComfyUI-DLSS5-Enhancer 選擇咗另一條路:將 ComfyUI 內部嘅 RGBA8 幀傳去一個原生 D3D12 worker,由 ReShade 載體配合 RenoDX DLSS 5 add-on 觸發 NGX feature 18,重建完再送返 ComfyUI,仲支援 1.5x 到 3x 升頻。影片本身冇 motion vectors,佢哋用 OpenCV DIS 做稠密光流逐幀估算,並喺場景切換時自動重置 history,等渲染器唔會將錯誤嘅時序資料傳入去。

呢個項目嘅類型係工具 / 節點包,定位好明確:畀 ComfyUI 用戶喺影像同影片工作流直接用 DLSS 5 嘅神經渲染器。佢唔係一個自帶模型嘅外掛,神經組件係 NVIDIA、ReShade、RenoDX 嘅原生 binary,呢個 repo 只負責實作 client side 嘅二進制協議,包括 session 建立、解像度協商、幀序、取消同診斷。

NVIDIA DLSS 5 In ComfyUI Changes EVERYTHING! Full Setup Guide

硬件要求 NVIDIA RTX 50 系列原生支援,透過社區 runtime 可以喺 RTX 40 同 30 上面跑,RTX 20 或更早直接拒絕。ComfyUI 需要 V3 node API(comfy_api.latest),Python 依賴 numpy、av 同 OpenCV,ComfyUI portable 通常已經內建。

幾個重要限制:nr intensity 鎖死喺 1.0,1.0、1.5、2.0 嘅輸出 bit identical;skin structure strength 必須開啟 automatic mask 先有效,閂咗之後所有皮膚參數都唔再產生變化;nr preset 喺任何數值下都係 bit identical。只有 local structure strength 同 local tone strength 係全程範圍真正可調。預設、J、K 幾個 dlss model preset 嘅源幀 detail energy 大約喺 0.56x 左右,呢個唔係銳化工具想要嘅走向,反映嘅係材質重建比邊緣強化重要嘅設計取向。

適合已經用 ComfyUI 做影片後製、CG 合成、AI 動畫修復或者數字人相關工作嘅團隊同個人創作,尤其係想處理 skin、hair、fabric 呢類容易被傳統濾鏡抹平嘅材質細節嘅場景。留意到嘅限制係 GPU 受限於 NVIDIA,而且沒有 Python API,調用方式只能透過 ComfyUI 節點流程。

GitHub

Categories: 開源, ComfyUI, AI productions, 數字人, NVIDIA, API, Video, Image, 工具, 3D, Python, 動畫

World in World 把 14B 世界模型變成你的虛擬攝影機

想用一條普通影片就做到 360 度重拍、子彈時間、視角切換?World in World 讓凍結的 14B 影片世界模型 LingBot-World 2.0 直接「走進」影片,無需微調,單卡 80GB GPU 即跑。

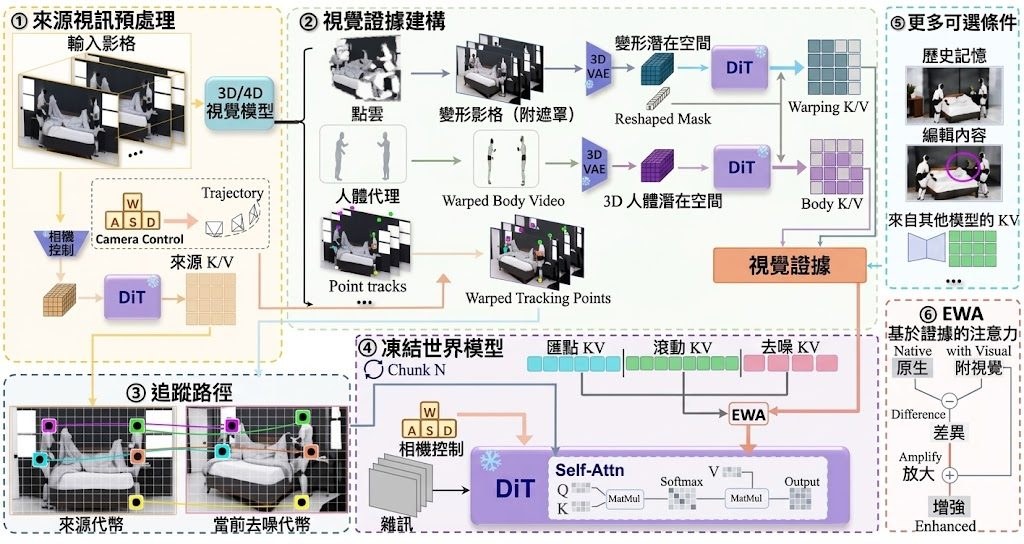
pipeline

對於做特效、剪輯或沉浸式內容的人來說,最頭痛的往往不是生成新畫面,而是手上明明有一段拍好的影片,卻想換個角度、換條鏡頭軌跡重新「拍一次」。Westlake-AGI-Lab 推出的 World in World,正是針對這個卡位:給定一段輸入影片和一條新相機路徑,模型會重新生成同一事件在新視角下的畫面,不用訓練、不用微調。

它本質是一個影片再攝影框架,骨幹是一個凍結的 14B 影片世界模型 LingBot-World 2.0。技術上沒有走 latent editing 或 GAN 反轉的老路,而是把所有可控制的訊號——來源影片、場景幾何、相機參數——全部變成視覺證據:先用深度把來源幀提升到 3D,依新相機路徑 warp 過去,再當成額外 key/value 塞進模型自己的 attention,讓模型「看到」新相機應該看到什麼,缺失的部分由它自己補完。這種做法讓相機軌跡、人物動作與場景幾何保持高度一致。

從結果來看,它已經放出自由相機重拍、子彈時間和影片編輯三項功能;大型角度 360 度重拍結合 3D 人體代理、跨模型記憶共享、長影片 frustum memory、串流互動生成、動作遷移等仍在路線圖中。對特效團隊、短片創作者、遊戲過場預覽、AR/VR 內容開發者來說,可以用一條現成素材快速產出多視角版本,而不必從零生成或手動三維重建。

官方在 Linux 上以 80GB A100 測試,峰值記憶體約 72GB,需 CUDA 12.4 與 Python 3.10,並預編譯 flash-attn wheel 以避免從源碼編譯。相較同類影片重生成方案,它放棄了對模型本體做適配,以 warp + attention injection 換取「即插即用」與較低硬體門檻,但代價是大角度旋轉、人物遮擋等極端情況仍依賴後續的 3D 代理與 frustum memory。

  • 凍結模型免訓練:以 warp 後的視覺證據作為 attention key/value,無需微調 14B 世界模型。
  • 多視角影片重拍:支援弧線、推拉、平移、定點旋轉等自由相機路徑。
  • 子彈時間與影片編輯:凍結任意一幀改變視角,或改第一幀讓編輯自然延伸至整段。
  • 單卡 80GB 可跑:Linux + A100 + CUDA 12.4 + Python 3.10,硬體門檻相對可控。
  • 路線圖仍在擴展:360 度重拍、跨模型記憶、串流生成等功能陸續排程中。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 世界模型, 模型訓練, NVIDIA, Video, 框架, Content Creator, 3D, Linux, Python

Edge0 開源框架:Mac 本機推論 35B MoE,記憶體僅佔用 2.9 GB

Edge0 是一套開源串流 MoE 推論框架,靠 SSD 專家卸載搭配 LoRA 還原與前置路由器,在 Apple Silicon 上把 35B 等級的 MoE 模型壓到 2.9 GB 活動記憶體就能跑,對想在筆電本機玩大型稀疏模型的人來說是個務實的選擇。

edge0

MoE 模型參數規模愈推愈大,但真正能在消費級硬體本機跑得動的方案一直不多。Edge0 想處理的就是這個落差:它把 SSD 專家卸載、Recover-LoRA 還原、以及 prerouter 路由預測這三招組合成一套可擴展框架,目前以 MLX 後端跑在 Apple Silicon(M1 至 M4)上,CUDA 後端列在路線圖但尚未支援。

隨框架釋出兩個模型檔:edge0-35b(基於 Qwen3.5-MoE 35B-A3B)與 edge0-8b(基於 Ling 3.0 bailing 混合架構),皆以 4-bit 量化釋出。LoRA 配重與 prerouter 頭已隨 checkpoint 一同發佈,edge0 serve 即可直接載入訓練好的完整管線,不用額外拼湊組件。短上下文情境下,edge0-35b 峰值活動記憶體約 2.9 GB,edge0-8b 約 1.0 GB;專家權重以 mmap 方式按需讀取,不會預先佔用 RAM。

TierReleased checkpointInference profile
edge0-35bEdge0/Edge0-35B-A3B-preview4-bit, 40 layers, 256 experts, prerouter K=4
edge0-8bEdge0/Edge0-8B-A1B-preview4-bit, 24 layers, 128 experts, prerouter K=8

使用介面提供 AutoModel、AutoConfig、AutoEngine 自動按模型名稱解析層級。所有 MLX 程式碼集中在 edge0/backends/mlx/,核心邏輯只依賴抽象層,因此日後加入 CUDA 等後端時不必重寫調度邏輯。

  • 類型:開源 MoE 推論框架(搭配兩個預訓練 checkpoint)。
  • 資源門檻:4-bit 35B 模型約 23 GB 磁碟、2.9 GB 活動記憶體;8B 模型約 4.2 GB 磁碟、1.0 GB 活動記憶體。
  • 硬體限制:目前僅支援 macOS Apple Silicon,CUDA 仍在規劃中。
  • 目標用戶:想在 M 系列 MacBook 上本機試跑大型稀疏模型的研究者、開發者,以及對 VRAM 不夠、又不願完全依賴雲端推論的團隊。
  • 差異化:相較純量化或純卸載方案,Edge0 把 prerouter 預測與 LoRA 還原包進同一條管線,讓卸載後的精度損失有明確補償路徑。

Edge0 屬於「先把本地大型 MoE 跑起來」這個務實路線上的工具,限制也很清楚:必須在 Apple Silicon 上跑、長上下文 KV 會額外吃記憶體、目前沒有非 Apple 平台的後端可用。對想驗證稀疏模型在消費硬體可行性的人,這套框架省去了自行整合卸載與適配器還原的功夫;對 NVIDIA 用戶,則要等 CUDA 後端落地。

GitHub

Categories: 開源, 模型, Qwen, NVIDIA, 框架, 工具, Mac, 蘋果

SyncWorld:用一段影像校準,讓世界模型零樣本遷移到新機械人

同一個數值動作換了鏡頭或機械人就失效?SyncWorld 以「視覺校準片段」作為提示,讓單一世界模型即時推斷動作與畫面嘅對應關係,毋須再為每個環境重新微調。

SyncWorld teaser

動作數值喺像素空間其實唔係通用語言——換鏡頭、換機械人位置、換機械結構,同一個動作指令就會產生唔同嘅視覺效果,亦即係點解用混合數據訓練出嚟嘅動作條件世界模型(action-conditioned world model)喺新場景入面成日失效。SyncWorld 嘅切入角度係:既然動作同畫面嘅對應因環境而異,不如用一段包含每個可控自由度(DoF)嘅短影像校準片段(visual calibration episode)做 in-context prompt,等模型喺推論時即場估計呢套環境嘅 Action–Visual Mapping,從而把單一 checkpoint 變成零樣本(zero-shot)模擬器,毋須額外訓練。

基於 NVIDIA Cosmos-Framework 改寫而成,並非由零開始砌嘅新網絡。對比一般針對單一機械人做 fine-tuning 嘅做法,SyncWorld 用視覺證據取代權重記憶;訓練時混入 calibration context 之後,模型仲學識喺冇 calibration 嘅情況下落返去用互動歷史做預測。程式庫提供分散式 FSDP trainer、typed TOML 食譜同原生 DCP checkpoint,可以直接匯出 HuggingFace safetensors;評估就用全段自回歸 rollout,配合 PSNR、SSIM、LPIPS 量度像素相似度。

直接受惠:需要喺多款 xArm、ARX5、KUKA、Franka Panda、UR5e 等異質平台上做 sim-to-real 想像嘅機械人研究團隊;做測試時策略改進(test-time policy improvement)而唔想再花錢訓練嘅 RL 團隊;以及想避開「每個新 setup 都要重新標註動作」呢個樽頸嘅數據團隊。Demo 顯示佢能準確模擬未見過嘅設定入面嘅動作後果,並令策略喺測試階段靠 rollout 改善而毋須再訓練。

重點摘要:

  • 以視覺校準片段作為 in-context prompt,免去 per-deployment fine-tuning
  • 訓練同時令模型能喺冇 calibration 時回退用互動歷史
  • 基於 NVIDIA Cosmos-Framework 改寫,提供 FSDP 訓練同 DCP checkpoint
  • 評估用全段自回歸 rollout,配 PSNR、SSIM、LPIPS 指標
  • 模型權重同評測集已開喺 HuggingFace:yyuncong/SyncWorldyyuncong/SyncWorld-Evaluation

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 世界模型, 模型訓練, NVIDIA, Image, Robotic, 框架, AGI, Dataset 數據集

OmniEvalKit:唔使重新訓練 VLM 都可以聽聲答問題

MBZUAI Oryx 團隊把 OmniEvalKit 開源出嚟,主打唔使改動 VLM 任何參數,就為佢加掛語音理解能力。對於想評估或部署多模態模型嘅團隊,可以直接拎現成骨幹即試。

Training-Free Omni

想為一個視覺語言模型加入語音理解,但又唔想重新訓練?MBZUAI Oryx 團隊開源嘅 OmniEvalKit(Training-Free Omni)就正正針對呢個痛點。它把語音先經 Whisper 抽取成帶時間戳、語言同信心分數嘅結構化文字,再連同圖片或影片幀一齊餵俾凍結嘅 VLM,所有推理都沿用原本嘅 prompt 接口,骨幹權重全程不動。換句話講,任何新嘅視覺骨幹都可以即插即用,毋須再做語音—視覺對齊微調。

它同時係一個統一嘅多模態評測框架,支援文字、圖片、影片、音頻同音視頻任務,並預載 118 個資料集適配器,涵蓋 Qwen、Gemma、MiniCPM、VILA、OmniVinci 等模型,方便做公平對齊測試。對研究人員同部署團隊而言,最直接嘅好處係可以一次過跑 56 個 benchmark、21 種語言,直接比較凍結骨幹同原生 omni 模型之間嘅差距,睇下語音能力究竟係新加出嚟定係由舊能力交換得嚟。

如果你關心 VLM 加掛語音後會唔會「失憶」,呢套框架正正提供 matched comparison,可以量化評估圖像理解、視覺定位、編碼、數學等原有強項有冇被削弱。額外支援嘅 CosyVoice3 文字轉語音輸出,亦令文本答案可以直接變成語音回覆。

要本地跑得起嚟,需要 Python 3.10+、ffmpeg,再針對 CPU、CUDA 或 ROCm 安裝對應嘅 PyTorch。之後透過 eval.sh 配環境變數指定模型同資料集即可開跑,加 MAX_SAMPLES=3 可以做煙霧測試,中斷後設 RESUME=True 可以接返。

以下係幾個值得留意嘅重點:

  • 凍結骨幹、零微調:所有 VLM 權重完全不變,語音理解透過 Whisper 抽取文字證據再加 prompt 融合達成。
  • 即插即用嘅 omni 能力:支援 Qwen2.5-Omni、Gemma、MiniCPM、VILA、OmniVinci 等多個模型適配器,方便横向比較。
  • 覆蓋廣嘅評測矩陣:內置 118 個資料集適配器,涵蓋 56 個 benchmark 與 21 種語言。
  • 原生 omni 同凍結骨幹嘅 matched 對照:可以清晰分辨新增能力同保留能力,避免重訓帶嚟嘅 capability drift。
  • 可選語音回覆:透過 CosyVoice3 把文字答案合成語音輸出,適合對話式場景。

項目主頁 · GitHub

Categories: 開源, 文字轉語音, AI productions, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, Image, 框架, Python, 語音, Dataset 數據集

MiniMax H3 Semantic Bridge:單卡煉成的極輕量視頻生成適配器

約 11 MB 的小型適配器,可在不改動 H3 權重的情況下,把跨架構語意信號融入 MiniMax H3 的視頻生成流程。

Og image

由社群開發者 speach1sdef178 發佈的 MiniMax H3 Semantic Bridge,基於 MiniMaxAI 嘅 MiniMax-H3 進行延伸,定位係一個輕量嘅 conditioning-space 適配器,主要服務於標準 H3 FL2VA 文字生成視頻流程,整個項目僅用單張 NVIDIA RTX 3090 Ti 24 GB 完成訓練,並無動用多 GPU 叢集。

這並非 LoRa、checkpoint 合併或傳統的參數轉接。此適配器在影片Transformer之前轉換原生H3條件,並將學習到的語意表示以可控強度融合回H3。佢嘅核心做法係將原本用於 SenseNova U1.5 嘅語意表示,透過跨架構遷移與蒸餾,壓縮成一個獨立嘅小型檔案(MiniMaxH3_SemanticBridge_v1.safetensors)。使用時 SenseNova 完全唔需要載入,適配器會喺視頻 transformer 之前轉換 H3 嘅原生 conditioning,再以可控強度將學到嘅語意信號混合返入 H3。檔案本身只有約 11 MB,並唔係 LoRA、權重合併或者傳統參數嫁接,安裝方法係將 MiniMax_H3_Semantic_Bridge_v1.0.zip 解壓至 ComfyUI 自訂節點目錄,再將適配器放入新增嘅 ComfyUI/models/semantic_bridge/ 資料夾即可。

目前 v1 只支援文字條件嘅標準 FL2VA 流程,Ref2VA 參考圖生成或參考音訊工作流並唔適用。官方亦提到,喺參考音訊場景插入呢個適配器時,唱歌同嘴型同步表現會明顯下降,因此使用前要留意任務邊界,避免硬套落唔支援嘅流程。呢個項目提供咗 examples/ 對照素材、workflow JSON 同研究文章,方便用家直接喺 ComfyUI 內做 Native H3 同 Semantic Bridge 嘅 A/B 比較。

重點摘要:

  • 基礎模型:MiniMaxAI/MiniMax-H3,定位係 H3 嘅 conditioning-space 適配器而非權重合併。
  • 檔案規模:約 11 MB 嘅獨立 .safetensors,外加 ComfyUI 自訂節點 zip 同 workflow JSON。
  • 訓練條件:單張 RTX 3090 Ti 24 GB 完成,無需多 GPU 叢集,SenseNova 只用於訓練階段。
  • 支援範圍:適用於 H3 FL2VA 文字生成視頻,Ref2VA 同參考音訊流程未獲支援。
  • 整合方式:放入 ComfyUI custom nodes,並透過新增節點將 conditioning 同 latent 注入原有 H3 流程。

項目主頁

Categories: 開源, ComfyUI, 模型, 視頻模型, 模型訓練, NVIDIA, Video, Audio, MiniMax

VDN-H3 開源:14 秒 MiniMax 影片生成只花 11 秒

OpenVDN 團隊將 softmax 與線性注意力混合架構(hybrid attention)套用到 MiniMax H3 影片生成模型,在 8 張 B200 上以 8 步去噪產出 14.4 秒 768p 影片,速度比播放還快。

Repository image for OpenVDN/vdn-minimax-h3

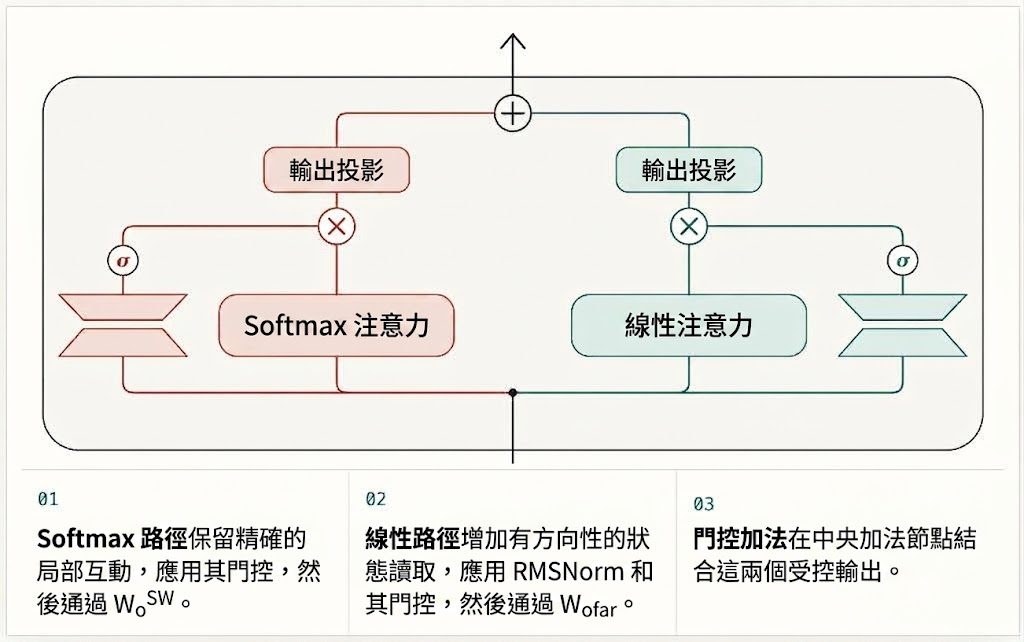
影片生成最貴的部分往往不是參數量,而是長序列上的 softmax attention。VDN-H3 針對這個痛點,把 MiniMax H3 骨幹拆成兩條互補分支:滑窗 softmax 負責鄰近幀之間的精細對齊,線性注意力則接手長距離語境與主體一致性,並用 4 向邊界錨點補強全域結構。最終在 8 張 NVIDIA B200 上,用 8 步去噪就能在 11.23 秒內生成 14.4 秒 768p 片段,生成速度比播放還快。

與同類做法的差異在於「近乎無損」這個定位。純線性注意力雖然快,但長序列下容易丟失主體身份、場景佈局與時序依賴;VDN-H3 透過混合架構把這部分成本交回給局部 softmax,線性分支只負責長程記憶,因此視覺品質與原版 H3 幾乎難以區分,也比 MiniMax FastH3 有更好的指令跟隨能力。對需要高吞吐量同時不犧牲一致性的團隊,這個取捨相當實用。

部署面需要 PyTorch 2.13、CUDA 12.9 與 FlashAttention 4(含 nvidia-cutlass-dsl 預釋版依賴),另外還要安裝一份修補過的 Diffusers;骨幹權重不需更動,兩條 LoRA adapter 可在推理時合併進去,等同 plug-and-play 替換。程式碼、訓練流程與優化後的推理 stack 一併開源,研究者與影片生成產品團隊都能直接複用。

重點摘要

  • 8 步去噪、8 張 B200,11.23 秒生成 14.4 秒 768p 影片,生成快過播放。
  • 混合 attention:滑窗 softmax 保留局部細節,線性分支負責長距離語境。
  • 視覺品質與原版 MiniMax H3 近乎無損,比 FastH3 指令跟隨更佳。
  • LoRA adapter 可合併進骨幹推理,不需更動原始權重。
  • 權重、推理 stack 與訓練程式碼同步開源。

項目主頁 · GitHub · 模型· ComfyUI 節點

Categories: 開源, AI productions, 視覺模型, 多模態模型, 視頻模型, NVIDIA, Video, Python, MiniMax

RoboTok:用 YouTube 影片教機械手做家務

RoboTok 把網上大量的人手操作影片變成機器人訓練素材,對應一段示範就能自動撈出動作相似的影片做模仿學習,等 AI 機械手多了一條低成本數據來源。

Retrieval embedding space and example clips

想訓練機械手做家務,最貴的部分往往不是模型,而是數據。RoboTok 由 Rice University 及 NVIDIA 合作開發,直接從海量網絡影片中撈取人手操作片段,再交給擬人機械手學習。它屬於一種數據引擎兼策略學習框架,把「找對數據」這一步自動化掉。

核心做法是把人手動作抽成以軀幹為基準的 3D 手部軌跡,再學一個嵌入空間,用 DTW(Dynamic Time Warping)相似度作監督,令同一種操作(例如倒水、摺衫)在不同鏡頭、不同人、不同場景下都能對齊。查詢時只要給一段示範影片,系統就用 cosine similarity 找出動作最相近的網絡片段。

  • 以軌跡為單位做檢索:避開外觀差異,直接比動作本體,所以鏡頭變、場景變、人變都唔會影響配對。
  • 配套軀幹估計模型:用雙手軌跡反推出身體/軀幹參考框,減少裁切與遮擋帶來的偏差。
  • FAISS + GPU DTW:向量檢索用 FAISS,DTW 內核用 numba CUDA,跑大規模影片庫唔會慢到難以迭代。
  • 機械人策略學習閉環:檢索結果直接餵下游模仿學習,做擬人機械手 policy 訓練,並已在仿真及真機任務做評估。

同類做法多數只用影片幀或粗糙動作標籤做檢索,容易被背景雜訊干擾。RoboTok 走 3D 手部軌跡嵌入這條路,換來更精準的動作匹配,但代價是 pipeline 較重:要裝 MANO/SMPL-H 體模、CUDA 環境,再跑一套自帶的訓練與評估流程。

最受惠的是做擬人機械手、靈巧操作(dexterous manipulation)研究的團隊,以及想用低成本網絡影片取代部分遙操作數據的工作小組。對只想要開箱即用機械人策略的人來說,門檻仍然偏高;對做數據策展與 representation learning 的人,呢套引擎本身就值得參考。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型訓練, NVIDIA, Robotic, 3D

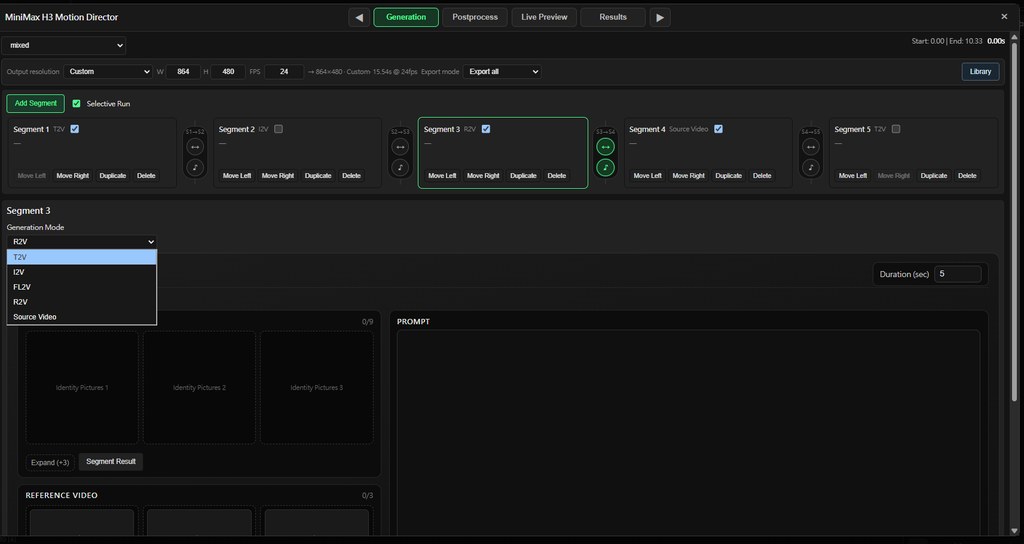
MiniMax-H3-Motion-Director 全能導演台節點

ComfyUI 自訂節點 Motion Director 將 T2V、I2V、V2V 等多段生成整合到同一介面,支援分鏡重跑、跨鏡頭連貫與即時預覽,讓多片段 AI 影片製作不再被節點海淹沒。

MiniMax H3 Motion Director — Mixed Mode

用 ComfyUI 砌 AI 影片嘅朋友,多數都經歷過呢個困局:想做一個有五個鏡頭嘅項目,要由零開始接 T2V、I2V、V2V 各種 workflow,每段調好參數再串埋,節點一多就連自己都搞唔清邊段行緊、邊段要重做。Motion Director 想處理嘅就係呢個問題——佢係一個 ComfyUI 自訂節點,把多段影片生成收納到同一個 Director 介面,等你可以逐段揀唔同生成方法(T2V / I2V / FL2V / R2V / V2V / RV2V),又唔使為咗切換而重新拉整個圖。

佢同一般 ComfyUI 工作流最大嘅分別,係圍繞「項目」做設計。Director 介面入面有 Segment、Multi Segment、Final Result 三層檢視,亦有 Director Live Preview 即時顯示邊段行緊、邊段做完。跨段連貫靠 Motion Context、Context Frames、Latent Scale Lock 同生成音訊接續,仲可以將上一段已解碼嘅幀直接當下一段嘅 I2V/FL2V 輸入,避免每次都重新生成首幀。素材方面提供 Common References 同持久化 Material Library,圖、音、影片、提示詞都可以重複用。

另一個貼地嘅設計係 Selective Run——只要揀要重做嘅片段就得,唔使成條 pipeline 重跑,配合 MIXED 模式用,可以幾段文生、幾段圖生、幾段源影片剪輯混埋做項目。Director 本身係 OUTPUT_NODE,最尾嗰格就可以輸出畫面、音訊同 FPS 畀下游 ComfyUI 節點繼續接。後製方面內置 Global Refine、放大、可揀 NVIDIA RTX VSR / Deblur 同 Face Refine,不過 VSR/Deblur 要相容 NVIDIA VFX runtime,Face Refine 要 UI 揀好對應 detector/SAM 路徑。

適合要處理多鏡頭、有分鏡表、要保持視覺同音訊一致嘅創作者,例如廣告原型、MV 概念、敘事短片預覽,或者要把源影片做局部 V2V/RV2V 修補嘅後期流程。生成方面支援內建 sampling 或外部 ComfyUI SAMPLER + SIGMAS,方便想自己控制 noise schedule 嘅人。版本去到 v1.2.0,採用 GPL-3.0;硬件門檻就睇你揀嘅功能——基本生成跟返 ComfyUI 一般配置,想用 VSR/Deblur 或大尺寸放大就要 NVIDIA 顯卡同對應 runtime。

重點摘要:

  • 多段整合 Director 介面:T2V/I2V/FL2V/R2V/V2V/RV2V 同一畫面揀,逐段切換唔使重拉 workflow
  • Selective Run + Mixed Mode:只重跑指定片段,唔使成條 pipeline 由頭嚟
  • 跨鏡頭連貫:Motion Context、Context Frames、Latent Scale Lock 同音訊接續,仲可以重用上一段解碼幀
  • 內建 Live Preview 與三層檢視:Director 介面直接睇 Segment/Multi Segment/Final Result
  • 後製選項齊全:Global Refine、放大、可選 RTX VSR/Deblur 與 Face Refine,對硬件有特定要求

GitHub

Categories: 開源, ComfyUI, AI productions, NVIDIA, Video, 框架, , MiniMax

Page 1 of 11
1 2 3 11