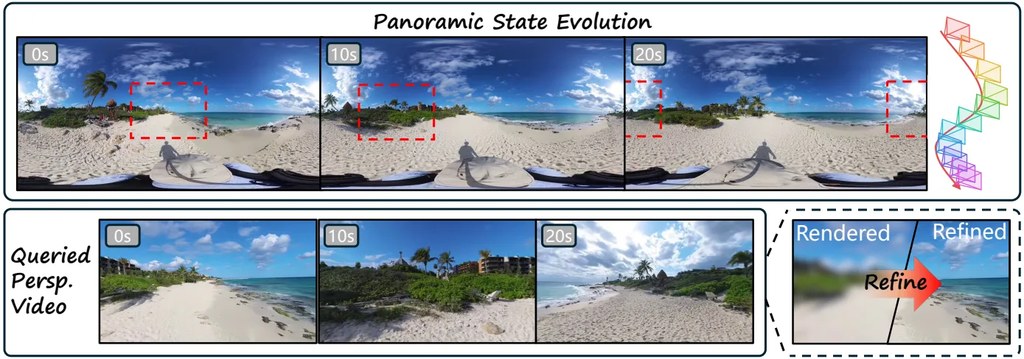
AlayaVista:全景潛態驅動嘅可串流世界模型

AlayaVista 從一張透視圖出發,建立 360° 全景先驗,再隨鏡頭動態演化作為視點潛態,逐區塊渲染並局部精煉所選畫面,做流暢且高保真嘅可控影片生成。

AlayaVista evolves panoramic states under camera control and renders and refines the requested perspective views.

想由一張普通圖片,邊拉鏡頭邊即時生成高質影片,而又唔丟失 360° 場景記憶?AlayaVista 就係為呢個矛盾而設計——佢屬於世界模型(World Model)類研究原型,處理嘅係可控、可串流嘅影片生成問題。

核心做法分三步:先用一張透視圖估出完整 360° 全景先驗,模擬出 VR 風格嘅場景記憶;之後鏡頭控制訊號會驅動呢啲全景潛態持續演化,保持全局一致性;最後系統只渲染用戶當前視角所在嘅區域,並用潛態視口渲染與局部精煉做高保真合成。為咗兼顧速度與質素,佢採用 chunk-autoregressive 逐區塊自迴歸生成,配合少步蒸餾(few-step distillation),令串流過程唔使逐幀重頭計,全部運算力集中在真正需要輸出嘅視窗。

比起傳統逐幀擴散或全景一次性輸出嘅做法,呢種「全景當記憶、視口當輸出」嘅分工換嚟兩個明顯取捨:視窗畫面更銳利、代價係鏡頭一轉就要重新做視口對齊;同時間全景一致性同幀率都受惠於 chunk 邊界設計,對長鏡頭平移類場景特別友好。

幾個重點摘要:

  • 全景記憶 + 局部渲染:以 360° 全景潛態維持場景上下文,鏡頭視口獨立精煉,避免整段重算。
  • 鏡頭可控串流:支援 user-controlled camera 訊號輸入,邊互動邊生成適合遊戲引擎、VR 預覽或 cinematic pre-vis。
  • 效率設計:chunk-autoregressive 加 few-step distillation,專注運算力於選定視窗。
  • 仍屬研究階段:roadmap 列明推理代碼同預訓練權重尚未釋出,目前只可睇 paper 與 project page 嘅 demo。

呢類模型對做互動敘事、VR 內容預覽、遊戲關卡 walkthrough 嘅團隊最有直接參考價值,因為佢直接處理「鏡頭會行、背景要穩」呢個常見卡位。對純做離線一鍵出片嘅用家嚟講,呢類串流設計嘅優勢未必即刻見效,但對需要低延遲、長時序一致嘅創作流程,呢條技術路線值得留意。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 視覺模型, 視頻模型, 世界模型, Video, Image, 框架, 教學

BVB 用 影片內容令 AI 自動轉為 Blender 3D 場景

BVB 拋開選擇題,要求 AI 代理直接用 Blender 重建 288 段真實室內影片,從程式碼品質判斷它到底有冇真正理解畫面內容。

BVB logo

現時大多數影片理解 benchmark 都係問 AI 「張圖入面有幾多張椅」,但 BVB(Blender-VideoBench)行另一條路:畀 AI 睇一段室內影片,然後叫佢自己寫 Blender 腳本,把場景、鏡頭動線逐個 primitive 砌返出嚟。如果代理人交到一個可以重新開啟、可以渲染嘅 .blend 檔,代表佢真係睇明條片。

每個代理會都被困喺同一個 Blender 4.2 Docker 沙盒入面,淨係可以用 bashframes,仲有共享成本上限。禁止使用任何外部素材庫,幾何體全部由代理自己用基本操作砌出嚟。呢種「同條件競技」設計解決咗以往影片 benchmark 靠選擇題容易被 prompt hack 或者背答案嘅問題。

數據方面,BVB 用咗 ARKitScenes、ScanNet、ScanNet++ 嘅 288 段室內影片,配合 5,130 條時空題目,並涵蓋 10 個模型家族、共 51 個配置。評分用兩條軸:Dual VQA 睇重建場景保留幾多影片入面嘅時空事實;Latent Similarity 就用凍結影片 embedding 對比重建結果同原片嘅感知距離,再以平方根均值合成綜合分數。

對做空間智能、機器人感知或者影片理解研究嘅團隊嚟講,呢個 benchmark 提供咗一個更貼近「代理人真係要喺軟件入面操作世界」嘅測試場景。視頻生成、動畫製作或者世界模型團隊亦可以直接借用 Mini-BVB harness 喺自己 pipeline 度做壓力測試。

團隊結果顯示,最強配置喺 Latent Similarity 做到 88.6,但 Dual VQA 仲有明顯差距,代表現時頂級模型仲未做到「理解」同「重建」兩條線同步推進。呢個落差本身就係 BVB 想凸顯嘅訊號:識答題未必等於識建模。

重點摘要

  • 288 段真實室內影片,全部來自 ARKitScenes、ScanNet、ScanNet++ 嘅 held-out split。
  • 51 個代理配置橫跨 10 個模型家族,統一跑喺 Mini-BVB 沙盒同成本上限下。
  • 禁止使用外部素材庫,逼代理人由 Blender primitives 自己砌幾何。
  • 評分用 Dual VQA 加 Latent Similarity 兩條軸,避免單一指標偏廢。
  • 目標係可執行、可重新渲染嘅 .blend 檔案,而唔係文字描述或者單張圖。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, Embedding, 視覺模型, 多模態模型, 世界模型, Qwen, OpenAI, Gemini, Video, 軟件, , Anthropic, 動畫, Dataset 數據集

PhysBrain 1.5 統一三項能力,機器人世界模型走進單一詞彙表

PhysBrain 1.5 把語言、動作軌跡、未來畫面全部折成離散詞元,用同一個自迴歸骨幹同時回答、理解與預測。它基於 Qwen3-VL 構建,2B 與 8B 兩個版本已開源。

DeepCybo · Zhongguancun Academy · Zhongguancun Institute of Artificial Intelligence

PhysBrain 1.5 把機器人的「看懂」、「出手」、「預測下一步畫面」三件事,塞進同一個自迴歸模型裡。對做具身智能的人而言,最直接的體感差異是:不用再為理解、動作、預測各掛一個任務頭(task-specific head),全部以離散詞元(discrete tokens)在同一個 next-token prediction 目標下聯合學習。等於讓模型在推理時,能在語句、空間輸出、末端執行器軌跡、未來 RGB 影像之間自由切換。

對比同類路線,許多開源具身模型要嘛只做視覺語言理解,要嘛只做動作生成;PhysBrain 1.5 則強調三者共享詞彙表(vocabulary),並透過 ActionPiece 詞元把不同機械臂、控制配置統一在一個動作碼本(codebook)下。預訓練以人類互動影片為主,監督微調混入真人示教、真機軌跡與模擬經驗,等於把世界模型與策略模型壓進同一副骨架。

2B 與 8B 的權重已上傳 Hugging Face,開發者可透過官方評測工具 PhysBrainEvalKit 對齊 28 個具身基準測試。PhysBrain 1.5-8B 整體得分 72.5,在 14 個基準上排開源第一、10 個排第二。對機器人團隊或在做 VLA、世界模型研究的人,這套統一詞表的做法,是現時少數能把三者一齊端出來的開源選擇。

重點摘要:

  • 三能力統一:理解、動作生成、未來狀態預測共享同一個自迴歸骨幹與 next-token 目標,無需任務專屬輸出頭。
  • 基於 Qwen3-VL:以 Qwen3-VL 為起點,把語言、空間、軌跡與視覺詞元納入同一詞彙表。
  • 2B 與 8B 開源:權重已釋出至 Hugging Face,2B 適合邊緣部署,8B 瞄準基準測試表現。
  • 基準表現:PhysBrain 1.5-8B 在 28 個具身基準取得 72.5 整體分,14 項開源第一、10 項第二。
  • 配套工具:PhysBrainEvalKit 評測工具與官方 Demo 已上線,方便重現結果與部署測試。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 世界模型, 模型訓練, Qwen, Video, Image, VLA, Robotic, 工具

MaP-WAM:把記憶變成計劃

MaP-WAM 將機械臂長任務拆成「記憶 → 計劃 → 行動」三步,先保留稀疏視覺證據,再壓成固定長度的計劃執行,讓 executor 不再因歷史增長而越來越慢。

Repository image for aipixel/MaP-WAM

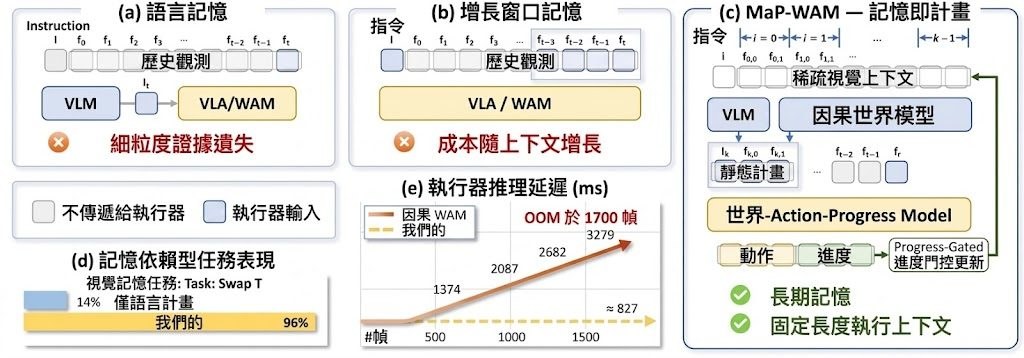
做過長任務的 robot policy 都知道,當動作序列拉長,模型要嘛靠語言摘要回憶過去,要嘛硬把一堆畫面塞進上下文,結果前者丟失精確視覺證據,後者則隨步數累積越來越慢。MaP-WAM 走的第三條路:把記憶視為「規劃時的證據」,而非「執行時的負擔」。它由哈爾濱工業大學、南洋理工大學及山東大學等團隊共同提出,屬於 VLA 框架與 World-Action Model 思路的延伸。

主流機器人策略通常採用馬可夫公式,但許多複雜的現實世界操縱任務本質上是非馬可夫的,需要超越當前觀察的長視野記憶。MaP-WAM 的核心分三層:每完成一段任務,便把該段的語言指令與少量真實執行幀打包成 episodic memory;之後由視覺語言模型生成下一段的語言計劃,並由因果世界模型補出對應的視覺引導;最後由 World-Action-Progress(WAP)模型在同一上下文內同時輸出動作 chunk 與進度,再以 plan-observation alignment 校正遞迴估計、以 progress-gated transitions 決定何時更新記憶並請求下一段計劃。由於已完成片段的 episodic 證據與當前計劃都可被 cache,executor 的上下文長度保持固定。

在 RMBench 上達到 83.3% 成功率、真機實驗約 78.0%,同時 executor 維持近似常數的 per-chunk 延遲。在三個長任務記憶方案中,這套設計拿來對比的恰是「語言記憶丟視覺證據」與「滑動視窗記憶吃 GPU」這兩個老毛病,並以固定上下文的方式直接拆解效率與覆蓋率的取捨。

適合關注機器人長任務、World-Action Model、VLA 框架的研究團隊與工程團隊參考。模型 checkpoint 標示為 Coming Soon,現階段只能讀 paper 與項目頁理解思路。

重點摘要:

  • Memory-as-Plans:將長任務記憶拆成「已完成片段的稀疏視覺證據 + 語言計劃」,而非把所有歷史塞回 executor。
  • WAP 模型:在同一上下文內同時輸出動作 chunk 與任務進度,並透過 plan-observation alignment 校正遞迴估計。
  • 固定上下文執行:已完成片段與當前計劃皆可 cache,executor 上下文長度不再隨歷史增長。
  • 對比清晰:直接挑戰語言記憶丟失視覺證據、滑動視窗吃 GPU 記憶體兩種主流做法。
  • 現況限制:訓練與推理程式碼、模型 checkpoint 均未釋出,目前僅有 paper 與項目頁可參考。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 世界模型, 模型訓練, VLA, World-Action Model, Robotic, 框架

World in World 把 14B 世界模型變成你的虛擬攝影機

想用一條普通影片就做到 360 度重拍、子彈時間、視角切換?World in World 讓凍結的 14B 影片世界模型 LingBot-World 2.0 直接「走進」影片,無需微調,單卡 80GB GPU 即跑。

pipeline

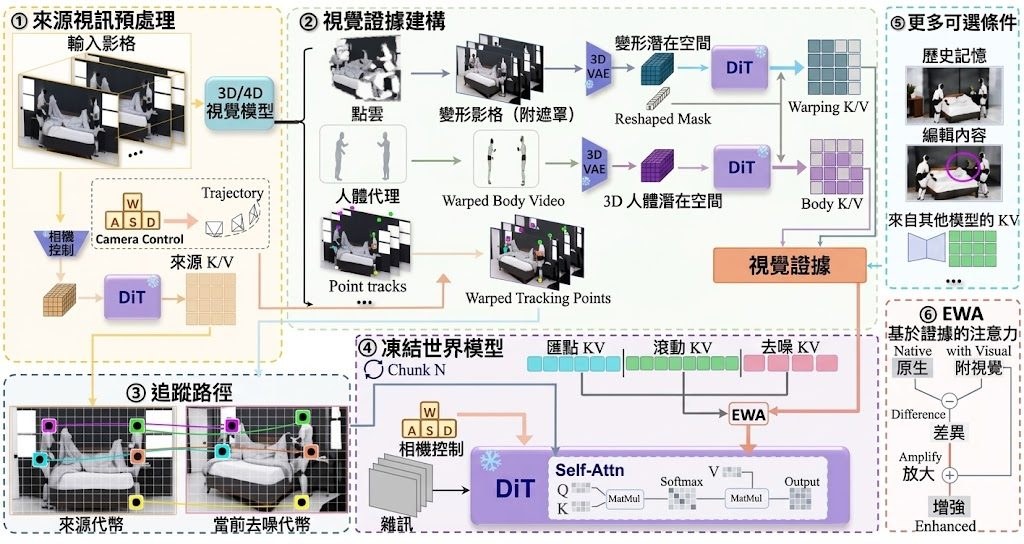
對於做特效、剪輯或沉浸式內容的人來說,最頭痛的往往不是生成新畫面,而是手上明明有一段拍好的影片,卻想換個角度、換條鏡頭軌跡重新「拍一次」。Westlake-AGI-Lab 推出的 World in World,正是針對這個卡位:給定一段輸入影片和一條新相機路徑,模型會重新生成同一事件在新視角下的畫面,不用訓練、不用微調。

它本質是一個影片再攝影框架,骨幹是一個凍結的 14B 影片世界模型 LingBot-World 2.0。技術上沒有走 latent editing 或 GAN 反轉的老路,而是把所有可控制的訊號——來源影片、場景幾何、相機參數——全部變成視覺證據:先用深度把來源幀提升到 3D,依新相機路徑 warp 過去,再當成額外 key/value 塞進模型自己的 attention,讓模型「看到」新相機應該看到什麼,缺失的部分由它自己補完。這種做法讓相機軌跡、人物動作與場景幾何保持高度一致。

從結果來看,它已經放出自由相機重拍、子彈時間和影片編輯三項功能;大型角度 360 度重拍結合 3D 人體代理、跨模型記憶共享、長影片 frustum memory、串流互動生成、動作遷移等仍在路線圖中。對特效團隊、短片創作者、遊戲過場預覽、AR/VR 內容開發者來說,可以用一條現成素材快速產出多視角版本,而不必從零生成或手動三維重建。

官方在 Linux 上以 80GB A100 測試,峰值記憶體約 72GB,需 CUDA 12.4 與 Python 3.10,並預編譯 flash-attn wheel 以避免從源碼編譯。相較同類影片重生成方案,它放棄了對模型本體做適配,以 warp + attention injection 換取「即插即用」與較低硬體門檻,但代價是大角度旋轉、人物遮擋等極端情況仍依賴後續的 3D 代理與 frustum memory。

  • 凍結模型免訓練:以 warp 後的視覺證據作為 attention key/value,無需微調 14B 世界模型。
  • 多視角影片重拍:支援弧線、推拉、平移、定點旋轉等自由相機路徑。
  • 子彈時間與影片編輯:凍結任意一幀改變視角,或改第一幀讓編輯自然延伸至整段。
  • 單卡 80GB 可跑:Linux + A100 + CUDA 12.4 + Python 3.10,硬體門檻相對可控。
  • 路線圖仍在擴展:360 度重拍、跨模型記憶、串流生成等功能陸續排程中。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 世界模型, 模型訓練, NVIDIA, Video, 框架, Content Creator, 3D, Linux, Python

SyncWorld:用一段影像校準,讓世界模型零樣本遷移到新機械人

同一個數值動作換了鏡頭或機械人就失效?SyncWorld 以「視覺校準片段」作為提示,讓單一世界模型即時推斷動作與畫面嘅對應關係,毋須再為每個環境重新微調。

SyncWorld teaser

動作數值喺像素空間其實唔係通用語言——換鏡頭、換機械人位置、換機械結構,同一個動作指令就會產生唔同嘅視覺效果,亦即係點解用混合數據訓練出嚟嘅動作條件世界模型(action-conditioned world model)喺新場景入面成日失效。SyncWorld 嘅切入角度係:既然動作同畫面嘅對應因環境而異,不如用一段包含每個可控自由度(DoF)嘅短影像校準片段(visual calibration episode)做 in-context prompt,等模型喺推論時即場估計呢套環境嘅 Action–Visual Mapping,從而把單一 checkpoint 變成零樣本(zero-shot)模擬器,毋須額外訓練。

基於 NVIDIA Cosmos-Framework 改寫而成,並非由零開始砌嘅新網絡。對比一般針對單一機械人做 fine-tuning 嘅做法,SyncWorld 用視覺證據取代權重記憶;訓練時混入 calibration context 之後,模型仲學識喺冇 calibration 嘅情況下落返去用互動歷史做預測。程式庫提供分散式 FSDP trainer、typed TOML 食譜同原生 DCP checkpoint,可以直接匯出 HuggingFace safetensors;評估就用全段自回歸 rollout,配合 PSNR、SSIM、LPIPS 量度像素相似度。

直接受惠:需要喺多款 xArm、ARX5、KUKA、Franka Panda、UR5e 等異質平台上做 sim-to-real 想像嘅機械人研究團隊;做測試時策略改進(test-time policy improvement)而唔想再花錢訓練嘅 RL 團隊;以及想避開「每個新 setup 都要重新標註動作」呢個樽頸嘅數據團隊。Demo 顯示佢能準確模擬未見過嘅設定入面嘅動作後果,並令策略喺測試階段靠 rollout 改善而毋須再訓練。

重點摘要:

  • 以視覺校準片段作為 in-context prompt,免去 per-deployment fine-tuning
  • 訓練同時令模型能喺冇 calibration 時回退用互動歷史
  • 基於 NVIDIA Cosmos-Framework 改寫,提供 FSDP 訓練同 DCP checkpoint
  • 評估用全段自回歸 rollout,配 PSNR、SSIM、LPIPS 指標
  • 模型權重同評測集已開喺 HuggingFace:yyuncong/SyncWorldyyuncong/SyncWorld-Evaluation

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 世界模型, 模型訓練, NVIDIA, Image, Robotic, 框架, AGI, Dataset 數據集

PWM(Programmable World Model) 以世界模型驅動影片生成

AlayaLab 開源的 Programmable World Model 把世界狀態與畫面生成拆開管理,讓角色、事件與鏡頭外的物件都能被查詢、修改與驗證,不再只靠潛在影像記憶。

Programmable World Model overview

影片世界模型能夠即時渲染出像真的畫面,但畫面背後其實欠缺一部「世界引擎」——狀態藏在影像序列裡,難以檢查、編輯或驗證,鏡頭一轉,鏡頭外的角色與潛在事實就會被悄悄遺忘。AlayaLab 開源的 Programmable World Model(簡稱 PWM)正正針對這個痛點,把世界狀態的維護與視覺生成徹底解耦,由一個 state executor 負責推進世界狀態,再由 deterministic compiler 把以 state-augmented 3D OBB 描述的狀態投影成 pixel-aligned controls,最後才交給影片模型渲染畫面。

這個框架真正解決的問題,是讓世界「可被編程」。同一份世界狀態可以驅動任意鏡頭、任意視覺風格,角色即使離開畫面依然存在,事件具備不可逆性,亦可由規則觸發;使用者可以用類似 WASD 的方式操控,並預先以語言定義世界規則。一個 VLM-based agent 會讀取參考圖與開放式文字,自動寫出可執行的世界規格。

PWM 屬於框架類項目,定位接近研究原型。與 Genie 3、GameNGen 等同類做法相比,PWM 的取捨在於放棄純端到端的潛在表達,換取可查詢、可驗證、可長時序的狀態;對於遊戲開發者、需要可控互動世界的模擬研究者,以及想用程式化方式生成可控影片內容的團隊,這種顯式狀態設計明顯更貼近「世界引擎」的真正需求。

目前 PWM 已釋出技術報告,推理程式碼與預訓練權重尚未開源,因此暫時只能從紙面層面理解並等待官方補上權重。從架構看,這個方向對於追求可控性與持久性的應用場景會有明顯吸引力。

重點摘要:

  • 狀態與畫面解耦:狀態由 executor 維護,畫面由影片模型渲染,互不綁定
  • 可查詢、可驗證的世界事實:角色、事件與鏡頭外實體都能被檢查與修改
  • 持久世界:鏡頭外的物件與潛在狀態不再被遺忘,長時序互動更可靠
  • VLM agent 自動生成世界規格:以參考圖加文字描述即可寫出可執行的世界規則
  • 尚待補完:推理程式碼與預訓練權重仍未釋出,目前以技術報告形式呈現

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 世界模型, Video, Image, 框架, 3D

OpenWAM-α 把世界模型與動作模型拆開重組

來自XPolicyLab等團隊的開源研究棧OpenWAM,把世界–動作模型(World-Action Models)拆解成可替換模組,並以約6,400小時第一人稱與機器人資料訓練出OpenWAM-α,在八個模擬基準與真機實驗均取得頂尖表現。

OpenWAM

如果你是做機器人策略或世界模型研究,大概都有過這種經驗:想換一個視覺編碼器、想試不同動作頭的耦合方式,結果整個訓練流程都要重寫,因為生成骨幹、視覺表示、架構、推論步驟和訓練資料全綁在一起。OpenWAM正是針對這種「綁死」的痛點而來。它是一個開源研究棧,把世界–動作模型(World-Action Models,簡稱WAMs)的設計空間拆成可組合模組,並用統一介面串接訓練、推論、部署與評估。

這個項目分成三層。OpenWAM-Infra提供模組化基礎設施,讓研究者可以像堆積木一樣替換模型、表示、訓練與評估設定;OpenWAM-Study則透過控制變量實驗,回答三個核心問題:應該從什麼預訓練骨幹繼承知識、世界學習與動作學習如何耦合、以及兩者如何隨規模擴展。基於這些結論,作者訓練出OpenWAM-α,一個以約6,400小時(5.185億幀)第一人稱人類與機器人資料預訓練的開放模型,並在涵蓋單臂、雙臂到靈巧手的八個模擬基準,以及真機實驗中維持頂尖水準。

架構由Hydra配置檔驅動,預設採用wan22 ti2v 5B作為影片骨幹,並搭配獨立的動作頭(如ActionDiT或共享動作骨幹),視覺編碼器則可在VAE、DINOv3、V-JEPA 2.1之間切換。基準測試覆蓋RoboTwin、LIBERO、LIBERO-plus、RoboCasa365、RoboCasa GR1、VLABench等主流環境,研究者可以直接用提供的評估客戶端跑對比。

  • 定位:開源研究棧,專門解決世界–動作模型設計選擇難以分離比較的問題
  • 核心貢獻:把生成骨幹、動作頭、視覺表示等模組化,並用控制實驗歸納出三條設計原則
  • 預訓練模型:OpenWAM-α基於約6,400小時第一人稱與機器人資料訓練,在八個模擬基準及真機均表現頂尖
  • 適用對象:機器人策略學習、世界模型研究團隊,以及需要可重現基準對比環境的從業者
  • 配套資源:模型已上傳Hugging Face,並提供完整的訓練、推論、部署腳本

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港大學, 模型, 世界模型, 模型訓練, Video, World-Action Model, , Dataset 數據集

Atlas 世界模型一次處理文字、圖片、影片與 3D

World Labs 推出 Atlas,聲稱是目前首個原生同時處理文字、圖像、影片與 3D 的「omni」世界模型,能從一張相機路徑推算未見過的視角,並重建真實場景。

Og image

World Labs 公開了新一代世界模型 Atlas。它的特別之處在於從訓練階段就同時處理四種輸入——文字、圖像、影片、3D——並把它們整合到同一個空間脈絡裡,再以多模態自迴歸擴散 Transformer 推算下一個畫面。這意味著 Atlas 不只是「看得更多」,而是嘗試理解世界怎樣呈現、怎樣變化,並把想像中的場景渲染出來。

從使用場景來看,Atlas 主要涵蓋四類工作:相機控制生成、空間重建、空間時間模擬,以及純文字生圖與 360 度全景。其中相機控制生成支援 1 至 6 張輸入圖片,可輸出最高 1440p、最長約 1 分鐘的影片,並以像素級精度的相機幾何作為輸入,而不只是粗略的文字描述。

重建方面,Atlas 只需要 1 張到幾十張相片,就能還原真實場景並產出新視角的影像幀與明確的 3D 輸出。團隊指出,這項表現優於專門做 3D 重建的同類模型。空間時間模擬則可從影片重新取景,生成電影級視覺效果,並支援 Real-to-Sim 流程,供機器人規劃動作。

以下幾點值得留意:

  • 原生多模態:文字、圖片、影片、3D 一開始就共享同一空間脈絡,並非後期拼接。
  • 像素級相機控制:把精確相機幾何列為原生輸入,能逐格構圖、逐段運鏡。
  • 超越專用模型:3D 重建表現優於專門訓練的模型。
  • 支援 Real-to-Sim:能把真實影片轉成可模擬的世界,供機器人規劃。
  • 規模持續擴展:團隊表示表現會隨訓練算力提升,並預期這個趨勢會延續下去。

World Labs 表示,Atlas 將驅動他們自家 Marble 的未來版本及其他產品,現已開放早期使用的申請。

項目主頁

Categories: AI productions, 多模態模型, 世界模型, 模型訓練, API, Video, Image, 影像模型, Robotic, 3D

SolarWM 開放視頻世界模型全流程基建

SolarWM 不只公開模型權重,連數據處理、訓練流程和長時推理方法一併開放,目標是降低互動式視頻世界模型的研究門檻。

SolarWM teaser: one framework for diverse interactive worlds

從數秒訓練片段推演出長達數分鐘甚至更長時間的互動視頻,一直是世界模型(World Model)發展中的難題。SolarWM 把焦點放在整個研發鏈條,而不只是單一模型,結合開放數據管線、訓練框架與推理流程,形成一個面向互動式視頻世界模型的完整研究基礎設施。

項目屬於世界模型訓練框架與開放研究基建,處理的問題是如何把不同來源的視頻資料整理成一致格式,並在不同模型骨幹之間建立可擴展的長時推理能力。團隊將來自 14 個資料集、約 143 萬段影片統一整理,讓資料準備與訓練配方可以分離,研究人員毋須重複建立資料處理流程。

與許多只圍繞單一架構設計的方法不同,SolarWM 強調保留原生骨幹能力,同時支援 Wan2.2、LTX-2.5 與 MiniMax-H3 等不同模型家族,涵蓋 5B 至 33B 規模。研究團隊提出三階段訓練流程,包括雙向適應、結合 AnyFlow 的教師強制訓練,以及長時互動推理策略,希望在不依賴超長訓練影片的情況下維持世界演化一致性。

  • 開放釋出資料處理管線、資料集及模型權重
  • 支援多個主流視頻生成骨幹,而非綁定單一架構
  • 利用約五秒片段訓練,目標達成分鐘級甚至小時級推理
  • 涵蓋 143 萬段影片與約 25TB 數據規模
  • 提供可重組資料配方與不同訓練策略組合

適合世界模型研究團隊、互動式模擬系統開發者,以及探索 World-Action Model 與長時視頻生成的學術機構。SolarWM 的價值不只在單次生成效果,而在於把過往難以重現的資料處理和訓練步驟公開,讓不同研究單位更容易比較方法與建立可重複驗證的實驗流程。長時間推理的一致性仍有待更多公開基準驗證,但這套框架已經把世界模型研究由單一模型競賽推向完整基礎設施層面。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, 世界模型, 模型訓練, NVIDIA, World-Action Model, 3D, LTX, Dataset 數據集, MiniMax

Page 1 of 9
1 2 3 9