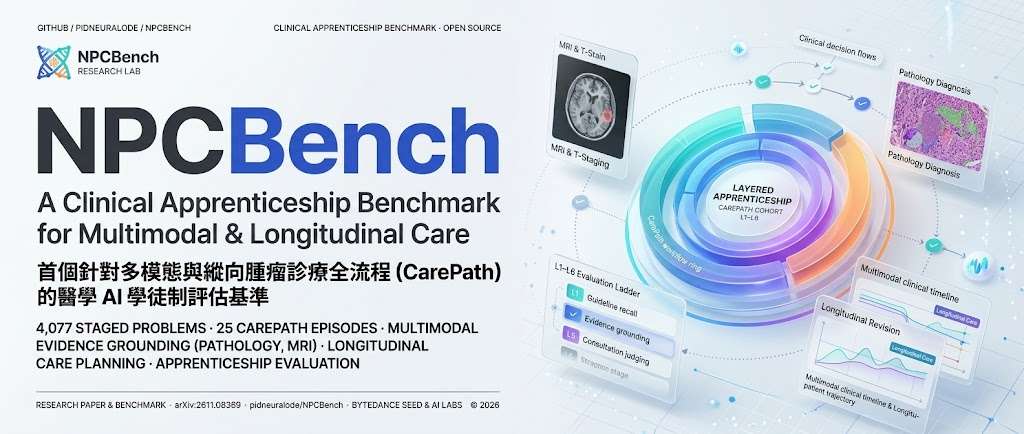
NPCBench:檢測模型能否串連鼻咽癌診療全程

模型答對單題,不代表能為同一位病人作出前後一致的診療判斷。NPCBench 把鼻咽癌知識、影像、治療決策與病程追蹤放進同一套評測。

NPCBench overview

答對鼻咽癌知識題,未必代表模型能制定合適方案,或隨病情變化修正判斷。NPCBench 是一套醫療 AI 評測基準,涵蓋指引知識、影像判讀、臨床決策及專科諮詢,嘗試檢驗模型能否把這些能力連接到病人的診療流程中。

不少醫療基準把能力拆成知識問答、單張影像判讀或靜態病例題,逐題計分;這種方式較難看出模型能否整合多模態證據,或在病程改變時更新決策。NPCBench 改以近似專科培訓測試,並加入縱向病例與 CarePath 評估,要求同一病人的病理、MRI T 分期及各項照護決策全部正確,才算聯合成功。
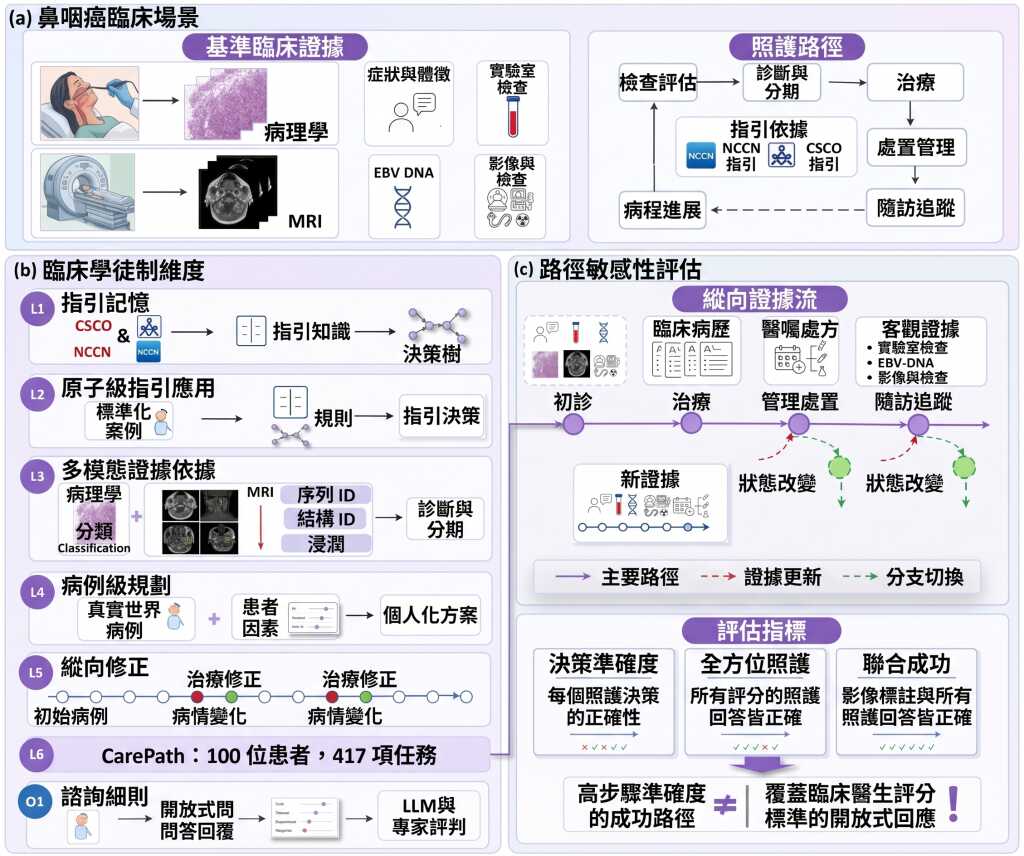
資料集包含 4,777 項分階段及諮詢題目,另有 100 名病人的 CarePath 病例,共 417 項診斷與照護評分任務。項目亦提供 MRI 延伸評測指南、醫師一致性校準,以及可用已發布預測結果重現主要結果表的 CPU 指令;研究比較了 30 個模型,並以配對控制檢視證據依據、病程中的判斷修正及諮詢評分。

結果反映單項能力與完整診療流程之間存在落差:在 21 個多模態模型中,嚴格 CarePath 聯合成功率最高為 23%。這令 NPCBench 適合研究醫療模型評測、腫瘤照護工作流程及多模態臨床推理的團隊;但它聚焦鼻咽癌,分數不能直接推廣至其他疾病或真實臨床成效。

  • 評測範圍由指引知識延伸至影像、決策、病程追蹤及專科諮詢。
  • CarePath 以病人為單位,要求多項診斷與照護答案同時正確。
  • 研究比較 30 個模型,並納入配對控制與醫師一致性校準。
  • 嚴格 CarePath 評估中,多模態模型最高成功率為 23%。

使用者可按任務下載相應題目,為每題提交模型答案,再以提供的評分工具輸出分數;Python 3.10 或更新版本即可執行。多選題需要提交完整選項集合,L1、L2、L4 等任務有各自的題目檔與評分命令,MRI 延伸測試則另有資料處理及推理設定指南。
GitHub · Paper

Categories: 開源, 香港理工大學, 多模態模型, Image, 香港, 工具, Medical醫學, 中國, Dataset 數據集

EmoReward:讓影片生成按情境調整情緒評分

情緒表達沒有唯一標準答案,固定評分模型容易忽略不同影片中的細微線索。EmoReward 會按影片內容調整各類獎勵訊號的可信度,並把訓練經驗帶到下一輪。

EmoReward logo

生成影片要呈現特定情緒,不能只靠一個固定分數判斷做得好不好。EmoReward 是一套用於情緒影片生成強化學習的獎勵校準機制,會按影片中的情緒階段、面部表情、訊號衝突與細微線索,決定不同評分來源各自應佔多大比重,處理情緒主觀而且隨時間變化的問題。

透過 Reflective Reward Gating,在每段影片中調整面部動作、語意等不同獎勵訊號的可信度。完成一輪訓練後,RewardMemory 會整理哪些情境下的線索較可靠,轉成有上限的融合權重倍率,供下一輪訓練使用;記憶表在該輪訓練期間保持凍結,避免權重持續變動。

這種跨輪次校準適合研究情緒影片生成、強化學習後訓練,或需要整合多種評分模型的團隊。項目以 HunyuanVideo-1.5 為基礎模型,並採用 SAGE-GRPO 作為強化學習骨幹;實驗涵蓋三種影片強化學習算法及兩個影像骨幹,亦包括消融實驗與人類評估。

  • 按影片情境調整不同情緒評分訊號的權重。
  • 不改動獎勵模型參數,降低校準對模型本身的干預。
  • 把一輪訓練所得的線索可靠度帶到下一輪,訓練期間凍結記憶表。
  • 評估涵蓋三種影片強化學習算法、兩個影像骨幹及人類評估。

項目文件列出 PyTorch 2.6+、Transformers 4.57.1 與 Diffusers 0.35.0 等依賴。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 騰訊, AI productions, 模型, 多模態模型, 模型訓練, Video, Image, 香港, Python, 庫, 強化學習

Embodied Agent Arena:測試十款 VLM 的任務能力

十款前沿視覺語言模型接受 1,000 個具身任務測試,結果顯示,能生成可執行動作,不代表能完成多步操作或精細接觸任務。

logo transparent

要判斷視覺語言模型(Vision-Language Models,VLMs)能否勝任機械人通用操作,不能只看它有沒有成功發出動作。Embodied Agent Arena 是一個具身代理評測項目,以共同測試流程比較十款模型在五類能力上的表現,涵蓋 1,000 個案例,並把幾何理解、空間推理和視覺定位納入評測。

項目把任務理解、推理和動作選擇交由模型處理,再以同一套精簡評測框架測試不同模型。測試資料整合 32 個既有來源,另加入 168 個案例的 GeoProbe 幾何基準;相比只看機械人互動任務,這種安排能同時檢視模型理解空間資訊的能力,以及能力能否轉化為實際任務成果。

結果反映,單一指標容易掩蓋任務是否真正完成。Gemini 4 Argon 的 3D 路徑誤差最低,為 0.310 米,但 56 條路徑中只有 24 條符合全部限制;Manipulation 成功率最高的 Opus 5.5 亦只有 47.8%。CALVIN 測試中,100 個序列有 60 個完成第一個目標,完成全部五個目標的只有 9 個;在五項 ManiSkill 診斷任務中,Opus 5.5 能完成拾取、放置和堆疊,卻未能完成插入插銷或充電器。

  • 同一批 157 項 Planning 任務中,至少有一款模型完成 142 項;仍有 15 項十款模型全部失敗。
  • Astra 的 31 項失敗任務耗用 55.5% token;失敗任務平均耗用的 token 是成功任務的 5.1 倍。
  • CALVIN 有 65 個序列曾遇到執行錯誤;其中 62 個後來能無錯執行程式碼,但只有 3 個最終完成序列。
  • Case Atlas 收錄 181 個涵蓋五類能力的案例,提供十款模型的紀錄;缺少影片的項目會使用共用任務場景,API 中斷則標記為失敗嘗試。

這些結果適合用來比較模型在哪些環節失手,亦提醒研究團隊不要把路徑精度、程式碼執行成功或單一步驟操作,直接當成完整任務能力。項目提供線上結果、案例影片、資料集及程式碼。

項目主頁 · GitHub · 數據集

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, AI productions, 世界模型, Qwen, DeepSeek, Gemini, API, VLA, Robotic, 框架, 香港, Anthropic, Dataset 數據集

CUA-Master:把教學影片變成電腦操作訓練資料

教學影片可以變成代理的操作練習,但仍要接駁沙盒。CUA-Master 串起任務挖掘、驗證與訓練資料製作。

com

把軟件教學影片轉成可驗證的操作任務,CUA-Master 這套框架協助團隊訓練電腦操作代理(Computer-use agents,CUAs)。它會按模型弱點補充任務,讓資料建構與模型改進互相帶動。

框架結合字幕語意與畫面變化重建操作軌跡,再抽取可重用的能力單元,控制新任務涉及的能力及應用程式數量。沙盒執行失敗後,可按回饋回復快照重試;已驗證軌跡可轉成 ms-swift 格式的監督式微調(Supervised Fine-Tuning,SFT)資料。

準備測試需要安裝依賴及接駁服務:

  • 以可編輯模式安裝,加入 seeding、annotator、collection、dev 依賴。
  • 複製 .env.example 為 .env,填入 API 金鑰及沙盒服務端點。
  • 經 provider 介面接駁自己的沙盒後端,再按範例設定搜尋影片資料、下載選定影片;命令支援 –help。

官方公布 CUA-Master-27B 在 OSWorld Verified 得分為 80.2,在 OSWorld 2.0 為 36.9,兩者不可直接當成同一尺度比較。項目較適合有沙盒及訓練資源的代理研究團隊;提供的快速開始內容未完整展示後續流程,尚不足以照抄完成整條訓練流程。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, AI productions, 模型, 模型訓練, API, Video, 框架, 教學, 軟件

CodeSpecWeave:寫碼容易,了解需求才是關鍵

CodeSpecWeave 將互相影響的軟件要求編織成可執行訓練任務,測試編程代理能否維持整體行為一致。

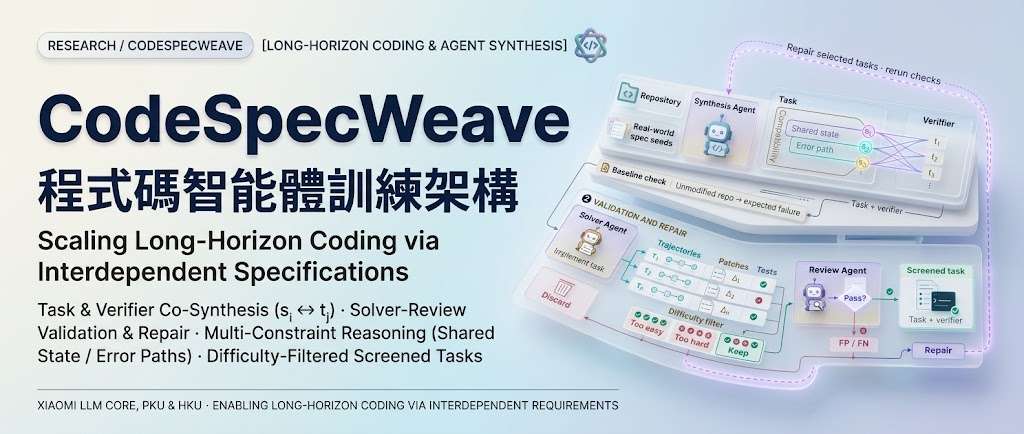
Paper pipeline: task and verifier synthesis, baseline check, solver trials, difficulty filtering, trajectory review, and repair followed by revalidation.

新增一項功能,可能同時改變狀態、介面、錯誤處理路徑和執行次序。CodeSpecWeave 是一個面向 Computer-use agents 的編程代理訓練與評測項目,處理的正是這類不能逐項解決的長流程編程工作,要求代理在同一份實作中兼顧互相牽動的限制。

項目建立更貼近真實軟體工程的任務,用來訓練與評估 AI 程式開發代理(coding agents)。它不是一般的寫程式工具或線上 IDE,而是一套「產生開發任務、建立驗證測試、訓練及評估 AI」的研究框架。

網站用交易分配功能作例子:AI 不只要依金額比例分配資源,還必須同時確保總量守恆、最低分配額、四捨五入順序穩定,以及保留舊版單一收款人的行為。某一項需求單獨看似做對,整個功能仍可能不符合規格。

CodeSpecWeave 因此刻意讓需求共享狀態、執行路徑及生命週期限制,測試 AI 能不能把整組約束一起處理,而不是只寫出局部正確的程式碼。

  • 將獨立要求連結成 shared decision space
  • 同時檢查功能語意、狀態一致性和介面兼容
  • 以 executable tests 評估跨要求的聯合推理
  • 涵蓋真實 repository 與保留作評測的工程任務

項目主頁

Categories: 北京大學, Agentic, 模型, 模型訓練, World-Action Model, 香港, 軟件, 編程, Dataset 數據集, 小米-Xiaomi

IIT:讓小學生用簡單指令與 AI 對話

香港小學將逐步引入 IIT,讓七歲學生以簡單提示或指令與 AI 交流。

Og image

七歲學生將有機會用簡單提示或指令,與人工智能(artificial intelligence,AI)作簡單「對話」;香港小學由 2028 年 9 月起逐步引入 Information and Innovation Technology(IIT)新科目,回應數碼素養、創意及創新科技學習需要。

課程《Information and Innovation Technology Curriculum Framework for Primary Schools (Provisional Draft)》,AI 是其中一項重點。學生先認識相關技術,再以簡單命令與 AI 互動,學習重點不只接觸工具,也包括培養好奇心及對創新科技的興趣。

對學校而言,IIT 提供一個讓學生較早接觸 AI 的課程位置;對學生而言,互動形式把抽象的 AI 概念拉近到提問、下指令和接收回應等熟悉行為。資料未有交代課堂會採用哪些 AI 系統、設備、評核方式或具體教學活動,亦未提供安裝、下載或使用流程。

  • 由 2028 年 9 月起在香港小學逐步推行
  • 學生年紀可低至七歲
  • 以簡單提示或指令與 AI 作基本互動
  • 目標包括提升數碼素養、創意及對創新科技的興趣

目前公布內容屬臨時課程框架草案,實際推行安排仍可能隨後續課程設計而調整。家長、教師和教育科技項目策劃者可先把它視為小學 AI 素養教育的方向訊號,但現有資料不足以判斷課程深度或學生可使用的系統範圍。

項目主頁

Categories: 框架, 教學, 香港, 工具, 新聞, 中國

Work Agents 將數碼工作拆成可驗證成果

跨應用程式完成工作,不能只看模型答得對不對;Work Agents 把代理流程、能力與可驗證成果放進同一研究脈絡。

Work Agents: Systems, Capabilities, and Optimization

當 AI 要跨應用程式完成多步工作,交付可核實、能供後續使用的成果,比單次答對更重要。Work Agents 是配合調查研究整理的開源閱讀清單,收錄數碼工作代理的系統、訓練、環境、記憶、基準與官方資源,並非可直接安裝的代理軟件。

研究以工作持續性(work persistence)和工作開放性(work openness)描述工作條件,並分成對話(Conversation)、單一步驟(Atomic Action)、多步(Multi-step)、工作流程(Workflow)及工作區(Workspace)五類。它也梳理 foundation models(基礎模型)與 runtime harnesses(執行時框架)的單獨或協同優化,評估則聚焦成果能否符合要求並供下游使用。

你可由 GitHub 清單挑選論文、基準和工具;暫未有可直接執行的代理或統一安裝、測試流程,不能當成部署指南。

  • 整理代理系統、訓練方法、環境與記憶研究
  • 涵蓋五類數碼工作及相關評測資源
  • 比較模型、執行框架及兩者的協同優化
  • 以可驗證、能供下游使用的成果作評估焦點

產品團隊和自動化流程負責人可用它整理能力缺口與評測方法。清單沒有同一環境下的性能數字,具體效果仍要回到各研究與工具核實。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港大學, 香港科技大學, 清華大學, Agentic, 模型, 模型訓練, 框架, 香港, 軟件, 工具, 庫

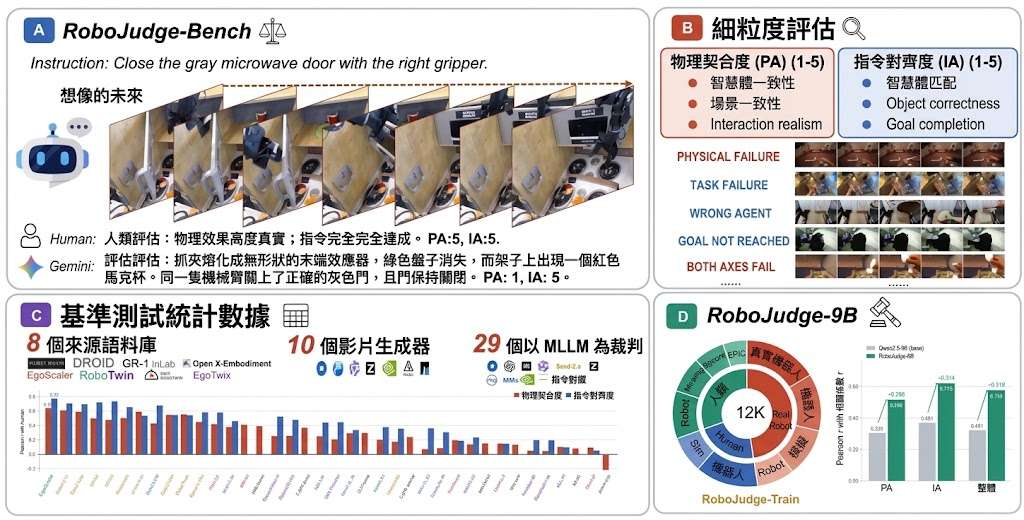
RoboJudge:把影片的物理合理性與指令分開評測

RoboJudge 分開檢視具身影片的物理合理性與指令完成度,並以人類評分訓練模型,供團隊比較生成結果。

RoboJudge overview

具身影片可能動作自然卻未完成指令,也可能完成任務但違反物理規律。RoboJudge 以 Multimodal Language Models (MLLMs) 評審生成影片,分開衡量 Physical Adherence (PA,物理遵循) 與 Instruction Alignment (IA,指令符合度)。

這有助機械人及具身世界模型團隊分辨動作可信度和任務完成度。RoboJudge-Bench 收錄 800 段人工標註影片,涵蓋 8 個語料來源、10 個影片生成器,以及夾爪、人手與靈巧手。

RoboJudge-Train 收錄 12,000 段影片及 25,000 筆人工評分與理由;RoboJudge-9B 經監督學習及強化學習訓練。Pearson 相關係數在 PA 為 0.645、IA 為 0.775、整體為 0.719,較測試中的最佳專有基線高 0.089;相關性不代表每次判斷都正確。

GitHub 提供推理和基準評估程式,並連結模型與資料集。README 列出依賴安裝及執行流程,但沒有硬件需求資料,採用前宜先確認設備能否負擔模型載入與影片處理。

  • PA 檢視影片是否符合物理與時間約束。
  • IA 檢視影片動作是否符合指令。
  • 基準可用於比較評分,不能取代人工核對。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, Video, 香港, Dataset 數據集, 強化學習

CLI-Anything 讓 AI 代理直接操控軟件

CLI-Anything 把圖像、CAD、3D 等軟件包裝成可供 AI 代理操作的 CLI,打通代理與既有工具之間的斷層。

icon

當 AI 代理需要製作 CAD、3D 場景、圖表、遊戲或字幕,CLI-Anything 會把原本面向人類操作的軟件轉成可調用的 CLI。它屬於開源的 Agentic 工具與 CLI 生成框架,處理的是代理缺乏一致介面、難以持續操作軟件及產出可驗證成果的問題。

項目以 /cli-anything 作為主要入口,並配合預覽、即時預覽及 trajectory loops,讓代理不只發出指令,還能逐步產生和檢查真實 artifact。README 亦列出 Cursor plugin、Hub 及 skills,反映它同時照顧 CLI 生成端和代理使用端;舊版本則可能要改用 /cli-anything:cli-anything。

和只依賴 GUI 操作或個別 API 整合的做法相比,CLI-Anything 嘗試為不同軟件建立較統一的代理介面,方便重用流程,但效果仍取決於每個軟件的 CLI harness 是否完整,以及代理能否正確理解工具狀態。項目提供 CLI-Hub,使用者可瀏覽、安裝及管理社群建立的 CLI;原始資料未交代各 harness 的詳細安裝步驟、資源要求或一致的性能基準。

CLI-Anything: Turn ANY App into a CLI for Claude Code & Codex (GIMP, Blender, LibreOffice & More!)

• 支援把多類軟件轉成 AI 代理可調用的 CLI
• 以預覽與 trajectory loops 協助產生可檢查的成果
• 提供 CLI-Hub 管理社群 CLI
• 適合需要串連設計、製作及自動化流程的團隊
• 仍需逐一確認各軟件 harness 的成熟度

對熟悉 Cursor 或其他代理工作流的開發者,這套方法適合用來延伸圖像處理、CAD、3D 製作及內容生產流程;對只想即時使用單一軟件的使用者,則要先確認所需 CLI 是否已建立及可用。

GitHub

Categories: 開源, 香港大學, Agentic, API, Image, World-Action Model, 框架, 軟件, 工具, IDE, 3D, 編程, Skill 技能

ShotVerse2.0:讓影片生成更有電影感

從文字生成影片時,角色衣着、場景和鏡頭動作往往難以同時維持一致。FAPL 訓練多模態語言模型理解影片生成所需的時間線索,並支援分項控制。

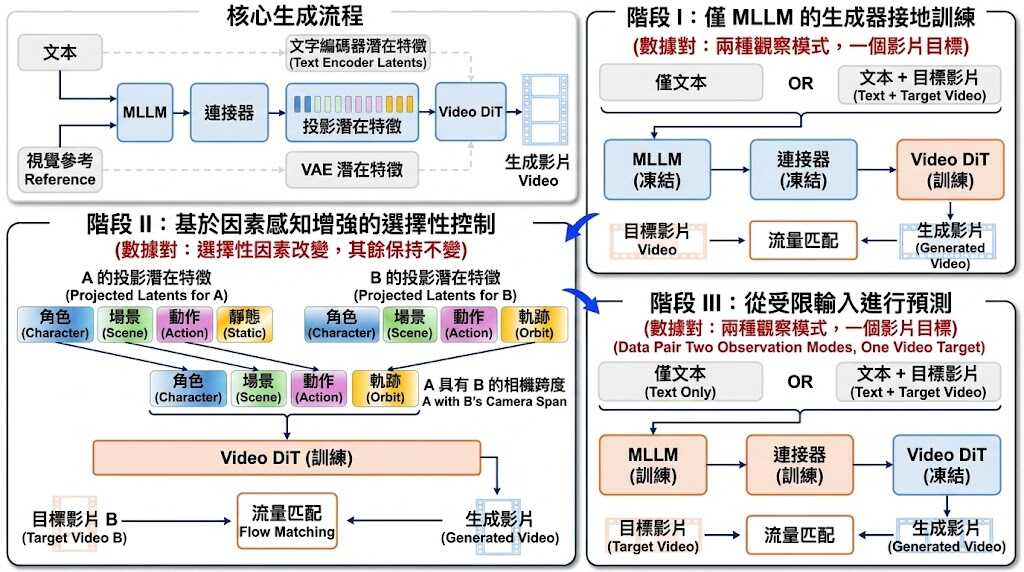
FAPL training framework

文字生成影片時,模型不只要描寫眼前一幕,還要推斷未提供的時間變化,並在角色、場景、動作和鏡頭之間維持一致。FAPL(Factor-Aware Predictive Learning,因素感知預測學習)是一套訓練方法,旨在讓多模態大型語言模型(Multimodal Large Language Model,MLLM)的表示真正參與影片生成,而非被解碼器繞過。

它以 UniVideo 的 13B Video DiT 為基礎,不改動模型架構,而是分三階段訓練:先令 DiT 以 MLLM 潛在表示作為內容條件,再透過成對的因素編輯資料,教模型只改指定內容、保留其他因素;最後固定 DiT,訓練 MLLM 與連接器,讓只有文字或文字加完整影片的輸入都能對應同一影片目標。這讓方法同時處理文字推斷影片細節,以及按因素選擇性控制的需求。

研究報告的評測中,FAPL 把 Motion Order 由 48% 提升至 61%,∩-Acc 由 42% 提升至 58%,FaceSim-Arc 則由 0.451 升至 0.523。展示案例亦呈現角色衣着和外觀較能維持一致;不過,這些數字來自指定評測,不能直接視為所有提示詞或影片情境下的保證。

目前較適合研究影片生成、希望改善多因素控制的團隊參考。GitHub 資料標示程式碼、模型權重及 CineFactor-10K 評測提示仍待發布,因此暫未能按儲存庫提供的資料安裝或重現訓練;現階段可先閱讀論文及項目網頁了解方法與示例。

  • 以 MLLM 潛在表示作為影片生成的內容條件。
  • 分開訓練內容 grounding、因素控制與有限輸入預測。
  • 可針對角色、場景、動作或鏡頭變更,同時保留其他因素。
  • 在所列評測中,動作順序、因素準確度與人臉相似度均有提升。
  • 程式碼、權重和評測提示尚未發布,現階段無法依實驗。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 騰訊, AI productions, 模型, 多模態模型, 模型訓練, Video, 提示詞, 香港, 庫

Page 1 of 19
1 2 3 … 19