Hypit:把爆款短片變成可換臉的模板

Hypit 是一套開源影片克隆工具,主打把 TikTok、Reel 或 Short 變成可重用的版面,換掉主持人、產品、開頭與長寬比,就能快速產出多個變體做投放測試。

Hypit

短片團隊最常遇到的卡位,是手上有一條跑出來的素材,卻要趕在疲勞前把它複製成十幾條變體測試新 Hook。Hypit 想解決的正是這個工序:丟一條影片進去,它會拆解成鏡頭、字幕、B-roll、效果這些可組合的工作流部件,而不是只輸出一份腳本分析。對做付費社交投放的人來說,這意味著可以從 Meta Ad Library 複製一條已經贏過的廣告,換掉商品與開場就當日出 50 條 Hook 變體;等兩星期素材疲勞,再用同樣的主體版型換新開頭,主體片段完全保留。

它和一般「AI 影片生成器」差別在定位:生成式模型負責補上會變的部分,Hypit 則是負責把會變跟不會變的部分拆乾淨、串起來。每個組件都能被替換或 fork,使用者不必動到字幕或剪輯邏輯。商業模式上,項目本身是開源(Apache-2.0 with conditions),沒有平台座位費或浮水印,模型服務費則看你接的是哪一家。

技術偏向給內容團隊或 growth marketer 自建的工程師整合進既有管線。素材來源涵蓋 TikTok、Reel、Short,也可以從 Meta Ad Library 抓一支跑得好的 paid ad 當模板。對需要大量 A/B 測試 hook、不同市場語言切版、或長線養帳號的工作流來說,這種「一次結構、N 次變奏」的思路,比每次從腳本重頭來要省事不少。

  • 不是單次生成,而是變奏生產線:同一支片可以反覆換主播、產品、語言、長寬比
  • 組件化設計:字幕、B-roll、效果都能獨立替換,不影響整體結構
  • 開源但非全免費:項目本體免費、無浮水印;模型推理依賴外部服務計費
  • 適合 paid social 與 viral clone 場景:Meta Ad Library、TikTok、Reel 都能當模板來源
  • 技術門檻在整合端:需要 Node.js + TypeScript 環境,較適合有工程支援的團隊
GitHub

Categories: 開源, AI productions, Video, 工具, , Skill 技能

BVB 用 影片內容令 AI 自動轉為 Blender 3D 場景

BVB 拋開選擇題,要求 AI 代理直接用 Blender 重建 288 段真實室內影片,從程式碼品質判斷它到底有冇真正理解畫面內容。

BVB logo

現時大多數影片理解 benchmark 都係問 AI 「張圖入面有幾多張椅」,但 BVB(Blender-VideoBench)行另一條路:畀 AI 睇一段室內影片,然後叫佢自己寫 Blender 腳本,把場景、鏡頭動線逐個 primitive 砌返出嚟。如果代理人交到一個可以重新開啟、可以渲染嘅 .blend 檔,代表佢真係睇明條片。

每個代理會都被困喺同一個 Blender 4.2 Docker 沙盒入面,淨係可以用 bashframes,仲有共享成本上限。禁止使用任何外部素材庫,幾何體全部由代理自己用基本操作砌出嚟。呢種「同條件競技」設計解決咗以往影片 benchmark 靠選擇題容易被 prompt hack 或者背答案嘅問題。

數據方面,BVB 用咗 ARKitScenes、ScanNet、ScanNet++ 嘅 288 段室內影片,配合 5,130 條時空題目,並涵蓋 10 個模型家族、共 51 個配置。評分用兩條軸:Dual VQA 睇重建場景保留幾多影片入面嘅時空事實;Latent Similarity 就用凍結影片 embedding 對比重建結果同原片嘅感知距離,再以平方根均值合成綜合分數。

對做空間智能、機器人感知或者影片理解研究嘅團隊嚟講,呢個 benchmark 提供咗一個更貼近「代理人真係要喺軟件入面操作世界」嘅測試場景。視頻生成、動畫製作或者世界模型團隊亦可以直接借用 Mini-BVB harness 喺自己 pipeline 度做壓力測試。

團隊結果顯示,最強配置喺 Latent Similarity 做到 88.6,但 Dual VQA 仲有明顯差距,代表現時頂級模型仲未做到「理解」同「重建」兩條線同步推進。呢個落差本身就係 BVB 想凸顯嘅訊號:識答題未必等於識建模。

重點摘要

  • 288 段真實室內影片,全部來自 ARKitScenes、ScanNet、ScanNet++ 嘅 held-out split。
  • 51 個代理配置橫跨 10 個模型家族,統一跑喺 Mini-BVB 沙盒同成本上限下。
  • 禁止使用外部素材庫,逼代理人由 Blender primitives 自己砌幾何。
  • 評分用 Dual VQA 加 Latent Similarity 兩條軸,避免單一指標偏廢。
  • 目標係可執行、可重新渲染嘅 .blend 檔案,而唔係文字描述或者單張圖。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, Embedding, 視覺模型, 多模態模型, 世界模型, Qwen, OpenAI, Gemini, Video, 軟件, , Anthropic, 動畫, Dataset 數據集

Ambient CSS 用物理光照重新定義 box-shadow

一個以光線方向驅動嘅 CSS 工具庫,唔再需要逐個元素微調 shadow-sm、shadow-lg,所有陰影同邊緣高光會跟住同一個光源自動生成。

A hardware panel raytraced in Blender, rotating to a flat-on view, then wiped across to reveal the same panel rendered b

Ambient CSS 最大嘅改變係將 UI 表面當作真實物料嚟處理。傳統嘅 CSS 陰影階只係裝飾,卡片用 shadow-lg、掣用 shadow-sm,兩個元素之間並無物理關係。呢個工具庫引入咗 key light 同 fill light 兩盞光源嘅概念,所有陰影、邊緣高光、表面漸層都由同一組 CSS 自訂屬性推算出嚟。當你改變容器嘅光線方向,底下每一個子元素都會即時跟住調整,唔使逐個改。

引擎將每個元素拆成五層 box-shadow 合成:方向性嘅 drop shadow、面對光源嘅 fillet 高光、背光邊嘅 fillet 暗影、斜面嘅 chamfer 高光同暗影,加埋材質表面嘅漸層。表面類型分 flat、concave、convex 三種弧度,邊緣可以揀 chamfer、fillet 或 groove,仲有 matte、shiny、glass 呢幾種材質,最後用 elevation 0–3 控製投影高度。所有參數都係用 Blender raytrace 嘅結果做標定。

對一般開發者嚟講,安裝同整合都幾直接。純 CSS 版可以喺 HTML 直接掛入,框架版本分別支援 Tailwind、PureCSS、React 同 React-Bootstrap。命名空間用 .ambient 做容器、再用 .amb-surface.amb-chamfer-2 等工具類調整細節,常用距離值跟 12/20/32 mm 嘅間距比例,避免頁面入面出現零碎數值。Demo 頁面將 Blender raytrace 同 live DOM 並排展示,幾容易睇出差距。

重點摘要

  • 將 UI 視為真實光照環境,所有陰影、高光、表面漸層由統一光源參數衍生
  • 每個元素由五層 box-shadow 合成,包含 drop shadow、fillet 同 chamfer 嘅高光與暗影
  • 表面類型(flat/concave/convex)、邊緣類型(chamfer/fillet/groove)、材質(matte/shiny/glass)同 elevation 0–3 可自由組合
  • 參數以 Blender raytrace 結果做物理標定,唔係靠肉眼調較 blur 值
  • 支援 PureCSS、Tailwind、React、React-Bootstrap 幾種整合方式

對需要管理大量卡片、面板、控制台介面嘅團隊嚟講,呢套系統可以避免每個設計師各自調較 shadow 嘅問題。對於追求像素級一致嘅硬件風格介面、儀表板或產品頁,效果會特別明顯;但若然你嘅介面本來就偏好扁平設計、唔需要表面弧度嘅呈現,呢層物理光照帶嚟嘅額外 box-shadow 開銷同學習成本就未必值得。

項目主頁 · GitHub

Categories: 開源, 框架, 工具, , UI/UX

jarvis-voice-butler:識睇住嘢同你傾偈 + 開瀏覽器幫你查資料

用講嘢就可以叫 AI 幫你上網、搜尋、填表,仲配上一把英式管家口吻。這個項目把 LiveKit Agents、Google Gemini Live 同 Playwright 串成一套聲控代理人。

Repository image for ruxakK/jarvis-voice-butler

聲控助手最麻煩嘅地方,往往係講完一句佢就要重新聽成段指令,又或者根本無法直接代你落手做嘢。Jarvis 直接針對呢個卡位,把 LiveKit Agents 框架、Google Gemini 3.1 Flash Live 即時語音模型,同 Playwright 操控嘅 Chromium 瀏覽器三樣嘢扣埋一齊。你可以理解成一個識講英式冷笑話嘅 AI 管家:你開口叫佢搜尋資料、撳掣、打字、捲頁、讀網頁內容,佢都會即時用「Enceladus」把聲回應你,過程仲支援自適應打斷同搶先生成。

對比起一般只能對答嘅語音 bot,呢個項目最大嘅突破係將語音輸入直接打通到瀏覽器操作層。佢內建十一個工具,包括開網址、搜尋、讀取同檢查頁面、撳掣、打字、捲動、撳掣鍵同截圖,仲有一個 confirm_browser_action 安全閘,去處理會造成實際後果嘅動作,例如提交表單或者刪除資料。視訊鏡頭輸入亦支援,等 AI 可以「睇到」你。

How to build a JARVIS AI Voice Agent for FREE | Full Livekit Tutorial (2026)

如果你想由頭砌起,作者用 uv 管理 Python 依賴,前端就用 Next.js 加 React,而家嘅程式庫亦用 Python 寫評估測試,覆蓋代理行為、瀏覽器操作同 prompt 表現。前端介面跟住會播一段自訂粒子動畫,連 Flutter 手機客戶端都一齊包埋,等你可以用手機當遙控。

呢類項目最適合做內部自動化研究助理,或者需要示範 Computer-use agents(CUAs)點樣融入聲音介面嘅團隊。值得留意嘅限制係實作仍處於早期階段,prompt 同安全策略都係寫死嘅版本,如果你想用佢處理高風險任務,仍然要自行加多一層審批同監察。

GitHub

Categories: 開源, Agentic, Google, Gemini, Audio, 框架, 工具, Python, , 語音, 動畫

qisi-video-remix:喂一段參考片給 Agent 它直接交出改編劇本與分段提示詞

一個專給 AI Agent 用的視頻改編技能:丟一段參考視頻,它就吐回新故事、完整劇本、分鏡表和能直接複製貼去生視頻的分段提示詞。

Repository image for wyuzhi/qisi-video-remix

要做一條短片,常常卡在「找參考、拆敘事、寫分鏡、再翻譯成生成器看得懂的提示詞」這幾步之間。qisi-video-remix 把這條鏈條整進一個 Agent skill:你貼一段參考視頻(或者故事梗概、截圖、逐字稿),它先把原片的敘事手法抽出來,再以此為基礎寫出新故事,並按鏡頭兼容性和時長上限拆段,最後給出每段可獨立複製的生成提示詞。它不依賴特定後端或拼裝服務,所有結果先在對話中展開,能寫檔的環境下再另外存成 creative-plan.md

重點摘要:
– 屬於視頻策劃向的 Agent skill,不帶模型或生成器,需由宿主 Agent 處理視頻讀取與生成。
– 默認做創意改編,要落實到人物選擇、事件發展或解決方式的變化,不止換名字。
– 分段先看場景、造型與動作複雜度,再看時長;15/30 秒是單段上限,不是固定段長。
– 提示詞各段獨立展開外貌、場景、動作和對白,可直接貼到所選視頻生成工具。
– 倉庫附一份 30 秒、6 鏡、2 段的完整示例,展示交付結構。

Codex 用戶只要把倉庫克隆到 ~/.codex/skills/qisi-video-remix/ 即可載入;其他支持 SKILL.md 的 Agent 按各自技能目錄安裝。它不替你選單段上限,未確認時會先詢問;遇到無法定論的聲音、身份或轉折會標明,不補造證據。對做豎屏短劇、廣告分鏡、或者想用 AI 視頻模型快速試腳本的個人和小團隊來說,這套指令能省下不少從分鏡到提示詞的人肉翻譯工作。

GitHub

Categories: 開源, Agentic, 模型, Video, Audio, 提示詞, 工具, , Skill 技能

Marigold V2:把擴散 Transformer 改成一步深度估計模型

只要一張普通 RGB 相片,就即時輸出高質素深度圖,連毛髮和髮絲等幼節都保留到。Marigold V2 把預訓練擴散 Transformer 改造為單步密集預測模型的開源項目,一張消費級 GPU 一星期內就能完成微調。

Project website

過去做單目深度估計,要麼靠傳統監督學習,要麼用擴散模型疊好多步去噪,兩者都唔易兼顧細節同效率。華為 Bayer Lab 開源 Marigold V2 走第三條路:直接把預訓練嘅擴散 Transformer(DiT)當成單步密集預測器,重新微調之後輸出深度、透視深度、法線、反照率等多種密集模態,毋須反覆去噪。對從業人員嚟講,呢個改動意味住一張普通 RGB 相可以即時變成帶細節嘅深度圖,毋須等幾秒去疊步驟,毛髮邊緣同髮絲呢類幼節都保留得到,貼近 SOTA 水準。

模型家族同訓練成本:每個 checkpoint 包含一組 rank-128 LoRA 適配器,配合 4-bit 量化嘅 DiT 主體,個別任務仲會附帶微調過嘅 VAE 解碼器。底層凍結嘅基礎模型會另外下載。整個微調流程用單張消費級 GPU 少於一星期就完成到,對個人開發者同細型實驗室都係可觸及嘅範圍。

程式碼結構清晰,方便二次開發:倉庫用 manifest graph 加 transform list 嘅方式定義數據集,網絡組件同損失函數都係讀寫 batch dict 嘅有序步驟,數據集定義、網絡圖、損失圖、優化排程四個層次分得幾開。對想擴展到新任務嘅人嚟講,只要跟住呢個結構加步驟就得,唔使由零砌起。

對比傳統多步擴散深度估計,Marigold V2 犧牲咗迭代式去噪嘅靈活性,但換嚟一步推理嘅速度同細節還原度;對比純監督方法,佢借用咗擴散模型對紋理同邊界嘅先天理解力,再加 LoRA 保持輕量。同一批權重仲可以用喺 metric depth completion 等下游任務,一個模型覆蓋多個密集預測場景。

**適合做 AR/VR、3D 重建、影像合成嘅中小團隊,或者想低成本試驗新密集預測任務嘅研究者,都會覺得呢個 setup 幾啱手。HuggingFace 上有對應嘅 demo 空間可以直接試,權重同訓練推理碼都已開源。

項目主頁 · GitHub · 模型

Categories: 開源, 華為, 模型, 模型訓練, Qwen, Image, 3D, , Dataset 數據集

OpenWAM-α 把世界模型與動作模型拆開重組

來自XPolicyLab等團隊的開源研究棧OpenWAM,把世界–動作模型(World-Action Models)拆解成可替換模組,並以約6,400小時第一人稱與機器人資料訓練出OpenWAM-α,在八個模擬基準與真機實驗均取得頂尖表現。

OpenWAM

如果你是做機器人策略或世界模型研究,大概都有過這種經驗:想換一個視覺編碼器、想試不同動作頭的耦合方式,結果整個訓練流程都要重寫,因為生成骨幹、視覺表示、架構、推論步驟和訓練資料全綁在一起。OpenWAM正是針對這種「綁死」的痛點而來。它是一個開源研究棧,把世界–動作模型(World-Action Models,簡稱WAMs)的設計空間拆成可組合模組,並用統一介面串接訓練、推論、部署與評估。

這個項目分成三層。OpenWAM-Infra提供模組化基礎設施,讓研究者可以像堆積木一樣替換模型、表示、訓練與評估設定;OpenWAM-Study則透過控制變量實驗,回答三個核心問題:應該從什麼預訓練骨幹繼承知識、世界學習與動作學習如何耦合、以及兩者如何隨規模擴展。基於這些結論,作者訓練出OpenWAM-α,一個以約6,400小時(5.185億幀)第一人稱人類與機器人資料預訓練的開放模型,並在涵蓋單臂、雙臂到靈巧手的八個模擬基準,以及真機實驗中維持頂尖水準。

架構由Hydra配置檔驅動,預設採用wan22 ti2v 5B作為影片骨幹,並搭配獨立的動作頭(如ActionDiT或共享動作骨幹),視覺編碼器則可在VAE、DINOv3、V-JEPA 2.1之間切換。基準測試覆蓋RoboTwin、LIBERO、LIBERO-plus、RoboCasa365、RoboCasa GR1、VLABench等主流環境,研究者可以直接用提供的評估客戶端跑對比。

  • 定位:開源研究棧,專門解決世界–動作模型設計選擇難以分離比較的問題
  • 核心貢獻:把生成骨幹、動作頭、視覺表示等模組化,並用控制實驗歸納出三條設計原則
  • 預訓練模型:OpenWAM-α基於約6,400小時第一人稱與機器人資料訓練,在八個模擬基準及真機均表現頂尖
  • 適用對象:機器人策略學習、世界模型研究團隊,以及需要可重現基準對比環境的從業者
  • 配套資源:模型已上傳Hugging Face,並提供完整的訓練、推論、部署腳本

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港大學, 模型, 世界模型, 模型訓練, Video, World-Action Model, , Dataset 數據集

anything2explainer:把任何主題變成科普影片

它不是 CLI,而是一套交給 AI 編碼 agent 用的方法包:從研究、旁白、字幕到分鏡,都用 Remotion 寫成 React 元件,產出可逐幀追溯的解說影片。

Repository image for Vincentwei1021/anything2explainer

當你丟一個主題或一篇文件給它,系統會先做資料蒐集並標註來源,再寫旁白、生成 TTS 語音,並把時間軸對齊到逐個鏡頭。接著多個建構 agent 平行運作,每個負責一個 Remotion(React + TypeScript)元件,QC agent 再依書面標準審查每一幀。輸出是 1280×720 H.264 MP4,配上字幕、章節卡與進度條,全程沒有現成影片或生成式影像模型的痕跡。

這套流程對創作者的最大意義在於可追溯。每個鏡頭都有自己的原始碼、QC 報告與研究文件,螢幕上出現的年份、數字、英文術語都要對得到來源 URL;live-action B-roll 也強制記錄在 MANIFEST 裡,附上 sha256、來源與授權。這種「紙本文書鏈」對需要審核的場景——例如企業內訓教材或品牌內容——比多數 AI 影片工具更有交代。

在同類做法裡,它明顯偏向工程化交付而非即興 demo。Remotion 元件庫、燈光與樣式規格、多 agent 協作協議都以可複用資產形式提供,並用一段完整的參考影片作為品質基準。對會寫程式、需要大量長版講解影片但又受版權與準確性束縛的團隊——例如 SaaS 團隊做產品教學、研究單位做技術普及——會比較感受到它的價值。

限制同樣明顯:不是 CLI,必須搭配 Claude Code 或 Codex 這類 agent 環境;TTS 要自備並處理對齊;中英文以外語言未提及支援;整個流程壁鐘 1 到 3 小時,瓶頸在並行建構鏡頭的數量與長度。授權採 PolyForm Noncommercial,商用前要先看清楚。

重點摘要

  • 全程程式碼繪製:用 Remotion 寫 React 元件產出每一幀,沒有生成式影片模型或現成素材。
  • 可審核的紙本文書鏈:研究文件、旁白、分鏡、鏡頭原始碼、QC 報告全部保留。
  • 多 agent 平行建構:研究、旁白、語音、分鏡後,由多個 agent 同時寫鏡頭元件,QC agent 再逐幀複查。
  • 多語言旁白:支援中文與英文,TTS 需自備並做強制對齊。
  • 非商業授權:採用 PolyForm Noncommercial,商用情境需自行評估。

GitHub

Categories: 開源, 文字轉語音, Agentic, AI productions, OpenAI, Video, Image, 工具, Content Creator, , 語音, Anthropic, 動畫, Skill 技能

MovieGrid 把長片拆成方格生成,解決多鏡頭一致性

來自 UC Santa Cruz 等院校的 MovieGrid 框架,把長片拆成空間方格同步生成,目標是同時兼顧鏡頭內連續動作與跨鏡頭視覺一致性。

Repository image for jwmao1/moviegrid

MovieGrid 針對的痛點很直接:現有影片生成模型傾向犧牲多鏡頭敘事完整性來換取單鏡頭內的動作連貫,而傳統把整段故事沿時間軸壓縮的做法,更會加深這個偏差。

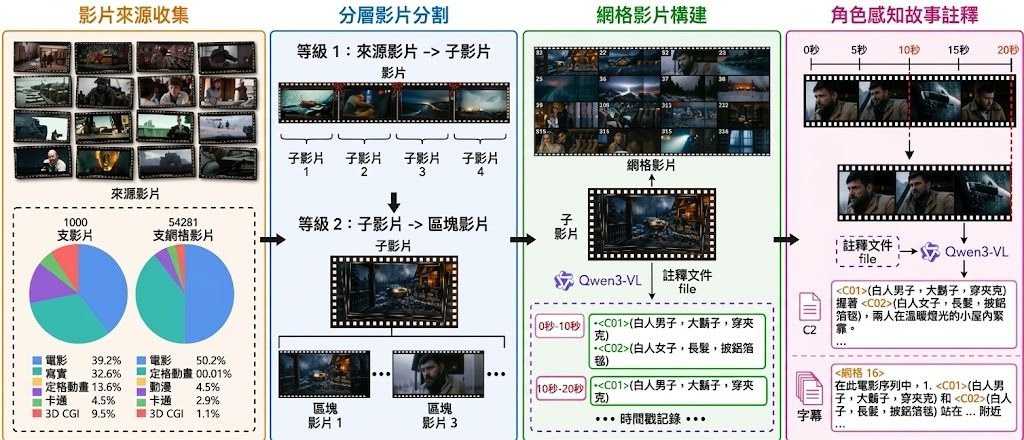
核心做法是把一段長影片切成分佈於空間方格上的短片段,每格只負責少量鏡頭與較短的時間跨度,從而降低單格需要建模的轉場數量;同時所有格子會被聯合生成,並透過 Grid Embedding、角色感知的 Story Prompt 以及 Grid Boundary Loss 來維持格與格之間的銜接。訓練時採用的 Noise-Free Random-Grid Training,會隨機保留部分格子作為乾淨視覺上下文,引導其餘格子的去噪過程。

項目以 Wan2.2-TI2V-5B 作為基座模型,並配搭自家構建的 MGLV 資料集——從 1,000 段長片萃取出 54K 條方格影片,每條都附有角色級故事標註。在等量 token 預算下,MovieGrid 在 1,616 幀長片裡可生成比 Temporal Packing 基線多 6.05 倍的鏡頭,並在自建基準上取得 0.9131 的鏡頭內一致性與 0.5914 的跨鏡頭一致性,分別優於 HoloCine 與 StoryMem。

目前已開源 16 格與 64 格的訓練與推理配置,以及對應的 MovieGrid-16、MovieGrid-64 LoRA 權重;環境需以 Python 3.10 搭配官方 Wan2.2 倉庫安裝。對需要批量產出多鏡頭短片、廣告分鏡或敘事預覽的團隊,這套框架提供了比單時間軸方案更可擴展的路徑,但生成品質仍受基座模型與資料規模所限,未來計劃加入 first frame 與 storyboard 條件控制。

重點摘要:
核心方法:將長片切成空間方格短片段並聯合生成,減輕每格時間跨度負擔。
關鍵機制:Grid Embedding、角色感知 Story Prompt、Grid Boundary Loss 與 Noise-Free Random-Grid Training。
基座與資料:基於 Wan2.2-TI2V-5B,配搭自建 MGLV 資料集共 54K 條方格影片。
開源狀態:已釋出 16 格與 64 格的推理配置、訓練代碼,以及對應 LoRA 權重。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, Embedding, 模型, 模型訓練, Video, 框架, Python, , Dataset 數據集

Perplexity 開源 Lily:Mac 本地推理專用提速引擎

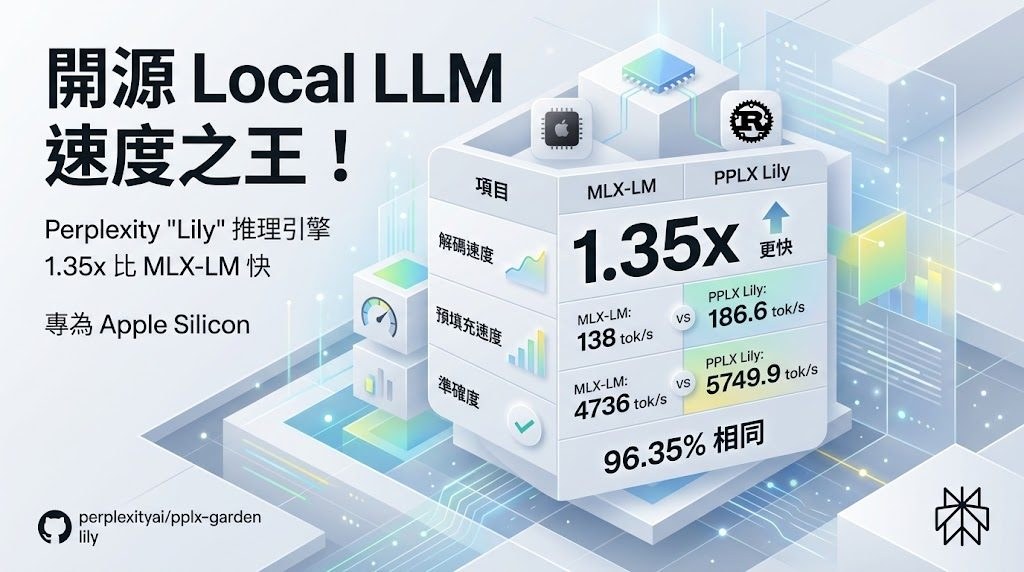
Perplexity 推出針對 Apple Silicon 與 Qwen3.6-35B-A3B 的本地推論引擎 Lily,繞過 PyTorch 與 MLX,以 Rust 和自訂 Metal kernels 改善預填充及解碼效率。

Repository image for perplexityai/pplx-garden

當大型模型開始負責處理 Mac 上的私人檔案與應用程式,本地推論速度就不再只是開發者實驗的指標。Perplexity 開源嘅 pplx-garden 入面,Lily 以工具項目形式處理 Apple Silicon 上 Qwen3.6-35B-A3B 的推論,目標係令提示詞處理及文字生成更快,並透過 OpenAI-compatible HTTP API 串接聊天流程。

Lily 唔似 MLX-LM 般追求支援多款模型,而係集中服務 Qwen3.6-35B-A3B:Rust runtime 負責載入 checkpoint、管理 session state 同生成迴圈,自訂 Metal kernels 就處理模型特定運算。呢種單一進程、模型與 runtime 共同協調嘅做法,減少通用 kernel 帶來嘅額外調度,亦避開 PyTorch 和 MLX execution path。

pplx-garden 不只是 Mac 本地推論工具。fabric-lib 提供 RDMA TransferEngine,同時涵蓋 P2P MoE dispatch 與 combine kernel;pplx-unigram 則係針對 Unigram tokenizer 嘅 CPU encoder。相關內容亦包括 trillion-parameter model 喺 AWS EFA 上嘅部署,以及 RL post-training 權重轉移、分離式 prefill 和 decode 等系統研究,顯示儲存庫涵蓋由裝置端推論到分散式 LLM infrastructure 嘅多個瓶頸。

適合需要喺 Mac 處理敏感資料、又希望保留本地生成能力嘅開發者及研究團隊;需要 RDMA、MoE 溝通或 tokenizer 優化嘅系統工程人員亦可參考相關元件。現有資料集中講述 Lily 分別量度 prefill throughput 同 decode throughput。

重點摘要:
– Lily 專為 Apple Silicon 與 Qwen3.6-35B-A3B 設計,支援 OpenAI-compatible HTTP API。
– 以 Rust runtime 配合自訂 Metal kernels,分開處理 prefill 同 decode。
– 不經 PyTorch 或 MLX execution path,代價係模型及硬件支援範圍較專門。
– fabric-lib 同 p2p-all-to-all 面向 RDMA、MoE dispatch 與 combine 等分散式推論問題。
– 效能應按裝置、上下文及生成負載實測,不能只依賴官方定位作比較。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, Qwen, OpenAI, API, 提示詞, 工具, Mac, Python, , 蘋果, Dataset 數據集

Page 1 of 7
1 2 3 7