RecursiveGameCreator:讓你的創意從原型走向成功的遊戲開發框架

Recursive Game Creator 把設計、開發、遊玩與評審串成循環,令 AI 遊戲開發不止於成功運行。

Recursive Game Creator framework: Designer, Builder, coding-native Player, and Reviewer connected through game developme

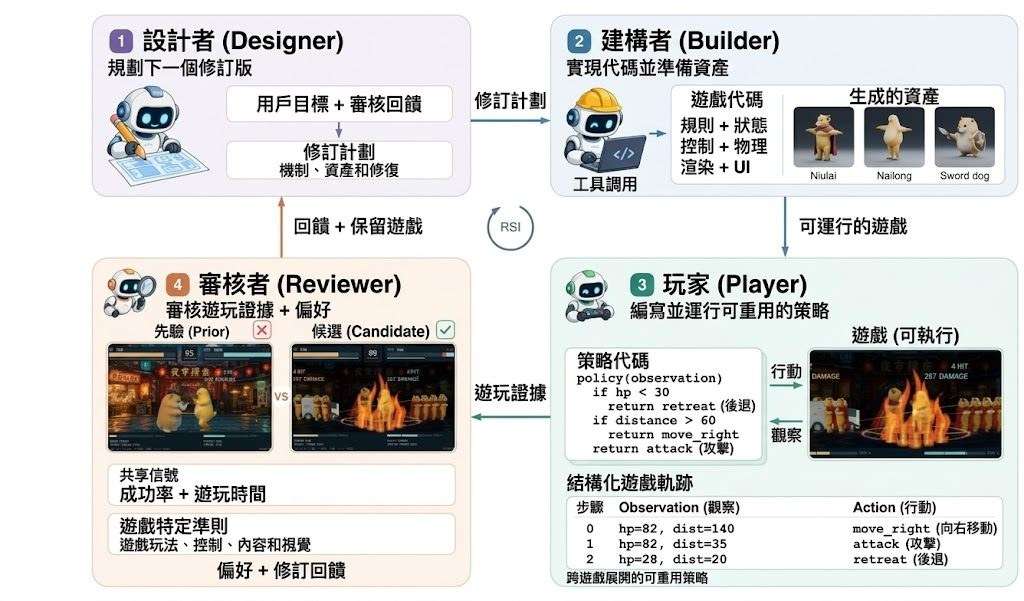
遊戲能夠運行,不代表玩家會覺得好玩。Recursive Game Creator 將 Designer、Builder、coding-native Player 與 Reviewer 串成循環,屬於一個 Agentic Product-Level Experience-Oriented Game Harness,處理 AI 由可玩原型持續改良至完整遊戲時,缺乏體驗評估的問題。

Player 會透過程式介面執行可重用的 gameplay policies,收集多條 gameplay trajectories,毋須每個動作都重新呼叫模型,較適合反覆測試機制與內容。Reviewer 再結合行為軌跡、畫面觀察、玩家偏好及遊戲專屬準則,為下一輪 Designer 計劃提供修訂回饋。

項目支援 HTML 和 Godot,遊戲可在隔離 runtime 內開發及測試,亦可選擇接入影像、3D asset 與 Blender。macOS 或 Linux、Git、Node.js 22/npm,以及運行中的 Docker daemon 是主要環境要求;Docker 使用 software rendering,主機不必配備 GPU。

目前公開結果以三輪迭代展示改良,GameCraft-Bench overall 由 R1 至 R3 提升 5.19 points。這個數字反映循環式修訂的效果,但未等同所有遊戲都能獲得相同體驗,因為評審準則、玩家偏好及遊戲類型仍會影響結果。

較適合研究 agentic game development、需要大量自動 playtesting 的團隊,以及希望比較遊戲版本演進的開發者。實驗可從 HTML 遊戲開始,再按需要加入 Godot、視覺素材或 Blender 整合,先驗證設計—開發—遊玩—評審流程是否符合自身工作流。

  • 以四個角色連接設計、實作、遊玩與評審
  • 透過 reusable policies 收集 gameplay trajectories
  • 同時考慮行為、畫面與玩家偏好
  • 支援 HTML、Godot、3D asset 及 Blender 整合
  • GameCraft-Bench 三輪迭代提升 5.19 points
項目主頁 · GitHub

Categories: 開源, 香港大學, Agentic, 模型, DeepSeek, Image, 框架, 香港, 軟件, Mac, 3D, Linux, 編程

CIA-minimal-repro:與思維鏈一致性改進模型訓練

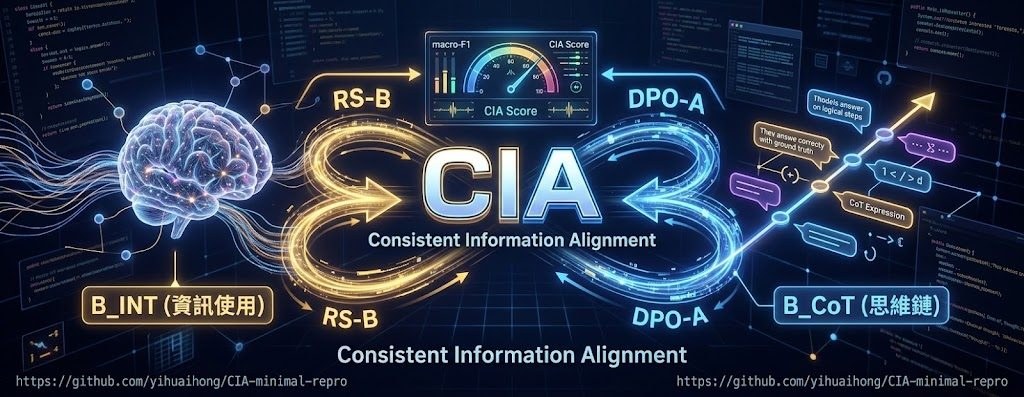
CIA 將模型是否真正使用關鍵資訊,與 CoT 是否說出相關內容分開量度,再用 RS-B 和 DPO-A 改善兩者的一致性。

Repository image for yihuaihong/CIA-minimal-repro

當模型答對問題,卻未必真正用到提示中的關鍵資訊,CIA 以可驗證的方式拆開這個差異。這個 GitHub 項目屬於模型訓練及評估程式碼,處理模型內部資訊使用(B_INT)與 Chain of Thought(B_CoT)表述是否一致的問題,並以 macro-F1 定義 CIA 分數。

RS-B 和 DPO-A 使用同一批資料起步:基礎模型為每個提示取樣 16 個回答,再按內部使用資訊、CoT 表述及答案正確性標記。RS-B 保留 B_INT 與 B_CoT 一致的回答進行 SFT,即使答案未必正確;DPO-A 則按正確性加一致性排序,將每題排名最高及最低的回答配對作 DPO,取捨更偏向同時追求正確和忠實表述。

評估涵蓋 TwoHop、Hint 和 Mult 三項任務。TwoHop 以線性 probe 讀取隱藏狀態,Hint 使用 Qwen2.5-32B-Instruct 判斷 CoT 是否承認提示,Mult 則以 causal corruption test 檢查答案會否跟隨被修改的中間乘積;這些方法比單看最終答案更能暴露模型是否真正依賴關鍵步驟。

  • 可重現範圍:提供 RS-B、DPO-A、訓練流程及三項任務的評估入口。
  • 限制:儲存庫只有程式碼,不包含資料、模型權重、probe 權重或實驗結果。
  • 硬件要求:預設以 2 張 GPU 配合 Accelerate 和 DeepSpeed ZeRO-3,原始實驗使用 80 GB A100、H100 及 H200。
  • 檢查方式:TwoHop 每 15 步儲存 checkpoint 並選驗證集峰值,Hint 和 Mult 則只保留最終模型。

研究人員可用它重跑訓練及檢查指標定義,已有 Hugging Face Open R1 訓練環境的團隊亦較容易接入;但缺少資料與權重,不能直接下載後重現結果。項目更適合作為研究管線的精簡骨架,而非開箱即用的完整模型。

GitHub

Categories: 開源, 模型, 模型訓練, Qwen, DeepSeek, 框架, 庫, 深度學習

[技術文章] DeepSeek-V4.1-Flash 百萬上下文 KV Cache 壓到四分之一

百萬 token 上下文背後最大的成本壓力來自 KV cache。DeepSeek-V4.1-Flash 用 CED 架構配合 CSA2,將每個 token 的記憶體用量壓到大約 890 bytes。

Hero image preview

長文 agent 跑得愈久,KV cache 累積得愈快,HBM 容量、頻寬、SSD 傳輸成本幾乎同步飆升;DeepSeek 團隊認為,這才是 scaling down 長上下文部署成本的主要瓶頸,而不單是推論計算本身。

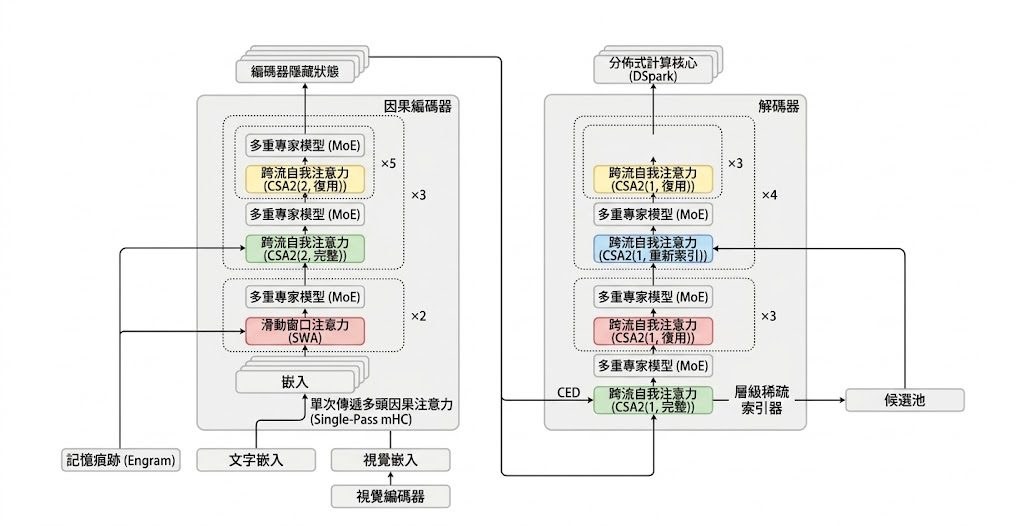
為處理這道難題,DeepSeek-V4.1-Flash 採用 Causal Encoder-Decoder(CED)架構:prefill 階段啟用 8B 參數,decode 階段啟用 16B 參數,讓輸入極長但輸出相對短嘅 agent workload 成本結構更友善。Backbone 規模去到 552B,並支援長達一百萬 token 嘅上下文。

記憶體方面,Compressed Sparse Attention 2(CSA2)加入跨層 KV cache reuse 與分層稀疏 indexer,再搭配 FP4 KV cache,使常駐 HBM 嘅 global KV cache 降到每個 token 約 890 bytes,相對 V4-Flash 縮減約四倍、相比 V1 更達到 437 倍幅度。透過 SWA Bounded Replay 部署優化,落在 SSD 或 host memory 嘅 persistent footprint 更壓到大約 V4-Flash 嘅八分之一。即使 cache 大幅縮減,模型在 agentic 基準上仍比 baseline 表現更好。

預訓練採用 45T token 嘅多模態語料,後訓練亦經過完整流程,使 V4.1-Flash 在文本與多模態 agent 場景都保持穩定輸出。模型 checkpoint 已於 Hugging Face 開源,可供社群自行部署驗證。

  • 552B 參數 MoE 骨幹,支援 100 萬 token 上下文。
  • CED 架構令 prefill 僅啟用 8B 參數、decode 啟用 16B 參數。
  • CSA2 + FP4 KV cache 將 global KV cache 壓至 890 bytes/token。
  • SWA Bounded Replay 進一步將 persistent KV cache 降至 V4-Flash 約 1/8。
  • 45T token 多模態預訓練 + 完整後訓練,agentic 表現優於前代。

Paper

Categories: 開源, 模型, DeepSeek

Wenyi 把整本書放進記憶:一次譯完一本書,角色名終於唔再走樣

Wenyi 是一款針對小說、專書同長篇敘事嘅開源翻譯工具,主打逐章掃描、術語即時對齊同可斷點續譯,支援 DeepSeek、OpenAI、Gemini 等多個模型供應商。

wenyi emblem

好多人試過用大型語言模型 (LLM) 翻譯小說或學術專書,往往喺第三、四章就發現角色名譯咗另一個譯法,或者術語前後矛盾,要回頭逐段人手修正。Wenyi 就係針對呢個常見痛點而設計嘅 Python 開源工具,主打長篇文本嘅翻譯流程。佢會事先將全書掃描一次,為每個章節建立摘要同全書概要,再喺逐批翻譯時一齊注入,令模型對脈絡同角色關係有長期記憶。

工具同時內建術語管理模組,會隨翻譯過程自動抽取人名、地名同專有詞彙,並偵測前後唔一致嘅譯法,要求人手仲裁,再影響後續批次。咁樣嘅設計對譯者、編輯同人氣翻譯團隊特別有用,可以避免「譯到後期先發現譯名漂移」嘅慘況。Wenyi 仲提供可選嘅多階段品管:先以主力模型做初譯,再由較強模型做潤稿,最後以證據導向嘅方式做整書 AI 審閱,適合對品質要求高、但又想慳人手嘅場景。

操作上,每批翻譯都有 checkpoint 落盤,章節狀態有獨立追蹤,任何時候中斷都可以用同一個指令續譯。支援嘅模型供應商包括 DeepSeek、OpenAI、OpenRouter、OrcaRouter、Google Gemini、Ollama、vLLM 及任何 OpenAI 兼容端點,可分為三個方便嘅 tier,亦可每個操作揀唔同模型。輸出格式方面,佢會直接寫返入原 EPUB 嘅 XHTML 模板,嘗試保留樣式、圖片、目錄同錨點,對電子書排版敏感嘅讀者會幾啱用。

要注意嘅限制係,Wenyi 仍然依賴上游模型嘅語言能力同上下文窗口,對語氣、文風同微妙雙關嘅判斷無可避免會受模型本身限制;長篇翻譯嘅成本同時間亦會隨章節增加。文檔列明需要 Python 3.10 或以上,社群主要喺 Discord 運作。

重點摘要:
– 全書預掃描 (Whole-book prescan):每章摘要 + 全書概要同時注入翻譯批次
– 即時術語同衝突偵測,可人手決議後回寫後續翻譯
– 支援 DeepSeek、OpenAI、Gemini、Ollama 等多 LLM,可分三層 tier
– 提供 checkpoint 續譯,中斷後同一指令可接返
– 多階段品管:初譯 → 強模型潤稿 → 全書 AI 審閱,並原生保留 EPUB 排版

GitHub

Categories: 開源, Google, OpenAI, DeepSeek, Gemini, Image, 工具, Ollama, Python

E-CommerceBench 經營 365 日網店的 Agent 考試

代理人要由十萬元起步,經營最多四間網店並應付供應商、庫存與退貨,最後以全年資產增長分高低。

Mean end-of-year total assets, eighteen models, five 365-day episodes each

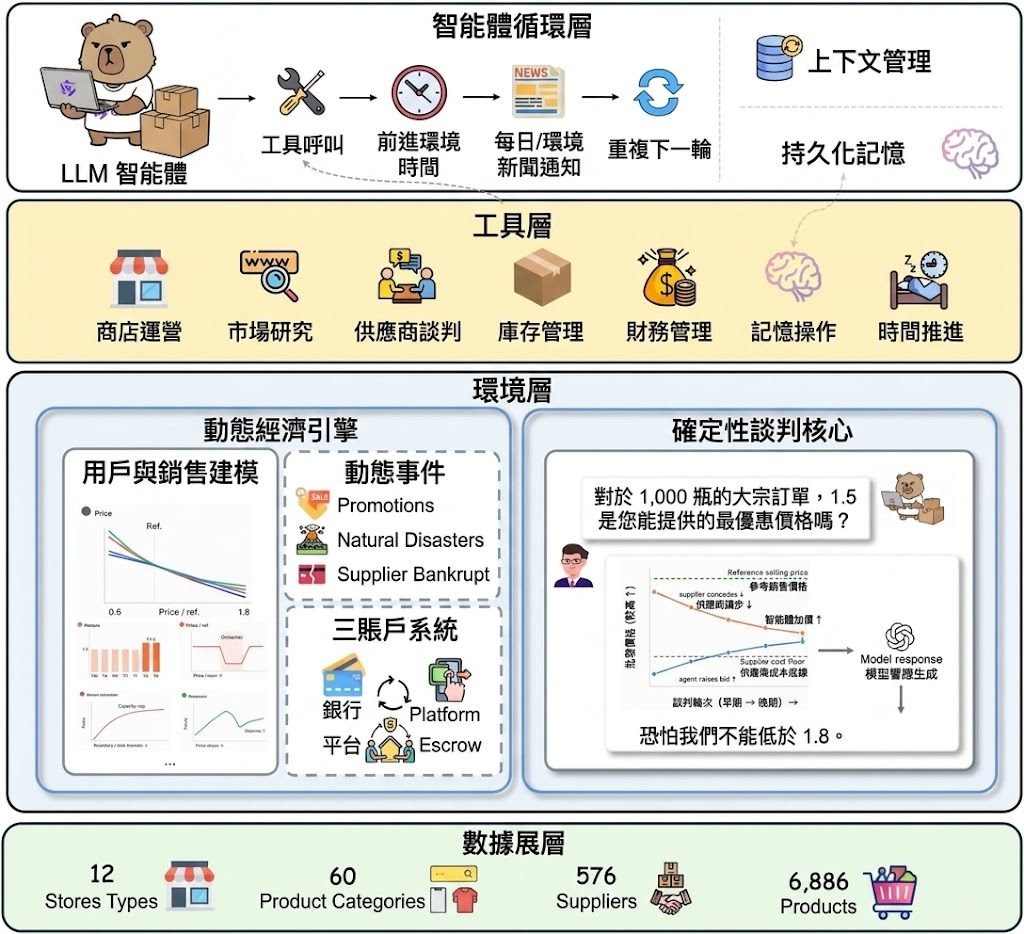
一個代理人由 ¥100,000 起步,連續經營最多四間網店 365 個模擬日,還要自行處理採購、定價、補貨、訂單履行及退貨。E-Commerce Bench 屬於長期自主商業運作的 LLM agent benchmark,實際處理的是代理人能否在現金流、庫存、風險和增長之間持續作出決策。

環境包含 6,886 個產品、60 個類別及 576 家供應商,其中 152 家涉及五種詐騙類型;全年亦有八次促銷和十項市場事件。客戶需求由固定多因素模型決定,供應商價格、讓步及接受與否則由 Deterministic Negotiation Kernel 計算,LLM 只負責把決策呈現成對話,避免抽樣回覆直接改變交易結果。

排行榜以五次獨立 episode 的年終總資產平均值計算 asset multiplier,同時提供標準差、CSE⁺、BadSpend%、回撤、每次工具呼叫帶來的收入、可控退貨比例、AnchorRatio、工具呼叫次數及破產次數等指標。GPT-5.6 Sol(max)平均資產達 ¥1,431,425,約為本金 14.3 倍;最佳 open-weight 模型 Qwen3.8-Max-Preview 為 ¥416,252,約 4.2 倍,18 個模型之間相差 1,264 倍,90 次運行有 10 次破產。

  • 測試場景涵蓋最多約 4,000 個回合,適合研究長期記憶、規劃和工具使用。
  • 固定需求與談判機制令模型差異較容易歸因,但未必代表真實市場的隨機性。
  • 模型排名同時呈現盈利能力、風險控制、浪費開支及資金壓力。
  • 項目資料提到 Python 3.10+,但提供內容沒有列出完整安裝、執行或下載流程。

研究代理人可靠性、商業決策、長期規劃或多步驟工具調用的團隊,會較容易從這套固定世界取得可重複比較的結果;網店經營者則可把它理解成壓力測試,而不是直接預測真實銷售額。它同時比較 proprietary 與 open-weight 模型,但資料未交代各模型的提示詞、工具策略或成本,因此資產排名不應單獨視為整體能力結論。

項目主頁 · GitHub

Categories: 開源, Agentic, Qwen, Google, OpenAI, DeepSeek, Gemini, Python, Anthropic, Dataset 數據集

DeepSeek Harness 把多 Agent 協作變成可控工作台

[教學影片]DeepSeek Harness 讓 DeepSeek dsh 變成可啟動 Web UI 的開發者工作台,重點放在多個 Agent 並行處理、動態工作流同插件擴展。它適合要在複雜程式碼庫入手審計、協作同加速探索嘅使用場景。

Og image

DeepSeek Harness 把 DeepSeek dsh 做成一個可啟動 Web UI 的開發者工作台,處理的是複雜程式碼庫入面要同時分工、同步同收斂結果的問題。影片實測重點放喺並行只讀審計、動態派生 SubAgent,同埋最後將多路輸出整合返去。

它同一般單一路徑的助理做法不同之處,在於可以按工作內容拆成多個 Agent Teams,再根據任務需要即時調整流程。這種安排適合審查、分析同探索型工作,因為不同子任務可以同時展開,唔使一條線慢慢行。

片中亦提到插件開發門檻較低,代表它不只係拿來跑預設流程,仲可以按團隊習慣加功能。對要處理既有代碼、要快速驗證想法,或者想將 AI 工具接入日常開發流程的人,這種擴展性會更實用。

重點摘要:
– 以 Web UI 包裝 DeepSeek dsh,方便直接操作
– 支援多個 Agent 並行工作,減少單線等待
– 可動態派生 SubAgent,按任務拆分工作
– 插件擴展門檻較低,方便接入自訂流程
– 適合複雜程式碼庫審計、協作同探索任務

項目主頁

Categories: 開源, Agentic, DeepSeek, 教學, 編程, 安全, UI/UX

VoxEMW:把 Mac 變成 1.3 秒回應的私人語音助手

VoxEMW 將語音處理放在 Apple Silicon Mac,手機只需透過瀏覽器或 iOS 客戶端對話,回應速度與音色克隆是最大賣點。

Repository image for emwstudio/VoxEMW

對住手機講完一句話,約 1.3 秒後便聽到固定角色用克隆聲線回答,VoxEMW 屬於開源語音助手項目,處理判停、轉寫、對話調度及語音合成,解決語音對話延遲高、角色聲線難以保持的問題。Mac 負責主要語音管線,只有 LLM 大腦經 DeepSeek API 上雲,日常成本相對可控。

整套流程由 Silero 加 SmartTurn 負責判斷何時真正講完,Qwen3-ASR-0.6B-hf 在 MPS 上轉寫,再由 DeepSeek v4-flash 產生回覆,Qwen3-TTS-1.7B-Base 以 MLX 6bit 執行零樣本音色克隆。參考聲音配合逐字台詞便可註冊角色,首段聲音約 0.5 秒生成;中途打斷時,已播放及已聽內容會寫回上下文,對話較不容易斷層。

一块 4090 跑通 AI 视频通话全栈:Qwen3.8-27B 本地部署,对话时延 2 秒

項目需要 Apple Silicon Mac 作本地伺服器,實測以 M5、16GB 記憶體可以流暢運行,模型及環境約需下載 4GB。瀏覽器可直接連接本機介面;iPhone 或 iPad 則要透過局域網 HTTPS/WSS 連線,並自行處理 TLS 證書、Xcode 簽署及免費帳戶七日側載限制。

• 回應最快 1.26 秒,中位數約 1.6 秒,實際速度仍受網絡及 API 影響
• VAD、STT、TTS 留在本機,DeepSeek API 按 token 收費
• 支援流式字幕、空回覆重試及語音中斷後續接
• 全屏星空會隨說話及聲波變化,增加角色互動感

相比全程雲端方案,VoxEMW 減少語音資料離開家中 Mac,但需要一部 Apple Silicon Mac 長期運行;相比完全離線方案,DeepSeek API 帶來額外費用及資料傳輸考慮。適合想建立固定聲線角色、研究低延遲語音管線,或有 Mac 作家庭伺服器的開發者,普通使用者則要先接受證書、模型環境及 API 金鑰設定等門檻。

GitHub

Categories: 開源, 文字轉語音, Qwen, DeepSeek, API, 框架, Mac, 語音, 蘋果

DeepSeek API 加入圖片理解,支援截圖與圖表分析

DeepSeek-v4-flash-vision-exp 可把圖片與文字放在同一個請求,處理截圖、圖片描述及圖表分析。

Og image

處理產品截圖、掃描文件或圖表時,DeepSeek API 現在可讓文字問題與圖片一併送出,由 deepseek-v4-flash-vision-exp 回應內容。這個視覺模型適合用於圖片描述、讀取截圖文字,以及分析圖表等需要結合視覺與語言的工作流。

API 採用 OpenAI-compatible Chat Completions 格式,請求中的 content 不再只是單一字串,而是由文字和圖片區塊組成;Responses API 亦支援以 input_image content parts 傳送圖片。開發者可按項目需要選擇圖片提交方式,文件列出三種方法,其中包括直接內嵌 Base64 圖片,以及提供公開可存取的 http(s) 圖片網址。

支援的圖片格式包括 JPEG、PNG、GIF 和 WebP。系統會按檔案實際內容判斷格式,而不是依賴檔名或宣告的 MIME type;使用 Base64 內嵌本地圖片較直接,但編碼後的資料會計入 48 MiB request body 上限。

  • 可同時分析文字與圖片
  • 適合讀取截圖文字及分析圖表
  • 支援 JPEG、PNG、GIF 和 WebP
  • 兼容 Chat Completions 與 Responses API
  • Base64 圖片會受 48 MiB 請求大小限制

需要把圖片理解接入現有 OpenAI SDK 或 API 工作流的開發者,可沿用熟悉的請求結構,再按圖片來源選擇內嵌資料或公開網址。圖片網址必須可供模型下載,並受 8192 字元長度限制。

項目主頁

Categories: Agentic, DeepSeek, API, Image

Agent Lightning v1.0:把代理訓練接回真實工具流

Agent Lightning v1.0 讓代理在保留工具、上下文和環境的情況下直接訓練。它也把 Kubernetes、程式編寫和獎勵防作弊流程一併整合起來。

logo

Agent Lightning v1.0 針對一個常見卡位:代理訓練往往要靠額外沙箱或改寫流程,令工具、控制流和環境脫節。這個項目把訓練直接接回真實 agent harness,代理可以經由 Agent Lightning v1.0 proxy 運作,而不用改動原本架構。

它的設計取向相當清晰,核心程式碼大約 3,500 行,重寫後把複雜度壓低。代理亦可直接作為 Kubernetes Jobs 執行,不必依賴外部 sandbox 服務,對要跑長時間 rollout 或分散式訓練的團隊會方便很多。

文檔同時提供完整的 coding-agent 訓練流程,涵蓋資料清理、reward-hacking 防護和訓練腳本。這代表它不只停留在概念層面,而是把一條可落地的訓練管線交到使用者手上。

  • 保留工具、上下文、控制流和環境在訓練迴圈內
  • 透過 proxy 接入現有 agents,減少改動成本
  • 原生支援 Kubernetes Jobs,部署更直接
  • 提供 coding agent 範例,連資料清理和防作弊流程都包進去
  • 適合做具互動工具、程式執行或多步推理的 agent 訓練

項目主頁

Categories: 開源, Agentic, 模型訓練, 微軟, DeepSeek, API, Vibe Coding, Python, 編程

DeepSeek Harness 把 Agent 變成插件

DeepSeek Harness 想解決的唔係單一 Agent 功能,而係點樣把模型、工具同工作流拆開重組。對想長期調整 Agent 流程的團隊,呢個方向比單次 demo 更有參考價值。

Repository image for deepseek-ai/deepseek-harness

DeepSeek Harness 把 dsh 做成一個面向開發者的 Agent harness,重點不在於再包一層聊天介面,而是把模型、工具、技能、會話、沙箱、存儲、循環、調度同 UI 全部拆成插件,讓團隊用配置去換件、重組,同時保留可追蹤的執行過程。它處理的是 Agent 進入真實工作流後,經常要改工具鏈、換模式、查執行軌跡的維護問題。

你可以直接用 npx @deepseek-ai/dsh web 啟動 Web UI,也可以從原始碼安裝;兩種方式都指向同一件事:DeepSeek 並非只想交付一個可試玩的介面,而是提供一個可延伸的開發底座。現階段它仍屬 developer preview,兼容性破壞會持續出現,較適合願意跟住 API 與插件生態一齊迭代的團隊。

跟不少把能力寫死在框架內的做法相比,DeepSeek Harness 把 Cordis 放在核心位置,內核只負責插件載入、卸載與依賴關係,Agent 能力則交由插件之間透過服務與事件協作。好處是替換模型、工具或 preset 時毋須大改源碼;代價是系統理解成本較高,穩定性亦未到可安心鎖版的階段。

它提供標準模式、PTC 模式、極簡模式同創造模式,反映出同一套底層同時照顧編碼 Agent、基準測試同自訂 preset。當中較值得留意的是 Trajectory 視圖與僅追加式會話日誌,系統會記錄提示詞、工具調用、結果、子 Agent 調度與上下文注入,對除錯、回放、分叉同檢索都幾有用,但官方未提供明確基準分數,現時較難直接用量化結果同其他 Agent 框架比較。

  • 用 Cordis 作核心,將 Agent 各層能力拆成可替換插件
  • 可經 Web UI 快速測試,亦可由原始碼部署到自訂環境
  • Trajectory 與事件流日誌有助追查每一步決策與工具操作
  • developer preview 階段變動頻密,較適合開發者與研究型團隊
  • 重點價值在可組合工作流,而唔係單一模型能力展示

項目主頁 · GitHub

Categories: 開源, Agentic, DeepSeek, API, 工具, Skill 技能, UI/UX

Page 1 of 5
1 2 3 … 5