[技術文章] WeLM-Image:把生圖、指令編輯與多圖合成整合一個模型

從文字生圖、按指令修改圖片,到合併多張參考圖,WeLM-Image 嘗試用同一模型處理多種視覺創作需求,並支援單張 GPU 執行。

Hero image preview

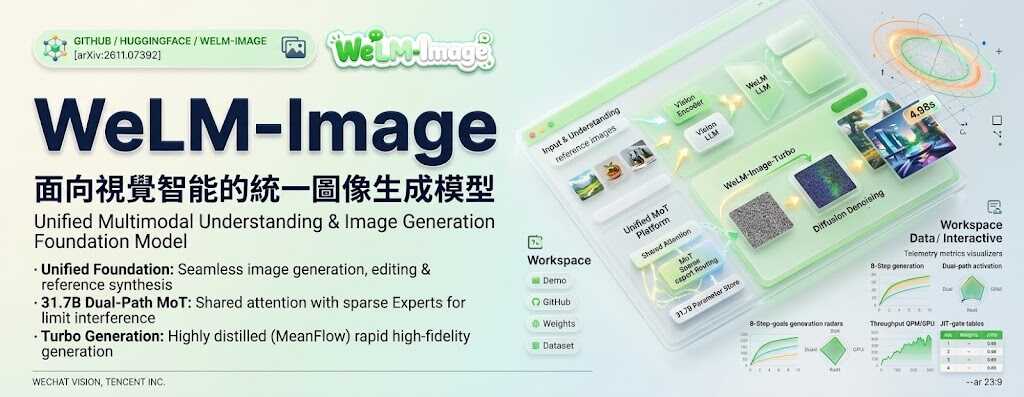
創作時要由文字描述生成圖片、再修改姿勢或移除路人,甚至合併幾張參考圖,WeLM-Image 都可用文字指令處理。這個騰訊 WeChat Vision 團隊推出的統一圖像模型,亦支援在圖片中加入或替換文字,面向 WeChat 的消費者應用設計,目標是在單張 GPU 上部署。

常見做法會把圖像理解與生成分成不同模型或參數路徑,處理多種任務時可能互相干擾。WeLM-Image 把文字、參考圖像與目標圖像的潛在表示交錯放進同一序列,再以 Mixture-of-Transformers(MoT)共用注意力、分開理解與生成參數,並用 Mixture-of-Experts(MoE)提供稀疏運算容量。

訓練資料涵蓋雙語標註與經核實的編輯範例,並逐步訓練至原生 1.5K 解像度。團隊分別針對生成與編輯使用評分規準及檢查清單設計獎勵,再以感知雜訊的 on-policy distillation 整合兩條路徑。

報告指出,1,536 解像度版本在 PRISM-Bench、Qwen-Image-Bench 及 UnicBench 的受測開源模型中排名第一。加速版本 WeLM-Image-Turbo 則以 MeanFlow 蒸餾,在單張 NVIDIA H20 GPU 上用八步生成 1024 × 1024 圖像,耗時 4.98 秒。

  • 同一模型涵蓋文字生圖、指令編輯與多參考圖合成。
  • 可處理姿勢調整、風格轉換、物件增刪及畫面文字修改。
  • MoT 分開理解與生成參數,MoE 提供稀疏模型容量。

Paper

Categories: 開源, 騰訊, 模型, 多模態模型, Qwen, NVIDIA, Image, 影像模型, txt2img

EmoReward:讓影片生成按情境調整情緒評分

情緒表達沒有唯一標準答案,固定評分模型容易忽略不同影片中的細微線索。EmoReward 會按影片內容調整各類獎勵訊號的可信度,並把訓練經驗帶到下一輪。

EmoReward logo

生成影片要呈現特定情緒,不能只靠一個固定分數判斷做得好不好。EmoReward 是一套用於情緒影片生成強化學習的獎勵校準機制,會按影片中的情緒階段、面部表情、訊號衝突與細微線索,決定不同評分來源各自應佔多大比重,處理情緒主觀而且隨時間變化的問題。

透過 Reflective Reward Gating,在每段影片中調整面部動作、語意等不同獎勵訊號的可信度。完成一輪訓練後,RewardMemory 會整理哪些情境下的線索較可靠,轉成有上限的融合權重倍率,供下一輪訓練使用;記憶表在該輪訓練期間保持凍結,避免權重持續變動。

這種跨輪次校準適合研究情緒影片生成、強化學習後訓練,或需要整合多種評分模型的團隊。項目以 HunyuanVideo-1.5 為基礎模型,並採用 SAGE-GRPO 作為強化學習骨幹;實驗涵蓋三種影片強化學習算法及兩個影像骨幹,亦包括消融實驗與人類評估。

  • 按影片情境調整不同情緒評分訊號的權重。
  • 不改動獎勵模型參數,降低校準對模型本身的干預。
  • 把一輪訓練所得的線索可靠度帶到下一輪,訓練期間凍結記憶表。
  • 評估涵蓋三種影片強化學習算法、兩個影像骨幹及人類評估。

項目文件列出 PyTorch 2.6+、Transformers 4.57.1 與 Diffusers 0.35.0 等依賴。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 騰訊, AI productions, 模型, 多模態模型, 模型訓練, Video, Image, 香港, Python, 庫, 強化學習

Wizard:讓 AI 即時改動遊戲世界與戰鬥規則

Wizard 讓玩家用指令改變場景、角色和戰鬥狀態,再即時生成連貫影片。它適合探索互動遊戲原型與可控世界模型的創作方式。

favicon

改變地形、召喚敵人,甚至令角色變身,Wizard 都能把這些操作整合到即時遊戲畫面中。這個世界模型項目以代理控制修改遊戲狀態,再由影片生成模型呈現變化,目標是讓互動不只限於移動角色,也能改動環境與戰鬥規則。

使用者可透過按鍵、文字指令或單張畫面控制世界。場景幾何、角色骨架、動作和戰鬥狀態會分開記錄,因此系統可以處理平台升降、地面變形、角色攻擊與受傷等變化;影片生成器則以每秒 24 幀輸出畫面。項目亦稱,展示中的場景和角色都是模型未曾見過的內容。

整個流程分成快速建置和遊戲期間的控制。建置階段會重建場景與角色、配置骨架並整理動作;遊戲期間,代理更新幾何、動作和戰鬥狀態,再交由 Wan2.2-TI2V-5B 生成影片。文字指令會轉成幾何操作程式,戰鬥則由狀態追蹤、攻擊規劃和規則控制器處理。

• 適合想測試可互動遊戲場景、角色動作及戰鬥變化的研究者與創作者。
• 可用文字指令、按鍵或畫面輸入控制世界,也能比較生成影片與場景代理畫面。
• 每秒 24 幀生成,並以兩步去噪處理;項目描述的建置階段少於五分鐘。
• 程式碼尚未公開,現有資料亦未提供下載或使用流程。

Wizard 把可明確追蹤的遊戲狀態與即時影片生成結合,適合探索「能否直接操控世界規則」這類互動設計。它的應用仍受限於目前展示和程式碼尚未開放的狀態,外部使用者暫時難以自行驗證或整合。

項目主頁

Categories: 騰訊, Agentic, AI productions, 模型, 視頻模型, 世界模型, Qwen, Video, Image, 框架, Content Creator, 動畫

WeVisCut 單一 9B 模型自主剪出多分鐘知識影片

由文章或旁白稿生成多分鐘影片,WeVisCut 讓模型逐步選擇剪輯工具,並可在時間線上修改成片。運行 9B 模型約需 24 GB NVIDIA GPU。

WeVisCut

把知識文章或旁白稿變成多分鐘影片,通常要處理分段、鏡頭、配音、素材、字幕和配樂。WeVisCut 是一個長流程影片剪輯 Agent,由單一 9B 模型讀取剪輯狀態,每次呼叫一項工具,逐步完成製作;它處理的是長篇內容轉成可編輯成片的流程,而非只生成單一畫面或短片段。

模型不依照寫死的階段流程前進,而是按當前狀態決定下一步;防護規則只會拒絕不合法的操作,不會代替模型選擇。每次任務通常約有 12 次工具呼叫,涵蓋文章分段、鏡頭規劃、語音合成、素材檢索、動畫模板、配樂、檢查、修正及合成。檢查與反思本身也是工具,模型可按檢查結果修補未達要求的部分。

Studio 提供八條同步時間軌,成片完成後仍可手動編輯,也支援暫停與續做、聊天修改、單鏡頭重製及版本回退。這讓內容團隊能把它用作長篇解說影片的初剪與修改工作台;成片仍需要人手確認素材、旁白和敘事是否合適。要運行 bf16 9B 模型,項目列出的硬件需求約為 24 GB NVIDIA GPU;只開啟介面、不執行模型則不需 GPU。資料未提供完整安裝及素材服務設定流程,不能只憑這些資訊判定部署所需的全部硬件與外部服務。

評估使用 100 項保留任務,整體分數為 90.5;項目亦報告,每分鐘成功輸出的生成 token 數約比 Claude Opus 5 少 33 倍。這些數字反映項目設定下的測試結果,不足以單獨證明不同影片類型或工作環境都能得到同樣成效。訓練資料則由 3,750 個完成影片項目還原剪輯意圖,再經驗證重播整理出 134,771 個訓練例子;開放的資料建構流程可供研究長流程工具操作的團隊參考。

  • 輸入知識文章或旁白稿,輸出多分鐘剪輯影片。
  • 單一 9B policy 每次呼叫一項工具,按編輯狀態自行規劃後續動作。
  • Studio 保留可編輯時間線,支援逐鏡修改與版本回退。
  • bf16 9B 模型約需 24 GB NVIDIA GPU;純介面模式毋須 GPU。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, Agentic, AI productions, 模型, 模型訓練, NVIDIA, Video, 工具, 語音, Anthropic, 動畫

DraMaze 讓長篇微短劇少重複套路,兼顧劇情連貫

長篇微短劇寫到後段,AI 容易反覆使用相似的劇情推進方式。DraMaze 以多個代理人探索不同因果路徑,並按未來劇情需要找回關鍵往事。

Hero image preview

微短劇需要密集轉折,但劇集一長,AI 生成的情節容易逐漸集中在少數套路,例如角色關係反覆靠誤會與澄清推進。DraMaze 是面向長篇劇本生成的多代理人流程,嘗試同時維持故事連貫與情節變化。

常見做法會用歷史摘要、記憶檢索或知識圖譜提供前文脈絡;但檢索到相似經歷,也可能令模型重複舊有因果模式。DraMaze 改用「未來敘事依賴樹」整理往事,按後續劇情目標保留和檢索相關記憶,並透過套路記憶引導的演化樹搜尋與變異,探索不同的因果發展。

研究團隊亦推出雙語評測基準 MiDramaBench,評估不同長度劇本的邏輯與創意,並加入衡量因果模式重複和多樣性的指標。測試涵蓋三個基礎大型語言模型;生成最多 60 集、約 6 萬字劇本時,因果模式重複減少 32.1%,邏輯評分達 82.5 分,較最佳基線高 8.5 分。

  • 面向數十集的長篇微短劇生成,兼顧前後連貫與劇情變化。
  • 依照未來情節需要整理記憶,不只按語意相似度檢索舊內容。
  • 以演化樹搜尋和變異探索不同的劇情因果路徑。
  • MiDramaBench 提供雙語評測,涵蓋邏輯、創意及因果模式多樣性。

對需要批量構思長篇微短劇的編劇與內容團隊,DraMaze 提供一套可評估的生成流程;不過,摘要所列結果集中於特定劇本長度與評測指標,不能單憑這些數字判斷所有題材和創作場景的表現。

GitHub · Paper

Categories: 騰訊, Agentic, 模型, 框架, KnowledgeGraph, 中國, Dataset 數據集

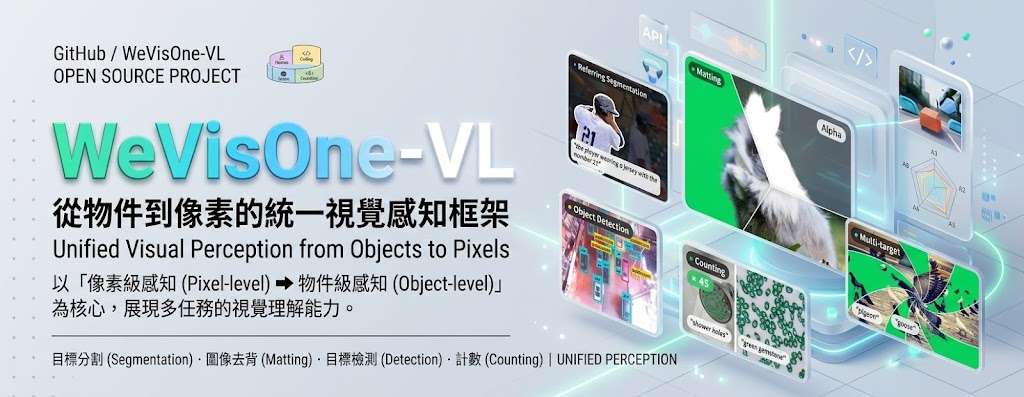
WeVisOne-VL 整合多種視覺任務

由座標定位延伸至遮罩與透明度摳圖,WeVisOne-VL 把多種視覺任務整合在一個模型,並以輕量解碼器處理像素輸出。

WeChat Vision

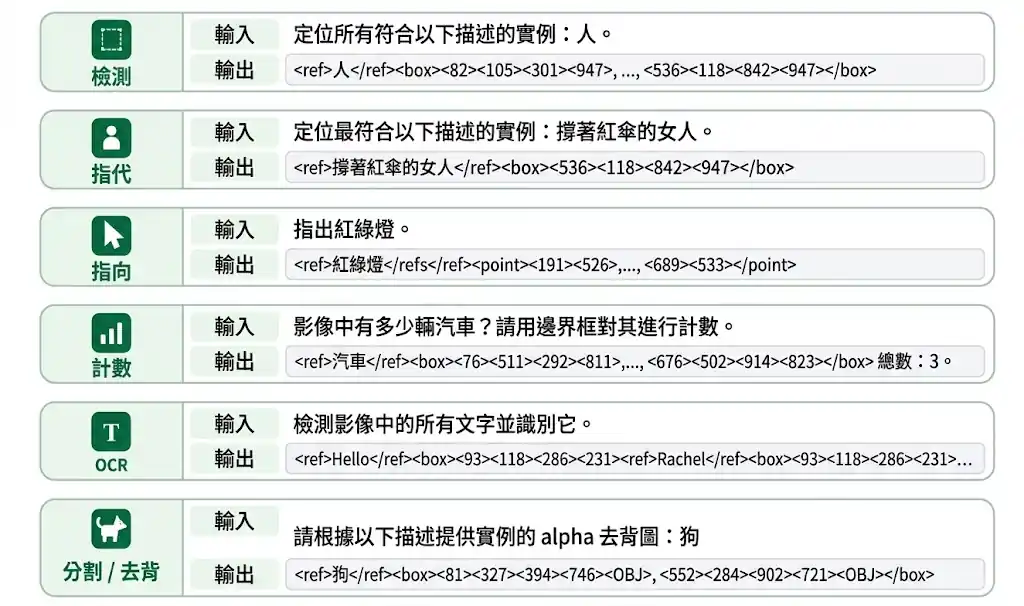
要在一張圖中找出物件、讀取文字,再按需要輸出座標、遮罩或透明度邊緣,WeVisOne-VL 把物件層級與像素層級工作整合為視覺語言模型(Vision-Language Model,VLM),適合標註及影像檢查流程。

模型建基於 Qwen3-VL,以 structured next-token prediction 生成定位結果:座標 token 表示點與框, token 則觸發像素解碼器。解碼器只有 9.6M 參數,重用 Vision Transformer(ViT)特徵,不需 Segment Anything Model(SAM)或外置分割骨幹,可輸出二值遮罩與連續 alpha matte。

任務涵蓋物件偵測、指稱定位、計數、指點、光學字元辨識(Optical Character Recognition,OCR)、指稱分割及 promptable alpha matting;找不到指定目標時會回傳 None,減少虛構定位。需要在同一流程處理定位、分割與前景摳圖的團隊,可評估它是否適合自身資料和任務。

  • 提供 2B、4B 模型權重、推理套件、Cookbooks、Gradio 示範及評測流程。
  • 微調程式碼尚未提供;資料亦未列出硬件需求或逐步安裝方式。
  • 項目在 30 多項基準測試領先。

項目主頁 · GitHub

Categories: 開源, 騰訊, 模型, 視覺模型, 多模態模型, Qwen, 微軟, Image, Medical醫學

ShotVerse2.0:讓影片生成更有電影感

從文字生成影片時,角色衣着、場景和鏡頭動作往往難以同時維持一致。FAPL 訓練多模態語言模型理解影片生成所需的時間線索,並支援分項控制。

FAPL training framework

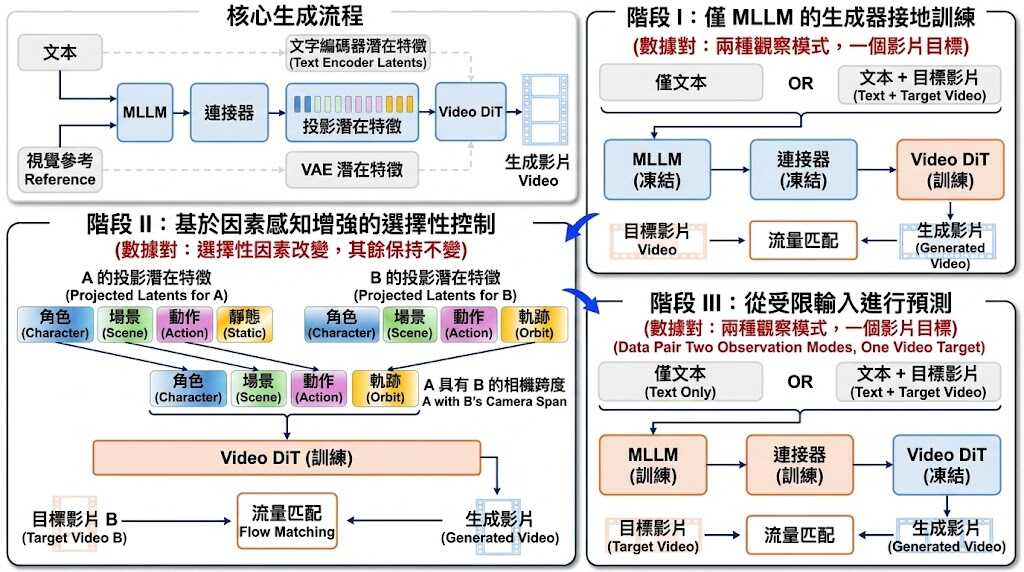
文字生成影片時,模型不只要描寫眼前一幕,還要推斷未提供的時間變化,並在角色、場景、動作和鏡頭之間維持一致。FAPL(Factor-Aware Predictive Learning,因素感知預測學習)是一套訓練方法,旨在讓多模態大型語言模型(Multimodal Large Language Model,MLLM)的表示真正參與影片生成,而非被解碼器繞過。

它以 UniVideo 的 13B Video DiT 為基礎,不改動模型架構,而是分三階段訓練:先令 DiT 以 MLLM 潛在表示作為內容條件,再透過成對的因素編輯資料,教模型只改指定內容、保留其他因素;最後固定 DiT,訓練 MLLM 與連接器,讓只有文字或文字加完整影片的輸入都能對應同一影片目標。這讓方法同時處理文字推斷影片細節,以及按因素選擇性控制的需求。

研究報告的評測中,FAPL 把 Motion Order 由 48% 提升至 61%,∩-Acc 由 42% 提升至 58%,FaceSim-Arc 則由 0.451 升至 0.523。展示案例亦呈現角色衣着和外觀較能維持一致;不過,這些數字來自指定評測,不能直接視為所有提示詞或影片情境下的保證。

目前較適合研究影片生成、希望改善多因素控制的團隊參考。GitHub 資料標示程式碼、模型權重及 CineFactor-10K 評測提示仍待發布,因此暫未能按儲存庫提供的資料安裝或重現訓練;現階段可先閱讀論文及項目網頁了解方法與示例。

  • 以 MLLM 潛在表示作為影片生成的內容條件。
  • 分開訓練內容 grounding、因素控制與有限輸入預測。
  • 可針對角色、場景、動作或鏡頭變更,同時保留其他因素。
  • 在所列評測中,動作順序、因素準確度與人臉相似度均有提升。
  • 程式碼、權重和評測提示尚未發布,現階段無法依實驗。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 騰訊, AI productions, 模型, 多模態模型, 模型訓練, Video, 提示詞, 香港, 庫

Hy Memory 共享不同 Agent 的記憶

Hy Memory 的模型、框架、應用三層全開源。將聊天脈絡、工作進度與代碼修改原因分開管理,再讓不同 AI 工具共享同一份記憶。

Tencent Hunyuan

當 AI 需要記住的不只是單句事實,還包括事情是如何發展、任務做到哪一步,以及代碼為何這樣修改,Hy Memory 便提供了一套較完整的處理方式。它屬於面向 LLM agents 的認知記憶引擎與 Python SDK,將 Chat、Working、Coding 三類場景分開處理,減少長對話和長期任務中召回錯誤脈絡的問題。

Chat 以分層長期記憶整理事件及後續發展;Working 同時保存任務事實與可重用經驗,重用前會檢查適用條件;Coding 則以版本演化鏈追蹤每次改動,將相關指令、真實 diff 和指定函式區塊連結起來。這比單純把內容切段後交給向量搜尋更適合需要延續工作的 Agent,但也依賴清晰的 user id、workspace id 和代碼變更來源。

• 自動按工具呼叫及搜尋模式分流到三類記憶
• 支援記憶的新增、更新、刪除、列出及 System 2 演化
• Coding 可讀取本地 Git diff,亦可處理 path、old、new 替換記錄
• MemHub 將 Claude Code、Cursor、Codex、OpenCode 和 Qwen Code 等工具的資料集中管理

評測涵蓋四套 benchmark:LoCoMo 聊天記憶準確率為 72.6%,MemoryArena 工作記憶平均分為 55.31%,CodeMemoryBench 的問答及解決率為 64.2% 和 35.6%,SWE-ContextBench 解決率為 28.3%。官方亦指記憶儲存佔用維持在較低水平,但不同任務和資料來源仍會影響結果。

透過 hy-memory SDK 接入,按場景寫入及搜尋;不指定場景時,無工具呼叫的寫入會直接進入 Chat,帶工具呼叫的內容才會分類。Hy-Memory-30B-A3B 是負責記憶讀寫的專用模型,約有 3B 激活參數,並可與引擎分開使用;MemHub 則提供 local-first 桌面及 CLI 產品,適合需要跨 AI 工具延續對話或編程工作的個人與團隊。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, Agentic, 模型, API, 工具, IDE, Python, 編程, Dataset 數據集

Terminal-RSI 讓終端機代理循環改寫策略

Terminal-RSI 透過成功軌跡反覆改寫與微調策略,提升模型完成終端機任務的能力。

Og image

終端機代理面對複雜指令時,往往不是完全不懂,而是在多輪操作中逐步偏離正確路徑。Terminal-RSI 是一項研究項目,利用驗證成功的 terminal trajectories,讓 27B 參數模型反覆修正自身行為,減少同類任務重犯錯誤的情況。

項目把 Recursive Self-Rewrite 與 Policy-Refine 分成兩條互相配合的流程。模型先透過不同 harness 產生操作軌跡,再由 terminal verifier 篩走失敗結果;成功軌跡會交給 actor 進行 SFT,critic 則保留並重新校準,之後再以 actor–critic PPO 一同優化政策。

它採用 TB-GAE(Turn-Based Generalized Advantage Estimation)追蹤生成 token 的責任,觀察內容留在上下文中,信用分配則沿着每輪操作向後傳遞。完成一輪後,保留的 checkpoint 會成為下一輪遞歸改進的起點,而非每次都由零開始訓練。

測試結果顯示,Terminal-Bench 4.0 的分數由 0.00% 升至 19.84%,Terminal-Bench 2.1 則由 51.70% 升至 86.52%,分別提升 19.84 個百分點及 34.82 個百分點。兩個基準版本的任務與難度不同,數字較適合用來觀察各自的改進幅度,不能直接當作同一條排行榜比較。

  • 只保留通過 verifier 的成功軌跡
  • 以 Recursive Self-Rewrite 改寫可重用的操作經驗
  • 以 Policy-Refine 持續調整 actor–critic 政策
  • Terminal-RSI-27B 是目前展示的最終 checkpoint
  • Code 與 model 仍標示為即將推出

對需要模型執行檔案處理、程式編輯或多步驟 shell 任務的工作流,這種訓練方式提供了另一條提升可靠性的方向。不過項目仍處於研究展示階段,代碼及模型尚未公開,結果亦主要集中於指定的 Terminal-Bench 評測。

項目主頁

Categories: 開源, 騰訊, Agentic, 模型

Multics:開源多玩家世界模型

Multics 是騰訊 ARC Lab 與港大合作的多玩家影片生成世界模型,靠分層通訊機制讓同一個訓練版本直接推廣到 6、8、10 人,玩家與鏡頭控制互不干擾。

Repository image for TencentARC/Multics

打機時如果有 4 個、6 個甚至 10 個玩家走在一起,畫面要保持連貫,又要讓每個人各自控制鏡頭與動作,舊做法往往一加人就 O(N²) 爆計,或出現互相干擾。Multics 正是針對這個卡位:來自騰訊 ARC Lab 與香港大學的開源世界模型,採用 Player → Group → Global 的分層通訊,動態根據最近鏡頭軌跡分組,限制無關事件直接混合。共享的 group-token 參數令用 4 人數據訓練的模型,可以直接推廣到 6、8、10 人而毋須重新訓練。

對於做多人遊戲原型、模擬訓練環境或敘事影片的團隊,這個項目直接省掉「人數一變就要重訓模型」的麻煩,同時降低自注意力計算量,GPU 開銷壓得較低。它的代價是依賴 NVIDIA GPU、CUDA 12.8 與 Linux 環境,安裝需用 uv 同步依賴,並從 Hugging Face 下載包含 VAE、tokenizer 與 4-player checkpoint 的完整推理包。

Repository 提供 inference.py 配合 YAML 配置,可選擇 4-player 範例或擴展到多人數測試,原始資料未列出具體的玩家數上限驗證結果,只說明同一個 4 人 checkpoint 能支援 10 人輸出。代碼以 Apache 2.0 授權,研究與商業應用皆可改作。

重點摘要:

  • 騰訊 ARC Lab 與香港大學共同開發的多玩家影片生成世界模型
  • 分層通訊機制降低注意力計算成本,避免無關玩家互相干擾
  • 共享參數設計讓 4 人訓練版本直接支援 6、8、10 人,毋須重新訓練
  • 推理需 Linux + CUDA 12.8 + NVIDIA GPU,模型權重經 Hugging Face 發佈
  • 適合多人遊戲畫面合成、模擬訓練、互動敘事等需要可擴展多視角的工作場景

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 騰訊, 模型, 世界模型, 模型訓練, NVIDIA, Video, 香港, Linux, Tokenize

Page 1 of 5
1 2 3 … 5