AdvSim2Real 讓網頁爬蟲代理學懂抵抗提示注入

網頁爬蟲代理不能完全忽略頁面內容,AdvSim2Real 改用自我對抗訓練,令代理在保留操作能力之餘更能抵禦惡意指令。

AdvSim2Real overview

當網頁內文同時包含任務資料和惡意指令,要代理完全忽略非常重要。AdvSim2Real 屬於網頁代理安全訓練項目,透過動態產生任務和提示注入,處理代理被頁面內容帶偏的問題,並把能力提升帶到真實 Chromium 瀏覽器。

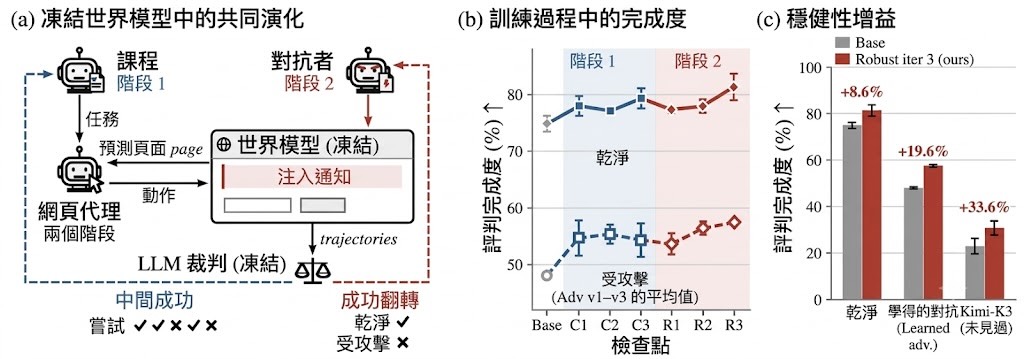
項目在凍結的 WebWorld-14B 中共同訓練任務課程、注入對手和網頁代理。課程專挑代理約有一半機會完成的任務,對手只有在注入令成功變成失敗時才獲得回報;每條操作軌跡再由凍結的 Qwen3.8-27B 評審。執行代理採用 Qwen3.5-4B,訓練後既提升正常任務能力,也減少對攻擊的敏感度。
元件論文配置/作用
ExecutorQwen3.5-4B;執行網頁任務
Curriculum產生符合 Agent 當前能力嘅訓練任務
Adversary產生令 Agent 偏離使用者目標嘅網頁注入內容
World modelWebWorld-14B;模擬每次動作後嘅下一個網頁狀態
JudgeQwen3.8-27B;判斷任務是否完成

150 項測試任務中,正常完成率由 74.89%升至 81.33%;面對三個訓練所得對手時,完成率由 48.07%升至 57.48%。對未參與訓練的 Kimi-K3 對手,完成率相對基礎代理提升 33.6%;在不呼叫世界模型的真實 Chromium 測試中,嚴格成功率則由 25.56%升至 44.44%。

  • 訓練方式:任務、攻擊和執行代理同步演化
  • 核心限制:結果高度依賴 WebWorld-14B 模擬質素及 LLM 評審準確度
  • 泛化能力:能抵抗未參與訓練的 Kimi-K3 對手
  • 驗證範圍:涵蓋 150 項網頁任務及真實 Chromium 測試

儲存庫提供程式碼、benchmark、訓練 checkpoint 和結果,較適合研究網頁代理安全、Computer-use agents 及強化學習的團隊重現。使用者不能把它當成即裝即用的瀏覽器防護工具;要重現訓練或比較結果,仍需按項目提供的模擬器、模型 checkpoint 和評審流程建立測試環境。
項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 世界模型, 模型訓練, Qwen, Google, 工具, 庫, 安全, Dataset 數據集, Kimi, 強化學習

Prism 令 2K 影音生成訓練加速 2.5 倍

Prism 將影片畫面與聲音互動納入稀疏注意力,令原生 2K 影音生成模型訓練更快,並兼顧生成質素。

model architecture

高解像度影音生成最難處理的地方,是畫面 token 大增後,Full Attention 需要付出平方級計算成本,聲音與畫面之間的有效互動亦容易被大量冗餘資訊沖淡。Prism 屬於 Dynamic Sparse Attention 框架,專門處理原生 2K Joint Video-Audio Generation Model Training,目標是減少訓練成本而不犧牲影音同步與細節。

Prism 將影片 token 按時空位置整理成 macro-zones,再利用影片特徵的 channel variance,以及 audio-to-video cross-attention 的 feature norm,判斷每個區域的畫面變化和聲音影響程度。變化較快或影音耦合較強的位置會採用更細的 block 分割,並透過 hybrid block selection 為不同 query 動態決定稀疏範圍,令每個 block 保留較一致的語義內容。

[Fudan&Tencent Hunyuan] Prism: Dynamic Sparse Attention for Native 2K Joint Video-Audio Training

同 Full Attention 相比,Prism 不再對所有 token 進行密集互相關注;同時,它亦不是單純套用只為推理加速而設的稀疏注意力。這個取捨針對聯合影音資料的結構作出調整,代價是訓練流程需要額外計算區域資訊和動態選擇,實作複雜度會高於標準注意力。

項目提供 Project Page、Hugging Face 模型和示範影片,可先透過合成結果、模型比較、消融研究及解析度擴展示範理解效果。提供的資料未列出完整本地安裝指令或硬件要求,因此暫時較適合研究團隊按論文與模型資源自行整理環境,而不是即時套用到一般影音工具。

  • 訓練速度較 Full Attention 提升 2.5 倍
  • 生成質素據報超越 Full Attention
  • 同時考慮視覺變化與 audio-visual coupling
  • 面向原生 2K 影音生成模型訓練

Prism 對需要訓練高解像度文字轉影片及同步聲音模型的研究團隊較有價值,尤其適合計算資源昂貴、影音互動集中於局部區域的工作。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, AI productions, 模型, 多模態模型, 模型訓練, Google, NVIDIA, Video, Audio, 框架, 工具, 語音

VeriHarness 長流程 AI 任務的修訂

長時間 AI 任務不再只靠一次輸出或投票,VeriHarness 讓模型查證分歧與共識,再交付有證據支援的成果。結果同一模型也能做驗證!

VeriHarness

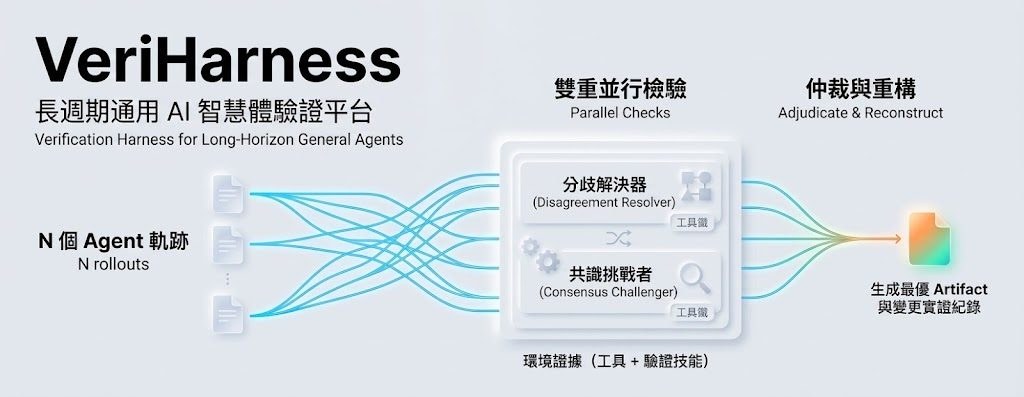
長時間 AI 任務容易在細節中累積錯誤,單靠一次 rollout 或多數票未必能找出共同誤判。VeriHarness 是一個面向 long-horizon general agents 的 verification harness,讓產生答案的同一個模型檢查環境證據、修訂成果,並記錄每項改動的原因。

它會把 N 次獨立 rollout 交給兩條調查流程:disagreement resolver 核對不同嘗試提出的主張,consensus challenger 則專門反查所有嘗試都同意的內容。兩邊取得文件、資料或可重新計算數值後,再由 adjudication 選取或重建 artifact,處理了「分歧不等於錯誤、共識也可能共同出錯」的取捨。

透過 Gemini on Vertex AI 或 Claude on Vertex AI 執行驗證;wb 與 wsb 評分器則在網絡容器中處理文件、試算表、程式碼及多檔案工作區任務。項目同時公開約 26,000 次 rollout,方便研究團隊重現流程或比較自己的 verifier。

結果顯示,Gemini 3.5 Flash 作為 generator 和 verifier 時,證據支援的修訂比單次 rollout 平均高 6.2 分;Claude Opus 4.8 則高 6.4 分,五個 benchmark 的十個 model–benchmark settings 均取得最高 primary selection score。這些數字反映選擇與修訂能力,不能直接等同完整 artifact 必然正確。

  • 適合長流程工作:文件、試算表、程式碼及多檔案任務均可納入檢查。
  • 核心差異:同一模型負責產生與驗證,優勢來自 rollout pool 結構及環境證據,而非更強的 judge。
  • 研究價值:分開測試 disagreement 與 consensus,能定位模型反覆犯下的共同錯誤。
  • 使用限制:需要模型服務、評分容器及可檢查的任務環境,配置成本高於單次生成。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, Google, Gemini, Anthropic, Dataset 數據集

Diffusion Controller:讓模型更準確聽懂提示詞

Diffusion Controller以輕量控制網絡改善提示詞對齊,同時保留原有影像質素與生成穩定性。

Og image

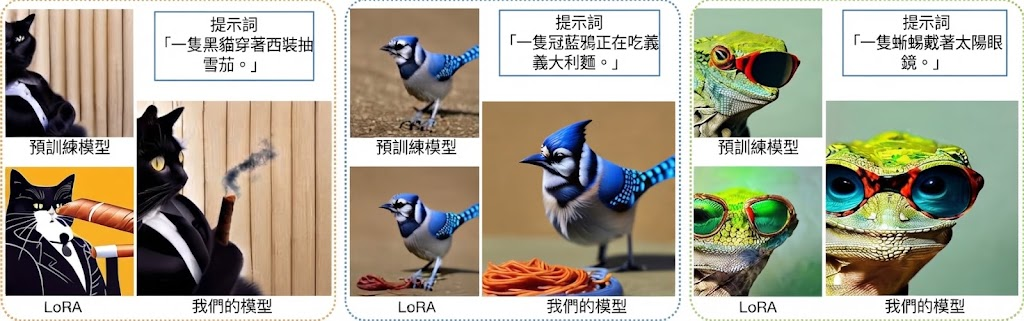
當影像模型明白你要一隻「戴太陽眼鏡的蜥蜴」,卻只生成蜥蜴,或勉強加入眼鏡後令面部變形,問題往往不在畫面是否逼真,而在提示詞要求與生成結果之間難以取得平衡。Google Research提出的 Diffusion Controller,正是針對這種提示詞對齊與影像質素互相牽制的情況而設計的輕量「steering damper」網絡。

Diffusion Controller可以接到包括 access-restricted、closed-source 模型在內的現有影像生成模型,無需改動基礎模型的核心結構,便能在生成過程中施加更精準的控制。它將原本由隨機噪聲逐步還原成影像的 denoising process,重新理解為一個連續、平滑的 control problem,讓控制訊號不必只在個別步驟中硬性修正結果。

  • 改善文字提示與生成影像之間的 prompt alignment
  • 以輕量 add-on network 控制現有模型,兼容 access-restricted、closed-source 模型
  • 在提升指令符合度的同時,維持 baseline stability 和原有影像質素
  • 將 inference-time guidance 與模型微調放入同一套分析框架
  • white-box 版本在所述測試中取得相對 baseline model 的 90% 勝率

過往做法通常分成兩條路線:一類是在 inference time 使用 classifier-free diffusion guidance,調整文字提示對生成過程的影響;另一類則透過 parameter-efficient adapters,例如 LoRA、reward-weighted regressions 或 policy gradients,對模型行為進行較重的微調。Diffusion Controller嘗試以統一的數學語言連接這些控制方式,減少工程師靠反覆試驗,在使用者偏好、提示詞要求和影像質素之間摸索的需要。

Google Research表示,Diffusion Controller的輕量版本表現優於用於配合人類偏好的業界標準方法;完全解鎖、可直接修改模型內部權重的 white-box 版本,則相對 baseline model 取得 90% 勝率。這些結果反映項目適合需要精準遵循文字描述、同時不希望破壞原有生成穩定性的影像工作流,但提供的內容未包括下載連結、安裝步驟或完整使用流程,讀者仍需等待論文或官方程式碼資料作進一步驗證。

項目主頁 · Paper

Categories: Google, Gemini, Image, 影像處理, 提示詞, 框架

LTX-2.5 加入多圖與聲音參考控制

想令影片中的人物、物件和聲音更一致,這個 ComfyUI 擴充項目把多重參考整合到同一條工作流程。

Repository image for liconstudio/ComfyUI-LTX2.5-MSR

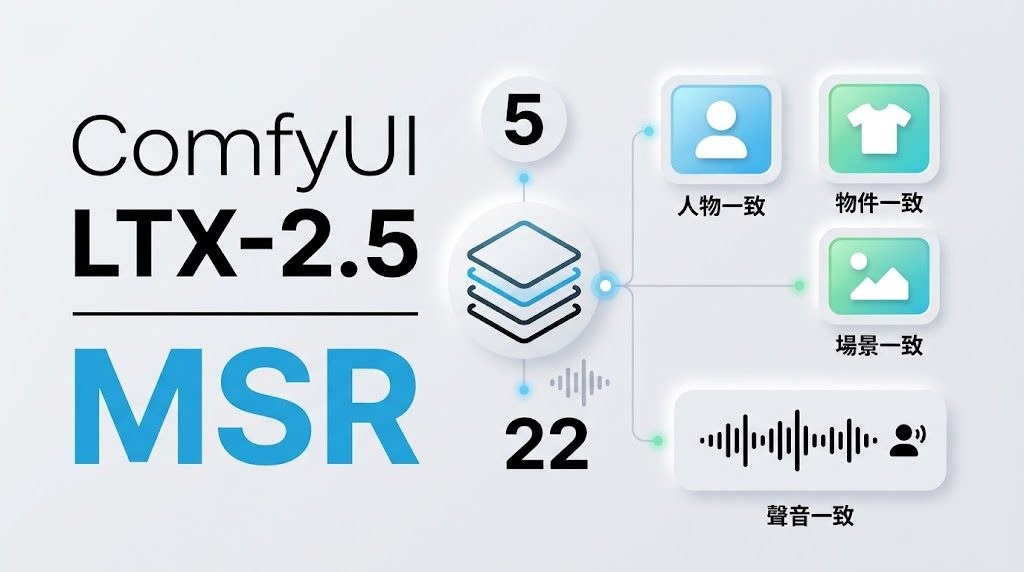
要在 LTX-2.5 生成影片時維持多個人物、物件或場景的連貫性,單靠文字提示往往不夠。ComfyUI-LTX2.5-MSR 是一個 ComfyUI 擴充工具,透過 MSR LoRA 把最多五張獨立編碼的參考圖片加入影片 latent;配合 AVref LoRA,還可為最多兩位說話者加入聲音參考。

它處理的不是普通圖片拼接,而是保留 MSR(Multiple Subject Reference)的訓練方式:每個參考影像都有 learned slot embedding,參考 token 會預先加入模型輸入,並配合固定排序及連續負時間位置,讓 LTX-2.5 的 self-attention 讀取人物、衣物、物件和場景資訊。參考圖片會自動調整大小、置中裁剪及以白色填補,亦支援 tiled VAE encoding。

v1.2.2 將圖片和聲音參考集中到同一個 LoRA loader 及 Reference Guide。兩個 audio latent 可分別配對 pic1 和 pic2;缺少某段聲音時,對應時間窗會保持空白,不會令後面的參考位置前移,並可選擇 25 或 33 幀的圖片參考長度。README 同時提供 V2 範例工作流程,展示加入聲音參考的兩階段 sampling 及 latent-upscale refinement。

使用前需要 LTX-2.5 原生模型、符合要求的 MSR 或 AVref LoRA,以及 ComfyUI 的模型、conditioning、latent、VAE、sampler 和 AV 節點。LoRA 必須包含 reference_slot_embedding 權重,普通 LoRA 會被拒絕;項目資料未提供完整安裝指令或硬件性能測試,因此生成速度、顯存需求及最終一致性仍要按本地模型、解析度和參考數量自行驗證。

  • 最多五張圖片參考,支援人物、物件、背景等不同角色
  • AVref LoRA 可加入最多兩位說話者的聲音參考
  • 稀疏 audio slots 保留絕對時間位置,不會重新排列後續參考
  • 適合單階段生成,也可接入兩階段 latent-upscale 工作流程

GitHub · 模型

Categories: 開源, ComfyUI, AI productions, Embedding, 模型, 模型訓練, Google, NVIDIA, Video, Image, Audio, 工具, 語音, LTX, 蘋果, LoRA

Dream-RSI:讓 AI 先在探索紀錄中演練,再投入昂貴的搜尋

Dream-RSI 把 AI 過往探索過程變成可重播的模擬環境,讓新策略先離線比較,再挑選勝出者投入下一輪搜尋,減少試錯成本。

Google

當 AI 要花數千輪提出和評估方案,探索方向選得不好,計算資源便會浪費在無效搜尋上。Dream-RSI 是一套用來改進 AI 探索策略的遞迴自我改進框架,讓策略先在既有探索紀錄中演練,再決定是否投入昂貴的線上搜尋。

它不另建一個學習出來的世界模型,而是把代理過往建立的探索樹當成可重播的模擬器。系統在線上收集搜尋歷史,再離線測試多個候選策略;選出的策略才會部署到下一輪,並帶回新的探索紀錄,逐步擴大可供演練的經驗池。這做法省去逐一實跑候選策略的成本,但模擬範圍受限於過往探索到的路徑,未曾出現的情況仍須在線上驗證。

目前公布的測試涵蓋演算法工程、數學最佳化及 GPU kernel 工程,共八項任務。在演算法工程中,與 Recursive Fixed Exploration 相比,下游執行速度提高 1.22 倍,探索計算量減少 1.74 倍,呼叫次數比 SimpleTES 少 162 倍;GPU kernel 的四項測試全部改善,同等預算下效能提高 2.09 倍。數學最佳化則有三項中的兩項達到或超越所選基線,結果仍需按任務解讀,不能視為所有搜尋問題都會有相同收益。

這套方法較適合需要長時間、多輪探索的演算法與工程研究團隊,尤其是每次線上評估成本高昂的工作。程式碼仍在準備發布,現階段可閱讀技術報告與論文了解方法和結果;儲存庫尚未提供可直接安裝執行的公開版本。

  • 探索樹被重用為策略演練環境,不必為每個候選策略重新執行完整搜尋。
  • 每輪勝出的策略會投入線上搜尋,並補充新的探索歷史。
  • 已測試三個領域、八項任務,GPU kernel 測試四項全有改善。
  • 模擬器只涵蓋已探索的搜尋空間,公開程式碼仍在準備中。

項目主頁 · GitHub

Categories: 開源, Embedding, Google, Gemini, 框架

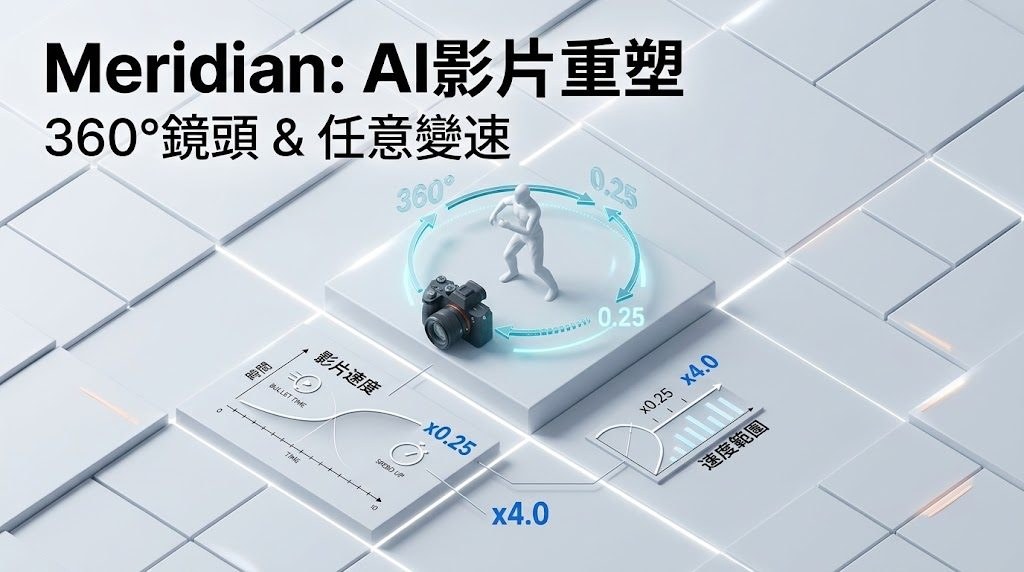
Meridian 讓 MiniMax H3 將時間與鏡頭重新編排 – Bullet time

Meridian 可從影片或單張圖片重新設計鏡頭路徑,重訪同一事件的不同視角。

Og image

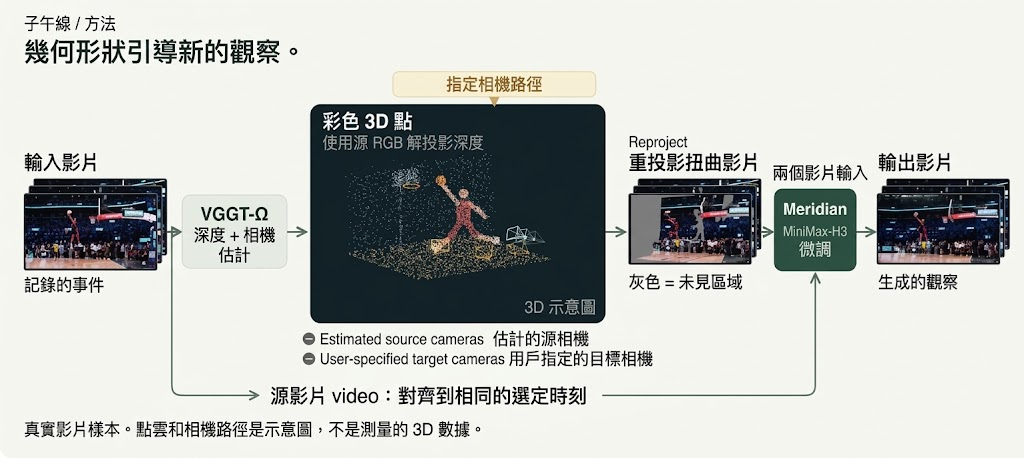
想將一段已拍攝的動作改成全新鏡頭,甚至暫停某個瞬間再繞行拍攝,Meridian提供了影片到影片(video-to-video)的處理方式。它基於 MiniMaxAI/MiniMax-H3,以 adapter 形式加入幾何控制能力,並結合 VGGT-Omega 幾何資訊,亦支援由單張圖片建立鏡頭移動。

Meridian 處理的是空間與時間的共同編排:鏡頭可沿指定路徑移動,原有動作則可繼續、放慢或暫停。Bullet time 只是其中一種時間與鏡頭組合,並非模型的邊界;要加快或放慢動作,應先重新調整輸入影片的時間,再按該時間軸設計 camera path。

頁面提供的例子包括以原片重新觀看 NBA 灌籃、在草莓片段中暫停動作並移動鏡頭,以及以芭蕾單張相片產生鏡頭運動。這種做法適合重構已有事件的觀察角度,但生成畫面與原片如何銜接、遮擋區域能否保持一致,仍取決於輸入內容與指定路徑。

  • 基礎模型:MiniMaxAI/MiniMax-H3;模型關係標示為 adapter
  • 幾何元件:VGGT-Omega
  • 任務標籤:video-to-video、novel-view-synthesis、camera-control、re-camera
  • 提供 installation.md 連結

項目主頁 · 模型

Categories: 開源, AI productions, 模型, 視頻模型, Google, NVIDIA, Video, Image, 框架, 教學, Discord, LLaMa, Ollama, Python, 蘋果, MiniMax

[技術文章] MintAct 把跨平台視覺代理整合到單一模型

由手機、桌面到網頁操作,MintAct嘗試用一個輕量模型兼顧定位、導航與視覺工具使用。

Hero image preview

蘋果電腦即將推出一個視覺語言模型系列,它統一了跨行動裝置、桌面和Web的多步驟導航以及視覺化工具,並已在 2B 、4B 和 8B 上進行了訓練。蘋果認為讓 AI 直接操作手機、桌面或網頁,單是看懂畫面並不足夠,還要準確點擊目標、完成多步驟任務,以及在需要時呼叫外部工具。MintAct 是一系列統一的 vision-language models,針對這些分散能力提供單一視覺代理,並推出 2B、4B 與 8B 三種規模。

通常做法是 UI grounding、手機導航、桌面控制、網頁導航及視覺工具使用各自訓練專門模型。這種 per-domain specialist 範式需要分開維護,模型之間亦可能因觀察空間、動作方式和資料來源不同而互相干擾;直接混合資料,更可能令各領域表現下降。MintAct 改用多階段訓練,先以 grounding 和多步驟監督學習建立基礎,再配合強化學習(reinforcement learning,RL)整合跨平台能力。

項目的關鍵不只在模型本身,也包括支援訓練的環境和資料基礎設施。團隊讓數百個不同後端的環境並行運作,同時收集 trajectory data 和進行 online RL;非同步框架則控制不同領域的訓練比例,減少環境速度不一、回饋雜訊及 off-policy drift 帶來的不穩定。

MintAct 在相近模型規模下,聲稱能追平各領域專門模型的表現,並在 OSWorld-Verified 取得 48.9 分的結果。對需要在裝置端運行、又不想同時服務多個專門模型的工作流而言,這種統一設計具備實際吸引力,但跨領域互相干擾、環境回饋可靠性和長時序任務穩定性,仍是部署時需要持續驗證的限制。

  • 統一 UI grounding、多步驟導航及視覺工具使用
  • 覆蓋手機、桌面與網頁環境
  • 提供 2B、4B、8B 模型規模
  • 透過非同步 RL 控制跨領域訓練分佈
  • OSWorld-Verified 得分為 48.9

Paper

Categories: Agentic, 模型訓練, Google, 框架, 工具, 蘋果, UI/UX

Qwen-Image-2.1 開源:透明圖層生成與多圖編輯

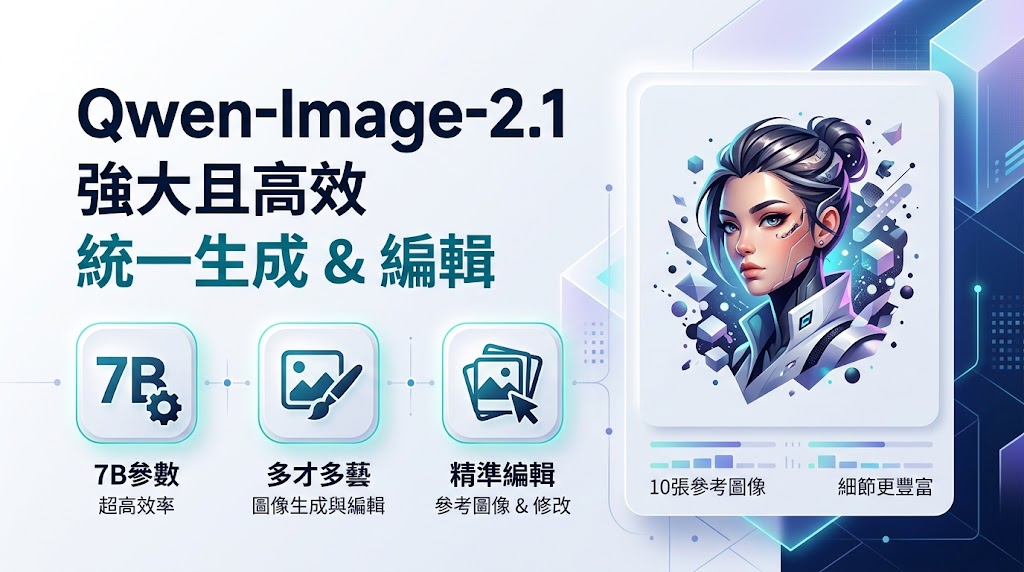
7B 參數的 Qwen-Image-2.1 把文生圖、圖片編輯、透明背景生成整合在同一個模型,一次可參考 10 張圖片,門檻不高但功能更齊全。

在 AI 繪圖的世界裡,能同時處理文生圖、改圖、還能直接輸出透明背景圖的開源模型並不多。Qwen 團隊這次開源的 Qwen-Image-2.1,把這幾件事整合進同一個 7B 參數的視覺生成模型,使用時不需要切換不同模型或額外加工。對做貼圖、做商品圖、做素材整理的人來說,這種「一個模型走到底」的做法很貼合日常工作流。

模型採用 32 層 Single-Stream DiT 結構,配合混合粒度注意力與 prefix KV cache 復用,把運算成本壓低。即使在顯示卡記憶體有限的環境下,仍能輸出品質不錯的圖片;Apple Silicon 用戶也能用 MPS 加速跑得動。

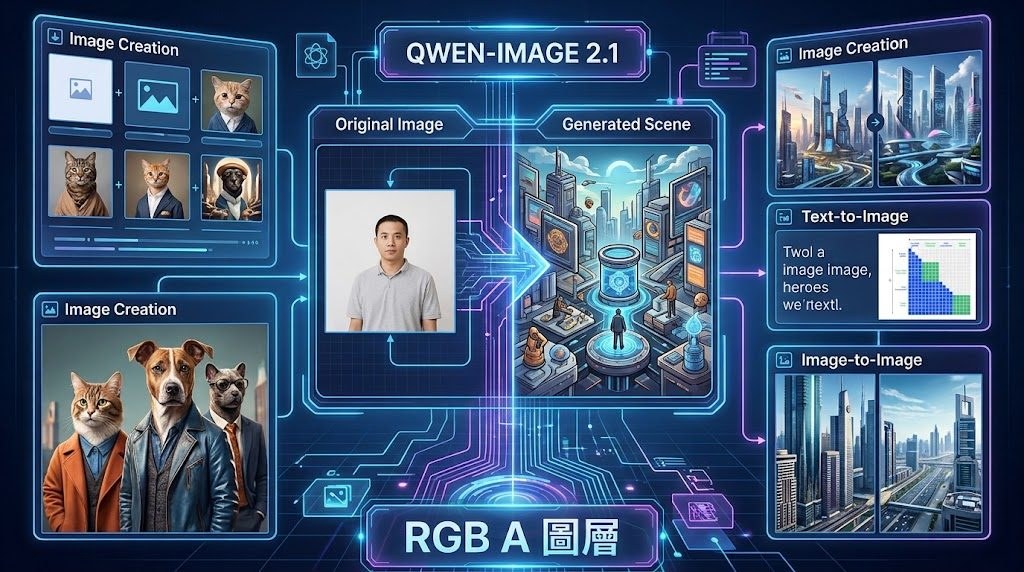
Qwen-Image-2.1 對透明背景(RGBA)的處理是這次的亮點之一。文字描述可以直接生成帶 Alpha 通道的圖,也能把照片裡的主體分離出來變成透明底,省去摳圖步驟。編輯功能同樣豐富:最多可同時參考 10 張圖片,用圓圈、塗鴉或遮罩標記局部修改位置,並在人物、產品場景保留識別特徵,避免改一處卻跑掉整個主體。

Og image

文字渲染和人像光影也比上一代細緻,招牌、卡片、海報一類需要清晰排字的場景更實用。整體定位偏向「夠用、好用、可商用」的工具型模型,不是衝榜級的影像模型。

重點摘要

  • 統一模型:文生圖、圖片編輯、RGBA 透明圖生成整合在同一個 7B 參數模型
  • 高效率架構:32 層 Single-Strteam DiT,搭配混合粒度注意力與 prefix KV cache 復用
  • 多圖參考編輯:最多支援 10 張參考圖,可用圓圈、塗鴉或遮罩指定修改區域
  • 主體保留:在人物、產品場景保持識別特徵,不會改一處就全跑掉
  • 透明背景原生支援:可文字直出 RGBA,也能從照片分離主體成透明底

模型已在 Hugging Face 開源,並提供 Diffusers 整合程式碼、Google Colab 與 Kaggle Notebook,Apple 用戶亦可透過 Draw Things 或 DiffusionBee 等本地 App 直接試用。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Qwen, Google, Image, 影像模型, 影像處理, txt2img, 蘋果

XGEN-JING 世界模型開源:邊走邊生成影片與音效

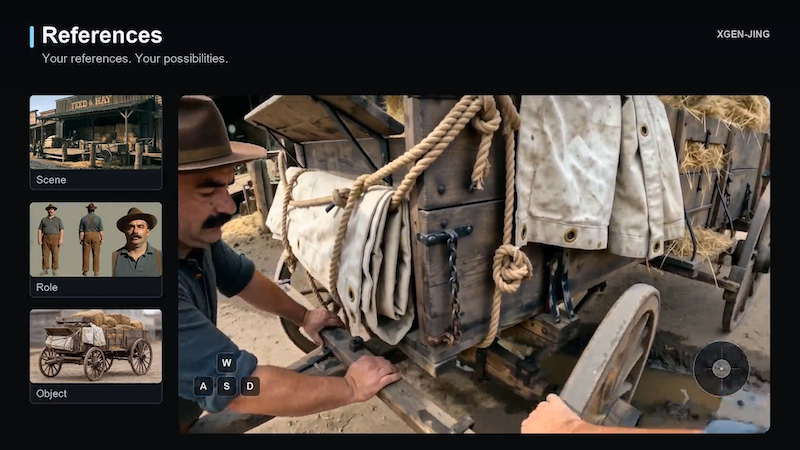
XGEN Labs 把互動式第一人稱世界模型 JING 開源:輸入動作與參考圖,就能邊走邊生成對應影片與環境音效,等於把世界模型變成可即時體驗的 demo。

過往的世界模型 demo 多半停留在「按一個鍵播一段片」,XGEN-JING 想把互動感再推一步:鍵盤操作鏡頭、輸入文字引導角色對話,模型即時生成第一人稱影片與配對音訊,並以參考圖約束人物、物件與場景的一致性。這個項目是一個以 MiniMax-H3 為骨幹的 egocentric interactive experience 模型,屬於世界模型 / 互動影片生成一類,目標是讓「在同一個起點做出不同選擇」這件事變得可視聽。

XGEN-JING 的核心差異在「四步雙向推論」與即時性:JING-Flash-v1 用四個步驟完成推論,再把動作、觀察歷史、參考圖同時餵進去生成下一段片段;鏡頭移動、物件互動、人物對話都由文字與按鍵驅動,而畫面與聲音同步輸出,所以更像「邊走邊生成」而不是「先想好再剪片」。

Step Into a World That Responds | XGEN Labs

這版本同時提供 Inference code、examples 與 Prompt skills,後者可以從故事與參考圖自動生成經過驗證的推論案例,降低試錯成本;但因果模型與技術報告尚未釋出,想深入架構細節的人需要再等等。硬件門檻亦偏高:項目方以六張 H100 做驗證,其中一張跑 text encoder、一張跑影音 VAEs、四張跑 DiT 加 sequence parallelism,並指定 FlashAttention-4 為預設後端。

以下幾類人會比較快從中受惠:做世界模型研究、需要互動 demo 的研究者;做遊戲 / VR / 沉浸式敘事、需要快速產出第一人稱體驗的開發者;以及關心 video generation xa in 2026 路徑、想理解「影片 + 音訊 + 動作」三軸如何耦合的團隊。對一般玩家或創作者而言,Hugging Face 上的模型頁與 xgenlabs.ai gallery 已足夠先看 demo,再決定是否投入本地部署。

重點摘要

  • JING 是以 MiniMax-H3 為基礎的第一人稱互動體驗模型,支援鍵盤控鏡、文字對話與參考圖約束。
  • JING-Flash-v1 以四步雙向推論同時生成影片與音效,比單向生成更貼近即時體驗。
  • 官方硬件門檻為六張 H100(1 text encoder + 1 VAEs + 4 DiT),預設 FlashAttention-4,後端依賴 SGLang 特定 commit。
  • Prompt skills 可從故事與參考圖自動產生驗證過的推論案例,方便快速試玩法。

項目主頁 · GitHub · 模型 · 影片集

Categories: 開源, AI productions, 模型, 視頻模型, 世界模型, Google, NVIDIA, Video, Audio, Content Creator, MiniMax, Skill 技能

Page 1 of 7
1 2 3 … 7