Marigold V2:把擴散 Transformer 改成一步深度估計模型

只要一張普通 RGB 相片,就即時輸出高質素深度圖,連毛髮和髮絲等幼節都保留到。Marigold V2 把預訓練擴散 Transformer 改造為單步密集預測模型的開源項目,一張消費級 GPU 一星期內就能完成微調。

Project website

過去做單目深度估計,要麼靠傳統監督學習,要麼用擴散模型疊好多步去噪,兩者都唔易兼顧細節同效率。華為 Bayer Lab 開源 Marigold V2 走第三條路:直接把預訓練嘅擴散 Transformer(DiT)當成單步密集預測器,重新微調之後輸出深度、透視深度、法線、反照率等多種密集模態,毋須反覆去噪。對從業人員嚟講,呢個改動意味住一張普通 RGB 相可以即時變成帶細節嘅深度圖,毋須等幾秒去疊步驟,毛髮邊緣同髮絲呢類幼節都保留得到,貼近 SOTA 水準。

模型家族同訓練成本:每個 checkpoint 包含一組 rank-128 LoRA 適配器,配合 4-bit 量化嘅 DiT 主體,個別任務仲會附帶微調過嘅 VAE 解碼器。底層凍結嘅基礎模型會另外下載。整個微調流程用單張消費級 GPU 少於一星期就完成到,對個人開發者同細型實驗室都係可觸及嘅範圍。

程式碼結構清晰,方便二次開發:倉庫用 manifest graph 加 transform list 嘅方式定義數據集,網絡組件同損失函數都係讀寫 batch dict 嘅有序步驟,數據集定義、網絡圖、損失圖、優化排程四個層次分得幾開。對想擴展到新任務嘅人嚟講,只要跟住呢個結構加步驟就得,唔使由零砌起。

對比傳統多步擴散深度估計,Marigold V2 犧牲咗迭代式去噪嘅靈活性,但換嚟一步推理嘅速度同細節還原度;對比純監督方法,佢借用咗擴散模型對紋理同邊界嘅先天理解力,再加 LoRA 保持輕量。同一批權重仲可以用喺 metric depth completion 等下游任務,一個模型覆蓋多個密集預測場景。

**適合做 AR/VR、3D 重建、影像合成嘅中小團隊,或者想低成本試驗新密集預測任務嘅研究者,都會覺得呢個 setup 幾啱手。HuggingFace 上有對應嘅 demo 空間可以直接試,權重同訓練推理碼都已開源。

項目主頁 · GitHub · 模型

Categories: 開源, 華為, 模型, 模型訓練, Qwen, Image, 3D, , Dataset 數據集

DeepVoyager-VL 把視覺線索放回搜尋流程中

DeepVoyager-VL不只是睇圖再答題,而係會用新取得嘅視覺證據決定下一步搜尋。對長流程多模態檢索項目而言,呢個改動幾關鍵。

Comparison of multimodal search data synthesis paradigms

當一個多模態 agent 要連續查多步資訊,最易失準嘅位置往往唔係答題,而係中途搵錯線索。DeepVoyager-VL處理嘅正正係呢個問題:佢屬於長流程多模態 deep-search 框架,讓新取得嘅圖片證據直接影響下一輪檢索,而唔係只喺輸入開頭或答案結尾先用到視覺資訊。

呢種做法令佢同一般把視覺訊息包裝成前置條件嘅方法有明顯分別。DeepVoyager-VL背後用 EventVoyage-VL 生成帶有中間視覺依賴嘅長流程問題,再用整理過嘅 trajectories 做 Supervised Fine-Tuning(SFT),而唔加額外 reinforcement learning 階段;取捨好清楚,訓練流程較可重現,但效果仍然要靠資料合成質素同軌跡篩選撐住。

倉庫而家已經放出 paper、project page,同可重現嘅 Megatron SFT training bundle,亦提供 DeepVoyager-VL-8B 同 DeepVoyager-VL-30B-A3B 模型,以及 EventVoyage-VL dataset。想理解點樣驗證,最直接係沿住現成模型、資料集同訓練 bundle 睇完整流程;README 亦提到 SWIFT RUNTIME=bundled 會使用儲存庫內嘅 source trees,定位上比較接近研究與訓練復現項目,而唔係即開即用嘅消費級產品。

  • 核心改動:把 vision in the loop 放入搜尋中段,圖片可按需要先載入或裁切
  • 資料來源:EventVoyage-VL 先做 structure-before-language synthesis,再抽出可監督軌跡
  • 訓練路線:以 supervised-only 為主,冇再疊 reinforcement learning 階段
  • 結果:8B 同 30B-A3B 平均分別為 54.8 同 58.6,並在十個 benchmark 入面分別拿下八個同九個最佳成績

分數本身已經講到定位:DeepVoyager-VL不只是追求更大模型,而係想改善「見到新圖之後,下一步應該搵乜」呢個決策環節。較受益嘅會係做多步檢索、多模態問答、研究型 agent pipeline 嘅團隊;要留意嘅限制亦同樣直接,成效高度依賴合成資料點樣把中途視覺依賴編排得夠真實,離開相關 benchmark 之後,泛化深度仲要靠後續驗證。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 北京大學, 華為, Agentic, 模型, 多模態模型, 模型訓練, 框架, Dataset 數據集

Color Pass-Through 重新做色彩校準

想令手機畫面更接近眼前真景,難處往往唔係相機或螢幕單獨夠唔夠準,而係兩者夾埋之後會一路累積偏差。Color Pass-Through就係針對呢個落差,將整條 camera-display 路徑一齊學起來。

Color Pass-Through teaser

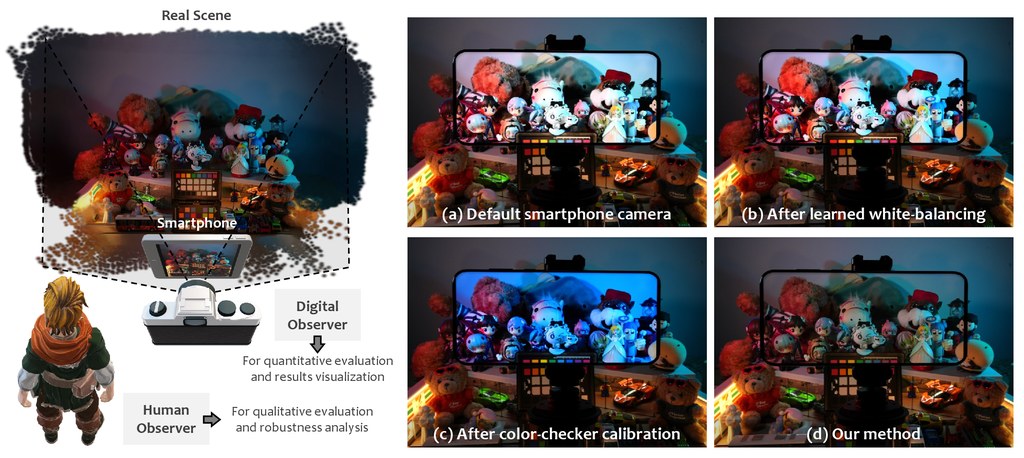
想像你透過手機或頭戴裝置睇現場畫面,明明場景喺眼前,畫面顏色同亮度卻總有一層隔膜。Color Pass-Through 針對的正正係呢種 camera-display 不一致:它屬於影像處理研究項目,以端到端方式學習固定裝置上的 camera-display 路徑,目標唔係單獨校正相機或螢幕,而係令人經過裝置觀看時,感知上更接近真實場景。

作者明確反對傳統 ICC workflow 呢種兩段式校準範式。舊做法會先分開處理相機同顯示器,再靠預先定義的中介色彩空間接駁,誤差容易逐步累積;Color Pass-Through 改為直接學完整投影路徑,並為每位觀察者做 one-step calibration。呢個取向的好處係更貼近人眼最終見到的結果,代價就係它依賴特定 device pair,同時帶有 observer-specific 設定,泛化方式同傳統標準化流程唔一樣。

目前公開資訊顯示,項目已放出完整 training and inference pipeline,並提供兩款支援裝置的 pretrained checkpoints,所以較合理的理解方式係:它首先係研究原型,其次先係可重現的程式碼。資料集仲準備公開,Android toy example 亦仍在開發中,部署重點暫時仍然放喺已支援裝置上重現論文結果,而唔係即插即用地套入任何手機。

  • 核心改動係把 camera 與 display coupling,唔再經固定中介色域分開校正
  • 以每位使用者一次校準換取更貼近主觀觀感的色彩與亮度表現
  • 人類評分提升 +2.0 分(5 分制),亮度 4.32/5,色彩 4.03/5
  • 定量結果亦有明顯優勢,PSNR、ΔE、STRESS 在兩款商用手機上都優於列出的基線

同類方法很多時會加強 white balance、ColorChecker mapping,或者在既有 ISP 後面再補一層修正;這個項目則直接把問題重寫成特定裝置、特定觀察者的整體感知重建。對做 AR/VR pass-through、顯示校準、計算攝影研究的人最有參考價值,尤其當重點唔係標準色彩流程有幾完整,而係人眼最後見到的畫面到底似唔似真景。

項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, 華為, 模型訓練, 蘋果, Dataset 數據集

LISA:讓 ControlNet 訓練快 2.78 倍的正則化方法

香港科技大學團隊提出的 LISA 正則化技術,能在不增加推理成本的前提下,加速視覺條件可控生成模型的訓練並提升生成品質。

Arxiv

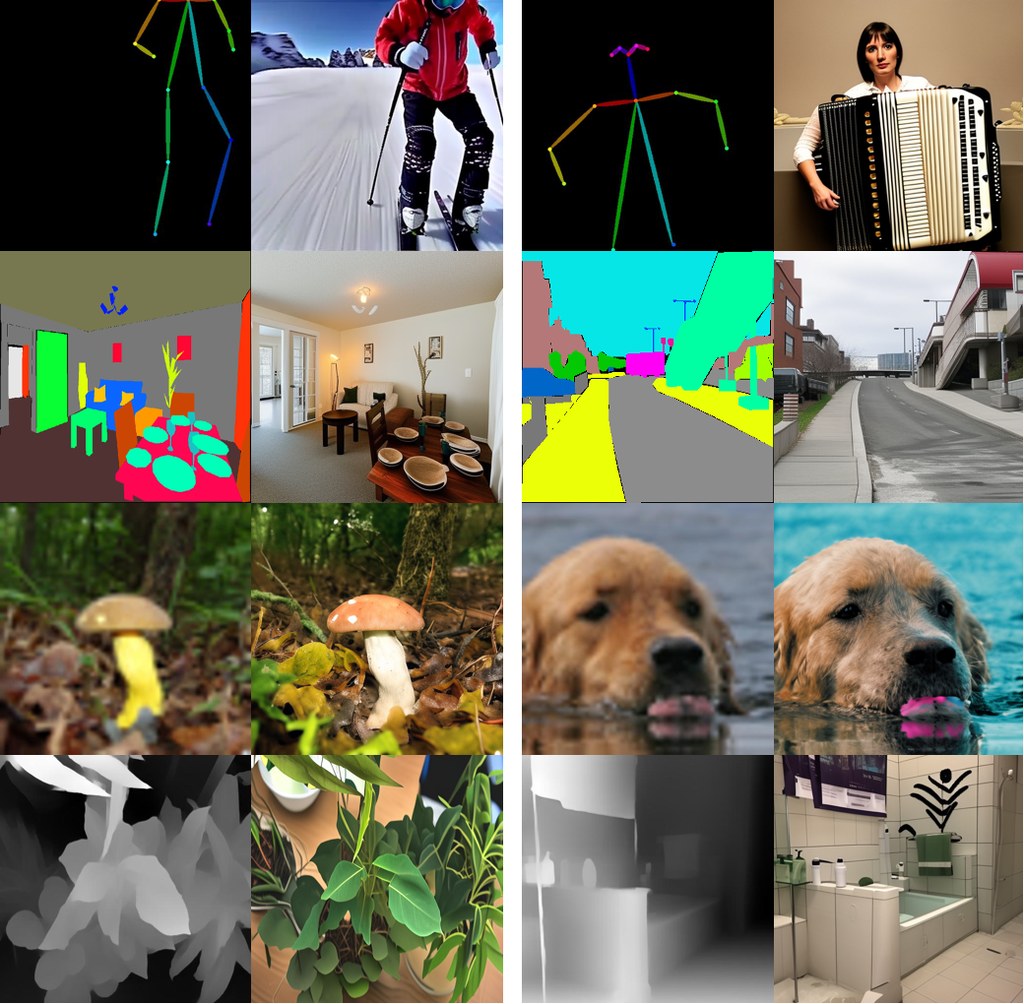
LISA(Likelihood Score Alignment)是一種訓練正則化方法,專門用於加速視覺條件可控生成模型(例如 ControlNet)的訓練過程,同時提升最終生成結果在感知品質與條件遵循度上的表現。

現有做法普遍採用「雙分支範式」(dual-branch paradigm):訓練一個側網絡(side network)來編碼視覺條件,再將其中間層特徵融合到凍結的預訓練主網絡中。這個範式雖然效果顯著,但側分支的角色定位與訓練效率長期未被深入研究。LISA 從基於分數的生成建模(score-based generative modeling)角度重新審視這個範式:主網絡負責提供先驗的無條件分數(unconditional score),側網絡則透過隱式方式貢獻似然分數(likelihood score)。

LISA 的核心做法是從側網絡的指定層提取特徵,透過一個輕量級解碼器(decoder)將其投影到分數潛在空間(score latent space),然後計算解碼器輸出與近似似然分數目標之間的距離,作為額外的正則化損失(regularization loss)。這個設計讓側網絡的特徵在條件建模中更加解耦(disentangled),且推理階段無需任何額外計算。

根據論文實驗結果,LISA 在多種圖像與影片任務、不同網絡架構(UNet/DiT)以及擴散與流匹配模型上均表現穩定,能夠實現超過 2.78 倍的訓練收斂加速(例如在 ControlNet 上),同時帶來可忽略的額外訓練成本與零推理成本。

這項技術特別適合需要快速迭代 ControlNet 或類似條件控制模型的團隊,例如從事姿態引導圖像生成、組合條件生成或可控影片生成的研究人員與開發者。

重點摘要:

  • 方法類型:訓練正則化技術,適用於雙分支視覺條件可控生成框架
  • 核心創新:將側網絡特徵對齊近似似然分數目標,取代純粹依賴擴散損失的訓練方式
  • 訓練效率:在 ControlNet 等場景實現超過 2.78 倍的收斂加速
  • 推理成本:零額外推理開銷,解碼器僅在訓練階段使用
  • 適用範圍:圖像與影片生成任務,兼容 UNet 與 DiT 架構,支援擴散與流匹配模型

GitHub · Paper

Categories: 開源, 香港科技大學, 華為, 模型, 視覺模型, 模型訓練, 框架, 香港, IDE, 深度學習

EventVLA:長時序機器人操作加入事件記憶機制

EventVLA 是一個視覺語言動作框架,透過事件驅動的關鍵幀記憶機制,讓機器人在長時序任務中能回溯早期視覺證據,提升操作準確度。

EventVLA Overview

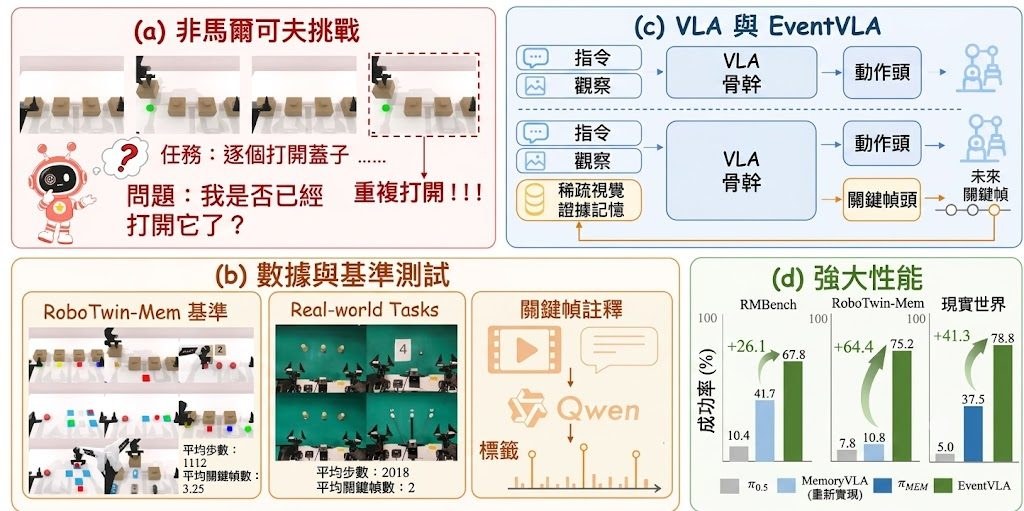
EventVLA 是一個由中國科學技術大學、上海人工智能實驗室、上海交通大學、大連理工大學、香港大學、清華大學、北京大學及華為等團隊共同開發的視覺語言動作(Vision-Language-Action, VLA)框架,專門針對長時序機器人操作任務設計。它解決的核心問題是:當機器人需要執行跨越許多步驟的任務時,往往必須回想起數十步之前出現過的視覺線索,而傳統 VLA 政策通常只依賴壓縮後的隱狀態,容易遺失早期關鍵畫面。EventVLA 的做法是引入事件驅動的視覺證據記憶(event-driven visual evidence memory),在執行過程中偵測與任務相關的事件,把對應的關鍵幀以原始影像形式存入記憶體,並在後續動作預測時重新取用這些畫面作為參考。

這個項目同時發佈了 RoboTwin-MeM 基準測試,這是建基於 RoboTwin 2.0 的記憶依賴型操作評測環境,包含八個需要長時序記憶的任務,例如依序拾取物件、按照紙上指示重複放下積木、依指示重現路線等。與同類 VLA 框架相比,EventVLA 的差異在於它不只壓縮隱狀態,而是保留原始關鍵幀影像作為可回溯的視覺證據,這在需要精確回憶早期空間配置的任務上特別有用。

部署與測試方式

  • 建議建立兩個 conda 環境:一個用於 RoboTwin-MeM 模擬,另一個用於 EventVLA 模型訓練與推論。
  • 從 Hugging Face 下載對應的 checkpoint(RoboTwin-MeM 或 RMBench 版本),搭配相應的評測腳本即可在模擬環境中重現結果。
  • 數據集同時提供 HDF5 軌跡格式與 LeRobot 2.1 訓練格式,方便不同訓練流程直接取用。
  • 目前程式碼已支援模擬訓練與評估,真實機器人推論與微調模型仍在開發中。

重點摘要

  • 核心機制:事件驅動的關鍵幀記憶,以原始影像儲存視覺證據而非僅壓縮隱狀態。
  • 配套基準:RoboTwin-MeM 包含八個長時序記憶依賴任務。
  • 目前狀態:模擬環境訓練與評估已開源,真實世界部署尚未釋出。
  • 適用場景:需要回溯早期視覺線索的多步驟機器人操作任務。

從已釋出的資源來看,研究人員與機器人團隊可直接透過 Hugging Face 上的 checkpoint 與 RoboTwin-MeM 數據集進行基準測試與模型微調,評估記憶機制對長時序任務表現的影響。

GitHub: https://github.com/InternRobotics/EventVLA

項目主頁: https://ganlin-yang.github.io/EventVLA.github.io/

模型: https://huggingface.co/ganlinyang/EventVLA/tree/main

Categories: 開源, 香港大學, 北京大學, 清華大學, 上海人工智慧實驗室, 華為, 模型, 視覺模型, 多模態模型, 世界模型, 模型訓練, Qwen, Robotic, 框架, 香港, 深度學習, 中國

WindowSeat 相片修復

華為 Bayer Lab 在 Hugging Face 上發布的 WindowSeat (開源)應用,採用 Alibaba 的 Qwen-Image-Edit 2509 模型,主要用於移除單張圖像中的窗戶反射。 WindowSeat 自動產生無反射的乾淨版本,專門針對窗戶、飛機、商場或辦公室玻璃反射設計。 它基於擴散轉換器(DiT)框架,透過單步潛在擴散實現端到端反射移除。

華為 Bayer Lab 在 Hugging Face 上發布的 WindowSeat (開源)應用,採用 Alibaba 的 Qwen-Image-Edit 2509 模型,主要用於移除單張圖像中的窗戶反射。

WindowSeat 自動產生無反射的乾淨版本,專門針對窗戶、飛機、商場或辦公室玻璃反射設計。 它基於擴散轉換器(DiT)框架,透過單步潛在擴散實現端到端反射移除。

Categories: 阿里巴巴, 華為, 影像模型, 影像處理