AcademiaSD LoRAlab Trainer Studio:訓練影像與影片 LoRA

把多個模型的 LoRA 訓練流程集中到一個介面,支持消費級 NVIDIA 8G 顯卡。

AcademiaSD LoRAlab Trainer Studio

想為角色、物件或畫風訓練 Low-Rank Adaptation(LoRA),不一定要準備高階顯卡;AcademiaSD LoRAlab Trainer Studio 是一套 LoRA 訓練工具,目標是在最低 8 GB VRAM 的消費級 NVIDIA GPU 上處理最新影像及影片模型,並把不同 trainer 收進同一個 Web 介面。

每個模型會以 4-bit NF4 載入,文字編碼器與 VAE 只在 pre-cache 階段執行一次,之後把 GPU 資源集中到訓練。項目支援 Windows 10、Windows 11 及 Linux,使用 Python 3.13、PyTorch 2.14 cu130,以及 Flask + HTML5 介面;同一套安裝環境可加入後續新增的 trainer,毋須為每個模型另建環境。

工作流程包括資料集管理、自動 caption、即時預覽、精確步數續訓及一鍵匯出至 ComfyUI。訓練期間可以修改 steps、儲存及預覽頻率、預覽設定和 learning rate,按下 Save JSON 後,變更會在下一步生效;每個項目亦會分開保存 pre-cache、checkpoint、預覽圖及 LoRA 輸出,刪除快取或訓練內容不會碰到資料集。

  • 匯出的 LoRA 帶有 kohya-style metadata,包含 trigger word、rank、steps 和 resolution
  • CivitAI 及 LoRA managers 可以讀取相關 metadata
  • 一般角色、物件和風格 LoRA 可採用一張圖片配一段 caption
  • 可從同一網絡的其他裝置上載資料集及下載 LoRA

這套工具較適合想在本機反覆試驗、又不想手動管理多個訓練環境的創作者和小型團隊。預覽圖只用來追蹤訓練進度及角色、物件或風格的相似度,不能直接當成最終品質;完成後仍要在 ComfyUI 或 Forge 調整 LoRA 強度及模型品質設定。由於多個模型支援接近同時加入,README 亦明確提醒可能存在錯誤、未完善設定,以及預設訓練參數未必適合每個資料集,使用者需要自行測試並透過 Issues 回報結果。
GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 模型訓練, NVIDIA, Video, Image, 工具, Content Creator, Linux, Python, Win, LoRA

AutoGUIWorld:跨平台 GUI Agent 訓練場景及模型

以圖像生成模擬 GUI 狀態轉換,降低建立跨平台對真實軟件環境的依賴。

GUI Agent 要學懂跨平台操作,往往受限於收集資料時能夠安裝和重設的軟件環境。AutoGUIWorld 會生成 Windows、macOS、Ubuntu、Chrome、Android 或 iOS 的 GUI 場景,再由模型規劃點擊、開啟、切換等動作,透過圖像編輯生成每一步的畫面。它屬於面向 Computer-use agents 的資料生成框架,在毋須逐一啟動真實應用程式的情況下,建立有畫面、有動作、有座標標註的訓練軌跡。

AutoGUIWorld 把語意規劃和畫面轉換分開。Meta Planner 先按場景建立任務及動作序列,Voyager 讀取最新的乾淨截圖,描述下一個視覺狀態,再交由獨立的模型 adapter 處理文字、視覺和圖像生成或編輯;grounding backend 則負責找出指向目標的位置。每條軌跡會保留 obs_k.png、帶有目標框的 act_k.png,以及記錄任務、計劃、動作、畫面對應、grounding boxes 和 provenance 的 meta.json,方便日後檢查和重用。

  • 覆蓋 Windows 11、macOS、Ubuntu 24.04、Chrome、Android 和 iOS 場景
  • 技術報告使用的 AutoGUIWorld 訓練集包含 79,266 個 grounded and filtered examples
  • 支援 LocateAnything-3B、MAI-UI 或視覺語言 backend 進行 pointing grounding
  • 固定 random seed 可重現結構化場景,但模型輸出的文字和像素仍可能改變
  • 生成資料不會在真實桌面執行動作,也不會自行驗證任務是否完成

雖然 AutoGUIWorld 以視覺生成換取更快的場景擴展和較低的環境管理成本。代價是生成畫面未必等同真實軟件狀態,圖像模型也可能產生不合理的介面轉換,因此項目提供 scene validity、action alignment 和 transition fidelity 等品質檢查,但不能把這些檢查視為真實執行結果。

目前公開結果集中在資料生成和模型訓練流程。用家可隨時以軌跡微調 Qwen3.5-35B-A3B ,建立合成訓練資料。對只需要真實操作成功率、而且不能接受模擬畫面偏差的工作流程,仍應把真實環境測試放在資料生成之後。

GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, Image, 框架, 軟件, Mac, Linux, Win, Dataset 數據集, UI/UX

VoxWeave:Windows 本機 RVC 變聲工作站

把音頻、影片、麥克風同批次任務收在同一個桌面工作站,VoxWeave 走的是本機離線處理路線。它重點解決變聲流程分散、結果難追蹤,同時保留即時變聲與批量轉換。

VoxWeave

VoxWeave 是一套面向 Windows 的 RVC(Retrieval-based Voice Conversion)變聲工作站,定位很清楚:把離線轉換、即時麥克風變聲、批量處理和結果追蹤放進同一個桌面流程。它適合要穩定處理音頻、歌曲或影片音軌的人,也適合需要交付產物、查看失敗原因和保存位置的工作場景。

使用方式偏向本機部署而不是雲端服務。EXE 不內置大體積環境或模型,首次使用可在介面內按需下載經哈希校驗的運行組件與推薦模型;來源倉庫也保留 Linux 和 macOS 的邊界,但目前真機驗收集中在 Windows 11 與 NVIDIA CUDA。

它和常見變聲工具最大的分別,在於把狀態、任務、批量規則、即時會話、產物與歸檔都收進 SQLite 作為單一真源,連診斷匯出都會帶上運行時、模型和日誌清單。這種做法讓問題排查和重試更直接,但代價是它明確不提供虛擬聲卡、模型訓練或 GPT-SoVITS,定位比完整聲音工坊收得更窄。

  • 支援音頻、影片、資料夾和麥克風輸入,流程集中。
  • 可做離線轉換、即時變聲與批量處理,結果可追蹤。
  • 模型按原路徑登記,會計算權重和索引的 SHA-256,不會複製或改名。
  • URL 模型需要提供來源、最終大小和 SHA-256,授權不明時會明確標示。
  • 目標較適合 Windows 本機使用者、內容製作流程,和需要留存產物與錯誤記錄的團隊。

GitHub

Categories: 開源, AI productions, NVIDIA, Mac, Linux, 語音, Win

MiniMax Hub:本機優先的多模態創作工作站

MiniMax Hub把文案、影像、影片與配音流程放進同一個創作畫布。重點是本機優先,素材可留在自己電腦。

MiniMax Hub

MiniMax Hub 是一個 Multimodal Creative Agent,定位像 AI 創作工作站,不只是聊天工具。它把 Copy Generation、Image Creation、Video Editing、Audio & Voiceover、Auto Packaging 與 Multi-format Export 整合在同一個流程,讓用家由想法到成片可在一處完成。

它支援 macOS 與 Windows 下載,輸入簡報、文字想法,或直接加入本機素材後,主代理會先理解創作目標,再做 Smart task decomposition,之後交由多個 agents 並行處理文案、視覺與音訊。用家仍可手動選模型,亦會在關鍵節點收到確認,避免流程完全黑箱。

這個項目在於把創作流程保存成可重用的 Skills。系統會隨工作過程累積你的做法與風格,之後可重複套用;如果需要,也可從 MiniMax Skills Market 啟用現成 Skills 或外掛。對經常製作短劇、電商內容、品牌 TVC 與廣告素材的團隊來說,這類流程重用能力相當實用。

  • 本機優先設計,頁面明確指出 local files stay on your machine
  • 單一畫布整合腳本、分鏡、影片、音樂與剪輯流程
  • 支援資產管理與 batch generation,可一次產出多個版本
  • 代理會自動分解任務,並在關鍵步驟要求人工確認
  • 可把工作流程沉澱成 Skills,逐步累積個人或團隊方法

MiniMax Hub較著重工作流編排與創作協作,而不是單一模型能力展示。網站未列出具體性能分數或公開評測結果,因此較適合把它理解為面向內容製作的本地化 AI 工具平台。文中未提供明確模型清單,只提到會自動匹配最合適模型。

項目: https://hub.minimax.io/

Categories: Agentic, AI productions, 模型, 視覺模型, 多模態模型, 視頻模型, Video, Image, Audio, 軟件, Mac, 語音, Win, 音樂, Skill 技能

iMaC:把機械臂動作變成可預測影像

iMaC 不是只餵動作向量入模型,而是把未來動作轉成影像控制。這種 world model 更貼近機械臂與場景的空間互動。

overview

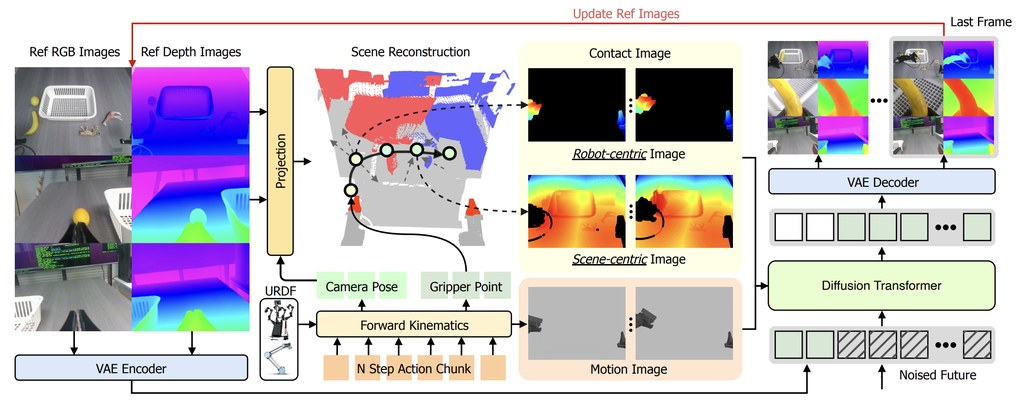
現時不少 action-conditioned video models 會把未來動作壓成 compact vectors,再經 learned conditioning modules 交給模型處理;作者認為這種做法要模型自行猜測細微空間後果,遇到 real manipulation 時,幾厘米差距已足以改變接觸、物件移動與任務成敗。iMaC 屬於世界模型與影片生成模型,核心是把 future joint actions 轉成 image-like controls,減少「動作有輸入,但空間關係表達不足」的問題。

這個項目的方法相當具體:先利用 robot URDF 與 forward kinematics,渲染 future robot-observation control videos,也就是 motion images;之後再加入 depth 作為輔助訊號,配合 3D pointclouds 建立 two-stream geometry controls,也就是 contact images。舊範式主要靠抽象向量條件化,iMaC 則把「未來機械臂會出現在哪裡、如何接近場景」直接變成可見控制,這是它最清晰的技術分野。

GitHub 儲存庫提供 training、preprocessing 與 inference code,覆蓋 RND-mix stage-one、stage-two,以及 WorldArena 三條流程。想試這個項目的人,會先由資料前處理、depth 與 3D condition 建立開始,再跑 validation inference 看生成影片是否跟動作一致;若本身做 robotic policy evaluation,還可以接到 WorldArena 或 online RND evaluation 場景。

  • 把 actions 轉成 motion images 與 contact images,空間條件更明確
  • 用 depth encoding 和 3D pointclouds 強化 robot-scene 幾何理解
  • 加入 training-time rollout strategy,目標是支援更長時序生成並減少 exposure bias
  • 儲存庫同時涵蓋訓練、前處理、推論,不只是論文展示模型
  • 相關組件包括 Wan transformer variants、Diffusion inference pipelines、RobotWin 2.0、WorldArena

性能方面,論文指出它在八個長時序真實機械人操作任務中,world-model success estimates 與真實 policy performance 呈強正相關。這個結果的價值不在於取代真機測試,而是在正式落機前,先用生成式 world model 篩選 policy checkpoints;對研究 embodied evaluation、robotics 與世界模型的人來說,iMaC 屬於相當值得跟進的一個方向。

GitHub: https://github.com/imac-wm/iMac

Paper: https://arxiv.org/pdf/2606.09813

Categories: 開源, 清華大學, AI productions, 模型, 視頻模型, 世界模型, 模型訓練, Stable Diffusion, Video, Image, Robotic, Vibe Coding, Mac, 3D, 庫, 編程, Win

MBench 專看長影片世界模型記憶力

MBench不是看單幀靚唔靚,而是追問模型能否記住離鏡後再出現的人與場景。它把長影片記憶拆成三條能力軸,令評測更貼近生成連續影片的難題。

Teaser

現時不少長影片評測,仍偏向單幀畫質或短距離 prompt following;畫面一旦切走、角色離鏡,很多模型便容易在回到同一情境時「失憶」。MBench 這個benchmark正是針對這個盲點而設,聚焦 long-video world models 的 memory capability,檢查模型能否在時間拉長後維持一致的世界狀態。

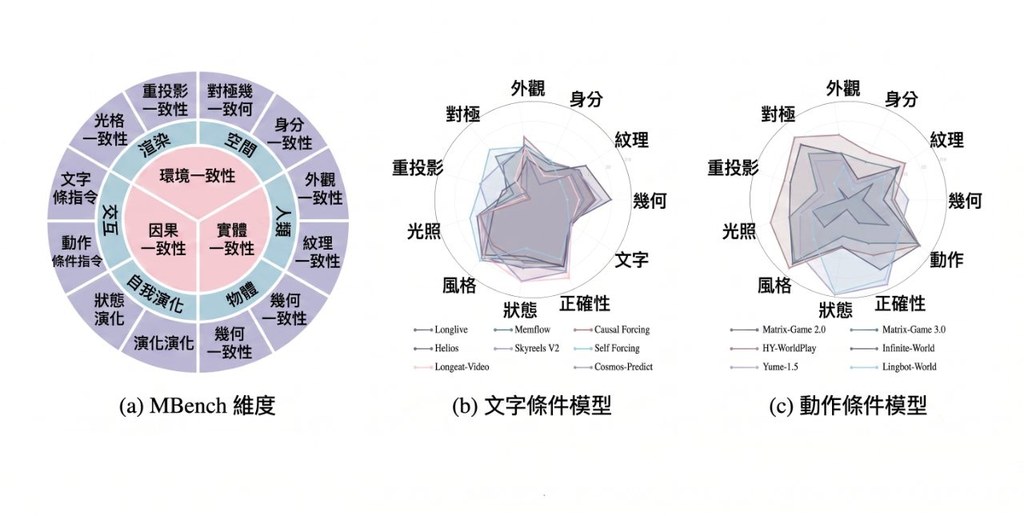
作者把問題拆成三個互相獨立但又彼此關連的方向:Entity Consistency、Environment Consistency、Causal Consistency。這種設計比籠統地給一個總分更有分析價值,因為你能看清模型究竟是忘記角色外觀、搞亂場景空間,還是未能延續畫面外仍在發生的物理過程;同時它再分成 MBench-A 與 MBench-T,分別對應 action-conditioned world models 與 text-segment-conditioned 長影片續寫模型。

如果你本身有影片生成或世界模型項目,這個儲存庫的用途很明確:先準備模型輸出,再用 mbench 這套 contract-driven、plugin-based CLI 跑完整評測流程。儲存庫已提供 12 個官方 metric implementation,亦整合 VLM trigger judge,代表它不只是論文概念,而是一套可落地比較不同模型表現的評測工具鏈。

  • 項目類型:這是一個 benchmark/評測工具鏈,用來量度長影片世界模型是否具備穩定記憶與時序一致性。
  • 創新位置:不是只看畫面質素,而是把「長時間記住世界」正式定義成三條 capability axes。
  • 適合場景:長影片生成、world model 研究、模型比較、內部驗證新版本退步與否。
  • 可讀性高:MBench-A 與 MBench-T 將不同條件設定分開,較容易知道模型失分原因。

從評論角度看,MBench 的價值在於它批評了舊有固定範式:只獎勵 single-frame quality 或 short-horizon prompt following,卻未有檢驗跨鏡頭、跨時間的持續記憶。若你關心的模型包括各類 long-video world models、action-conditioned world models,以及 text continuation 類影片模型,這個項目很值得納入測試流程;不過目前提供的資料以 benchmark 與評測框架為主,是否能全面代表所有真實創作場景,仍要配合你自己的生成任務一併觀察。

GitHub: https://github.com/study-overflow/MBench

Paper: https://arxiv.org/pdf/2606.00793

Categories: 開源, 清華大學, 模型, 視頻模型, 世界模型, Video, 框架, 工具, 庫, Win

GitHub Copilot CLI 正式發佈

GitHub Copilot 編碼代理的強大功能直接帶到您的終端。透過 GitHub Copilot CLI,您可以在本地與能夠理解您的程式碼和 GitHub 上下文的 AI 代理程式同步工作。

GitHub Copilot 編碼代理的強大功能直接帶到您的終端。透過 GitHub Copilot CLI,您可以在本地與能夠理解您的程式碼和 GitHub 上下文的 AI 代理程式同步工作。

Categories: 開源, MCP, Vibe Coding, Mac, Linux, 編程, Win

Chrome MCP 伺服器

Chrome MCP 伺服器是一款基於 Chrome 擴充功能的模型上下文協定 (MCP) 伺服器,它將您的 Chrome 瀏覽器功能開放給 Claude 等 AI 助手,從而實現複雜的瀏覽器自動化、內容分析和語義搜尋。與傳統的瀏覽器自動化工具(例如 Playwright)不同,Chrome MCP 伺服器直接使用您日常使用的 Chrome 瀏覽器,利用現有的使用者習慣、配置和登入狀態,讓各種大型模型或聊天機器人控制您的瀏覽器,真正成為您的日常助理。

Chrome MCP 伺服器是一款基於 Chrome 擴充功能的
模型上下文協定 (MCP) 伺服器,它將您的 Chrome 瀏覽器功能開放給 Claude 等 AI 助手,從而實現複雜的瀏覽器自動化、內容分析和語義搜尋。與傳統的瀏覽器自動化工具(例如 Playwright)不同,
Chrome MCP 伺服器直接使用您日常使用的 Chrome 瀏覽器,利用現有的使用者習慣、配置和登入狀態,讓各種大型模型或聊天機器人控制您的瀏覽器,真正成為您的日常助理。

ai 编程测试, chrome mcp server ,自动化必备,web 开发必备工具!
Categories: 開源, MCP, Mac, Linux, 編程, Win

NVSpeech 處理副語言聲音

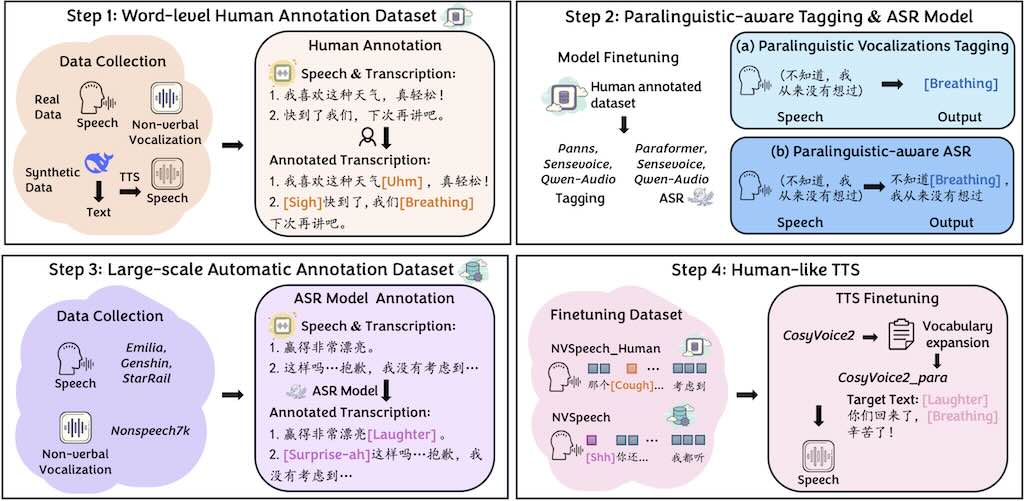
NVSpeech 用於處理副語言聲音(paralinguistic vocalizations),包括非語言聲音(如笑聲、呼吸)和詞彙化插入語(如「uhm」、「oh」)。這些元素在自然對話中至關重要,能傳達情感、意圖和互動線索,但傳統自動語音辨識(ASR)和文字轉語音(TTS)系統往往忽略它們。

NVSpeech 用於處理副語言聲音(paralinguistic vocalizations),包括非語言聲音(如笑聲、呼吸)和詞彙化插入語(如「uhm」、「oh」)。這些元素在自然對話中至關重要,能傳達情感、意圖和互動線索,但傳統自動語音辨識(ASR)和文字轉語音(TTS)系統往往忽略它們。

Categories: 開源, 香港中文大學, 模型, Mac, 語音, Win, 聲效

Matrix-3D:可探索的3D 世界

相較於最先進的 360 度影片生成方法,Matrix-3D 在全景影片的視覺品質與合理幾何結構上更優越。同時,在視覺品質與相機可控性上,也超越先前的相機控制影片生成方法。廣泛實驗證明其在全景影片生成與 3D 世界生成上的最先進效能。香港科技大學(廣州分校)有份參預!

相較於最先進的 360 度影片生成方法,Matrix-3D 在全景影片的視覺品質與合理幾何結構上更優越。同時,在視覺品質與相機可控性上,也超越先前的相機控制影片生成方法。廣泛實驗證明其在全景影片生成與 3D 世界生成上的最先進效能。香港科技大學(廣州分校)有份參預!

Categories: 開源, 香港科技大學, 模型, 視頻模型, Mac, 3D, Linux, Win