YuE2 補上真實音訊 Tokenizer,支援歌曲翻唱微調

YuE2取得音訊編碼與真實錄音適配能力,可將自家錄音轉成語義碼,再微調歌手風格。

Og image

當你餵給 YuE 一段參考音訊(例如某歌手的演唱片段或特定樂器風格,要求接續生成)時:必須先用 Tokenizer 將參考音訊「壓成代碼」傳入模型。若 Tokenizer 品質不佳,音色在第一步壓縮時就失真了。

這個 v4 工具能更高保真地將輸入聲音轉為 Token,讓後續模型捕捉到的音色特徵更貼近原音。

錄音轉換、歌手風格微調和歌曲翻唱,原本受限於 YuE2 沒有隨附的 audio → semantic-token encoder。這個項目基於 m-a-p/YuE2-3B 及 m-a-p/MERT-v2-FullSong,加入音訊 Tokenizer 與 NAR-branch LoRA,讓 YuE2-3B 可以處理自家錄音,並以真實製作音訊調整解碼效果。

Tokenizer 取用 MERT-v2-FullSong 第 20 層特徵,先按音軌作 instance normalization,再以 8 層、d=512 的 Transformer,在 512-frame 視窗內轉換成 32,768 種 YuE2 semantic codes,特徵率為 25 Hz。留出歌曲測試的 top-1 exact match 為 16.1%,但近似 code 產生的聲音接近,NAR round-trip 聽感測試約達 95%。

  • tokenizer_head_joint_v4.pt、.safetensors、.bf16.safetensors:音訊編碼 head
  • nar_lora_joint_v4.pt、.safetensors、.bf16.safetensors:NAR 解碼分支 LoRA
  • _comfyui.safetensors:配合 ComfyUI 的 YuE2 權重布局
  • LoRA rank 為 32,覆蓋 28 層 NAR attention、MLP,以及完整替換的 vae2llm 和 llm2vae

.bf16 版本約為完整精度檔案的一半,head 與 fp32 的輸出一致率為 98.6%。項目附有 scripts/ckpt_io.py、訓練迴圈和推論腳本;ComfyUI 可把 LoRA 載入 YuE2 checkpoint 的 MODEL 輸出,強度設為 1.0,CLIP 輸入不受影響。頁面沒有提供 GGUF 檔案、檔案大小、上下文長度、Ollama、LM Studio、llama.cpp 或 MTP draft speculation 支援資料,亦沒有列出可供選擇的量化級別。

模型先以 4,765 首 YuE2 自行生成歌曲訓練,再適配真實音訊;因此它的價值集中於提升真實錄音的編碼與 NAR 解碼,而非取代 YuE2-3B 的完整生成能力。授權為 CC-BY-NC-4.0,商業用途需要另行確認授權條件。
模型

Categories: 開源, ComfyUI, 模型, 模型訓練, Audio, 工具, 廣東話, Tokenize

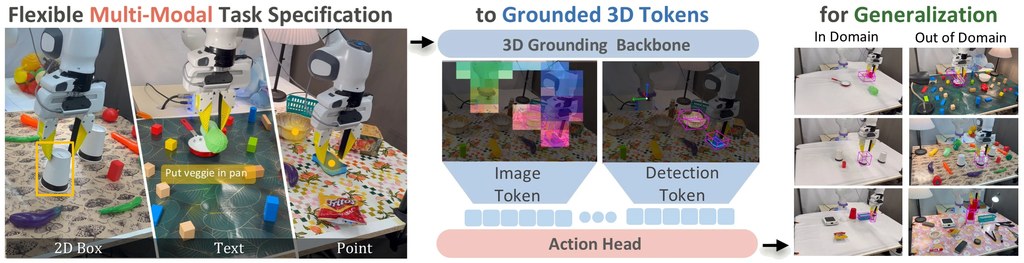
Grounded-Action-Model:讓機械人先理解物件位置,再決定如何動作

Grounded Action Model 把語言、點和框選提示轉成同一套 3D 物件表示,提升機械臂面對場景變化時的穩定性。

A language instruction, a 2D point or a 2D box is resolved by a pretrained 3D grounding model into image tokens and dete

面對物件被移位、場景重新排列,機械臂未必只需要更長的指令,而是要準確知道目標在哪裏。Grounded Action Model(GAM)屬於機械人基礎模型,透過 3D grounding 將語言、2D 點或 2D 框選轉成同一套以物件為中心的觀察,再預測連續動作。

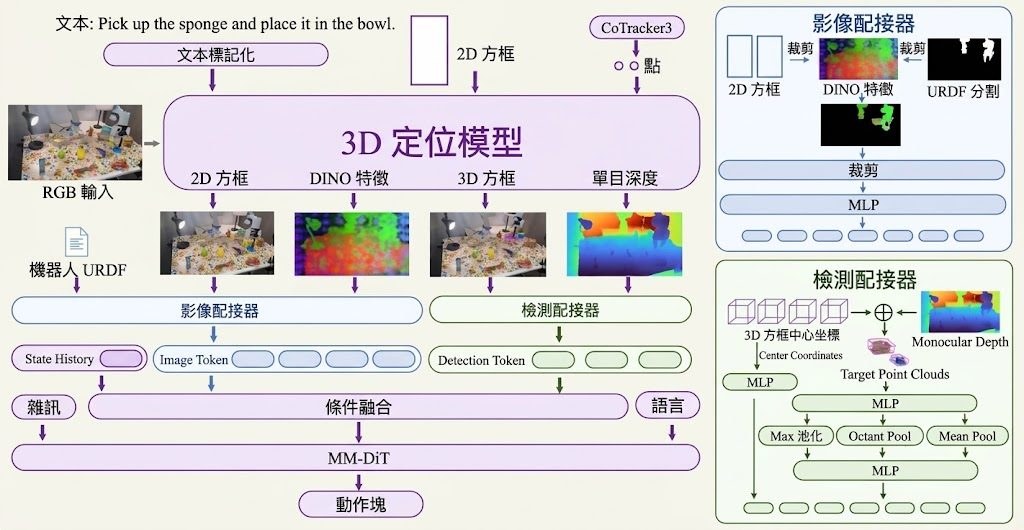
GAM 使用凍結的 promptable 3D detector,提取目標物件的視覺特徵和 metric geometry,並與機械人狀態歷史交給 multi-stream transformer,輸出 action chunks。相較於由 Vision-Language-Action Models(VLAs)或 World-Action Models(WAMs)從示範中隱性學習位置關係,GAM 把 3D 位置直接放進控制流程,也可由高層 planner 透過不同提示方式控制,支援較長流程和需要記憶的操作。

A language instruction, a 2D point or a 2D box is resolved by a pretrained 3D grounding model into image tokens and dete

目前可參考的結果包括:
– RoboTwin 2.0 的 50 項任務平均成功率為 55.3%,場景隨機化時為 47.6%。
– LIBERO-PRO 的 16 種擾動設定平均成功率為 61%,目標重新放置時改善較明顯。
– 雙臂 YAM 面對視覺變化仍成功 17/20 次;Franka 配合 Molmo2 planner,長流程任務的 OOD step completion 為 49.8%。

Grounded-Action-Model 適合研究機械人操作、視覺變化和高低層控制協作的團隊,但目前 GitHub 仍只有論文與項目頁面,training and inference code、pretrained checkpoints 及 real-robot setup 尚待公開,因此暫時不能按儲存庫直接安裝或重現結果。數據主要來自指定基準和兩款機械人,能否延伸到其他硬件與未見過的操作,仍要等待程式碼及更多測試。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, 微軟, VLA, World-Action Model, Robotic, 3D, 庫

physics:拆解 Wan2.1 的物理失誤

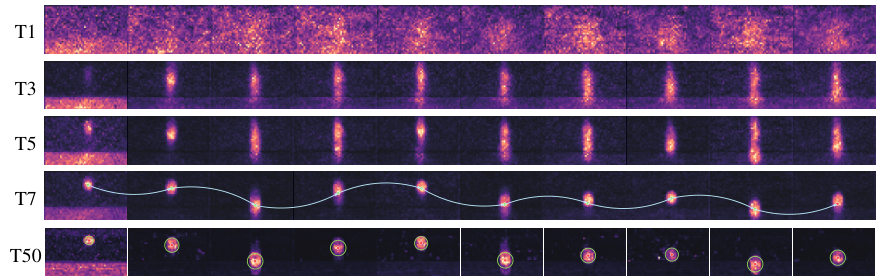
籃球彈跳變成半空漂浮,問題可能早在去噪頭幾步由注意力決定。這個研究以 RoPE 調整改善影片動態。

teaser

一個籃球由半空跌落後,理應撞地再彈起,Wan2.1-T2V 卻可能生成漂浮、突然停頓或半空反彈。這個 GitHub 項目屬於影片生成模型的可解釋性研究,實際處理的是 text-to-video diffusion models 如何在早期去噪階段規劃物件軌跡,以及錯誤位置為何會一路鎖定。

研究把視線集中在 Wan2.1-T2V-1.3B 的最初五個去噪步驟,透過 video-to-object-token cross-attention 追蹤物件位置,再配合 convergence speed 和 causal contribution 找出負責形成軌跡的 attention heads。分析指出,Self-attention 中的 Rotary Position Embedding (RoPE) 會令空間注意力衰減過快,早期錯誤候選位置因此壓過鄰近影格較合理的路徑。

修正方法不依賴外部物理模擬器或額外 foundation-model teacher,而是在早期步驟降低 height/width RoPE frequency,測試時前五步使用 λ^{h/w}=0.70;需要訓練時則以只作用於 self-attention 和 cross-attention 的 Low-Rank Adaptation (LoRA) 配合 λ^{h/w}=0.75。LoRA 設定為 r=64、alpha=32,並以首 10% 去噪步驟佔 0.9 機率的混合 timestep sampler 加強早期學習。

測試這個項目時可沿用 Wan 官方模型與提示詞,以不同 random seeds 比較原模型、training-free 頻率調整及 LoRA 版本的籃球跌落等片段;程式透過 runtime monkey patches 修改行為,不需要改動官方 Wan source。提供的資訊確認有 training-free 和 training-based 實驗,但未列出完整數值指標,因此更適合視為機制分析與可重現的研究原型,而非已證明能處理所有物理場景的通用修補方案。

  • 物件軌跡主要在最初五個去噪步驟形成
  • Cross-attention 負責引入物件語義,self-attention 協助選擇候選區域
  • RoPE 空間衰減過強,會令錯誤位置過早固定
  • 可用早期頻率縮放,或加入只改注意力層的 LoRA
  • 適合研究影片生成、模型可解釋性及物理一致性的團隊

項目主頁 · GitHub

Categories: 開源, AI productions, Embedding, 模型, 視頻模型, 模型訓練, Video, 提示詞

RefineEdit : 免訓練 Prompt-to-Prompt 編修

RefineEdit 以文字提示生成來源與編輯結果,毋須額外訓練或遮罩,但未能直接處理任意真實照片。

compare

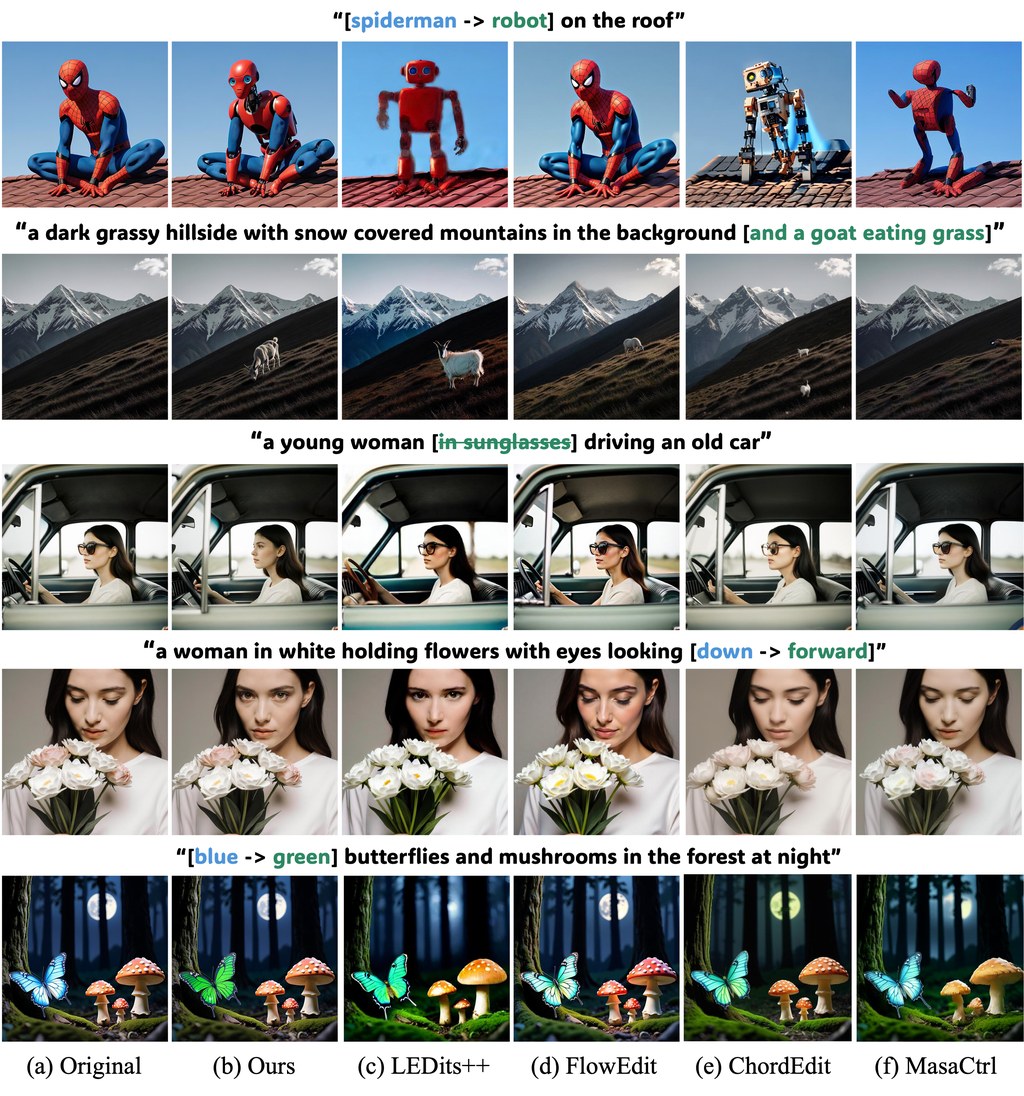
由 source prompt 改成 editing prompt 時,RefineEdit 會先生成來源圖,再重用中間 refinement state,讓 1024 × 1024 編輯結果較容易保留原有內容。這個項目屬於免訓練的 prompt-to-prompt 影像編輯方法,實際處理的是文字驅動編輯中「改變指定內容」與「維持畫面穩定」之間的取捨。

GRN 負責生成流程,HBQ tokenizer 和 UMT5 encoder 會一同載入;RefineEdit 本身沒有額外 checkpoint。source-anchored bit routing 先選出可編輯座標,再配合 adaptive spatial freezing(AdaSF)及 finite bit locking(FBL)限制後續變化,毋須外部 editing mask。

RefineEdit 需要 Linux、支援 BF16 的 CUDA GPU,以及官方 GRN 預訓練權重;A100 80 GB 是參考配置,項目並不適合低記憶體 GPU 或 CPU 推理。FlashAttention 2 可加速原始流程,未能安裝時可改用 PyTorch scaled dot-product attention,但速度、記憶體消耗和數值結果都可能不同。

  • 不需額外訓練、RefineEdit checkpoint 或外部遮罩
  • 只支援由提示詞內部生成的來源 refinement trajectory
  • 不直接編輯任意真實圖片,應用範圍比一般照片編輯流程窄
  • 附有 mask summary/step PNG 及 adaptive bit lock stats.csv,方便檢查座標選擇和鎖定狀態

它適合研究文字生成影像編輯、需要可重現實驗的團隊,以及已有 GRN 推理環境的開發者。儲存庫未提供統一 benchmark 數字,不能單靠 1024 × 1024 輸出判斷畫質;不同 attention backend 即使使用相同 seed,也不保證產生逐像素一致的結果。

GitHub

Categories: 開源, 模型訓練, NVIDIA, Image, 提示詞, Linux, Python, 庫, Dataset 數據集

TeleAntiFraud 開放反詐數據與模型,建立可重現研究基礎

TeleAntiFraud 將數據集、模型、評測和程式碼集中開放,讓電信反詐研究更容易驗證與延伸。

Hero image preview

面對電信詐騙檢測需要數據、模型和一致評測標準的問題,TeleAntiFraud 以開源研究社區形式,集中提供相關資源,涵蓋數據集、模型、論文及可重現的研究基礎設施。項目由中國人民公安大學聯合發起,適合研究人員、反詐技術團隊及需要測試檢測方法的開發者使用。

社區目前公開 TeleAntiFraud 數據集、AntiFraud-SFT 模型,以及論文與程式碼倉庫,並提供 Hugging Face 模型與數據入口。相比只發布單一模型或個別研究結果,這種整合方式讓使用者可以由數據、訓練資源一路追到論文和程式碼,較方便重現實驗及比較不同方法。

可直接關注的資源包括:
– TeleAntiFraud 數據集及相關論文入口
– AntiFraud-SFT 模型發布與研究資料
– 已錄用論文及對應的公開程式碼、模型和數據
– 面向音頻文本反詐檢測的 SAFE-QAQ 研究

社區列出的最新進展包括 TeleAntiFraud-28k 獲 ACM MM 2025 接收,以及 SAFE-QAQ 獲 ACL 2026 主會接收;後者聚焦慢思考強化學習框架。網站目前未提供統一的性能數字或詳細測試結果,讀者仍需按各論文及資源頁面的評測設定理解模型能力和限制。

項目主頁

Categories: 開源, 模型, 模型訓練, 框架, 庫, 中國, Dataset 數據集

[技術文章] MintAct 把跨平台視覺代理整合到單一模型

由手機、桌面到網頁操作,MintAct嘗試用一個輕量模型兼顧定位、導航與視覺工具使用。

Hero image preview

蘋果電腦即將推出一個視覺語言模型系列,它統一了跨行動裝置、桌面和Web的多步驟導航以及視覺化工具,並已在 2B 、4B 和 8B 上進行了訓練。蘋果認為讓 AI 直接操作手機、桌面或網頁,單是看懂畫面並不足夠,還要準確點擊目標、完成多步驟任務,以及在需要時呼叫外部工具。MintAct 是一系列統一的 vision-language models,針對這些分散能力提供單一視覺代理,並推出 2B、4B 與 8B 三種規模。

通常做法是 UI grounding、手機導航、桌面控制、網頁導航及視覺工具使用各自訓練專門模型。這種 per-domain specialist 範式需要分開維護,模型之間亦可能因觀察空間、動作方式和資料來源不同而互相干擾;直接混合資料,更可能令各領域表現下降。MintAct 改用多階段訓練,先以 grounding 和多步驟監督學習建立基礎,再配合強化學習(reinforcement learning,RL)整合跨平台能力。

項目的關鍵不只在模型本身,也包括支援訓練的環境和資料基礎設施。團隊讓數百個不同後端的環境並行運作,同時收集 trajectory data 和進行 online RL;非同步框架則控制不同領域的訓練比例,減少環境速度不一、回饋雜訊及 off-policy drift 帶來的不穩定。

MintAct 在相近模型規模下,聲稱能追平各領域專門模型的表現,並在 OSWorld-Verified 取得 48.9 分的結果。對需要在裝置端運行、又不想同時服務多個專門模型的工作流而言,這種統一設計具備實際吸引力,但跨領域互相干擾、環境回饋可靠性和長時序任務穩定性,仍是部署時需要持續驗證的限制。

  • 統一 UI grounding、多步驟導航及視覺工具使用
  • 覆蓋手機、桌面與網頁環境
  • 提供 2B、4B、8B 模型規模
  • 透過非同步 RL 控制跨領域訓練分佈
  • OSWorld-Verified 得分為 48.9

Paper

Categories: Agentic, 模型訓練, Google, 框架, 工具, 蘋果, UI/UX

RecreationWorld:從操作到重建軟件介面

代理不只觀察介面,還要自行寫程式、啟動成品及核對結果,測試由操作走向完整交付。

RecreationWorld logo

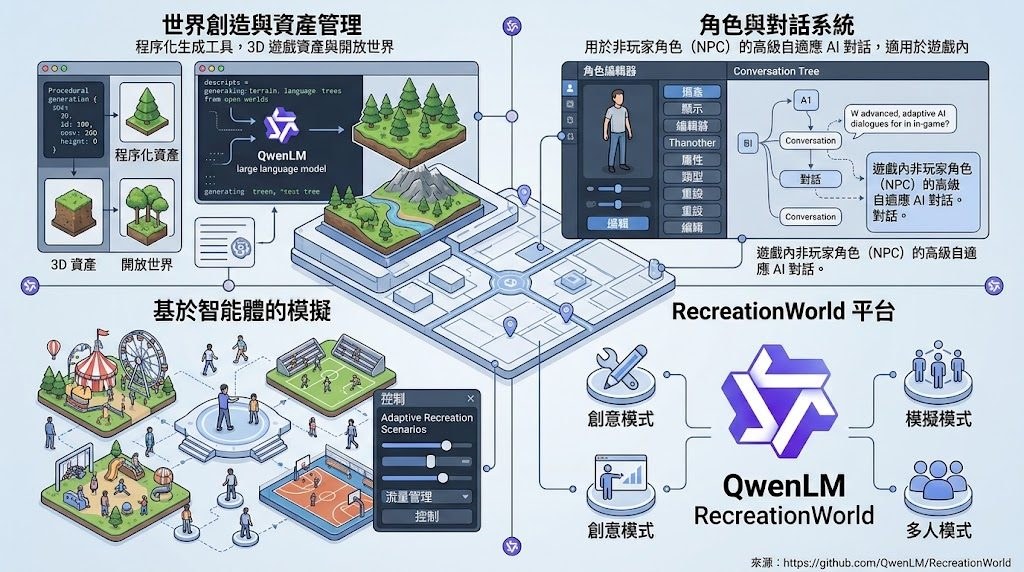
給代理一個正在運行的參考程式,它要邊操作、邊寫程式,再自行啟動及檢查成品。RecreationWorld 是研究混合式電腦操作代理(hybrid computer-use agents)的五平台框架,處理代理能否按可見行為重建軟件的問題。

它把參考程式當作可執行判準,讓代理反覆進行探索、實作與驗證,而非依固定階段完成任務。最終評分看功能與畫面是否吻合,不要求源碼、語言或架構相同,保留了實作自由。

  • 涵蓋 Ubuntu、macOS、Windows、Android 與 Web
  • RecreationBench 提供 250 個未公開於訓練流程的應用任務
  • 同時採用程式化檢查與視覺模型(Vision-Language Model,VLM)評分
  • 可比較完成度、接近滿分的應用比例及每項任務成本

已列出的結果中,GPT-6 Astra 平均 58.06%,領先 Claude Opus 5 的 44.16%,但估算成本達每項任務 115.80 美元;較便宜的模型則要接受明顯分數差距。這反映長時間探索、編碼與視覺核對仍然昂貴,而且只有少量應用能達到完整功能分數。

開發代理、GUI 自動化或程式生成系統的團隊,可下載 RecreationBench 資料集並依儲存庫的 Quickstart 配置環境;自行託管模型的正式評估需要聯絡團隊。它較適合作研究與模型比較,未見足夠資料證明可直接充當一般軟件重建服務。

項目主頁 · GitHub · 數據集

Categories: 開源, 阿里巴巴, Agentic, 視覺模型, 多模態模型, 模型訓練, Qwen, 框架, Mac, Linux, 庫, Dataset 數據集

小米公開 CodeMidas 強化學習訓練進度

小米以即時指標公開 mimo-v2.6-pro 與 mimo-v2.6-flash 的強化學習訓練狀態,並連結至程式編碼代理研究。

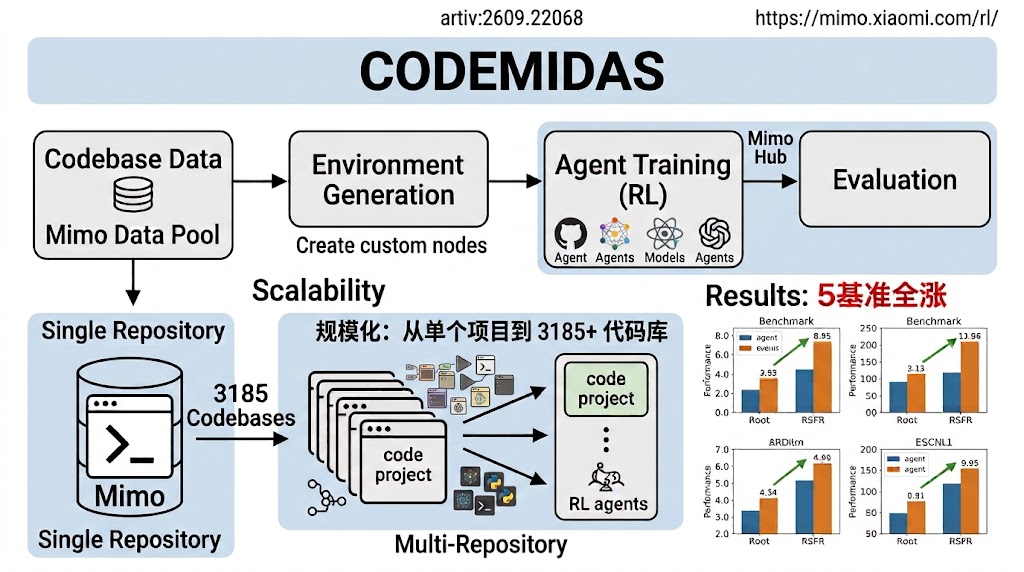
CodeMidas 把模型訓練過程帶到公開視野,展示 mimo-v2.6-pro 與 mimo-v2.6-flash 兩組 reinforcement-learning runs 的即時指標。對需要追蹤模型能力如何形成的研究者和開發者而言,這類介面可用來觀察訓練是否持續、何時中斷,以及不同模型版本的進度差異。

小米以 trainer 直接提供的 metrics 為主,未有完整列出指標定義、數值解讀或最終評測結果。因此,讀者可以把它視為訓練監察入口,而不是已完成模型的性能報告;畫面亦提示可能出現重新連線狀態,資料連續性仍需留意。

根據 CodeMidas 研究,mimo 從程式碼本身擴展 agentic coding reinforcement learning environments。這個方向處理的問題,是如何建立足夠多、又能反映真實編程任務的訓練環境,讓 coding agents 在程式修改、執行與驗證等流程中學習,而不只依賴靜態範例。

資訊:
– 同時追蹤 mimo-v2.6-pro 與 mimo-v2.6-flash 的強化學習訓練
– 指標由 trainer 即時更新,適合觀察訓練進程
– CodeMidas 聚焦由程式碼擴展 agentic coding RL environments

對模型研究、AI agent 和編程工具開發者來說,頁面提供了一個觀察訓練公開化的窗口;一般使用者則應等待正式模型說明和獨立評測,才適合判斷其編碼能力及穩定性。

項目主頁 · 模型

Categories: 開源, 香港大學, 北京大學, Agentic, 模型訓練, 工具, Discord, 編程, 小米-Xiaomi

EvoSkill-GUI 讓 GUI Agent 在執行中即時修正技能

浙江大學 ZJU-REAL 團隊開源 EvoSkill-GUI,毋須額外訓練,透過結構化技能包、即時修正與自我檢討機制,讓 GUI Agent 在 MobileWorld、AndroidWorld、OSWorld 三個基準上明顯提升成功率。

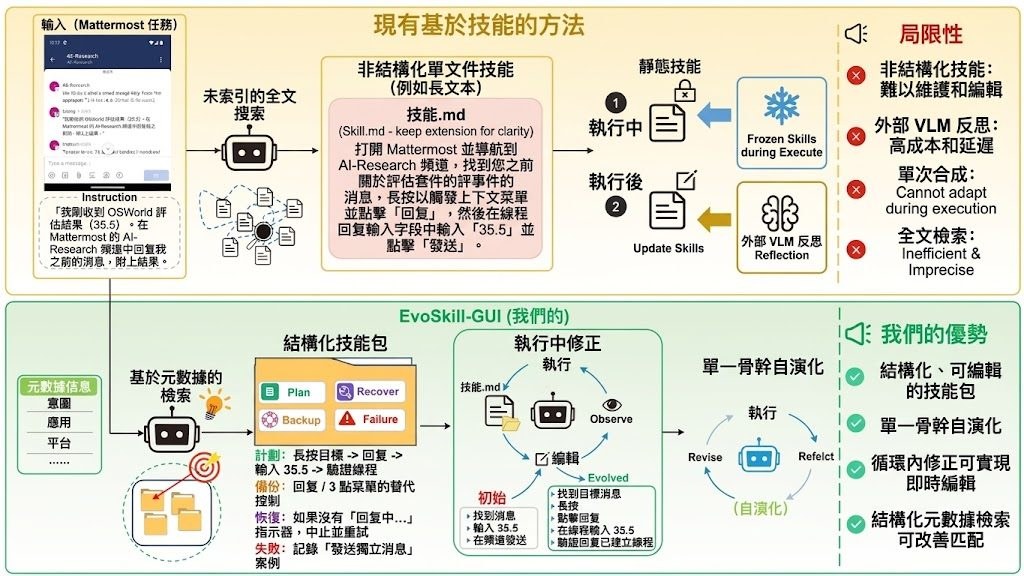
Comparison between static skill methods and EvoSkill-GUI

當手機或電腦彈出視窗、載入延遲、介面元素位置變動,原本寫好的 GUI 操作步驟往往幾步之後就失效。EvoSkill-GUI 正正回應這個痛點——它是浙江大學 ZJU-REAL 團隊推出的開源框架,毋須微調,就能讓 GUI Agent 把「技能」從靜態提示詞變成可即時修補、可重用的程序知識。

以往的 skill-based agent 把規劃、定位、復原規則全部塞進同一份文件,出錯時難以精準修補。EvoSkill-GUI 將每項技能拆成結構化套件,內含計劃、後備定位、復原規則、無障礙工具、檢索 metadata 與失敗案例等獨立檔案,並以 metadata 索引,後續按意圖、應用、平台等條件快速取出對應經驗,而非逐字比對長篇技能文件。

它的核心設計是「同一個骨幹模型」兼任執行者與批評者。執行時若觀察到介面與計劃不符,會即時修補局部錯配,避免小錯滾成大錯;失敗後模型會在嚴格資訊隔離下診斷軌跡,只針對出問題的檔案做精準編輯,毋須額外更強的反思模型輔助。

在 MobileWorld、AndroidWorld、OSWorld 三個基準上,無論通用模型還是 GUI 專用模型,EvoSkill-GUI 都帶來穩定提升,最高絕對增益分別為 +16.2、+6.0、+10.5 個百分點。對做行動 App 自動化、桌面助手或 RPA 的團隊而言,這種毋須重訓又能累積經驗的設計相當實用;不過整套機制依賴骨幹模型本身的反思品質,任務越長、介面越動態,回報會越明顯。

重點摘要:

  • 訓練免費用:以 single-backbone self-evolution 機制,省掉外部批評模型與微調成本。
  • 技能拆件:把計劃、定位、復原拆成獨立可編輯檔案,方便精準修補。
  • 即時修正:在 rollout 內偵測到介面變化就立刻修,避免錯誤擴散。
  • 資訊隔離批評:批評階段只看指令、觀察與動作,避免偷看草稿或答案。
  • 跨基準驗證:在 MobileWorld、AndroidWorld、OSWorld 三項皆有顯著絕對增益。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型訓練, 提示詞, 框架, 工具, Skill 技能

WeVisDoc 騰訊文件圖片的端到端解析模型

騰訊 WeChat Vision 團隊開源 WeVisDoc 系列文件解析模型,以「先擴廣覆蓋、再針對性補強」的兩階段訓練框架,在 OmniDocBench v1.6 與多個 PureDocBench 軌道同時刷新端到端解析器紀錄。

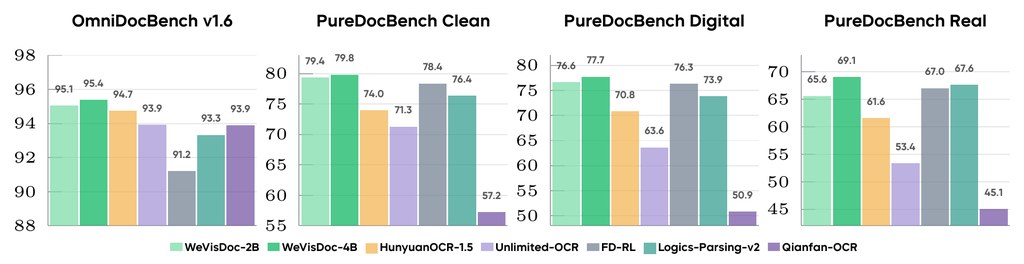
WeVisDoc-4B leads the compared end-to-end parsers across all four reported settings.

當一份文件同時夾雜模糊掃描、手寫註記、複雜表格與數學公式時,多數 OCR + 版面分析的流水線都會在交接處出錯——模型間責任不清,錯誤層層放大。騰訊 WeChat Vision 團隊開源的 WeVisDoc 系列正正針對這個痛點,把「文件頁 → 結構化 Markdown(含 LaTeX 公式、HTML 表格)」收進單一端到端模型,避免不同模組互相推卸責任。

WeVisDoc 推出 2B 與 4B 兩款模型,皆以 Qwen3-VL 為基座微調而成,覆蓋文字、公式、表格與閱讀順序四個維度。訓練方法分兩階段:Stage I 先擴大語義、結構、外觀三方面的數據覆蓋;Stage II 則用殘差診斷找出 Stage I 仍出錯的樣本,針對性地補充與重新分配訓練數據。這套做法與單純堆數據量的路線不同——它把精力集中在模型最容易跌倒的角落。

在 OmniDocBench v1.6 上,WeVisDoc-4B 取得 95.38 的 Overall 分數,三條 PureDocBench 軌道的平均分為 75.54,均為目前端到端解析器的最佳成績。在更貼近真實擷取條件的 PureDocBench Real(模擬四次實體拍攝劣化)上,相對次強基線仍拉開 1.44 分,是四個比較場景中差距最大的一項,正好對應 Stage II「在真實擷取最難看的外觀變化上獲得最大增益」的設計初衷。

對需要把大量歷史紙本文件、學術論文、表格報表轉成結構化內容的研究團隊與企業來說,WeVisDoc 提供了一個開源、可在本地用 GGUF 等格式部署的小模型選項。模型現已上載 Hugging Face,並附技術報告與互動式 Recovery Lab,方便逐頁對比 Stage I 與 Stage II 修復了哪些具體錯誤(例如被漏掉的 9×9 數獨格線)。

  • 騰訊 WeChat Vision 團隊開源的端到端文件解析模型,2B/4B 兩個規模,皆基於 Qwen3-VL 微調
  • 兩階段「數據中心」訓練框架:Stage I 擴大覆蓋、Stage II 以殘差診斷針對性補強
  • 輸出結構化 Markdown,內含 LaTeX 公式與 HTML 表格,涵蓋文字、公式、表格、閱讀順序四維度
  • WeVisDoc-4B 在 OmniDocBench v1.6 與三條 PureDocBench 軌道均居端到端解析器首位
  • 開源釋出模型權重、技術報告與互動式範例頁,方便逐頁審視修復效果

項目主頁 · GitHub

Categories: 開源, 騰訊, 模型, 模型訓練, Qwen, 框架, Dataset 數據集

Page 15 of 38
1 … 13 14 15 16 17 … 38