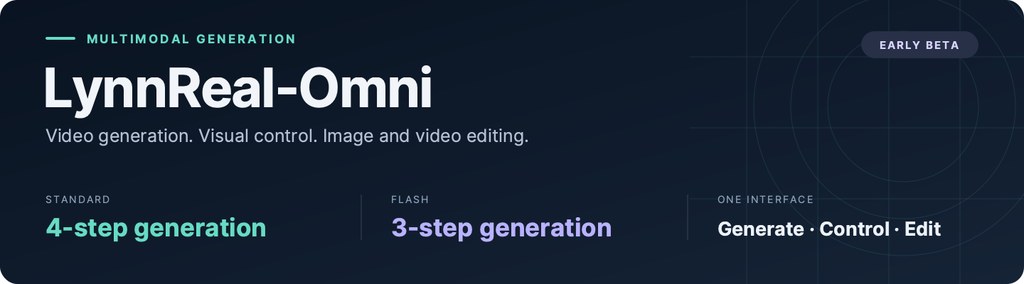
LynnReal-Omni 想解決嘅,係影片生成工具鏈最煩嘅一件事:每加一個任務(動作控制、參考影像、風格遷移、編輯、修復)就要疊多一個模型或多一套 pipeline。作者選擇用一個 32B 共享多模態擴散 Transformer(跟 MiniMax H3 架構)一次過承載文字生影片、圖生影片、人體與手部姿勢控制、結構控制、omni-reference、風格遷移、影片編輯、退化影片修復,以至串流式長影片生成,仲可以接駁外觀參考、可編輯 3D render、遊戲錄影等異質輸入,等 Agent 可以喺同一個模型內組合視覺條件。
對比同類做法,最大差異係「統一框架」而非「任務專用模型」。每個源帧獨立編輯再組裝成無聲 24fps 影片,每帧只需四次 DiT forward,120 帧即 480 次 forward。輸入限制清楚:24fps、寬高需為 32 倍數、目前只支援 768p(1344×768 起手)。獨立逐帧編輯會帶來亮度或形狀嘅帧間抖動,作者亦坦白標示為已知限制。

對短片創作者、遊戲或 3D 團隊、Agent 開發者來講,好處係少咗一套模型接駁嘅工程成本;Agent 可以直接用外觀參考同 3D render 嚟組裝條件。Flash 版本(27B、三步生成、輕量 VAE decoder)將單張 H100 上 22 帧 540p 由 843 毫秒壓到 377 毫秒,為實時或互動應用鋪路。
項目已提供 ComfyUI workflow 涵蓋 t2v、i2v、r2v、pose2v、v2v 幾個入口,但作者明言仲係早期 beta,質量、兼容性同 bug 仍然存在,訓練代碼、部分訓練數據同更高效 DiT 預計稍後釋出。打算用佢做關鍵流程嘅團隊,宜先以小批量預覽(--indices 0,24,48 --keep-clips)確認穩定性再評估是否引入生產。
重點摘要:
– 一個 32B DiT 模型覆蓋十幾種影片任務,Agent 可直接組合異質視覺條件
– 每源帧四次 DiT forward,120 帧共 480 次;輸入限 24fps、寬高需 32 倍數、768p
– Flash 版本用 27B 加輕量 VAE,單張 H100 上 22 帧 540p 暖機生成耗 377 毫秒
– 獨立逐帧編輯會產生帧間亮度與形狀抖動,屬已知限制
– ComfyUI 支援 t2v、i2v、r2v、pose2v、v2v,目前屬早期 beta,訓練代碼尚未開源