[技術文章] VibeVoice-ASR-Streaming 把講者即時辨識與轉錄合而為一

Microsoft Research團隊將講者辨識加入串流語音轉錄,讓語音助手更快知道誰在說甚麼。

Hugging Face

Microsoft Research聯同中國科學院大學及上海交通大學研究人員,開發VibeVoice-ASR-Streaming。

模型以 Large Language Model(LLM)為核心的端到端串流Speaker-Attributed Automatic Speech Recognition(ASR)系統,連續處理到達中的語音,同時輸出文字及講者身份。傳統流程通常把ASR與speaker diarization分開處理;此模型將兩項工作放進單一模型,針對即時語音助手及語音代理需要低延遲回應的場景,減少等待完整錄音後才分析的限制。

VibeVoice-ASR-Streaming 會交錯處理固定大小的audio chunks,並加入少量lookahead,讓模型在保留未來聲音片段作判斷的同時,逐步產生轉錄結果。固定分塊有助控制處理延遲,但lookahead 與分塊大小之間仍要取捨:前者越多,講者切換及語句判斷可能更穩定,回應時間亦可能增加。

  • 以單一LLM-based端到端模型同步處理ASR與speaker attribution
  • 使用固定大小audio chunks及少量lookahead支援串流輸出
  • 針對即時語音助手及agents的低延遲需求設計
  • 量化檔案、推論框架、硬體需求及效能指標尚未在提供內容中交代

項目主頁 · Paper

Categories: 微軟, Agentic, Audio, Discord, LLaMa, Ollama, 語音, Dataset 數據集

[技術文章]LLM 媲美 Embedding,成本卻高逾 1431 倍

LLM已能追上頂尖Embedding模型,但搜尋系統未必值得因此承受高昂成本。

Hugging Face

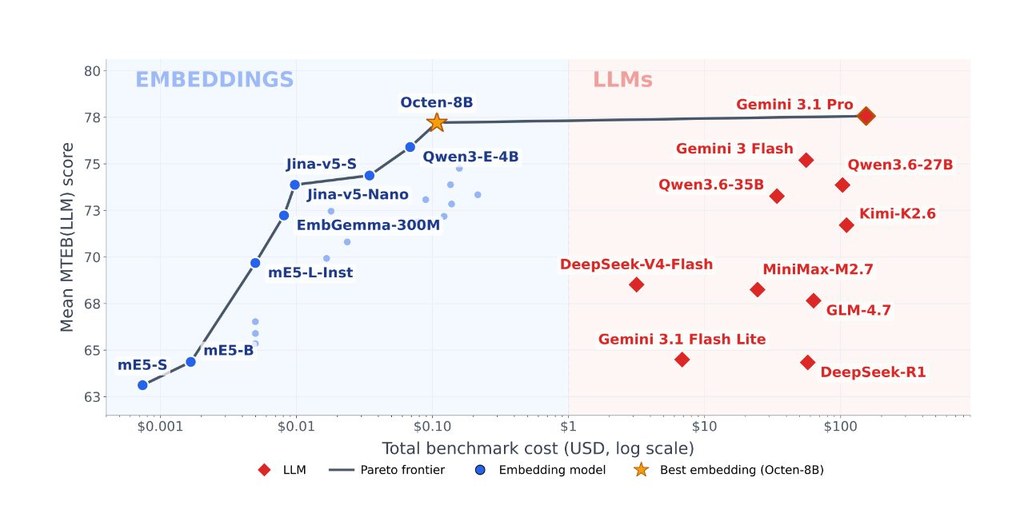
做語意搜尋、分類或文件聚類時,LLM已能在多項測試追上專門的文字嵌入模型;但每次評測成本最高相差1,431倍,令「是否應取代Embedding pipeline」成為成本與能力之間的取捨。本頁屬研究論文內容,並非可直接下載的單一模型頁面;未有提供可確認的 base model 或 fine-tuned from 資訊,因此無法判定某個模型的原始基礎模型。

研究比較10個、來自6個家族的 large language models (LLMs),以及26個參數量由118M至14B的 embedding models,測試涵蓋37項 MTEB(LLM) 任務,包括分類、semantic textual similarity (STS)、聚類、pair classification 和 retrieval。最佳 LLM Gemini 3.1 Pro 得分77.6,最佳 embedding model 得分77.2,差距只有0.4分。

  • Embedding models 在分類、相似度和聚類表現較合適
  • LLM 在需要推理的 retrieval 任務較有優勢
  • LLM 每次 benchmark pass 成本約154美元,embedding model 約0.11美元
  • 開源 LLM 在同一 GPU 上慢約2.5至736倍
  • reasoning tokens 佔 LLM inference 成本28%至81%

研究亦指出,降低 reasoning budget 對多數模型的 retrieval 品質沒有明顯傷害,反映混合式流程更合理:以 embedding model 負責大部分相似度搜尋,再把需要理解語境或多步推理的查詢交給 LLM。

Paper

Categories: Qwen, Gemini, Embedding, LLaMa, Ollama, Dataset 數據集, Kimi

Qwen3.8-2.4T-A95B 超大型開放權重文字推理模型

Qwen3.8 把 Qwen-Max 級別能力帶到開放模型,強項不只是答題,而係更穩定完成多步驟工作。

Og image

Qwen3.8-2.4T-A95B 把 Qwen-Max 級別的能力開放出來,而且明確建基於 Qwen3.5 的架構底層,BF16 safetensors 格式及1M上下文。定位上屬於 Causal Language Model,面向文字生成、編程、研究工作與長流程 Agentic 任務;相比只追求單輪回答,它更著重規劃、接收環境回饋,以及把多步驟工作做完。

Qwen3.8-2.4T-A95B 的核心規格相當進取:總參數 2.4T(2.4 trillion)參數,但每次啟動 95B,屬於典型大型 Mixture of Experts(MoE)路線,用較高總容量換取較可控的推理成本。模型經過 Pre-training 與 Post-training,並採用 Qwen3.5 架構延伸而來的層設計,包括 Gated DeltaNet、Gated Attention 與 MoE 組合,重點不是單純堆大,而是提升長鏈推理與任務完成的穩定性。

Qwen3.8-2.4T-A95B 主要來自兩個控制點:reasoning_effort 可調整推理深度,preserve_thinking 可保留歷史訊息中的 reasoning context。這代表它比較適合需要反覆修正、逐步執行的工作流,而唔係只看一次輸出的場景。頁面亦提到它對常見 harness 與開發工具有更廣泛支援,模型檔案可配合 Transformers、vLLM、SGLang、TokenSpeed 等推論堆疊。

  • 基礎模型可確認是建基於 Qwen3.5 architectural foundation。
  • 已知開放的是 Hugging Face Transformers 格式的 post-trained 權重。
  • 官方另有 Qwen3.8-Max 版本,功能更多,包含 vision input、non-thinking support、內建工具,以及預設 1M context length;但這些能力屬於官方服務版本,不應直接視為此頁權重全部具備。
  • 從已公開資訊看,它的優勢在於長流程 Agent 執行與專業工作可靠度提升;限制是硬體需求、完整上下文長度與量化部署細節未在此頁交代,離本地輕量部署仍有距離。

跟一般只強調 benchmark 分數的模型相比,它更強調任務完成率、規劃能力與工具鏈兼容性。由於缺少量化版本、推理記憶體需求與更完整評測數字,現階段較適合把它理解成面向高階推論服務與大型基建環境的開放權重,而不是即插即用的本地模型項目。

模型

Categories: 開源, Qwen, Agentic, API, LLaMa, Ollama, 模型訓練, 編程, Dataset 數據集

Meta Muse Glimmer:為本地多模態代理而生

Muse Glimmer 30B 針對本地部署而設,把圖文理解和代理式操作放在同一個模型裡。它同時提供 BF16、GGUF 與 ExecuTorch 版本,方便不同裝置取用。

Meta

Muse Glimmer 30B 屬於多模態 agentic model,重點放在本地部署時的可用性。對需要在自己裝置上處理圖文輸入、又想保留代理式工作流的用戶來說,這種設計比只提供單一格式的模型更實用,因為可以按硬件環境選擇合適版本。

Meta 這次一口氣放出多種包裝,包括 BF16 權重、GGUF k-quants、ExecuTorch builds,還有一個較細的 assistant 版本。這代表它不是只面向單一推理環境,而是嘗試覆蓋桌面、本地推理引擎,以及流動裝置部署等不同需求。

從現有資訊看,Muse Glimmer 的核心價值在於把多模態能力和本地執行的彈性結合起來。GGUF 版本方便在本地執行推理,ExecuTorch 版本則指向更輕量的裝置端部署;對想控制資料流向、減少依賴雲端服務的工作流,會更有吸引力。

  • 支援多模態輸入,適合圖文混合任務
  • 針對 local deployment 設計,部署選擇較多
  • 提供 BF16、GGUF k-quants、ExecuTorch 等不同格式
  • 有 30B 主模型與較小的 3B assistant 版本
  • 適合需要本地推理、裝置端或代理式工作流的場景

現時公開資料較集中在模型包裝與部署形式。就定位而言,它更像是一個面向實用部署的多模態模型系列,而不是只靠單一規格吸引注意的發佈。

項目主頁 · 模型

Categories: 開源, Agentic, API, Image, LLaMa, 多模態模型, 安全, 模型, 視覺模型, Meta

LFM2.5-2.6B:細模型做得到本地 Agent

LiquidAI 把 2.6B 模型做成可離線執行的 Agent 核心,重點是工具調用同多步任務。它更像一個為裝置端而設的工作模型,而唔係只追求聊天流暢度。

Og image

LFM2.5-2.6B 屬於經過後訓練的語言模型,基礎模型是 LFM2.5-2.6B,並非頁面再細分成其他來源模型。它的定位很清楚:在筆電、手機呢類裝置上處理工具調用、網頁搜尋同多步工作流程,盡量將推理留喺本地,減少資料外傳同雲端成本。

模型先經過約 34T tokens 的 pre-training,再用 mid-training 將上下文擴到 128K。之後以四階段後訓練把 base model 變成 agent,包括兩輪 SFT、按領域訓練 teacher、MOPD(Multi-domain on-policy distillation)同 Agentic RL(Agentic Reinforcement Learning)。頁面亦提到它在常見 agentic harness 內做過強化學習,目的係提升同工具框架的兼容度。

重點放在 GGUF 格式、mmproj 及量化版本,但目前提供的內容未列出完整檔名與各自大小,所以無法可靠列出每個檔案細節。作者建議由 Q4_K_M 作為起點,再按記憶體同速度需求向上或向下選擇;頁面同時指出它可以配合 llama.cppOllamaLM Studio 使用。

它在 Apple M5 Max 可達 220 tok/s,在 AMD Ryzen CPU 上可達 113 tok/s,而且記憶體需求低於 2.5 GB。不過,模型亦有清楚限制:它主要強在 agent 任務同工具使用,並唔代表所有通用推理場景都會贏過更大的模型;進階用法可配合 MTP draft speculation,但頁面未提供足夠細節去判斷其實際收益幅度。

  • 約 34T tokens 預訓練,後續再做 agent 導向微調
  • 上下文窗擴到 128K,適合較長任務鏈
  • Q4_K_M 可作為量化起點,兼顧體積同速度
  • 支援 llama.cppOllamaLM Studio
  • 設計重點係本地工具調用、多步 workflow,同私隱優先

項目主頁 · 模型

Categories: LLaMa, Mac, Ollama, 模型, 教學

DeepSeek-V4-Flash-0731:輕量化 Agent 模型追上大模型

想要較少啟動參數,又保留強 Agent 表現,DeepSeek-V4-Flash-0731 就係呢類取向。它把重點放在工具調用、編碼同自動化任務,速度與能力之間取得幾實際的平衡。

Og image

要兼顧回應速度、部署成本同 Agentic 能力,DeepSeek-V4-Flash-0731 走的是「較少啟動參數換取高效任務表現」的路線。頁面已清楚寫明它與 DeepSeek-V4-Flash-DSpark 採用相同模型結構,並且附帶 speculative decoding module,所以它不只是一般聊天模型,而是明顯朝工具使用、自動化操作與程式任務優化的版本。

它屬於 DeepSeek-V4-Flash 官方正式發布版,取代 preview 版本,並強調 agentic capabilities 有明顯提升。模型卡同時指出它的模型結構與 DeepSeek-V4-Flash-DSpark 一致,代表推理流程很可能圍繞主模型加速草稿模組來設計。

效能數字是最值得留意的部分。它在 Terminal Bench 2.1、NL2Repo、Cybergym、DeepSWE、Toolathlon-Verified、Agents’ Last Exam、AutomationBench Public 等基準上,普遍明顯高於 DeepSeek-V4-Flash(Preview),部分項目亦超過 DeepSeek-V4-Pro(Preview)。這種進步集中在 terminal 操作、程式庫理解、資安演練、軟件修復同工具鏈任務,反映它更像為 Computer-use agents、程式代理與自動化流程而調整,而不只是追求一般問答分數。

  • 與 DeepSeek-V4-Flash-DSpark 同結構,並附帶 speculative decoding module
  • 官方正式版取代 preview,重點提升 agentic capabilities
  • 多個 Agent/編碼基準明顯優於 DeepSeek-V4-Flash(Preview)
  • 啟動參數較少,但表現可與部分強勢閉源模型接近

部署資訊方面,內容只提供一則討論帖,提到可用兩台 DGX Spark 配合 ghcr.io/bjk110/vllm-spark:unholy-fusion-prod-ready 作最少設定部署;但模型頁面片段未列出上下文長度、GGUF 格式量化檔、mmproj、檔案大小、chat template 注意事項或 v2 檔名變更,因此不能推斷 llama.cpp、Ollama、LM Studio 的支援細節,也不能提供 Q4_K_M 一類量化建議。現有資料較適合把它理解成一個偏向高效率 Agent 任務的 DeepSeek 模型發布,而不是本地 GGUF 部署導向的模型。

模型

Categories: 開源, DeepSeek, Agentic, LLaMa, Ollama, 模型

CineMobile 點樣把電影運鏡搬上手機

想用一張相做出 bullet time 或 dolly zoom,CineMobile 瞄準的正是手機端生成速度與畫質之間的拉扯。它把大型影片擴散模型壓縮到可落地的體積,同時盡量保住電影感運鏡。

Hugging Face

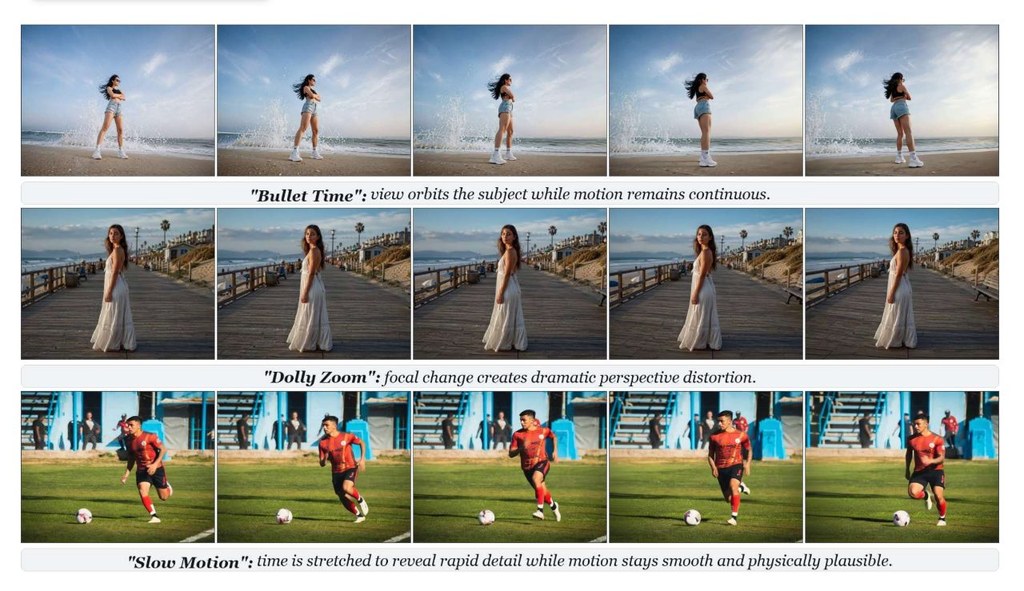
由 Wan 2.1 架構的 teacher model 壓縮而來,CineMobile 針對 image-to-video diffusion 而設,重點唔係追求最大全能,而係讓 bullet time、dolly zoom、slow motion 這類電影感鏡頭可以在手機晶片上跑得動。對一般使用者來說,最大差異是它把原本偏向雲端或高階 GPU 的生成流程,縮短到可在行動裝置完成的級別。

技術路線分三步走:先用 distillation-guided pruning 保留關鍵影片生成能力,再把壓縮後模型結合 diffusion distillation 與 reinforcement learning,進一步做成 4-step generator,最後再用 hybrid post-training quantization 把整體模型壓到 1 GB 以下。這組做法直接對準兩個瓶頸:DiTs 參數太大,以及多步去噪太慢。

頁面提供的數字相當具體。相比採用 Wan 2.1 architecture 的 teacher model,CineMobile 可帶來 40× 生成加速;生成 49-frame、480p 影片時,在 NVIDIA H200 GPU 的每步 denoising latency 為 0.6 秒,在 MediaTek Dimensity 8400 Ultimate 5G 平台約為 20 秒,峰值記憶體使用量為 1.8 GB。這代表它雖然仍有明顯等待時間,但已進入手機可接受的範圍。

  • 基礎來源可確認與 Wan 2.1 架構有關,但頁面未見完整 base model 款式或 checkpoint 名稱
  • 核心優化包括 pruning、distillation、reinforcement learning 與 post-training quantization
  • 目標輸出為 49-frame、480p 的 cinematic camera motion 影片
  • 重點能力在於連續運鏡,同時維持 subject identity 與 scene consistency

Hugging Face 暫未提供可直接下載量化檔的模型頁,未提供 GGUF、mmproj、llama.cpp、Ollama、LM Studio、chat template 或 v2 檔名更新資訊,亦無法判斷是否支援 MTP draft speculation。

項目主頁 · Paper

Categories: NVIDIA, Video, Image, AI productions, LLaMa, Ollama, 模型訓練, 視頻模型

Supra-Router-51M:AI 嘅智能分流

51.7M 參數嘅微型路由模型,自動判斷請求該交由本地小型模型定雲端大型模型處理。

Og image

Supra-Router-51M 係一個基於 SupraLabs/Supra-1.5-50M-Base-exp 基礎模型微調而成嘅小型語言模型(SLM),定位係多模型生態系統嘅邊緣路由閘道。佢嘅主要用途係分析用戶輸入嘅提示詞,判斷該請求適合由本地小型模型處理,定係需要轉交雲端大型模型,從而優化整體運算資源分配。

模型採用 Multi-Task Sequence Generation(多任務序列生成)嘅方法,唔係單純做二元分類。佢會先輸出一連串結構化資訊,包括語義領域(Domain)、複雜度評分(Complexity 1-5)、數學需求(Math)、程式碼需求(Code),最後先輸出路由決定(Route)。呢種設計令模型喺做最終判斷前,先建立內部特徵激活圖,避免細模型容易出現嘅權重崩塌問題。

訓練方面使用咗 SupraLabs/Prompt-Routing-Dataset 數據集(992 筆樣本),訓練 5 個 Epoch,但喺 Epoch 3(eval_loss 為 0.1342)已達到峰值後就回退保存,避免後段過度擬合。支援序列長度達 3840 tokens,使用 bfloat16 精度,喺 CPU/GPU 都能做到次毫秒級推論速度。推論時必須用 greedy decoding(do_sample=False)以確保決策穩定性。

使用時需要將用戶查詢包裝喺特定格式(Task: [Prompt] Analysis:)入面,模型會輸出 pipe-separated 嘅結構化字串,包含完整嘅提示詞遙測資訊。配合 FastAPI 等閘道框架就可以部署成生產環境嘅自動分流系統。

由於模型只有 51.7M 參數,運行門檻極低,適合邊緣裝置同需要即時決策嘅場景,但佢嘅路由準繩度仍然受制於訓練數據集規模較細呢個限制。

重點摘要:
– 基於 SupraLabs/Supra-1.5-50M-Base-exp 微調,僅 51.7M 參數
– 採用多任務序列生成架構,先分析提示詞特徵再決定路由
– 訓練數據集 992 筆,3840 tokens 序列長度,次毫秒級推論
– 支援 FastAPI 閘道部署,需使用 greedy decoding 確保穩定
– 適合邊緣裝置資源調度,限制係訓練數據規模較小

項目主頁

Categories: 開源, LLaMa, 模型, 框架, Dataset 數據集

Graph-GRPO:教模型先畫知識圖再作答

這是一個訓練語言模型的開源項目,重點是先整理知識圖,再輸出答案。它想改善純文字推理難以追蹤思路的問題。

Repository image for lamm-mit/graph-preflexor-grpo

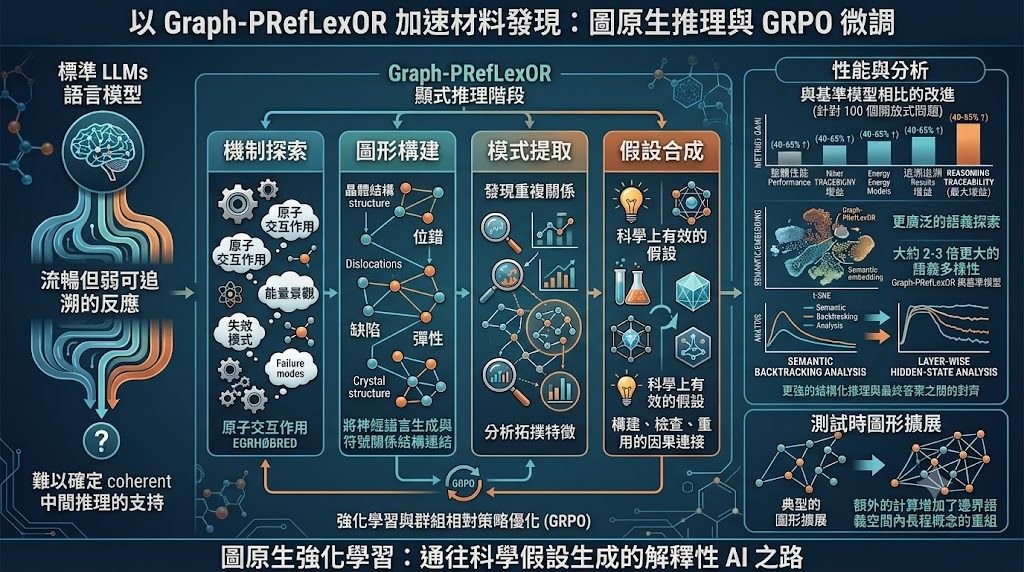
這是一個用來訓練語言模型的推理項目,核心屬於模型訓練流程兼研究原型。它要解決的問題,是模型回答問題時往往只輸出文字結論,推理結構難以檢查;Graph-GRPO 先要求模型把概念、關係與規律整理成 knowledge graph,再整合成答案。

現有做法多數依賴 chain-of-thought 或一般文字式 reasoning,把中間思路寫成自然語言。作者認為這種範式雖然靈活,但節點、因果、約束與抽象規律不易固定表示,因此提出 graph-native 的訓練方式:先用 ORPO(Odds Ratio Preference Optimization)或 SFT(Supervised Fine-Tuning)學格式,再用 Graph-GRPO 做強化學習,直接獎勵正確性、格式完整度與 graph utility。

項目的設計相當明確:節點類型限制為 entity、attribute、process、event、outcome、law、claim,關係亦只保留 12 種 verbs,並用 Pydantic 做結構化解析與 schema validation。這種取向的好處是輸出較易驗證,甚至能自動修補無效 graph;代價是表達自由度較低,未必適合非常開放、需要細膩語氣或鬆散聯想的回應。

部署與理解方式也算清楚,整個流程分成資料生成、run_orpo_graph 或 SFT 訓練,再進入 run_grpo_graph 強化階段,並以 LoRA 疊加在基礎模型上。README 亦提到可透過 OpenAI-compatible endpoint 驅動 ideation engine,把多輪生成的 graph_json 累積成可擴展知識圖,用於創意探索、問題延伸與比較不同前沿模型的表現。

  • 適合想研究可追蹤推理、結構化回答與可驗證中間步驟的團隊
  • 已釋出相關模型,基礎模型包括 Qwen-8B 與 Llama-3.2-3B-Instruct
  • 獎勵設計公開列出 correctness、format、graph utility 三部分權重
  • 亮點不在單純答得快,而在於把 reasoning 過程轉成可檢查的 graph object

在目前提供的內容中的性能不算完整,較明確的是訓練路徑、輸出結構與後續 ideation 用途,而 supporting context 另提到這條路線也延伸到 scientific hypothesis generation。整體來看,這個項目較適合研究型開發者、做 Agentic workflow 的團隊,以及想把 LLM 回答過程由黑盒文字轉成結構化證據鏈的人使用。

項目主頁 · GitHub · Paper

Categories: 開源, Qwen, OpenAI, Agentic, API, KnowledgeGraph, LLaMa, 模型訓練, Anthropic, Meta, Dataset 數據集

ConvFill:即時語音代理的雙模型方案

ConvFill 用本地小模型先開口,再由雲端大模型補上答案。它想解決語音代理常見的「快但唔夠準,準但唔夠快」拉扯。

Teaser

ConvFill 是一個用來建立語音代理的開源系統與研究原型。能夠實現即時回應和準確回答——這兩個目標通常難以兼顧。它將本地運行的小型快速語言模型與在後台進行繁重推理的大型雲端模型相結合,使代理能夠立即開始對話,並在資訊可用時自動填充合理的答案。此程式碼庫包含完整的系統、一個即時語音演示、七個即用型模型以及訓練您自己的模型所需的一切資源。

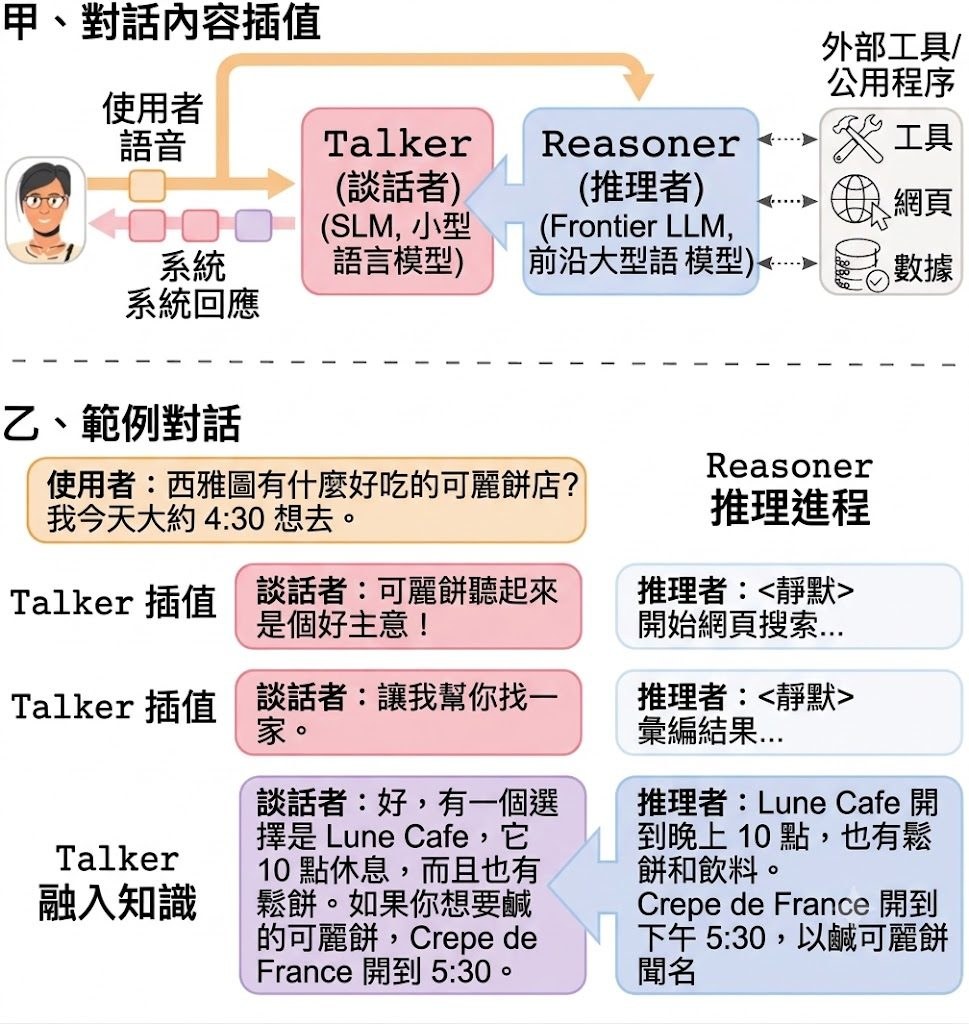
現有做法通常要麼直接等大型模型完整生成,回應較慢;要麼改用較小模型追求低延遲,但複雜查詢、文件搜尋同工具調用能力會明顯下降。ConvFill 提出 conversational infill 這個新任務,將 Talker 與 Reasoner 分工:Talker 先即時說話,Reasoner 在背景處理慢工序,再把精簡知識流式交回 Talker 融入回答。

ConvFill 不是單純做語音介面,而是重新安排推理時序。Talker 可用 135M 到 1.7B 參數的小模型,在手提電腦或手機本地運行;Reasoner 則可接 Claude、GPT 或 Gemini。儲存庫已提供 live voice demo、七個現成模型,以及訓練自家 Talker 所需內容,理解上可視為「本地即時對話層 + 雲端能力層」的組合。

  • 內置七個已微調 Talker,涵蓋 Qwen、Llama、Gemma、SmolLM 家族
  • 配套 ConvFill dataset,含 290,571 個經驗證訓練樣本,覆蓋六個領域
  • Reasoner 可替換為 Claude、OpenAI 或 Gemini,毋須為更換 Reasoner 重新訓練
  • 論文指出系統可維持 millisecond-level time-to-first-response,準確度與對應 frontier Reasoner 的差距縮至 6.3% 內

受益最明顯的,會是想做客服、助理、查詢式語音介面或需要邊說邊找資料的團隊。它未必適合完全離線、又要求深度推理的場景,因為關鍵能力仍依賴雲端 Reasoner;但對希望保留本地回應速度,同時接入大模型能力的項目,這套設計比單模型方案更有工程上的彈性。

GitHub · Paper

Categories: 開源, Qwen, Gemini, OpenAI, LLaMa, 模型, 語音, Anthropic, 蘋果, Dataset 數據集

Page 1 of 3
1 2 3