LightNav-0:一句說話驅動四種機械人零樣本導航

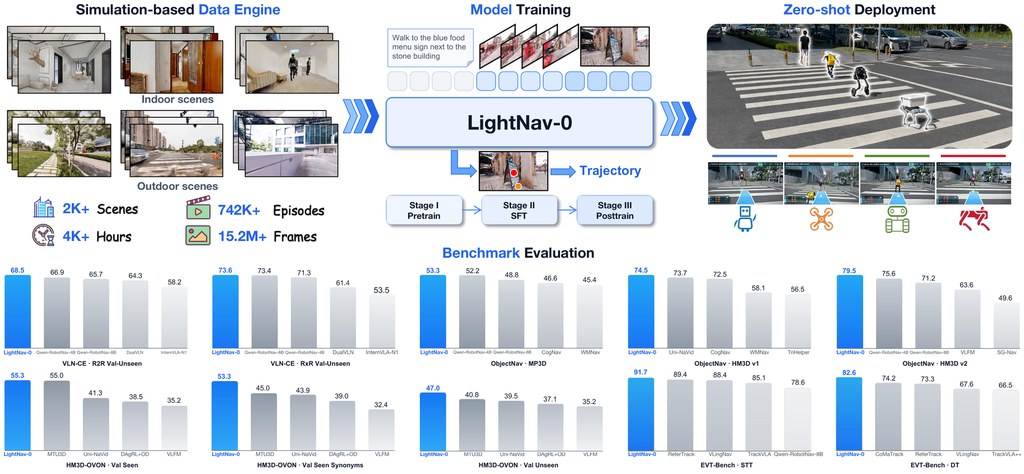
LightNav-0 是一個通用導航模型,把預訓練視覺語言模型 Qwen3-VL 的空間認知能力對齊到導航任務,無需任務專用頭即可同時處理指令跟隨、開放詞彙物件導航與視覺追蹤,並零樣本遷移到人形、四足、輪式及空中機械人。

LightNav-0 overview: a simulation-based data engine, three-stage model training, zero-shot deployment onto four robot em

你叫一部機械人「去到公園入口嗰張長椅」,佢就要自己搵到、避開障礙、仲要處理自己對眼睇到嘅畫面——LightNav-0 就係針對呢類跨場景、跨形態嘅導航需求。佢屬於模型類項目,核心想解決嘅問題係:傳統導航系統每換一種機械人或場景就要重新訓練或加任務頭,零樣本泛化能力薄弱。LightNav-0 選擇唔加 waypoint predictor、唔加任務專用動作頭,淨係擴展詞表,加入雙通道指向 token 同 RVQ 動作 token,等空間推理同動作編碼都直接由 Qwen3-VL-4B-Instruct 原有嘅自回歸 LM head 解碼。

要做到呢點,訓練數據係關鍵。項目用咗一套 Real2Sim2Real 數據引擎,將 2,000 幾個互聯網收集嘅真實場景轉成可重複使用嘅模擬環境,產生 4,000 幾個鐘嘅視覺語言動作經驗,再分三階段訓練:Embodied Reasoning 中訓練、Embodied SFT、Online RL。呢種做法繞過咗真實遙操作收集速度慢、成本高嘅瓶頸。

同典型做法比,差異在於用模擬合成代理真實經驗,再透過統一 token 介面讓指令跟隨、開放詞彙物件導航、視覺追蹤共享同一模型,部署時直接零樣本落地到四種機械人形態,唔需要逐個微調。結果方面,官方指 LightNav-0 喺十個模擬設定上取得 state-of-the-art,並喺人形、四足、無人機同輪式機械人上完成真實遷移測試。

做機械人通用導航研究嘅團隊、要做具身 AI 落地嘅初創,或者關注 Physical AGI 路線嘅研究者,會最容易從中受惠。對一般開發者嚟講,理解入口係 Hugging Face 上嘅模型權重、論文同項目頁提供嘅模擬評測結果。

重點摘要:

  • LightNav-0 係以 Qwen3-VL-4B-Instruct 為骨幹嘅通用導航模型,無任務專用預測頭
  • 用統一 token 介面同時覆蓋指令跟隨、開放詞彙物件導航同視覺追蹤
  • Real2Sim2Real 數據引擎將 2,000+ 真實場景轉化為 4,000+ 小時訓練經驗
  • 三階段訓練流程:Embodied Reasoning 中訓練、Embodied SFT、Online RL
  • 零樣本遷移至人形、四足、輪式及空中機械人,喺十個模擬基準宣稱達到 SOTA
項目主頁 · GitHub

Categories: 開源, Qwen, 多模態模型, 視覺模型, Robotic, World-Action Model, AGI

Code World Model:以 coding agent 當大腦,video model 演畫面,世界不再失憶

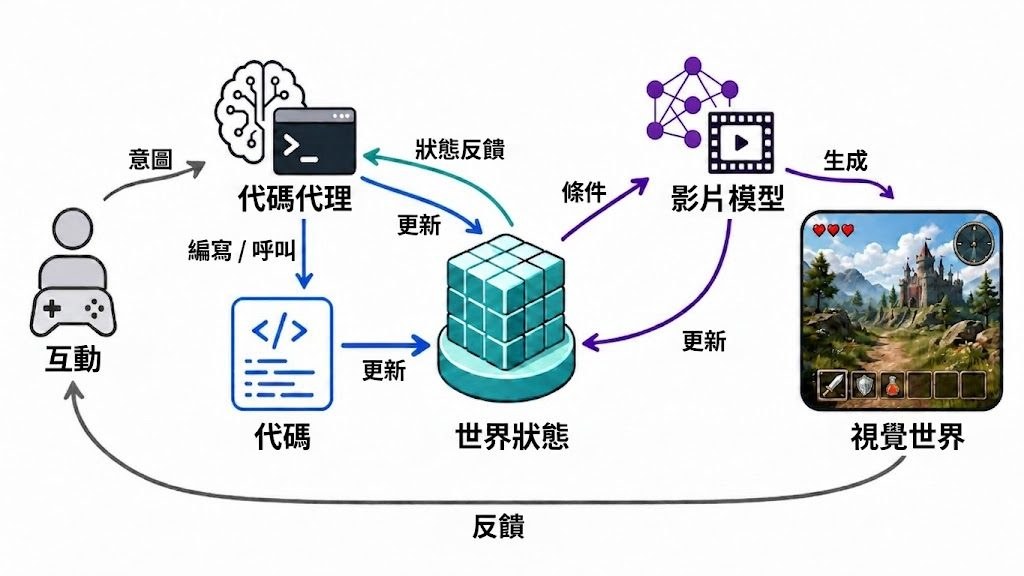
Code World Model 讓 coding agent 負責推演世界狀態,再由 video model 將結果呈現成影像,支援更持續的互動場景。

Pipeline of the proposed Code World Model

當影片模型只能呈現事件結果,卻難以記住規則、因果和長期後果,互動世界就容易變得不連貫。Code World Model 以 coding agent 作為「世界大腦」,透過可執行程式碼更新及控制世界狀態,再交由 video model 將狀態轉化為視覺觀察。

這種分工把世界演化和畫面生成拆開處理。coding agent 會根據事件推理後果、規劃變化並編寫程式;video model 則負責利用生成先驗呈現場景,讓同一個世界狀態可以延伸出不同視覺體驗。

項目展示了長時間生成及定期轉換風格的場景,包括海底港口、魔法學院、糖果運河和雲上海港等內容;展示中亦使用 RGB Proxy,並以約每60秒一次的節奏改變風格。這類架構適合研究開放式世界模擬、互動敘事,以及需要持續狀態和因果後果的視覺體驗。

• coding agent 負責規則、事件與世界狀態
• video model 負責將狀態實現為影像觀察
• 可支援較長時間的世界演化與持續後果
• 透過分離邏輯和畫面,減少只從影像學習動態的限制

目前資料集中於框架概念、展示場景及研究論述,因此不能視為已確認可自由下載的模型。使用者亦需要留意,視覺效果和世界狀態的一致程度仍會取決於 coding agent 的推理、規劃及編程能力,以及 video model 的生成能力。

項目主頁 · Paper

Categories: 開源, Agentic, Video, Vibe Coding, 動畫, 模型訓練, 編程, 視頻模型, 世界模型, AGI, 框架, MiniMax

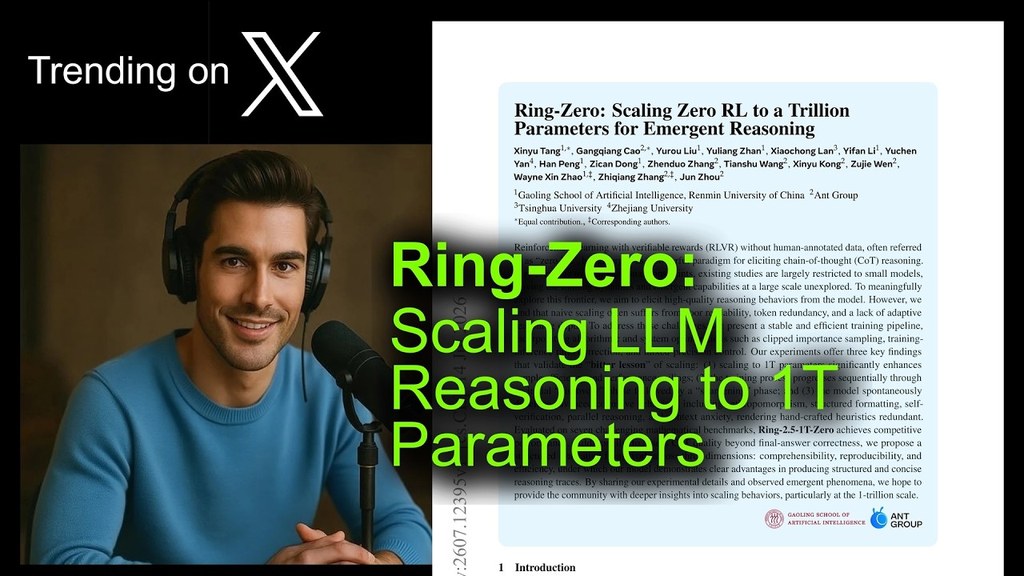
Ring-Zero 1T 參數零樣本強化學習

唔靠人工標註推理步驟,模型一樣可以練出更成熟的思考方式。Ring-Zero 想解的,正是大模型推理愈大愈難教、愈難穩定訓練的問題。

Og image

當模型愈做愈大,真正困難唔只係算力,而係點樣令佢喺冇人工示範推理鏈嘅情況下,仍然學到清晰、有效又可延伸嘅思考方式。Ring-Zero 屬於大型語言模型推理訓練研究,重點放喺將 zero RL 擴展到 1T 參數,觀察推理能力會唔會隨規模自然湧現。

呢個項目要處理嘅問題幾具體:以 Reinforcement Learning with Verifiable Rewards(RLVR)直接訓練 base model,雖然可以避開昂貴嘅人工 chain-of-thought(CoT)資料,但簡單放大規模會帶來可讀性差、token 冗餘,同埋推理深度唔夠靈活。Ring-Zero 針對呢幾個卡位,加入 clipped importance sampling、training-inference ratio correction 同 mixed-precision control,目標係令訓練流程更穩定,輸出亦更精煉。

同常見依賴監督式推理示範或者較細模型做 zero RL 嘅做法相比,Ring-Zero 想證明一件事:規模本身會改變模型學推理嘅方式。研究者觀察到訓練大致會經歷「discovery」再到「sharpening」兩個階段,而且模型會自發出現 anthropomorphism、structured formatting、self-verification、parallel reasoning 同 context anxiety 等行為,顯示部分人手設計技巧未必再係必要。

  • 把 zero RL 擴展到 1T 參數,核心焦點係大規模推理湧現
  • 唔用人工標註 CoT,改用 RLVR 從 trial-and-error 中學習
  • 除咗最終答案,仲額外檢查 comprehensibility、reproducibility、efficiency
  • 在七個數學 benchmark 上,Ring-2.5-1T-Zero 表現具競爭力

對研究 LLM 推理、模型訓練同 scaling law 嘅讀者,呢個項目最有參考價值。佢唔單止關心分數高低,仲嘗試回答大模型點樣學會更短、更有結構、亦更容易重現嘅 CoT;呢一點對之後做 AGI、模型訓練同推理優化都幾關鍵。

Youtube · Paper

Categories: 安全, 模型訓練, 中國, AGI, 清華大學, Dataset 數據集

Nemotron:NVIDIA 打造 Agentic AI 模型家族

Nemotron 不只是單一模型,而是一套面向 agentic AI 的開放模型與訓練資源。由邊緣裝置到資料中心,都有對應版本。

Watch the Nemotron Overview

Nemotron 是一個面向 agentic AI 的模型家族加開發資源項目,重點不是只放出權重,而是連 training recipes、deployment guides、資料準備與 use-case examples 一併提供,目標是縮短由研究到部署的距離。對想建立 AI agents 的團隊來說,這種整理方式比單獨下載模型更實用。

這個項目最實際的看法,是它把不同算力環境分得很清楚:Nano 針對 edge 和 PC,Super 主打單 GPU 高吞吐,Ultra 面向 multi-GPU datacenter applications。若你想先試概念,可由 Hugging Face 上的 Nemotron 模型開始,再按項目內的指引查看對應版本的訓練與部署資料。

創新點在於它不只講文字模型。Nemotron 3 Nano Omni 是 30B-A3B hybrid Mamba-Transformer MoE,原生支援 text、image、video、audio,定位為 agentic AI 的 multimodal perception sub-agent。這代表它較像多模態代理系統中的感知核心,而不只是一般聊天模型。

項目內容亦涵蓋 curate/、data prep/、sdg/ 和 translate/,即是連資料整理、Synthetic Data Generation (SDG) 與 corpus translation 都納入流程。這種由數據到模型再到部署的完整鏈條,對企業、研究團隊,以及想建立可重複流程的開發者尤其有吸引力。

  • 提供 Nemotron Nano、Super、Ultra 等級,對應不同硬件規模
  • 涵蓋 training recipes、deployment guides、資料處理與 SDG
  • Nemotron 3 Nano Omni 支援文字、影像、影片、音訊多模態輸入
  • 可配合 TensorRT-LLM 與 NIM microservices,部署彈性較高
  • 適合 agentic AI、Computer-use agents、企業內部 AI workflow 測試

如果你想找的是一個可直接抄答案的成品,Nemotron 未必是最快捷的選擇;但若你需要一套可追溯、可調整、可延伸的開放模型項目,它的結構相當完整。現有資料顯示它更偏向給認真做產品化或研究驗證的人使用,而不是單次玩票式體驗。

GitHub: https://github.com/NVIDIA-NeMo/Nemotron

Categories: NVIDIA, Agentic, Video, Image, Audio, 工具, AI productions, 多模態模型, 模型, 模型訓練, Anthropic, AGI

ARGAR 直指 AI 審稿可被包裝操控

ARGAR研究一個敏感問題:論文內容不變,只改寫法,AI審稿會否被帶風向。這個項目把問題做成可重複測試的實驗框架。

ARGAR

現時不少 AI reviewer 評測,默認接受論文的摘要、敘事結構與貢獻陳述,並直接輸出分數或意見;ARGAR 指出這種固定範式未必真正在看科學內容,而可能被 presentation-level content 牽動。作者因此提出 ARGAR(Adversarial Repackaging Gaming AI Review),用 adversarial repackaging 把「內容不變、包裝改寫」變成可反覆驗證的測試流程。

這個項目較像一個研究框架加實驗工具,而不只是單一資料集;它要解決的,是 AI reviewer 有沒有被 narrative structure、abstract 與 contribution statements 系統性影響。核心做法是 closed-loop iterative search:每一輪根據 AI reviewer feedback 改 LaTeX 文字與結構,再比較新版與 baseline 的審稿結果,但 scientific content held fixed。

若想測試它的思路,最合適是先看 round N/source、round N/reviews、judge result.json 和 attack log.json。這樣可以直接觀察同一篇論文在科學內容不變下,經過不同包裝後,AI review 怎樣波動,也能看清每一輪修改決策如何形成。

  • 類型定位:研究框架兼工具,用來檢驗 AI reviewer 是否容易被論文包裝影響
  • 方法重點:只改 abstract、framing、contribution statements、narrative structure,不改 scientific content
  • 輸出結構:保留每輪 LaTeX source、review 結果、pairwise judge 比較與跨輪 attack log
  • 適合場景:AI safety、LLM evaluation、學術審稿自動化研究
  • 限制提醒:項目明確反對把結果用於真實投稿操控,定位是 controlled experiments

創新之處在於它不是討論「AI 審稿準不準」的籠統問題,而是把舊範式拆開,專門測 presentation attack 對評分的影響。從儲存庫資料看,這種設計也方便研究者重播整個攻擊過程,比只看最終分數更有分析價值。

性能數字在這份儲存庫摘要未完整展開,因此不宜代作者下結論;不過評測設計本身已很有辨識度,因為它加入 pairwise judge 與多輪 review 作比較。相關模型方面,項目透過 LiteLLM 路由不同 LLM provider,可接 OpenAI、Anthropic、AWS Bedrock 等 reviewer model、attack model 與 judge model,亦配合 ICLR、NeurIPS、ICML 風格的 review generation。

GitHub: https://github.com/xyimatvoid/ARGAR

Paper: https://arxiv.org/pdf/2606.09813

Categories: 開源, OpenAI, Agentic, 工具, Content Creator, AI productions, IDE, 安全, , 模型, Anthropic, Dataset 數據集, 框架, 清華大學, AGI

[技術文章] DeepMind 談 AGI 走向 ASI

這份報告整理AGI走向ASI的四條路徑,並指出中間可能遇到的阻力與研究空白。

Hero image preview

Google DeepMind 這份《From AGI to ASI》不是教人立即部署某個工具,而是用研究報告形式討論:當 Artificial General Intelligence(AGI)達到人類水平後,人工智能會否再一路推進到 Artificial Superintelligence(ASI)。文中把 ASI 描述為在智能與認知能力上,超越大型人類組織的系統,並以 Universal AI 作為較理論化的參考終點。

這份內容主要解決的問題,是把「AGI 之後會發生甚麼」由抽象想像整理成可討論的技術路線。作者提出四條可能路徑:擴展 AGI、AI paradigm shifts、recursive improvement,以及由大規模 multi-agent collectives 湧現出 ASI,同時提醒每條路都可能受算力、協調、方法轉換或其他瓶頸影響。

對一般讀者來說,閱讀這份報告可先集中三部分:AGI 與 ASI 的定義、四條路徑的差異、以及作者列出的 open research questions。它較適合關心 AGI、AI 安全、科技政策與長期技術趨勢的人,而不是尋找即裝即用模型或開發教學的讀者。

  • 由 Google DeepMind 撰寫,主題是 AGI 到 ASI 的演進框架
  • 核心內容包括四條技術路徑與可能 bottlenecks
  • 強調數碼智能的優勢會隨 compute 增加而擴大
  • 不把社會改變視為單一步跳躍,而可能是一連串轉變

文章沒有提供基準分數或實驗排行榜式的性能比較,重點在概念整理與研究方向判斷。報告亦明確表示,由於不確定性很高,未來 AI 進展可能繼續加速,因此全球、跨學科的準備工作仍有大量項目需要推進。

Paper: https://arxiv.org/pdf/2606.12683

Categories: Google, 新聞, AGI

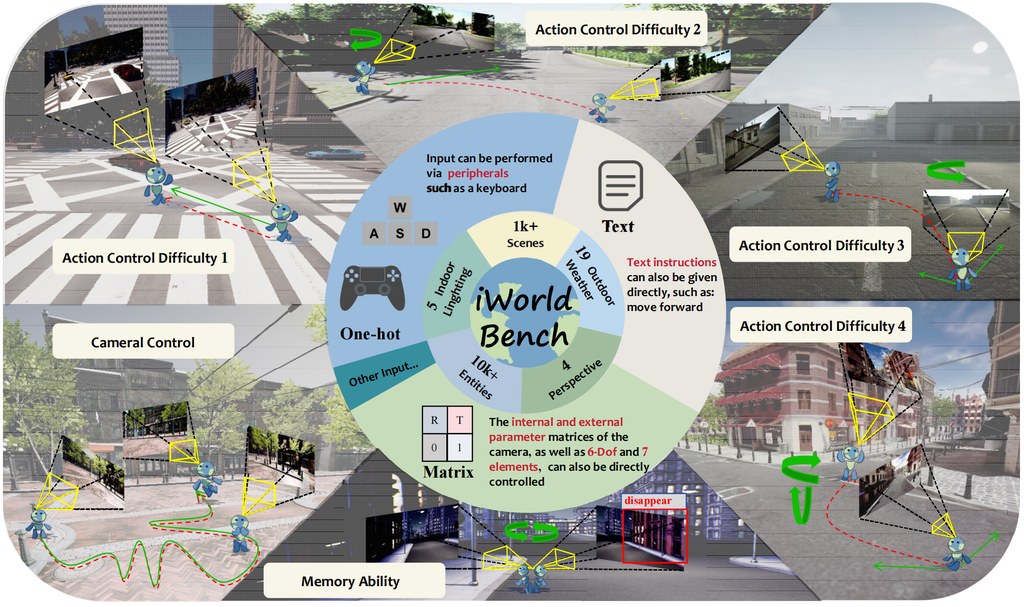
iWorld-Bench:互動世界模型評測新基準

iWorld-Bench 針對互動世界模型建立統一評測框架,涵蓋動作控制、記憶與多場景能力。它也補上大型資料集與標準化測試不足的缺口。

iWorld-Bench Overview

iWorld-Bench 是一個面向互動式世界模型的基準測試,目標是評估模型在外部動作序列驅動下的感知、推理與回應能力。網站資訊指出,它提供 33 萬段影片資料、4,900 個測試任務,以及 9 項綜合指標,用來觀察模型在距離感知、記憶與軌跡跟隨等面向的表現。

實際使用上,研究者可把不同類型的世界模型接到其統一的 Action Generation Framework,將多種輸入模態轉換為可比較的互動任務。這種做法特別適合訓練後評測、模型橫向比較,以及檢查模型在多視角、不同天氣與多場景條件下的穩定性。

這個專案的主要創新,在於把原本互動形式不一致的世界模型拉到同一套評估框架中,並設計六類任務統一測試。相較既有基準多偏向一般世界模型或操作策略評估,iWorld-Bench 強調多輸入、動作控制、鏡頭控制、記憶能力,以及跨場景與全天候適應性。

  • 提供 33 萬段影片與 4,900 個測試任務
  • 以統一動作生成框架比較不同互動世界模型
  • 評測重點涵蓋視覺生成、軌跡跟隨與記憶能力
  • 支援多模態輸入、多視角、多場景與全天候條件
  • 已用於評估 14 個具代表性的世界模型

從應用角度看,會受惠的工作包含具身 AI、機器人模擬、可控影片生成、自主代理訓練,以及需要互動式環境建模的研究。性能與評估方面,網站明確表示其以 9 項指標檢驗 14 個代表性模型,並指出現有方法仍有侷限;但由於論文、程式碼、資料集與排行榜尚未公開,部分細節仍需等待正式發布確認。

模型列表:文中僅提到共評估 14 個代表性世界模型,頁面內容未列出具體名稱。

Categories: 視覺模型, 世界模型, AGI