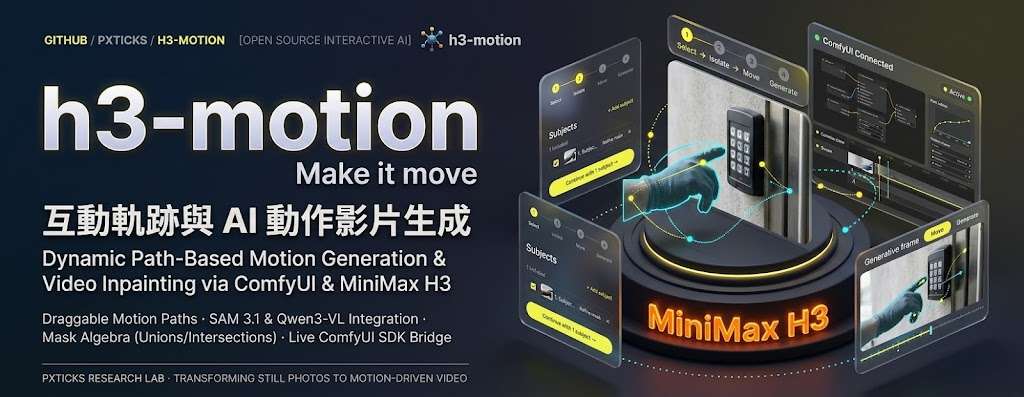
h3-motion:沿路徑移動照片主體並重生成影片局部

沿路徑移動照片主體,或為影片局部加上遮罩再重新生成;h3-motion 透過自架 ComfyUI 串連影像理解與動畫模型。

Select step: a gloved hand picked out with SAM 3.1

想沿路徑移動照片主體,或只重做影片局部,h3-motion 把兩種編輯流程整合在獨立 React app,透過 Comfy SDK 操作自架 ComfyUI。流程只用開放權重模型,不依賴 Comfy Router、合作夥伴節點或封閉 API。

照片流程以 SAM 3.1 選取主體,並可用點擊修整遮罩;Qwen3-VL 描述主體,Qwen Image 2.1 清除主體並補回背景。使用者設定路徑、大小或翻轉後,由 MiniMax H3 透過 Time-to-Move 生成動畫與聲音。
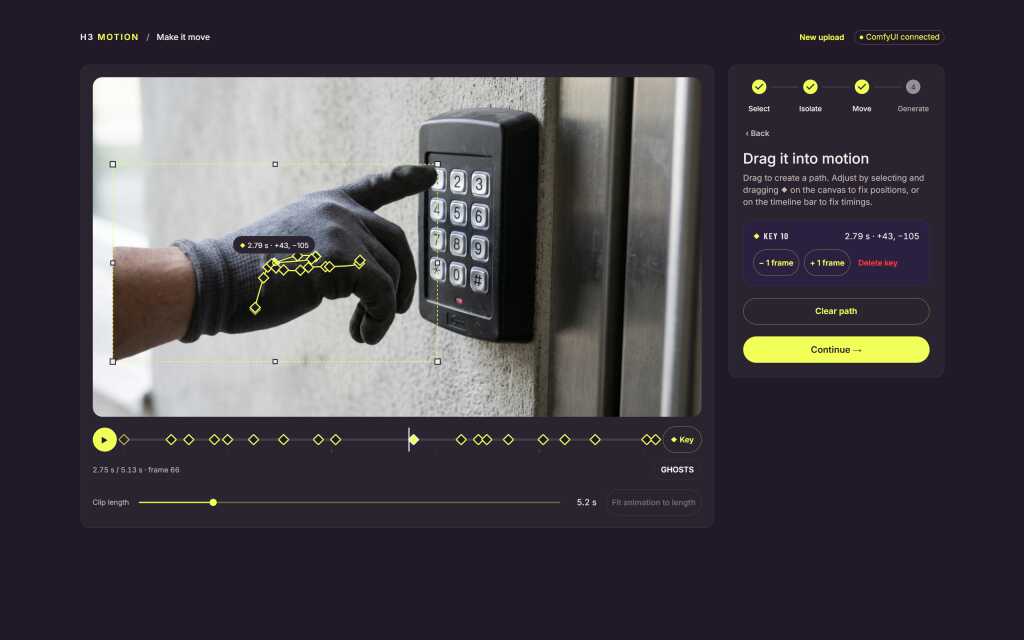
影片可用矩形或橢圓標出範圍,設定 keyframe 路徑或讓遮罩跟隨物件,並加入描述及可選參考圖。H3 重生成遮罩區域後,由 app 合成回原片;原有聲音可保留、參照或替換。

  • 照片:主體分割、背景清除,再沿路徑生成動畫。
  • 影片:局部遮罩、路徑或物件跟隨,並合成回來源影片。
  • 模型串連 SAM 3.1、Qwen3-VL、Qwen Image 2.1 與 MiniMax H3。

需要 NVIDIA 或 AMD GPU、近期 ComfyUI、ComfyUI-vlo 0.3.0 或更新版本,以及 Node.js 22.12 或更新版本;原生 Windows 尚未測試。文件未提供速度或畫質評測,較適合熟悉 ComfyUI、需要精細編輯影像局部的創作者。
GitHub

Categories: 開源, ComfyUI, AI productions, 模型, Qwen, NVIDIA, API, Video, Image, Audio, Content Creator, 動畫, MiniMax

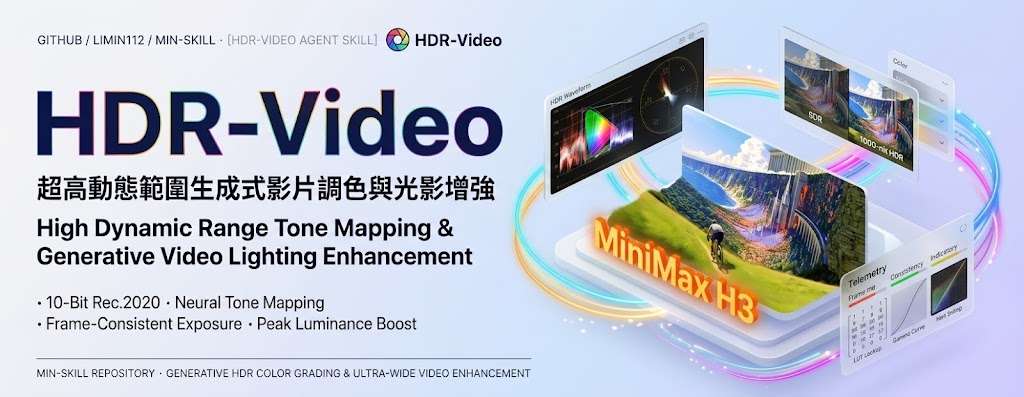
HDR mini-skill 讓 AI 片由 SDR 轉為 HDR

纯 ffmpeg + 自己生成的 3D LUT,不依赖 zscale / libplacebo / drawtext(Homebrew 的 ffmpeg 常常没带)。

Repository image for limin112/min-skill

把普通(SDR)視頻或其中一段,轉成 10-bit HEVC / HLG / BT.2020 的 HDR 文件:在 HDR 屏幕上,雲、太陽、水面反光、 金屬高光會“發光”。還能做左右對比:同一個文件里左邊 SDR、右邊 HDR。

  • 輸出 HLG HDR、10-bit HEVC 及 SDR/HDR 對比片。
  • 效果取決於素材。 米色卡片、文字、PPT 這類畫面轉成 HDR 只是把“紙”變亮,不適合。
  • 只有在 HDR 屏(Mac XDR、iPhone)上用 QuickTime 才有效果;普通播放器里會發灰、紅偏橙,這是正常的。
  • 原片已經是 HDR 的,腳本會拒絕(退出碼 2)。
  • 沒在真正的 HDR 屏上做過觀感驗證,也沒驗證過上傳各平台後是否保持 HDR;詳見 SKILL.md 末尾“已驗證 / 沒驗證”。

GitHub

Categories: 開源, 文字轉語音, AI productions, 數字人, 模型, Video, 框架, 工具, Content Creator, 3D, 庫, 語音, Anthropic, MiniMax, Skill 技能, LoRA

Open-H3-Regenerate-2K:把 MiniMax H3 影片提升至原生 2K

[YouTube 影片]NVIDIA 的 Open-H3-Regenerate-2K 可在 ComfyUI 將 480p MiniMax H3 草稿提升至 2K,並提供兩種測試方法。

Og image

將 480p 影片提升至 2K,往往要在畫面細節、運算成本與輸出穩定性之間取捨。NVIDIA Open-H3-Regenerate-2K 把這項流程帶入 ComfyUI,針對 MiniMax H3 產生的影片草稿進行高解像度重建,適合需要改善輸出尺寸而又想保留原有動態內容的影像工作流程。

影片示範以三個步驟完成處理,並測試兩種方法,相關檔案亦附有連結。不過,提供的原始資料沒有列出具體工作流程、模型檔案名稱、安裝方式或硬件要求,使用者仍需按影片內容及項目檔案確認 ComfyUI 節點、顯示卡記憶體和運算時間。

  • 將 480p MiniMax H3 草稿提升至原生 2K 影片
  • 以 ComfyUI 組合 NVIDIA Open-H3-Regenerate-2K 流程
  • 示範三步處理方式及兩種測試方法
  • 適合影片生成後的放大、修復及高解像度輸出
  • 硬件規格與安裝細節未在原始資料中提供

對內容創作者而言,這個項目可用於先以較低解像度製作草稿,再把選定結果交由高解像度流程處理,減少一開始便以 2K 生成所帶來的資源壓力。它較適合已經使用 ComfyUI、MiniMax H3 或 NVIDIA 影片模型工作流的使用者。

YouTube 影片介紹

Categories: ComfyUI, AI productions, 模型, NVIDIA, Video, Image, Content Creator, 安全, MiniMax

magpie:通過本機閘道,把不同 AI 編程代接上同一模型

Claude Code、Codex、Gemini CLI 等代理可以各自改用其他模型或訂閱帳戶;配額用完時,Magpie 亦可按設定切換帳戶或路由到其他服務。

magpie

想讓 Claude Code 用 Kimi、Codex 用 DeepSeek,或者讓 OpenCode 使用 ChatGPT 訂閱模型,不必逐個代理手動改一堆設定。Magpie 是一款跨平台工具,透過本機閘道統一管理模型與供應商,並從選單列切換代理設定;它改動的是各代理自己的關鍵設定,並非把不同代理合併成同一個程式。

它支援 API key、本機模型,以及 Claude、ChatGPT、Copilot、Gemini、Grok 等已登入帳戶。Claude 整合會呼叫本機的 Claude CLI,並透過 MCP(Model Context Protocol)橋接代理工具;ChatGPT 訂閱模型則可供其他代理使用。這讓使用者能沿用熟悉的代理工作流程,同時更換背後的模型來源。

配額耗盡時,Magpie 可改用同一供應商的另一個帳戶;若設定了路由群組,也可轉往其他模型或供應商。沒有備用帳戶或路由群組時,錯誤仍會傳回代理,因此不中斷並非無條件保證。隱私遮罩則須在設定中手動開啟,啟用後會在請求離開本機前遮蔽提示中的金鑰、密碼和電郵地址,再把內容還原到回覆。

  • 從同一份清單為不同代理選擇模型,減少逐個修改設定的工作。
  • 可混用雲端 API、本機模型和已登入的訂閱帳戶。
  • 帳戶或路由備援可降低配額用盡造成的中斷,但須先配置可用的後備路徑。
  • 隱私遮罩預設關閉,敏感資料保護需自行啟用。

對同時使用多個 AI 編程代理、需要管理不同供應商帳戶的個人或團隊,Magpie 可集中處理切換與備援;若只用單一帳戶,或不希望工具改寫代理設定,收益會較有限。項目支援 macOS、Windows、Linux、Docker 和 Termux;提供下載與文件,但所給資料未列出效能測試或延遲數據,選用前宜確認所需代理、模型與登入方式均在支援範圍內。

GitHub

Categories: 開源, MCP, 模型, 微軟, OpenAI, DeepSeek, Gemini, API, 工具, Mac, Linux, 編程, Anthropic, Kimi, MiniMax

MoneyPrinterTurbo 整合 AI 影片流程

輸入主題即可生成短片內容與素材,亦可接入不同模型;適合內容團隊快速製作多語言影片。

Kimi 赞助 MoneyPrinterTurbo

給定一個主題,便要自行寫稿、找素材、配音、加字幕再剪輯;MoneyPrinterTurbo 將這套流程整合成 AI 短影片生成工具,涵蓋腳本、配音、素材搜尋、字幕、配樂及剪輯,並提供 AI Agent、WebUI、API 和 CLI 四種介面。

由一句主題到成片:它可自動生成或改寫多語言影片腳本,也允許逐個環節改用自訂內容。支援批量生成、任務紀錄,以及設定和 API Key 的匯入、匯出與恢復,對經常製作大量短內容的編輯、社交媒體營運團隊及小型工作室尤其方便。

  • 輸入主題或關鍵詞,自動完成短片內容與素材配對
  • 以 WebUI、API、CLI 或 AI Agent 接入不同工作流程
  • 可替換腳本、配音、素材、字幕或配樂
  • 支援批量生成、任務歷史及多語言腳本
  • 兼容多種模型服務、統一網關及本地環境

模型選擇相當廣,可連接 Kimi/Moonshot AI、OpenAI、Anthropic Claude、Google Gemini、DeepSeek、阿里云通義千問、Microsoft Azure OpenAI、火山引擎方舟、xAI Grok、MiniMax、小米 MiMo,以及 Ollama、LiteLLM、OpenRouter 等平台。Kimi K3 獲項目採用,負責撰寫文案、提煉素材搜尋關鍵詞及判斷合適畫面;本地模型則適合重視資料控制或降低雲端依賴的團隊,但最終流暢度與準確度仍取決於所選模型、服務配額及素材來源。

這套工具的優勢不是生成單段影片,而是把多個製作步驟串成可重複運作的流程。代價是成品質素仍受文字模型、素材版權、語音及剪輯設定影響,重要影片應保留人工審核,而非直接自動發佈。

GitHub

Categories: 開源, Agentic, AI productions, 模型, Google, 微軟, OpenAI, DeepSeek, Gemini, API, Video, 工具, Ollama, 語音, Anthropic, Kimi, 小米-Xiaomi, MiniMax

SolarRenderer:Minimax H3 四步完成影片

SolarRenderer 將遊戲引擎或智能體輸出的結構訊號,於 MiniMax-H3 上以四步推理生成風格統一的影片,並以區塊串流方式即時輸出畫面。

teaser

過往要做「結構可控」的影片生成,往往要為每種輸入(灰盒、語義圖、骨骼、深度)各自訓練一支分支模型。SolarRenderer 試圖打破這個分工限制:它以兩組 LoRA 在 MiniMax-H3 上做 post-training,無需 condition-type label,純粹由 prompt 描述結構本身,再交由模型自行解讀。同一段結構影片,配合首幀與文字描述,可以分別輸出寫實、動漫、像素或水墨等風格。

更直接的價值在於速度與即時性。對比 50 步取樣,SolarRenderer 的四步推理聲稱快 12.3 倍,並在影像質素與結構保真度上同時達標。配合兩組 LoRA 的 block-causal 版本,影片可以逐區塊即時生成,每完成一塊便即時輸出,等候延遲約 0.7 秒出一個 17 幀區塊,整體滯後約 1.1 秒。對 agent 互動或即時預覽這類工作流,這個差距幾關鍵。

訓練資料與評估同為開放:weights、訓練資料,以及涵蓋 208 個高難度案例、53 段 held-out 影片的 benchmark 套件,連同評分代碼、輸出結果與裁判評語一併釋出。項目建基於 SolarWM 框架,並非隨意下載的開源玩具,但對從事可控影片生成、世界模型或 agent 影片預覽的研究者與團隊而言,是一個值得排入評估名單的選項。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, AI productions, 模型, 世界模型, 模型訓練, Video, Image, 框架, Dataset 數據集, MiniMax, LoRA

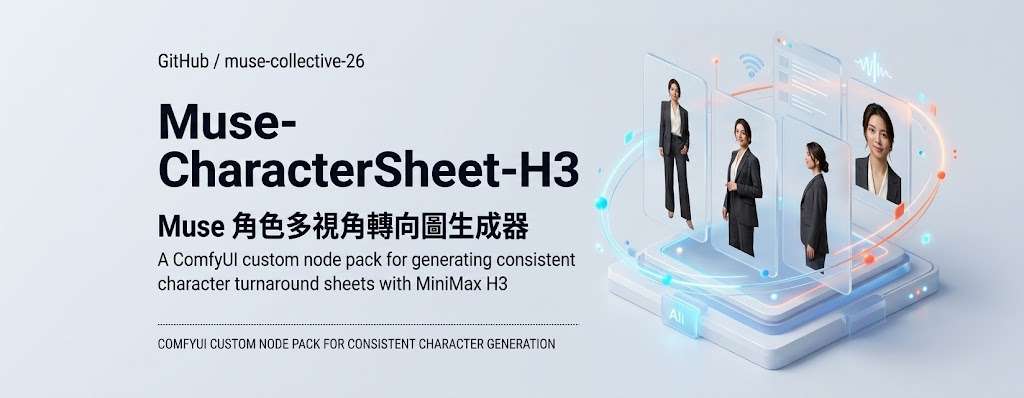
Muse-CharacterSheet-H3:MiniMax H3 角色表工作流

生成多角度、背景移除及排版一次完成,減少 ComfyUI 製作角色設定表的繁瑣步驟。

Repository image for muse-collective-26/Muse-CharacterSheet-H3

將五個角度的生成結果自動拼成一張角色設定表,Muse Character Sheet H3 這個 ComfyUI 工具組把 MiniMax H3 的多視角生成、文字儲存、影像轉換及背景處理連成一套工作流。對遊戲美術、角色設計與虛擬內容製作團隊而言,它省去逐格裁切、調整比例及手工排版,但仍需自行準備模型權重與合適的 ComfyUI 環境。

  • 提供 Standard 與 Enhanced 兩套工作流。
  • CHUNK/CUT 介面會把姿勢描述編譯成 H3 六段式 Reference-mode 提示格式。
  • Muse Character Sheet Compositor 可把 Close-up、Front、Left Profile、Right Profile、Back 五格自動並排。
  • Windows 安裝包已整合三個 Muse 工具節點,不需另下載獨立 utility ZIP。

Enhanced 版本在 H3 生成後加入 Qwen image refinement 與 DLSS enhancement;Standard 則以背景移除及選取畫面組成設定表,不依賴 DLSS,適合較簡單或未配置相關環境的流程。標準流程不再要求 WAS Node Suite 或原有 ComfyUI-RMBG 套件,但若其他工作流仍使用,就不應直接刪除。

背景移除輸出 IMAGE、MASK 與 MASK IMAGE;模型權重則另有使用條款。組合設定表支援 16:9、4:3、1:1、3:2 及 21:9,工具會按比例處理裁切,Close-up 佔完整寬度,其餘四個角度排列在側。

Windows 測試可下載完整 ZIP,將資料夾放入 custom_nodes,再執行 Install-Windows.bat;Git 必須在 PATH,模型則按清單另行下載。從前安裝過獨立工具資料夾的環境,應把備份移出 custom_nodes,避免同一節點重複註冊;安裝器不會自動刪除舊資料夾。

GitHub

Categories: 開源, ComfyUI, 模型, Qwen, Image, 工具, MiniMax

VIS-Ground 讓互動影片真正記住前文與要求

觀眾暫停影片後提出要求,VIS-Ground 會把來源、已播內容與指令整理成可驗證的生成約束。

VIS-Ground teaser

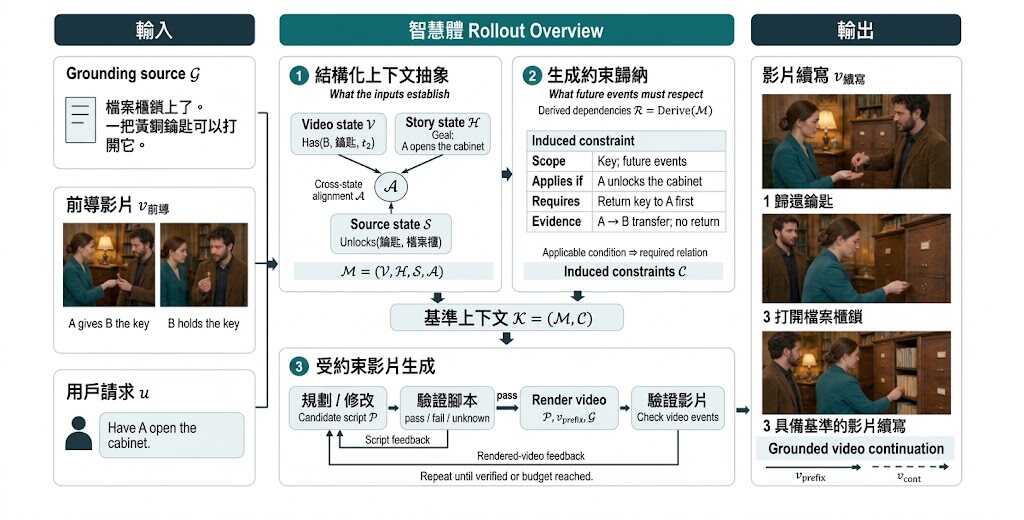
觀眾要求「用船運藥,而且不要弄濕」時,系統不能只理解一句新指令,還要記得橋已斷、目的地是祖母家,以及故事原本交代的背景。VIS-Ground 屬於互動影片生成研究框架,處理的正是來源資料、影片前段與觀眾介入之間容易互相牴觸的依賴關係。

它先以 Structured Context Abstraction 對齊 grounding source、已渲染的 video prefix 和 viewer request,再以 Generation Constraints Induction 抽取對下一段影片真正有關的條件,最後經過 plan、verify、revise、render 循環,檢查成片是否同時符合劇情連貫、知識來源和觀眾要求。這比單純把新提示詞交給影片生成器更重視前文約束,但代價是流程更複雜,也需要額外驗證。

  • 以可執行 constraint model 連接文字來源、影片內容與互動指令
  • VIS-Bench 包含 250 個 sources、1,004 個 viewer interventions 和 2,008 個 instances
  • 評估涵蓋 source faithfulness、story continuity、interaction fulfillment 及 joint score
  • 在 Omni-1.1-Flash、Veo 3.1 和 MiniMax-H3 三個 video backbones 均取得最高 composite score

Composite score 為 Omni-1.1-Flash 84.2、Veo 3.1 84.6、MiniMax-H3 78.8,較各自最強 baseline 高 12.3、15.3 和 3.4 分;提升主要集中在 story continuity。這些結果反映方法能跨越不同影片生成 backbone 工作,但資料只涵蓋 1,004 個互動介入,未足以代表所有敘事類型。

適合研究互動敘事、可控影片生成和多模態代理的團隊,用來測試「觀眾改變故事後,生成結果能否守住既有事實與新限制」。GitHub 目前只列出代碼、VIS-Bench 資料和評估腳本預告在 2026 年 12 月 15 日前釋出,因此暫時缺乏可按步驟安裝及本地測試的完整資訊。

項目主頁 · GitHub

Categories: 開源, AI productions, 多模態模型, Video, 提示詞, 框架, Dataset 數據集, MiniMax

WeKnora 把企業知識庫變成可問、可做、可追溯的 AI

WeKnora 將 RAG、Agent 與 Wiki 放進同一個知識庫,兼顧企業資料整合、任務執行和私有化部署。

WeKnora: find the answers, and put knowledge to work. Tencent

不只可以問文件內容,WeKnora 會幫你用 AI 操作工具、整理 Wiki,並保留已確認的偏好與事實。WeKnora 是一個開源 LLM 知識框架,處理企業文件理解、語意檢索與多步推理;RAG、Agent 和 Wiki 共用同一套知識庫,減少資料分散造成的落差。

RAG 會結合語意及關鍵字檢索,回答附上原文引用;Agent 可搜尋網頁、呼叫 MCP 工具、執行技能,並在沙箱中處理檔案。Wiki 則把文件整理成互相連結的頁面與知識圖譜,支援編輯、差異比較和版本回滾,適合需要持續維護內部知識的團隊。

  • 支援 PDF、Word、圖片、Excel、XMind 等十多種格式
  • 可同步飛書、Confluence、GitLab、Notion、語雀、RSS 等來源
  • 透過企業微信、飛書、Slack、Telegram、MCP Server 或 API 提供服務
  • 具備多空間 RBAC、審計日誌、任務佇列及 Langfuse 追蹤

模型、向量資料庫及儲存後端都可以替換,內置 29 家模型供應商,包括 OpenAI、DeepSeek、Qwen、Gemini、MiniMax、LiteLLM 和 Ollama。v0.8.2 加入本機瀏覽器操作、MCP Server、對話分叉與回滾,令知識庫不再只負責回答問題,也能參與任務流程。

Docker、Kubernetes、Helm、Lite 單機版及桌面應用都在支援範圍內,資料可以留在本地或私有雲。對重視資料留存、內部協作和可追溯性的企業,這套整合度具備明確吸引力。

項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, RAG, MCP, Qwen, OpenAI, DeepSeek, Gemini, Image, 框架, KnowledgeGraph, Ollama, 庫, Anthropic, MiniMax, Skill 技能

DMAD:MiniMax-H3 影片生成壓縮至四步

DMAD 將 MiniMax-H3 的 50 步生成流程壓縮至 4 步,兼顧 1344×768 影片與原生立體聲音輸出。

Videos generated by the 4-step DMAD student of MiniMax-H3 (video only; every clip also has generated audio)

由 50 步縮至 4 步,DMAD 讓 MiniMax-H3-33B 可以更快完成文字轉音訊影片生成,同時保留 1344×768 影片及原生立體聲音。這項目屬於模型蒸餾與推理工具,實際處理的是高質素生成與推理速度之間的取捨。

項目提供兩個 rank 128 的 LoRA,每個約 1.4GB,分別是論文使用的 lora critic,以及在 AVGen-Bench 取得較高分數的 full critic。它們都掛載於 H3 transformer,將 50 步 teacher 轉成四步 student;DMAD 以兩個 discriminator head 分辨真實資料、teacher 樣本與 student 樣本,直接學習 log-density ratio,省卻 DMD 所需的輔助 diffusion model。

  • 4 步生成 1344×768 影片及立體聲音
  • 提供 lora critic 與 full critic 兩個版本
  • 支援獨立推理程式及 Diffusers pipeline
  • 方法以 adversarial distillation 取代額外 score fitting

MiniMax-H3 與 rCM 的人類偏好比較為 84.6%,但 AVGen-Bench 只明確指出 full critic 分數較高,未提供具體差距;選擇模型時仍應按畫面質素、聲畫同步及硬件成本自行測試。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 多模態模型, 模型訓練, NVIDIA, Video, Image, Audio, 工具, MiniMax, LoRA

Page 1 of 7
1 2 3 … 7