YuE2 Studio 由樂譜到成曲:讓 AI 音樂可編輯重做

YuE2 Studio 先把風格與歌詞寫成可修改樂譜,再生成完整人聲歌曲,讓 AI 作曲不再只剩一個音訊檔。

logo

由風格描述和歌詞開始,YuE2 Studio 會先產生旋律與和弦樂譜,再演唱成最長約 10 分鐘的完整歌曲。這個項目屬於本地執行的 AI 音樂製作軟件,處理的是生成歌曲後難以修改編曲、旋律和聲部的問題。

YuE2 由 M-A-P 開發,先以 ABC notation 記錄 composition,再輸出歌曲;使用者可以閱讀及編輯樂譜,之後以相同 composition 重新渲染不同聲音。它不是只提供一次性音訊生成,而是把 score 帶回製作流程,較適合需要反覆改歌詞、旋律或配器的創作者。

項目建基於 yue2.cpp,一個原生 C++/CUDA port;桌面介面則採用 Rust、React 和 Tauri,執行路徑不需要 Python、Node.js 或 launcher。Windows 提供安裝程式及 portable folder,支援離線運行;NVIDIA 顯示卡需要至少 6 GB VRAM,AMD 和 Intel 透過 Vulkan 的支援仍屬 experimental。

  • 先寫樂譜再生成演唱,保留 composition 的修改空間
  • 支援歌曲、stems、MIDI、lyric sheets、scores 和 videos 的檔案管理
  • 內置十段 equalizer,並提供 Winamp 頻率配置預設
  • 可在本地 GPU 執行,毋須依賴線上音樂服務

它較適合有歌詞、曲式或編曲要求的獨立音樂人、內容創作者,以及需要離線處理素材的團隊。硬件限制亦相當直接:NVIDIA 6 GB VRAM 是較穩妥的起點,非 NVIDIA 顯示卡則要接受 Vulkan 路徑仍可能不完整。
GitHub

Categories: 開源, NVIDIA, Audio, 軟件, 工具, Content Creator, Mac, Python, 音樂, 廣東話

Audio8 ASR Infinite:持續運行語音轉錄

Audio8 ASR Infinite 以可調音訊時鐘和延遲,處理長時間串流轉錄的反應速度與記憶體增長問題。

Repository image for Edge0-AI/Audio8-ASR-Infinite

長時間錄音、直播字幕或語音助理最怕轉錄愈跑愈慢,甚至因上下文累積而出現漂移。Audio8 ASR Infinite 屬於原生串流語音識別模型,透過 rolling KV cache 將記憶體和延遲維持在有界範圍,支援 24/7 連續轉錄;目前支援中文及英文。

模型可在 80、120、160 ms 音訊時鐘之間選擇,每秒作出 12.5、8.3 或 6.25 次決策,並可將 transcription delay 設於 240 至 560 ms。延遲愈低,回應愈快;較長延遲則有較多時間累積語境。Semantic VAD 亦會分辨思考停頓、口吃和真正句末,減少傳統 acoustic VAD 過早截斷語句的問題。

架構承接 Voxtral realtime audio architecture 和 DSM-style streaming:Causal Audio Tower 以 Voxtral Realtime 4B 為初始權重,Audio Projector 及 Frame Length Embedding 由隨機初始化訓練,Decoder 和 LM Head 則採用 Qwen2.5-3B-Instruct。項目仍屬 preview release,後續會在同一 frame grid 加入即時語義感知。

  • 適合直播字幕、長時間會議紀錄及持續運行的語音介面
  • 可按硬件資源和回應要求調整音訊時鐘及延遲
  • 目前資料未提供完整安裝流程、硬件需求或公開 benchmark 數據
  • 使用 adapted vLLM build 才能對應無限長度串流運行

對需要低延遲、不中斷轉錄的團隊,這個模型的價值在於把速度、延遲可調性和長時間穩定運行放在同一個架構內,但正式採用前仍要自行測量廣東話支援、GPU 佔用及不同時鐘組合的辨識準確度。

項目主頁 · GitHub · 模型

Categories: 開源, Embedding, 模型, 模型訓練, Audio, 語音, Dataset 數據集, 廣東話

YuE2 補上真實音訊 Tokenizer,支援歌曲翻唱微調

YuE2取得音訊編碼與真實錄音適配能力,可將自家錄音轉成語義碼,再微調歌手風格。

Og image

當你餵給 YuE 一段參考音訊(例如某歌手的演唱片段或特定樂器風格,要求接續生成)時:必須先用 Tokenizer 將參考音訊「壓成代碼」傳入模型。若 Tokenizer 品質不佳,音色在第一步壓縮時就失真了。

這個 v4 工具能更高保真地將輸入聲音轉為 Token,讓後續模型捕捉到的音色特徵更貼近原音。

錄音轉換、歌手風格微調和歌曲翻唱,原本受限於 YuE2 沒有隨附的 audio → semantic-token encoder。這個項目基於 m-a-p/YuE2-3B 及 m-a-p/MERT-v2-FullSong,加入音訊 Tokenizer 與 NAR-branch LoRA,讓 YuE2-3B 可以處理自家錄音,並以真實製作音訊調整解碼效果。

Tokenizer 取用 MERT-v2-FullSong 第 20 層特徵,先按音軌作 instance normalization,再以 8 層、d=512 的 Transformer,在 512-frame 視窗內轉換成 32,768 種 YuE2 semantic codes,特徵率為 25 Hz。留出歌曲測試的 top-1 exact match 為 16.1%,但近似 code 產生的聲音接近,NAR round-trip 聽感測試約達 95%。

  • tokenizer_head_joint_v4.pt、.safetensors、.bf16.safetensors:音訊編碼 head
  • nar_lora_joint_v4.pt、.safetensors、.bf16.safetensors:NAR 解碼分支 LoRA
  • _comfyui.safetensors:配合 ComfyUI 的 YuE2 權重布局
  • LoRA rank 為 32,覆蓋 28 層 NAR attention、MLP,以及完整替換的 vae2llm 和 llm2vae

.bf16 版本約為完整精度檔案的一半,head 與 fp32 的輸出一致率為 98.6%。項目附有 scripts/ckpt_io.py、訓練迴圈和推論腳本;ComfyUI 可把 LoRA 載入 YuE2 checkpoint 的 MODEL 輸出,強度設為 1.0,CLIP 輸入不受影響。頁面沒有提供 GGUF 檔案、檔案大小、上下文長度、Ollama、LM Studio、llama.cpp 或 MTP draft speculation 支援資料,亦沒有列出可供選擇的量化級別。

模型先以 4,765 首 YuE2 自行生成歌曲訓練,再適配真實音訊;因此它的價值集中於提升真實錄音的編碼與 NAR 解碼,而非取代 YuE2-3B 的完整生成能力。授權為 CC-BY-NC-4.0,商業用途需要另行確認授權條件。

模型

Categories: 開源, ComfyUI, 模型, 模型訓練, Audio, 工具, 廣東話, Tokenize

YuE2-ComfyUI:本地生成完整歌曲,能改樂譜再翻唱

輸入風格與歌詞,便能在 ComfyUI 生成歌曲及可讀樂譜,讓創作流程多一個可修改的環節。

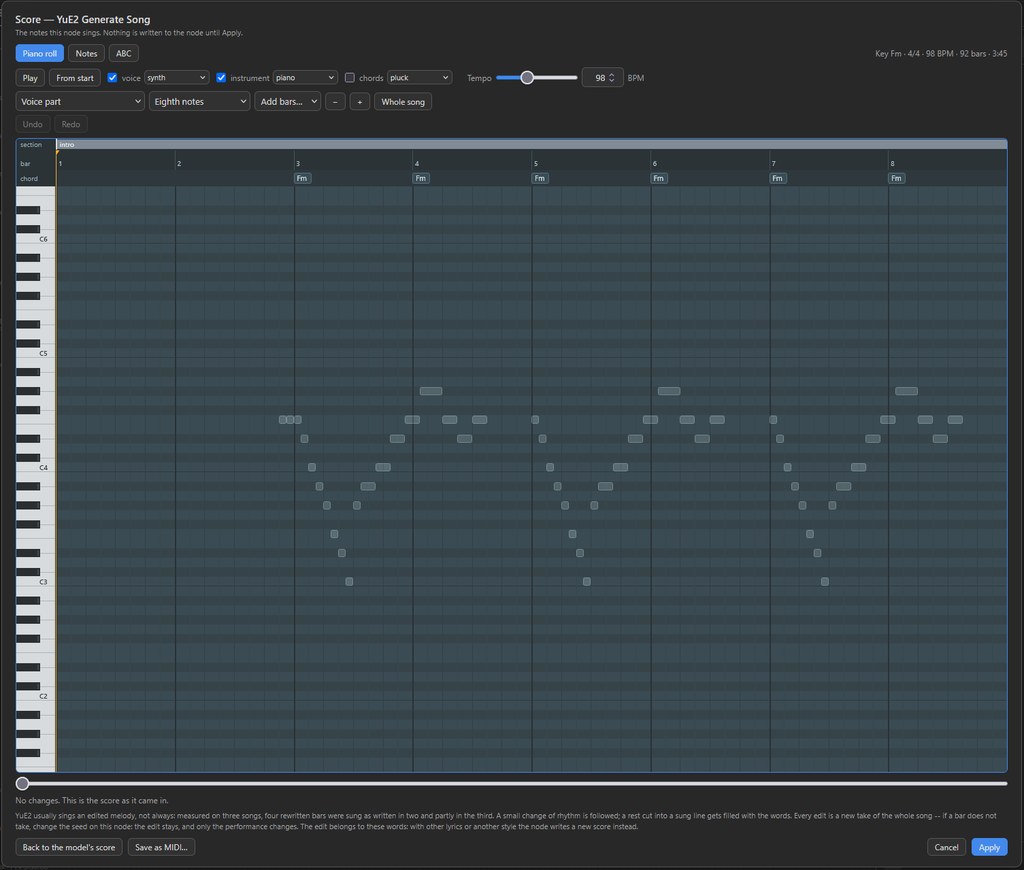
The score editor over the canvas, titled Score -- YuE2 Generate Song, with the line The notes this node sings. Nothing i

把歌詞接入節點、設定曲風後,YuE2-ComfyUI 便能在本機生成完整歌曲與可讀樂譜。這套音樂生成節點工具把 YuE2-3B 接入 ComfyUI,適合想在同一工作流程反覆試作的音樂創作者。

它先寫出 ABC 樂譜,再生成演奏內容,最後透過變分自編碼器(Variational Autoencoder,VAE)解碼成 48 kHz 立體聲。樂譜也可修改後送回節點演唱,讓旋律調整有更具體的入口。

  • YuE2 Generate Song 接收風格、歌詞及 seed。
  • 歌詞可從文字節點接入,以 [Verse]、[Chorus] 標示段落。
  • YuE2 Write Song 可從一句構想撰寫風格與歌詞。
  • YuE2 Options 提供選填設定,主節點會自動尋找本機權重。

項目示例在 RTX 5090 上花 40.2 秒生成 75 秒歌曲,但單一示例不足以推算其他硬件的速度。提供的內容未列出完整安裝步驟、最低顯示記憶體需求或音質比較;準備納入製作流程前,仍需確認本機能否載入模型。

GitHub

Categories: 開源, ComfyUI, AI productions, 工具, Content Creator, 音樂, 廣東話

ComfyUI-FL-YuE2:ComfyUI 內砌歌:FL YuE2 把樂譜編輯、AI 作曲、LoRA 訓練三件事接起來

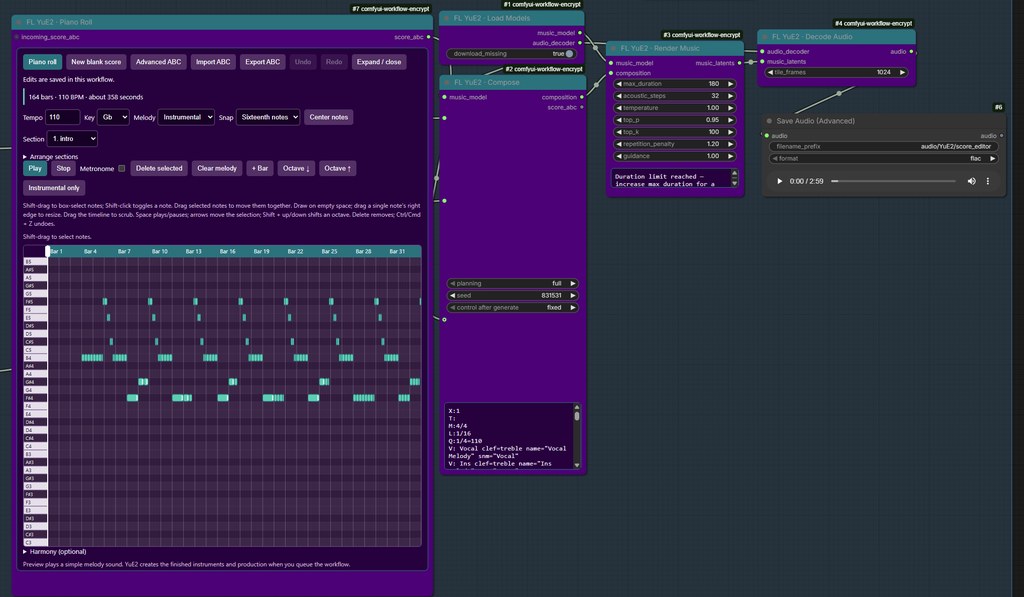
ComfyUI-FL-YuE2 是一組節點,把 YuE2-3B 音樂模型包進 ComfyUI 工作流,讓你用鋼琴卷軸寫樂譜、灌歌詞,最後輸出 48 kHz 立體聲成品,亦支援 AR LoRA 訓練。

YuE2 inference workflow in ComfyUI

以往想在 ComfyUI 玩音樂生成,往往要面對幾個卡位:要自行接 YuE2 的推理指令、要另外找譜面編輯工具、想做 LoRA 微調更要跳出 ComfyUI 自己搞訓練腳本。FL YuE2 嘗試一次解決這三件事,把樂譜編輯、AI 作曲、AR LoRA 訓練全部接成節點流程,對熟悉 ComfyUI 圖形化工作流的用家算是頗順手的整合。

項目核心是一個可視化鋼琴卷軸編輯器,支援點擊加音、Shift 框選、箭頭鍵移動、Undo/Redo 等基本操作,並提供 Instrumental 或 Sung 旋律模式。和弦面板可摺疊,匯入的 ABC 樂譜會保留 slash chord 等進階標記。換 Key 時同時處理旋律與和弦根音,最短轉調、超出音域會直接拒絕而非裁切音高,設計上偏向「樂理正確」多於「暴力生成」。

音訊輸出走 YuE2-3B 加獨立 VAE 解碼器,產出 48 kHz 立體聲,內建瀏覽器合成器可預覽節段節拍,但並非最終成品音色。LoRA 訓練流程則提供數據集檢視與 checkpoint 預覽,方便用家挑選權重繼續微調。

重點摘要
– 屬於 ComfyUI 自訂節點套件,整合 YuE2-3B 音樂生成與樂譜編輯
– 鋼琴卷軸支援框選、群組移動、Undo/Redo,轉調按樂理而非裁切處理
– 推理與 AR LoRA 訓練共用同一組節點,方便迭代
– 需 NVIDIA GPU 支援 BF16,已驗證 RTX PRO 6000 Blackwell,其餘 24 GB 配置未經驗證
– 首次執行約下載 7.8 GB 模型權重,支援中斷續傳與離線模式

適合已有 ComfyUI 基礎,又想嘗試可控音樂生成或自訓風格 LoRA 的用家。注意目前僅在 Windows + Python 3.12 + Torch 2.11 環境驗證,跨平台或較舊 GPU 仍需自行測試。

GitHub

Categories: 開源, ComfyUI, 模型, 模型訓練, NVIDIA, Audio, Python, 音樂, Dataset 數據集, 廣東話

YuE2 用樂譜做中介 把 AI 寫歌變成可改寫的工序

由香港科大 M·A·P 團隊推出的 YuE2,把歌詞與風格提示先轉成旋律與和弦樂譜,再渲染成完整歌曲。比起直接端出成品的做法,這條路線讓編曲、翻唱與代理編輯都變得可介入。

YuE

AI 寫歌工具多數只給你一首成品,YuE2 想處理的是另一個問題:怎樣讓生成過程本身可被人讀懂和修改。M·A·P 與港科大的團隊把流程拆成兩步,先用歌詞加風格提示寫出一份旋律與和弦計劃,再用同一個模型把樂譜變成帶人聲與伴奏的完整歌曲。

Melody 和 chord 不再藏在黑盒裡,而是可以預覽、試播,甚至交給人或 AI 代理去修改。這意味著同一個 checkpoint 可以同時做三件事:從零寫歌、把一段錄音轉成新風格的翻唱、以及透過對話逐步修編曲與歌詞。零樣本翻唱與代理式編輯不再需要切換不同模型。

當多數音樂生成模型只能交出一條「不能再拆」的音檔時,YuE2 走出了一條比較少見的路:它先把歌詞和風格提示轉成一份明確的樂譜與和弦藍圖,再用那份藍圖去唱出完整歌曲。等於把創作流程切成「規劃」和「演奏」兩段,而那份中間的樂譜本身就是可讀、可播、可改的物件,創作者或 AI 代理都能直接在上面動手。

开源翻唱音乐模型-YuE2:你的专业程度=模型上限,没有suno的各种限制。演示《Butterfly》。
YuE2 in ComfyUI: AI Music with an Editable Piano Roll

衡量歌曲品質的 WildSongBench 上,YuE2 best-of-8 取得 6.9632 平均分,是目前該榜觀察到的最高均值,並在多個面向與 Suno v5/v6 拉成均勢。它不只追求像 Suno,而是把 Suno 做不到的那一步:讓成品背後的樂譜可被檢視與修改,當作核心能力。

獨立音樂人、編曲助理、以及想把 AI 寫歌串進更長工作流的開發者,都是比較直接的使用者。代理式編輯對於要快速試不同編曲方向、需要保留人聲或旋律骨幹再重做風格的場景特別有用。

重點摘要

  • 先樂譜後音效:歌詞與風格提示先產出 melody 與 chord 計劃,再渲染成完整歌曲
  • WildSongBench 最佳均值:YuE2 best-of-8 取得 6.9632 分,與 Suno v5/v6 在多個面向拉成均勢
  • White-box 控制:樂譜可預覽、可試播、可交由人或代理修改
  • 零樣本翻唱:同一個 checkpoint 支援把轉錄樂譜換成新風格詮釋
  • 代理式編輯:可用對話方式逐步修編曲、歌詞與編排

入門方面,項目提供 Hugging Face 上的 YuE2-3B 權重、Demos 頁面,以及 Discord 社群。舊版 YuE 的程式碼與授權保留在 YuE-v1 分支,方便比對兩代做法差異。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 模型, 多模態模型, 工具, 音樂, 廣東話

FireRedTTS3:廣東話與各地方言內容創作,覆蓋 24 種語言與 21 種方言

FireRedTTS3 是把零樣本克隆、語音編輯、聲線設計整合進同一個模型的開源 TTS 項目,支援 24 種語言及 21 種中文方言,亦可純靠文字描述生成全新聲音。

做多語言配音或本地化短片時,最麻煩往往不是翻譯,而是要為每種語言找一個聽起來自然的聲線,又要顧及四川話、閩南話、上海話等方言差異。FireRedTTS3 想處理的就是這個矛盾:它是一個統一式的語音生成框架,把零樣本聲線克隆、語音編輯、以自然語言設計全新聲線三件事放在同一個模型裡,靠的是語義增強的連續語音表徵。

項目分兩個版本。FireRedTTS3-Base 主打多語言克隆,覆蓋 24 種語言(包括粵語在內)以及 21 種中文方言;FireRedTTS3-Instruct 則做到純文字驅動的聲線設計,不需參考音頻,只要描述性別、年齡、音色、語速等特徵,就能合成全新聲音,並且支援語義層與聲學層的自由形式編輯,例如改寫某段對話、調整語速或音量。

相對同類做法,它的差異在於把克隆、編輯、聲線設計整合成單一流程,而非各自獨立訓練模型。在 MiniMax-MLS-Test 上平均 WER/CER 約 3.754%、說話人相似度約 84.8%;在 Seed-TTS-eval 上克隆 WER/CER 約 3.04%、相似度約 78.8%,從公開數字看在多語言與中文方言任務都做到當前較高的水準。

本地配音、廣東話與各地方言內容創作、Podcast 或短影片自動化產出,以及需要快速原型不同聲線的產品團隊,都比較容易受惠。程式碼以 PyTorch 開源,模型已上架 Hugging Face 與 ModelScope,可透過 Python API 呼叫,亦提供 Instruct API 處理聲線設計與編輯。

重點摘要:

  • 多語言零樣本克隆:覆蓋 24 種語言及 21 種中文方言,包括粵語、四川話、上海話、福建話等。
  • 統一語音生成框架:把克隆、聲線設計、語音編輯整合在同一模型內,避免切換多套工具。
  • 純文字聲線設計:以自然語言描述性別、年齡、情緒等特徵即可合成全新聲音,無需參考音頻。
  • 自由形式語音編輯:支援語義層改寫(插入、刪除、替換)及聲學層調整(語速、音量、音調)。
  • 開源易取用:PyTorch 實作、Apache 2.0 授權,模型於 Hugging Face 與 ModelScope 提供下載。

GitHub · 模型

Categories: 開源, 文字轉語音, AI productions, 模型, API, Video, Audio, 語音, 廣東話

Hojo-ASR-Multi-V1:廣東話語音識別引擎

基於 Qwen3-4B-Instruct-2507 微調而成的多語言語音辨識模型,覆蓋歐亞九種語言,嘈雜環境與口語修正都有對應訓練。

Og image

如果你聽過一段嘈雜環境裡帶口音嘅外語對話,想即時轉成文字,Hojo-ASR-Multi-V1 就係針對呢類場景設計嘅。它並非由零訓練嘅語音模型,而係喺 Qwen/Qwen3-4B-Instruct-2507 之上做微調,把語音編碼器接駁到大語言模型嘅解碼端,形成 Encoder-Adapter-LLM 嘅典型結構,再加入多幀聲學融合模組去保留細粒度嘅聲音特徵。訓練過程分階段進行並結合強化學習,所以喺噪音、非標準發音、講錯即改口呢類真實情境下都唔會輕易崩潰。

多語言覆蓋係佢最突出嘅賣點。官方公布支援德、法、西、葡、意、日、阿拉伯、韓、俄等九種主要語言,並加入咗普通話、英語、廣東話同四川話等方言支援。從公開評測結果睇,佢喺多個 CoVoST、MLS 同 FLEURS 基準上都錄得相當低嘅 WER,例如意大利 FLEURS 2.30、法語 MLS 2.95、德語 CoVoST 3.85,整體表現平穩。

喺使用層面,開發者可以透過 PyPI 上嘅 hojo-asr 套件快速部署,亦支援 Hugging Face Transformers 後端。HOJO_ASR.load_model 介面可以直接接收 wav 檔案路徑、scp 清單或原始音訊 bytes,配合 CUDA 設備做批次推論。授權用 Apache-2.0,並提供商業整合支援,方便團隊接入產品線。

由於佢建基於 Qwen3-4B 體量,運行門檻比傳統大型 ASR 親民得多,但仍然需要 GPU 推論以維持批次速度。

重點摘要:

  • 基礎模型:以 Qwen/Qwen3-4B-Instruct-2507 為骨幹,採用 Encoder-Adapter-LLM 架構
  • 語言覆蓋:歐亞九國主要語言,加普通話、英語、廣東話、四川話
  • 訓練方式:多階段模組化訓練結合強化學習,針對噪音同口語修正優化
  • 評測表現:CoVoST、MLS、FLEURS 多語言 WER 普遍處於 2–5 區間
  • 部署方式:pip install hojo-asr 後用 HOJO_ASR.load_model 載入,支援檔案路徑、scp 或 bytes 輸入

需要留意嘅係,頁面並未提供 GGUF 量化檔案或本地推論引擎資訊,目前主要以 transformers 後端配合 GPU 運行;如果你想喺純 CPU 或邊緣裝置上使用,就要留意後續會唔會補上量化版本。

項目主頁

Categories: 開源, 模型, Qwen, Audio, 庫, 語音, Dataset 數據集, 廣東話

CantoneseChat:會聽聲調語氣的粵語聊天 App

一個針對粵語互動而做的 iOS 項目,把語音辨識、語氣調整同 TTS 串成完整對話流程。重點不只在聊天,而是回應更貼近香港人口吻。

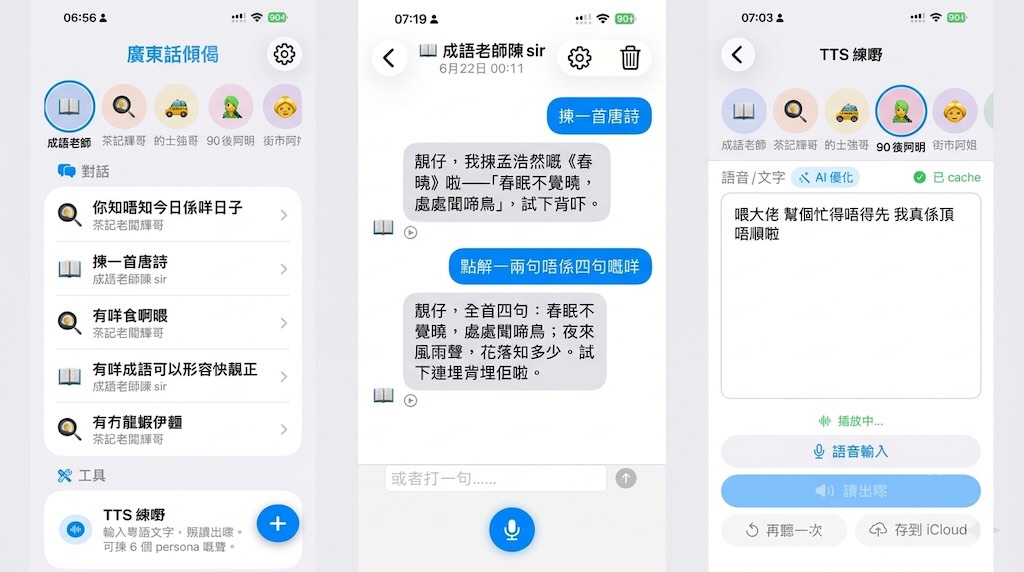
Cantonese Chat iOS app demo — Home / Chat / TTS Lab

CantoneseChat 是一個 iOS 粵語語音聊天工具項目,核心目標不是做通用聊天介面,而是把 iPhone 收音、on-device 粵語 STT、MiniMax cloud 的 LLM + TTS,以及 persona 語氣控制接成一條完整流程。它實際解決的問題,是一般語音助手識到字,但未必講得似香港人,亦未必會按說話者特徵調整語氣。

這個項目最值得留意的地方,是它會先用 AVAudioEngine 收音,再把音訊 downsample 去 16kHz,用 autocorrelation 估 pitch,推斷 VoiceType、Gender 同 AgeGroup,之後把結果注入 LLM system prompt。這種做法不是高精度聲紋身份辨識,而是偏向 heuristic 的語氣適配,所以速度會較直接,代價是分類準確度很受環境噪音、聲線變化同 pitch 規則影響。

安裝與理解方式也算清晰:它是 iPhone 真機導向的 iOS App,因為核心功能依賴 mic、AVAudioEngine、本機語音輸入同雲端模型串接,單看資料已可判斷模擬器未必能完整反映效果。測試時應分開看幾部分:persona 對話是否有語氣差異、TTS Lab 經 AI 粵語優化後是否更口語、pronunciation_overrides.txt 能否修正讀音,以及 iCloud export 有沒有順利保存音頻。

  • 支援 6 個 persona,適合示範同比較不同說話風格
  • 用 pitch heuristic 分類 VoiceType,再推斷 Gender、AgeGroup
  • 整合 on-device 粵語 STT、MiniMax cloud 的 LLM + TTS
  • 提供 pronunciation_overrides.txt 修正粵語讀音
  • 可將生成音頻匯出到 iCloud Drive

適合想做香港市場語音互動介面,例如客服示範、教育對話、角色語音內容,或者想研究粵語人機互動體驗的小團隊。若你重視可控語氣、多 persona 展示同本地口語感,它有明確方向;若你追求嚴格年齡性別判斷,這套規則式分類就應視為體驗輔助,而不是可靠的人口統計模型。

相關模型與模組包括 MiniMax cloud 的 LLM 與 TTS、iOS on-device 粵語 STT,以及項目內以 pitch 為基礎的 VoiceType 分類流程。公開資訊未見標準基準測試或 OSWorld 這類評測結果,所以較合理的判斷方式,是把它看成一個完成度不錯、偏產品原型取向的粵語語音互動項目。

GitHub: https://github.com/elbartohub/CantoneseChat

Categories: 開源, 文字轉語音, Audio, 香港, 語音, 蘋果, MiniMax, 廣東話