Video-Coder:用 AI 幫 Blender 補足影片生成的物理控制

Video-Coder 先用 Blender Python 建立具結構與動態的 Draft Video,再交給影片生成器完成畫面,改善物理合理性與控制能力。

Video-Coder overview

影片生成遇到物件互動、鏡頭運動或物理效果時,單靠文字直接生成往往難以穩定控制。Video-Coder 以 coding agent 身份編寫並執行 Blender Python,建立 3D 場景及 Draft Video,再把物件位置、動作和鏡頭資訊交給下游影片生成器;項目屬於影片生成代理項目,處理的是生成結果缺乏明確結構與物理約束的問題。

核心流程放在 Video-Coder Harness:代理會寫程式、執行、檢查結果,再按回饋修改程式。模型先以 supervised fine-tuning(SFT)訓練,之後接受 harness-native agentic reinforcement learning(RL);執行獎勵會逐步轉向影片獎勵,令程式能夠產生可用的場景草稿。Video-Coder-9B 建基於 Qwen3.5-9B,並可配合不同 Video generators。
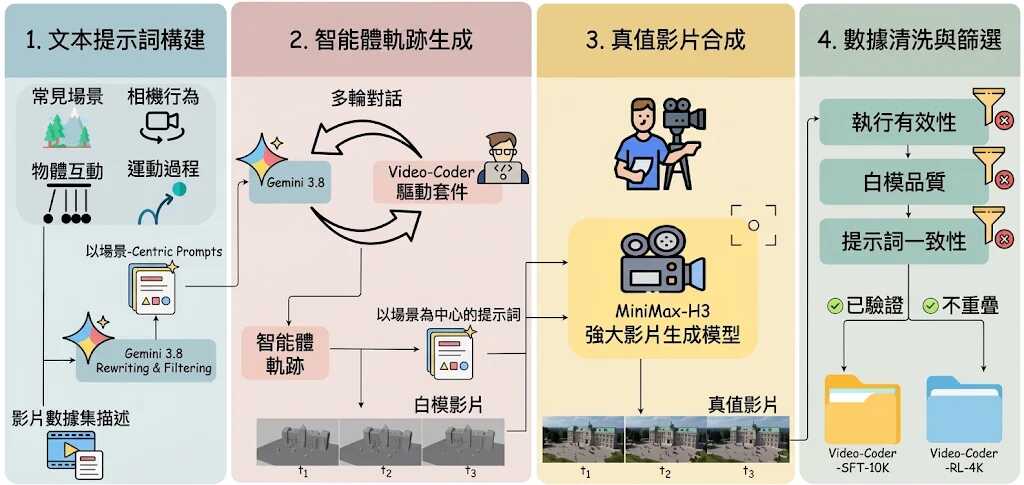
  • 以可執行 3D 程式補強直接文字生成
  • Draft Video 提供結構、動作與鏡頭訊號
  • 同時提供 SFT、RL 訓練流程及訓練資料
  • Video-Coder-9B 配合 MiniMax-H3 可提升物理相關評分

評測結果顯示,Video-Coder-9B + MiniMax-H3 在 PhyGenBench 平均取得 0.67,高於 MiniMax-H3 的 0.61;VBench-2.0 平均為 78.19%,較單獨使用 MiniMax-H3 的 54.58% 高 23.61 個百分點。Mechanics 分數達 88.67%,但這些結果依賴特定模型組合,未必能直接代表所有影片生成器的效果。

項目提供 Video-Coder-9B、Video-Coder-SFT-9B 模型及 Video-Coder-train-data,並列出 SFT 和 RL 的 Python 3.12 環境設定方向;提供的資料未包含完整推理流程,訓練指令亦在輸入內容中截斷。研究團隊、影片模型開發者及需要精確控制物件互動的創作者,較容易從這套程式驅動流程受益,但使用者需要準備 Blender、模型推理及訓練所需的運算資源。
項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, Agentic, AI productions, 模型, 模型訓練, Qwen, 微軟, Video, Vibe Coding, Content Creator, 3D, Python, 編程, Dataset 數據集, MiniMax, 強化學習

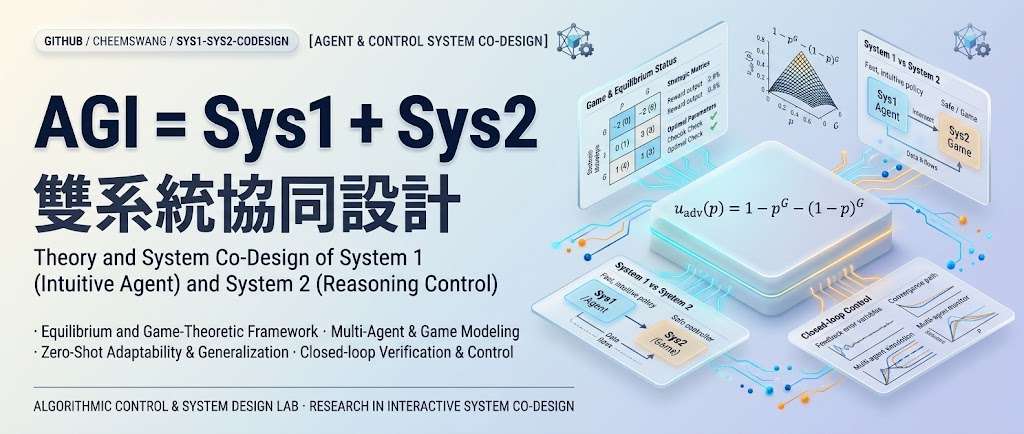
System 1+2:AGI 也要先估互動價值再花算力

多想幾步、多試幾次,都有成本。研究構想讓 AI 先估計哪些互動有價值,再投入資源執行。

Hero image preview

AI 代理搜尋資料、執行程式或讓機械人試走一步,都要付出成本,卻未必帶來有用結果。清華大學團隊提出 System-1/System-2 協同設計構想,希望在執行前先篩選值得投入的互動。

成本較低的 System-1 按預期價值排列互動的優先次序,再由成本較高的 System-2 執行較困難的工作。這個構想把資源分配提前,讓增加推理、訓練或探索次數之前,多一道價值判斷。

它涵蓋的場景包括:

  • 語言模型推理:判斷哪些推理步驟值得繼續投入。
  • AI 代理:篩選搜尋、程式執行及應用程式介面(Application Programming Interface,API)呼叫。
  • 機械人與強化學習(Reinforcement Learning,RL):優先探索可能提供學習訊號的經驗。

對互動成本高、數據取得慢的研究與開發工作,這個構想提供了分配預算的思路。不過,所提供節錄未交代價值預測器的具體實作或量化結果,仍未能判斷它能節省多少成本,以及會否錯過有用的探索。

項目主頁 · Paper

Categories: 清華大學, Agentic, 模型, 模型訓練, API, World-Action Model, Robotic, 框架, 軟件, 編程, AGI, 強化學習

Work Agents 將數碼工作拆成可驗證成果

跨應用程式完成工作,不能只看模型答得對不對;Work Agents 把代理流程、能力與可驗證成果放進同一研究脈絡。

Work Agents: Systems, Capabilities, and Optimization

當 AI 要跨應用程式完成多步工作,交付可核實、能供後續使用的成果,比單次答對更重要。Work Agents 是配合調查研究整理的開源閱讀清單,收錄數碼工作代理的系統、訓練、環境、記憶、基準與官方資源,並非可直接安裝的代理軟件。

研究以工作持續性(work persistence)和工作開放性(work openness)描述工作條件,並分成對話(Conversation)、單一步驟(Atomic Action)、多步(Multi-step)、工作流程(Workflow)及工作區(Workspace)五類。它也梳理 foundation models(基礎模型)與 runtime harnesses(執行時框架)的單獨或協同優化,評估則聚焦成果能否符合要求並供下游使用。

你可由 GitHub 清單挑選論文、基準和工具;暫未有可直接執行的代理或統一安裝、測試流程,不能當成部署指南。

  • 整理代理系統、訓練方法、環境與記憶研究
  • 涵蓋五類數碼工作及相關評測資源
  • 比較模型、執行框架及兩者的協同優化
  • 以可驗證、能供下游使用的成果作評估焦點

產品團隊和自動化流程負責人可用它整理能力缺口與評測方法。清單沒有同一環境下的性能數字,具體效果仍要回到各研究與工具核實。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港大學, 香港科技大學, 清華大學, Agentic, 模型, 模型訓練, 框架, 香港, 軟件, 工具, 庫

MT-Forcing:多輪改圖守住細節唔再走樣

連續改同一張圖時,主體、紋理與構圖往往會慢慢偏離;MT Forcing 以多輪訓練與教師引導改善這類累積錯誤。

MT Forcing teaser

連續要求「改杯色、加條紋、再調光線」時,圖片往往未到最後一輪已經失真。MT Forcing 是針對多輪圖像編輯的訓練框架,配合自迴歸擴散模型,減少每輪修改帶來的漂移。

方法把單輪 DMD(Distribution Matching Distillation)與 Teacher-Forcing Guidance 結合:學生模型逐步編輯自己生成的歷史,凍結的單輪教師則從原圖一次套用累積指示,提供分布層面的引導。參考真實編輯軌跡後,模型既要改善畫質,也要維持跨輪次內容關係。

  • 以自身多輪輸出作為訓練歷史
  • 引入單輪 DMD 改善視覺品質
  • 用 Teacher-Forcing Guidance 減少誤差累積
  • 展示最長十五輪及八輪編輯比較

官方程式碼要求 Python 3.11.13、NVIDIA CUDA GPU,以及指定 checkpoint、架構資源和擴充 U1.5 tokenizer;配置完成後,可在同一工作階段依序執行多個編輯提示。公開資料未交代完整硬件門檻、推理速度或標準化定量結果,因此較適合作為需要 NVIDIA GPU 的研究重現工具,而非直接比較成本已知的消費級服務。

它以 SenseNova-U1.5 作為相關基礎模型,並在多輪比較中加入 MT Forcing。對需要逐步修訂產品 concept、人物姿勢或場景細節的設計團隊,單輪教師可作品質參照。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 清華大學, 模型, 模型訓練, NVIDIA, Image, 影像模型, 框架, 工具, Python, Tokenize

KTP(Knowledge-Transfer-Probing) 統一多模態模型做知識轉移考核

清華與 Z.AI 團隊提出 KTP 評測協議,專門測試統一多模態模型從圖像生成學到的新知識能否透過純文字問答取出,逐步補上視覺與語言之間的知識流動缺口。

knowledge transfer probing

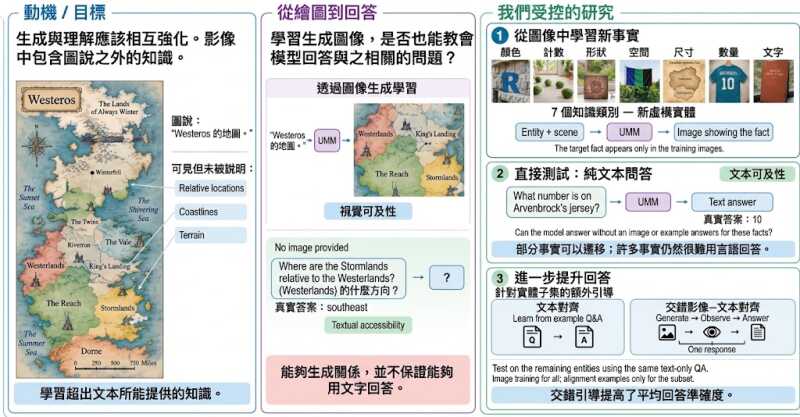
統一多模態模型(Unified Multimodal Models, UMMs)一邊做圖像生成、一邊做語言理解,但訓練時從圖像吸收的知識,一直難以量化究竟有多少真的能在純文字 QA 場景派上用場。Knowledge Transfer Probing(KTP)這個項目正正填補這個缺口:它設計了一套受控的評測協議,先以圖像生成訓練把新知識餵進模型,再以純文字問答檢驗模型能否取出。

團隊跨越七個知識類別(色彩、數量、形狀、相對空間、相對大小等),在三個 UMM 上觀察到一個關鍵現象:直接從視覺監督遷移到語言的知識,效果並不均勻,部分類別知識存取明顯偏弱。有趣的是,在部分實體上做 Textual Alignment 或 Interleaved Image-Text Alignment 對齊訓練後,模型在未對齊的其餘實體上同樣能改善知識存取,其中交錯式對齊的平均準確率比純文字對齊更高。

項目屬於研究型資料集與評測框架,隨倉庫釋出 KTP-Data(分為 train/ 與 eval/),訓練檔涵蓋文字生成圖像、文字對齊及交錯圖文對齊三類樣本,評估檔則提供文字可達性(QA 題目與參考答案)與視覺可達性(生成提示與屬性)。評分腳本只用 Python 標準庫,跑分結果會輸出 results.jsonl 與 summary.json,方便研究者直接替換自家模型回應做比較。

對正在訓練或微調 UMM 嘅團隊而言,KTP 提供一個可重現的基準去量度「圖像生成帶來多少純文字世界可用的知識」,同時指出交錯對齊是一條有實證支持的改進路徑。多模態模型研究者、訓練數據設計者,以及關心視覺-語言聯合表徵架構的人都會從中受益。

這個項目的限制同樣需要留意:KTP 目前只覆蓋七類視覺屬性,且只測試三個 UMM,並未涵蓋複雜語境或多輪推理,結論的普遍性仍有待擴充樣本驗證。

項目主頁 · GitHub

Categories: 開源, 清華大學, 模型, 多模態模型, 模型訓練, Image, 框架, Python, 庫, Dataset 數據集

SimVTA 為自動駕駛補上替代路線的視覺訓練

SimVTA 用模擬器生成不同駕駛路線的未來畫面,讓模型不只學習紀錄中的單一路徑。

From logged futures to candidate-matched supervision

自動駕駛模型需要判斷轉線、直行等替代路線,但行車紀錄通常只保留當時真正採取的路徑,其他選擇缺乏對應影像。SimVTA 屬於 driving world action model 的 post-training framework,處理的正是軌跡規劃與未來視覺監督不匹配的問題。

項目會在以 3D Gaussian Splatting(3DGS)重建的真實場景中,為候選軌跡渲染相配的未來影片,再以 Group Relative Policy Optimization(GRPO)優化軌跡,並加入 flow-matching video loss 更新共享表示。高回報候選之中,系統會優先挑選誤差較大的未來,減少有限渲染資源被低價值樣本消耗。

相較只依賴 logged trajectories 的訓練方式,SimVTA 補上了替代行動的視覺訊號;代價是需要 3D 場景重建與模擬渲染,訓練流程較複雜。推理階段則直接預測軌跡,不需再次呼叫模擬器,較適合納入自動駕駛規劃流程。

  • NAVSIM v1:PDMS 由初始化模型的 86.2 提升至 91.3
  • NAVSIM v2:取得 88.2 EPDMS
  • HUGSIM 閉環測試:平均 HD-Score 為 38.8
  • 消融結果支持共享表示更新及高誤差樣本優先策略

研究團隊包括 OpenDriveLab at HKU、Shanghai Innovation Institute、Li Auto、Tongji University 與 Tsinghua University。這個項目較適合研究自動駕駛、world action model 或模擬訓練的團隊;目前儲存庫仍標示 code 和 checkpoints 尚待發布,因此未能當作即裝即用的工具測試,重現結果仍需等待相關資源。

項目主頁 · GitHub

Categories: 開源, 香港大學, 清華大學, AI productions, 模型, 模型訓練, Video, Image, World-Action Model, 框架, 香港, 工具, 3D, 庫, 自動駕駛

Doc2Harness:測試模型能否造出真正可用的 Coding Agent

Doc2Harness 不只測模型識唔識寫程式,還把整套 Coding Agent harness 交由模型建造,再以黑盒方式驗證是否真的運作。

Doc2Harness

當 Coding Agent 要處理長時間、多步驟工作,成敗不只取決於模型本身,還取決於工具呼叫、權限、工作階段、復原流程和整個執行迴圈。Doc2Harness 是一個評測基準,專門處理模型能否按照開發文件和介面骨架,建造完整 Coding Agent harness 的問題。

項目分成兩個階段:第一階段由 build model 在隔離容器內透過 OpenCode 實作 harness;第二階段會凍結成果,再放到另一個容器,由 scripted mock model 端到端驅動。評分不接受 harness 自己聲稱完成任務,而是讀取四個可觀察渠道:傳給模型的請求、磁碟檔案、程序 exit code,以及 command output;positive controls 亦會阻止空殼實作取得通過結果。

  • 測試範圍:完整基準包含 328 個 test cases,公開儲存庫只提供 94 個 scenarios,包括 53 個評分案例和 41 個 positive controls。
  • 模型差距:完整套件涵蓋 19 個 frontier models,最佳模型通過率為 53.05%,最低約 27.4%。
  • 可重現限制:排行榜數字來自完整套件,不能只用公開子集重現。
  • 執行條件:需要 Python 3.11+、Docker,依賴採用 Python standard library;完整 catalog 在 concurrency 12 下約需 25 至 90 秒。

這項目直接把 harness engineering 本身納入評測。結果亦反映模組拆分並非必然帶來好處:在控制程式碼大小後,module count 與通過率呈負相關,相關係數為 -0.423;同一模型在 direct drive 和 permissions 等場景的排名也可能大幅變動,顯示權限及工具編排是獨立而關鍵的能力。

Doc2Harness 適合研究 Coding Agent、模型評測和 agent infrastructure 的團隊,用來比較模型建造長流程工具系統的能力,亦可協助定位 harness 在請求流程、檔案操作、程序控制或復原機制上的失敗位置。

項目主頁 · GitHub

Categories: 開源, 北京大學, 清華大學, Agentic, 模型, Vibe Coding, 工具, Python, 庫, 編程, Anthropic, Dataset 數據集

GroundingPI 以 4B 視覺基礎模型連接感知與機械控制

GroundingPI 把視覺定位轉成可供機械系統使用的點和框,主打複雜場景下的精準感知與控制效率。

GroundingPI

要讓自動駕駛或機械人準確知道「要處理哪件物件、位置在哪裏」,單靠一般視覺語言模型仍可能在雜亂畫面和細小物件上失準。GroundingPI 屬於視覺 grounding foundation model,以 4B 參數模型處理定位問題,輸出可供後續控制使用的視覺結構。

模型以 visual primitives 為核心,將點和框表示成 shared vocabulary 中的 quantized coordinates,再配合 vision-language model、tokenizer、processor 和 custom model code。這種做法針對 VLA(vision-language-action)及 WAM(world-action models)常見的感知瓶頸,並讓 perceptual foundation 可以轉移到 autonomous driving 和 robotic manipulation。

  • 定位方式:同時支援點與框,適合指定目標及描述空間位置。
  • 模型規模:4B 參數,目標是在能力與運算成本之間取得平衡。
  • 評測結果:涵蓋 34 個 grounding benchmarks、11 種感知能力,對比 44 個基準模型平均達 73.68%,高於 GPT-6 Astra 的 71.54%。
  • 轉移價值:在 ID 和 OOD 評估,以及 action-data efficiency 方面,展示對自動駕駛和機械人操作的幫助。

對研究團隊而言,GroundingPI 不只是單次定位模型,亦可作為 System-1 foundation-model 的感知層,補足未必擅長精準 grounding 的通用視覺模型。項目提供 Hugging Face 模型及 Demo,並列出 vLLM、Transformers backend、OpenAI-compatible API 和 JSONL batch annotation 工作流;不過提供的儲存庫資料未交代完整硬件需求,部署前仍需按文件確認環境。

研究重點同時放在 pretraining scale 和 data composition 如何影響 grounding 及轉移效果。需要即時視覺定位、閉環控制或希望減少 action data 的自動駕駛、機械人及 embodied AI 團隊,會較容易從這個模型的感知能力受益;純文字或一般影像分類工作則未必能直接發揮其價值。

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 香港科技大學, 北京大學, 清華大學, 模型, 視覺模型, 多模態模型, 模型訓練, API, Image, VLA, World-Action Model, Robotic, 香港, 庫, Tokenize

[技術文章] HARNESSSQL 讓 SQL 代理在真實資料庫中學習

SQL 代理不再只需一次生成查詢,而是在可執行資料庫內探索、修正錯誤並完成任務。

Hero image preview

面對陌生資料庫,SQL 代理往往要先查看 schema、檢查欄位和值,再執行試探查詢、分析錯誤,最後修訂並提交 SQL。HARNESSSQL(Harness-Native Training for SQL Agents in Realistic Database Environments)是一套面向這類互動流程的後訓練框架,針對模型訓練只學習「問題直接對應查詢」、但推理時才加入執行工具的落差作出修正。

傳統 Text-to-SQL 通常把資料庫視為靜態提示內容,難以涵蓋長時間、多回合的探索。HARNESSSQL 建立隔離且可執行的資料庫環境,配合隱藏的 execution oracles,讓教師模型直接在目標 SQL harness 內完成互動,並只保留經驗證的操作軌跡進行 full-sequence SFT,之後再以 execution reward 進行 RL。

項目的核心做法包括:
• 將 schema 檢查、工具呼叫、查詢執行及錯誤修正納入訓練流程
• 以 sandbox 控制資料庫狀態,保存結果與錯誤回饋
• 只使用可驗證的成功軌跡,減少錯誤示範干擾
• 讓模型適應 Spider 2.0-SQLite 的互動式任務

在 Spider 2.0-SQLite 上,Qwen3-8B 的 execution accuracy 由 15.5% 升至 45.2%,Qwen3-14B 則由 22.2% 升至 54.8%;訓練所得能力亦能轉移至 BIRD-Interact 和 LiveSQLBench。結果反映,資料庫代理要處理複雜工作流,訓練階段同步保留執行 harness,比只在推理階段補上工具更能縮小訓練與使用環境的差距。

Paper

Categories: 開源, 香港科技大學, 清華大學, Agentic, 模型, 模型訓練, Qwen, 微軟, 框架, 香港, 工具, 庫, 強化學習

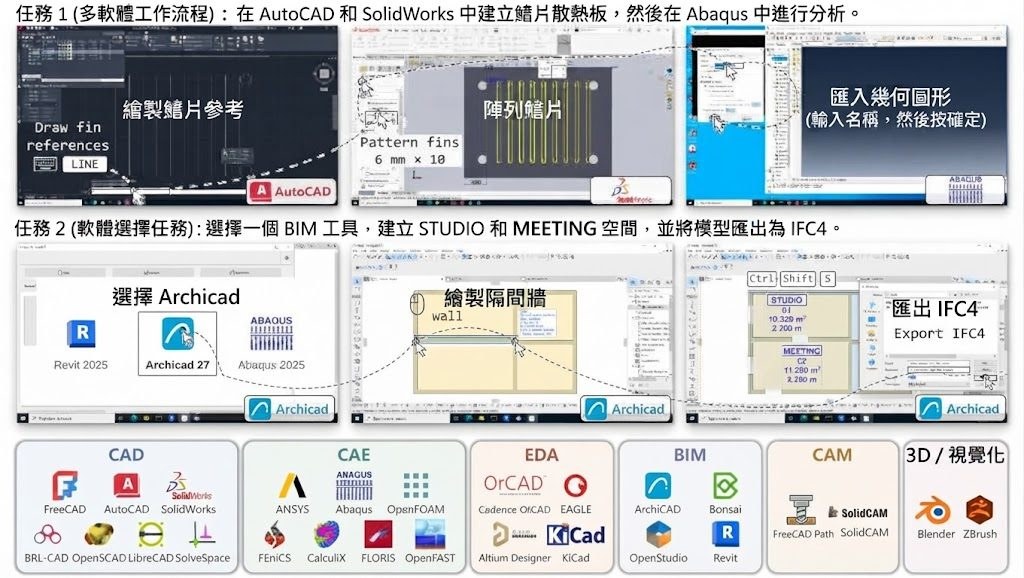
EngiWorld 把工程代理接入真實軟件工作流

EngiWorld 不只測試代理人能否操作介面,更檢查它能否交付合乎工程規範的成果。

EngiWorld task examples and engineering software coverage

代理人要在 CAD、CAE、CAM、BIM、EDA 和 3D 視覺化軟件中完成工作,難點不只是點擊按鈕,而是要維持幾何、物理條件及跨軟件流程的正確性。EngiWorld 屬於工程代理人評測基準,實際處理的是「能否由指令一路產出可驗證工程成果」這個問題。

項目收錄 1,301 個專家編寫任務,涵蓋 26 個軟件平台、6 個工程領域及 6 類任務,支援 GUI 和 CLI。評測會檢查最終及中間工程文件的幾何有效性、物理可行性和規則符合度,數值設計任務亦會按規格達成程度連續計分,而非只分成功或失敗。

  • 提供完整任務、驗證器及 GUI/CLI 評測執行環境
  • 主實驗採用 300 個任務,清單位於 task/splits/main-300.txt
  • 本地環境以 Linux、Docker 及虛擬機器執行,預設每個環境使用 4 個 CPU 和 16 GB RAM
  • 七個前沿模型中,最高 EngiScore 只有 44.3;多軟件嘗試成功率為 3.6%

同類 Computer-use agents 評測多集中於一般桌面操作,EngiWorld 把判斷標準推到可交付的工程 artifact,因此更能揭示模型在長流程、跨軟件依賴及專業規範上的不足。代價是執行門檻較高:需要 x86_64 Linux、Python 3.10、Docker Engine 和環境映像,沒有 /dev/kvm 時亦可運行,但軟件模擬會較慢。

研究團隊、工程軟件開發商,以及想比較 GUI agent、CLI agent 或多模態模型能力的團隊,都可以用它重現測試並保存評測結果。它目前更適合作為嚴格的研究及模型比較工具,而非即插即用的生產自動化方案;最高分數與多軟件成功率反映,代理人距離穩定完成專業工程流程仍有明顯距離。

項目主頁 · GitHub

Categories: 開源, 北京大學, 清華大學, Agentic, 模型, 多模態模型, 軟件, 工具, 3D, Python, Dataset 數據集

Page 1 of 7
1 2 3 … 7