DeepSeek 為 Agent 和 RAG 補上即時資料來源

DeepSeek Search 與 Fetch API 將網頁搜尋與單頁抓取整合成兩個 API,為 Agent 和 RAG 應用補上即時資料來源。

Og image

當 Agent 或 RAG 應用需要查找最新網頁資料,單靠模型內置知識往往不夠。DeepSeek API 現已提供 Search 與 Fetch 兩個原始 JSON API,讓應用程式可以搜尋網頁,再按需要讀取指定頁面的內容。

Search API 由 DeepSeek 自研搜索引擎支援,會按 query 返回結構化結果,包括標題、網址及摘要;將 need_content 設為 true,則可一併取得網頁正文。Fetch API 則針對單一網址抓取內容,並以 Markdown 文本返回,方便後續交給模型處理。

搜尋條件可透過 site:、lang:、after:、before: 及精確短語等語法收窄範圍,也能排除指定網站或關鍵詞。count 可設定返回 1 至 50 筆結果,ori_question 則可補充使用者原始問題,協助系統理解搜尋意圖。

• 適合建立需要即時資料的 Agent 與 RAG 工作流
• Search 用於找資料,Fetch 用於讀取指定頁面
• 支援中文及多語言搜尋條件
• 兩個 API 均使用 Bearer API Key 鑑權
• 搜尋沒有匹配結果時會返回空陣列

兩個接口共用 https://api.deepseek.com Base URL,分別對應 /v1/tools/search 與 /v1/tools/fetch。開發者需要自行處理 API 呼叫、結果篩選及網頁內容交給模型前的整理,文件目前提供 cURL 和 Python requests 範例,適合直接接入現有資料問答流程。
項目主頁

Categories: Agentic, RAG, DeepSeek, API, 軟件, Python

Google Foresight:會議筆記與個人資料留在 Mac

Foresight 在 Mac 本地聆聽會議、整理筆記,亦能按你的檔案即時回答問題。

開會時只需記下零碎提示,Google AI Edge Foresight 便可配合本機轉錄內容整理成較完整的會議筆記。工具支援 Google Meet、Zoom,以及面對面或離線對話,音訊和文字都在 Mac 處理,不必上傳雲端。

Foresight 亦能連接本地項目資料夾、Google Drive、參考文件、圖表、網頁連結和日曆,建立與工作相關的背景資料。對話期間,它可透過聊天檢索內容;Live Assistance 更會聆聽問題,在相關資料出現時主動顯示附有引用來源的 context cards,減少會議前準備和反覆確認資料的時間。

技術核心包括 740M 參數的 EmbeddingGemma 2。這個 on-device multimodal embedding model 會把文字、圖片、影片和音訊映射到同一向量空間,支援跨模態語意檢索;配合 Gemma 4,可在裝置上建立即時的 Retrieval-Augmented Generation(RAG)流程,避免網絡延遲。

  • 會議轉錄、音訊與檔案留在 Mac
  • 支援影片會議、面對面及離線對話
  • 可把速記提示整理成完整筆記
  • 支援跨文字、圖片、影片和音訊檢索
  • 具備聊天及 Live Assistance 兩種取用資料方式

頁面提供 macOS 下載入口。需要高度重視資料私隱、又經常在多個本地檔案之間切換的人,較容易感受到這種本機 AI 工作流的便利。

項目主頁

Categories: AI productions, RAG, Embedding, 多模態模型, Google, Gemini, Video, Image, Audio, 工具, Mac

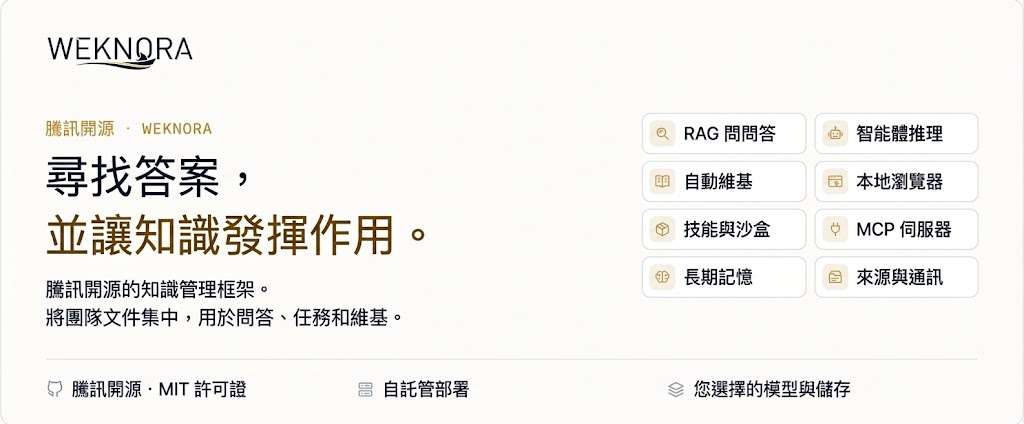
WeKnora 把企業知識庫變成可問、可做、可追溯的 AI

WeKnora 將 RAG、Agent 與 Wiki 放進同一個知識庫,兼顧企業資料整合、任務執行和私有化部署。

WeKnora: find the answers, and put knowledge to work. Tencent

不只可以問文件內容,WeKnora 會幫你用 AI 操作工具、整理 Wiki,並保留已確認的偏好與事實。WeKnora 是一個開源 LLM 知識框架,處理企業文件理解、語意檢索與多步推理;RAG、Agent 和 Wiki 共用同一套知識庫,減少資料分散造成的落差。

RAG 會結合語意及關鍵字檢索,回答附上原文引用;Agent 可搜尋網頁、呼叫 MCP 工具、執行技能,並在沙箱中處理檔案。Wiki 則把文件整理成互相連結的頁面與知識圖譜,支援編輯、差異比較和版本回滾,適合需要持續維護內部知識的團隊。

  • 支援 PDF、Word、圖片、Excel、XMind 等十多種格式
  • 可同步飛書、Confluence、GitLab、Notion、語雀、RSS 等來源
  • 透過企業微信、飛書、Slack、Telegram、MCP Server 或 API 提供服務
  • 具備多空間 RBAC、審計日誌、任務佇列及 Langfuse 追蹤

模型、向量資料庫及儲存後端都可以替換,內置 29 家模型供應商,包括 OpenAI、DeepSeek、Qwen、Gemini、MiniMax、LiteLLM 和 Ollama。v0.8.2 加入本機瀏覽器操作、MCP Server、對話分叉與回滾,令知識庫不再只負責回答問題,也能參與任務流程。

Docker、Kubernetes、Helm、Lite 單機版及桌面應用都在支援範圍內,資料可以留在本地或私有雲。對重視資料留存、內部協作和可追溯性的企業,這套整合度具備明確吸引力。

項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, RAG, MCP, Qwen, OpenAI, DeepSeek, Gemini, Image, 框架, KnowledgeGraph, Ollama, 庫, Anthropic, MiniMax, Skill 技能

CANOPY 讓多模態 RAG 按證據壓縮上下文

CANOPY 會在文字、表格及影片內逐區域保留證據,減少干擾內容,同時避免剪走理解所需的上下文。

Og image

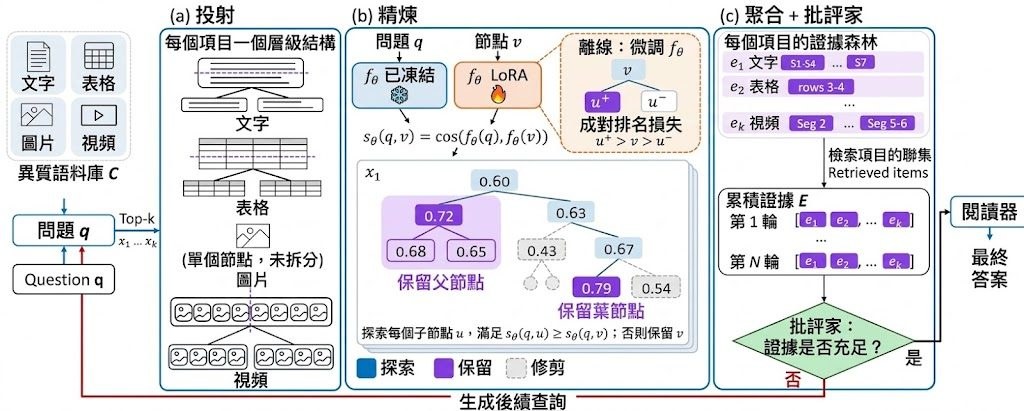
面對一段很長的文章、一張表格或一段影片,問題通常只需要其中一小部分證據,但過度保留會浪費讀者的上下文,剪得太細又可能失去理解線索。CANOPY(Canonical Projection over Hierarchy)是 POSTECH 提出的多模態 RAG 後檢索證據壓縮框架,按項目內不同區域決定保留範圍。

CANOPY 會把每個檢索項目整理成層級結構,再以經 gold evidence 微調的 node encoder,按照查詢評分不同區域。系統會比較子區域與父區域的相關程度,保留句子、表格列、關聯文字或影片片段等合適粒度,而非為整個項目套用單一截取規則。

保留的證據不足以回答問題時,critic 會要求針對性追加檢索;新找回的項目同樣先經壓縮,再加入讀者輸入,減少無關內容反覆累積。這個設計亦處理了壓縮本身無法補回「從未檢索到的證據」這項限制。

  • 在五個 QA benchmark、包含 3,300 萬個異質項目的語料庫上,平均答案準確率高於參與比較的檢索基線。
  • 消融結果顯示,多跳問答的準確率提升主要來自追加檢索。
  • 在未經路由的 Qwen3-VL-8B-Instruct 讀者設定中,證據 token 輸入量減少 14.2% 至 27.7%。
  • 壓縮後答案準確率保持相若,適合需要同時處理文字、表格及影片的 RAG 工作流。

CANOPY 的價值不在於單純縮短檢索結果,而在於讓每個項目內的保留範圍跟隨證據位置及上下文需要變化。它仍受初始檢索品質限制,但對多跳查詢和長內容閱讀,可在保留可解釋線索的同時降低 reader 的輸入負擔。

項目主頁

Categories: AI productions, RAG, 多模態模型, Qwen, Video, 框架, 庫, Dataset 數據集

Gricea:把 AI 研究變成可重用的開放工作流

Gricea讓研究團隊設計、執行及分析人機對話實驗,並保留可重用的研究脈絡。

image

研究人員測試 AI 對信任、偏見或使用習慣的影響時,往往要自行處理分支流程、隨機分組、對話介面與事件記錄。Gricea提供一個開放平台,讓團隊在同一套工作流內設計受控的 Conversational AI 研究、收集互動資料,並比較不同研究設計。Gricea 就是把這整套東西做成一個可運行、可分享的研究實驗。

用一個例子說明,假設你想研究:「廣東話 AI 客服,用 GPT 類模型還是本地模型,使用者會覺得較有幫助?」

你通常要自己做很多東西:
-做一個受試者能使用的聊天網頁
-設定 chatbot 用哪個模型、system prompt、知識庫與工具
-把受試者隨機分兩組:A 組用模型 A,B 組用模型 B
-安排任務,例如「請 AI 幫你處理退貨」
-收集聊天紀錄、完成時間、滿意度問卷
-確保別人日後可以用同一個流程再做一次

平台以可編輯的視覺流程建立器編排研究,支援 within-subject 和 between-subject 設計、隨機化、條件分支及邏輯控制。研究人員亦可加入 LLM 聊天介面、bias manipulation、RAG-based context retrieval 和 streaming responses,觀察模型設定或對話脈絡改變後,參與者行為如何變化。

• 記錄訊息、點擊及其他行為事件
• 連結參與者路徑、回應、replay 和研究層級分析
• 以 consent 版本管理、遮罩 replay,限制研究資料存取

Gricea 同時提供參與者管理、資料分析、研究分享及公開研究瀏覽功能,公開項目可以作為其他研究的模板。研究團隊可研究「奉承式 AI 如何改變信任」等問題,也可比較 RAG 介面、對話風格或教育問卷設計;平台的價值在於保留完整 study artifact,方便其他人檢視、修改及重新部署。對需要可重現流程、細緻互動記錄和社群協作的 Conversational AI 研究尤其合適,但資料貢獻仍涉及私隱及同意範圍,研究團隊需要自行界定收集與分享的界線。

項目主頁 · Paper

Categories: Agentic, RAG

WeMM-Embedding:對齊文字、圖片、影片的多模態檢索

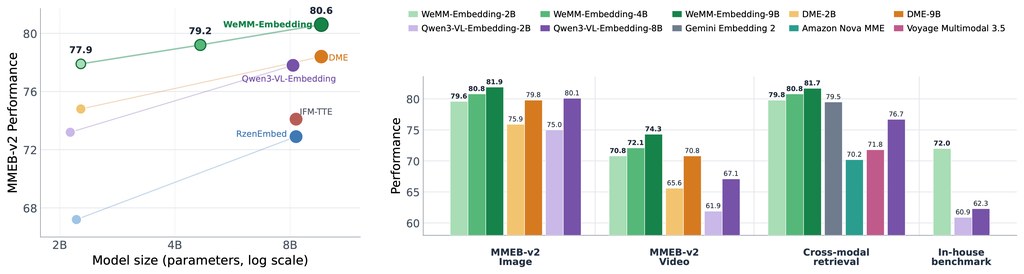
騰訊微信視覺團隊把文字、圖片、影片、視覺文件等多種輸入收進同一個嵌入空間,推出涵蓋 2B/4B/9B 三個尺寸的 WeMM-Embedding 系列,主打檢索與多模態理解一條龍。

WeMM-Embedding Performance Overview

把文字、圖片、短影片、文件截圖一次過丟進同一個嵌入空間做檢索,一直是多模態團隊頭痛的工程難題。WeMM-Embedding 系列由騰訊微信視覺團隊開源,正是針對這個場景而來:三個規模(2B/4B/9B)都用同一套介面,輸出可直接比對的向量,免卻多模型串接的麻煩。

向量從模型最後一層的 <embedding> token 位置取出,再做 L2 正規化,方便直接接入既有向量資料庫。對想做跨模態檢索或 RAG 的團隊而言,這類統一模型比起同時維護 CLIP 系、BGE 系、影片模型幾套 pipeline,部署成本明顯較低。

官方推薦 transformers==5.2.0 以保證預處理一致性,亦支援 SentenceTransformer 直接載入 Hugging Face 模型 ID。比較有彈性的是 Matryoshka Representation Learning(MRL):例如 9B 版本支援 64 到 4096 多段維度,開發階段可以用低維度快速迭代,再逐步切到高維度;2B 與 4B 版同樣提供 64 至 2048 左右的選項。已驗證 vLLM 0.27.0 與 SGLang 0.5.9 兩套推理引擎,兩者都以 pooling runner 啟動,搭配專屬的 chat template 即可提供 embedding 服務。

與同類開源嵌入模型相比,WeMM-Embedding 強調「影片與視覺文件也在同一個向量空間」,而不是只覆蓋到圖文。短影片摘要、PDF 截圖理解、社交媒體(X Demo)多模態內容推薦等場景,會比純圖文模型更貼地。音訊輸入目前不在支援範圍內,是規劃時要留意的限制。受惠對象包括做多模態 RAG、跨模態檢索、商品搜尋及內容審核的中小團隊,因為他們通常缺乏同時訓練多個專門模型的資源。

重點:

  • 統一嵌入空間:文字、圖片、影片、視覺文件、交錯輸入共用同一向量表示,免除多模型串接。
  • 三種規模:2B、4B、9B 同步開源,可在準確度與成本之間靈活取捨。
  • Matryoshka 維度彈性:支援 64 至 4096 多段可選維度,平衡儲存與效果。
  • 生態友善:兼容 transformers、SentenceTransformer,並已驗證 vLLM 與 SGLang 部署。
  • 目前限制:音訊輸入未支援,預處理對 Transformers 版本敏感,需固定在 5.2.0。

GitHub · 模型

Categories: 開源, 騰訊, AI productions, RAG, Embedding, 模型, Video, Image, Dataset 數據集

MobileMem 把手機長期記憶放入真實場景測試

手機助手要記住一年的生活,難點不只是搜尋資料,更要理解跨應用、跨模態的長期脈絡。

logo

手機助手若要回答「女兒七歲生日有哪些照片」或核對過敏藥物,單靠短對話記憶很快會失準。MobileMem 屬於端側長期記憶(on-device long-term memory)的評測框架與資料集,將一年手機經歷整理成可重現的測試環境,檢驗記憶系統能否跨應用保留、連結及找回重要資訊。

它涵蓋 365 天、12 個應用程式,以及每位使用者平均 1.72M tokens 的資料規模,來源包括對話、日曆、筆記、瀏覽紀錄和相片等異質內容。與只測單輪問答或獨立文件檢索的做法相比,MobileMem 更接近長期使用情境,但同時令資料整理、隱私處理和推理成本變得更複雜。

資料分為兩條 benchmark track:text 供文字記憶系統處理長期對話與結構化 mobile-app events;omni 則加入 screenshots 和 photos,測試多模態記憶。它本身不是模型,而是用來比較不同 memory systems、分析失敗原因及建立 leaderboard 的測試基礎。

  • 支援文字與多模態兩類測試
  • 涵蓋跨應用、長期且知識密集的 mobile agent trajectories
  • 可從 HuggingFace 下載資料集
  • Dataset Explorer branch 提供互動式資料瀏覽
  • 現有資訊未列出具體模型分數,需查看 leaderboard 或自行重跑測試

研究人員可先下載 HuggingFace 資料集,按 text 或 omni 軌道接入自己的記憶模型,再利用網站和 Dataset Explorer 檢查案例。適合開發 mobile agents、personalized assistant、長期 RAG 或 multimodal memory 的團隊;涉及健康紀錄、家庭相片等私人內容時,仍要自行確認資料授權、匿名化和端側部署要求。

項目主頁 · GitHub

Categories: 開源, Agentic, RAG, 多模態模型, Medical醫學, 中國, Dataset 數據集

MiniMax-H3-Text-Embeddings ?

這不是傳統 NLP 或 RAG 領域中所指的「文本向量嵌入(Text Embedding)」模型。

Og image

這不是傳統 NLP 或 RAG 領域中所指的「文本向量嵌入(Text Embedding)」模型。MiniMax-H3-Text-Embeddings 實際上是 DiffSynth-Studio 團隊為 MiniMax-H3 影片生成大模型所設計的「視覺特效/風格控制向量(Diffusion Templates / Textual Inversion)」。

MiniMax-H3 是一個高達 33B 參數的大型多模態生成模型,若要透過訓練 LoRA 來控制風格或特效,顯存與算力成本非常高。DiffSynth-Studio 團隊採用了類似 Textual Inversion(文字翻轉/概念嵌入) 的做法:

  1. 極輕量替代方案:將特定特效(如火爆、風暴、環繞鏡頭等)預先訓練或編碼成特徵 Tensor。
  2. 直接注入文字特徵層:這些檔案體積非常小,能在推理階段直接替換或疊加到 MiniMax-H3 的 Text Encoder 輸出上。
  3. 模組化與組合:使用者可以像掛載外掛一樣,組合多個特效 Embedding 來控制生成的影片視覺效果。

3. 總結建議

  • 如果你是在找 RAG / 知識庫 / 搜尋用的文本嵌入模型:請忽略此模型,這不是向量檢索工具。
  • 如果你是在使用 DiffSynth-Studio 進行 MiniMax-H3 影片生成:這是用來快速套用影片特效、節省顯存並替代重型 LoRA 的控制模組。

項目主頁

Categories: 開源, RAG, Embedding, 視頻模型, MiniMax

NanoVDR:70M 文字編碼器取代 2B VLM:視覺文檔檢索的輕量化新嘗試

NanoVDR 把 2B 參數嘅視覺語言模型蒸餾成 69–151M 嘅純文字編碼器,查詢時完全唔需要視覺模型,CPU 51 毫秒即可完成。

NanoVDR

處理幾十萬張文件圖片嘅時候,每次查詢都要過一次 2B 嘅視覺語言模型(VLM),開銷大到令人卻步。NanoVDR 想解決嘅就係呢個落差:文件索引由教師模型離線建好,查詢階段只用一個 DistilBERT 規模嘅純文字編碼器,CPU 上 51 毫秒出結果,2048 維嘅單一向量直接做點積,扔得入 FAISS。

佢嘅做法係將 Qwen3-VL-Embedding-2B 凍結做教師,提早把目標向量快取落嚟,學生只係學一個餘弦距離嘅 loss——即係 loss = 1 - cos(student, teacher)。訓練時冇相關性標註、冇負例採樣,兩邊完全解耦,所以查詢端同索引端可以分開換組合。DistilVDR 進一步把文件端都換走,做到成個流程都唔再需要教師。

對於做企業 RAG、法律文件搜尋、學術庫檢索嘅團隊,最大吸引力係每頁索引得 4 KB,比 ColPali 嗰類多向量檢索慳 64 倍儲存,而且唔使 GPU 即可頂住查詢負載。ViDoRe v1 上面,NanoVDR-S-Multi 拎到 82.2 NDCG@5,保留咗教師大約 95% 嘅能力,呢個取捨對批量部署嚟講好實際。

重點摘要:

  • 極輕量查詢端:文字編碼器僅 69–151M 參數,無需視覺模型參與查詢
  • 高效索引:每頁僅 4 KB(float16),比多向量方案節省約 64 倍儲存
  • 簡易整合:輸出為單一向量,FAISS 即可處理,無需 MaxSim 池化
  • 教師-學生解耦:目標向量預先快取,兩端可獨立訓練與組合
  • 完整資源:模型、訓練數據集、線上 Demo 同論文均已開源

多向量查詢塔嘅程式碼已就位,但 checkpoint 要等 NanoVDR-v2 先出齊,想要更高召回嘅人需要留意後續更新。

項目主頁 · GitHub

Categories: 開源, RAG, Embedding, 模型, 視覺模型, 多模態模型, Qwen

UEmbed:單一模型同時做稠密與稀疏檢索

UEmbed 把文字、圖片、影片都放進同一套 embedding 流程,令稠密向量與稀疏詞彙向量可以一併輸出。對要做多模態搜尋或檢索增強生成的團隊,這種設計可減少來回切換模型。

Repository image for Alibaba-NLP/UEmbed

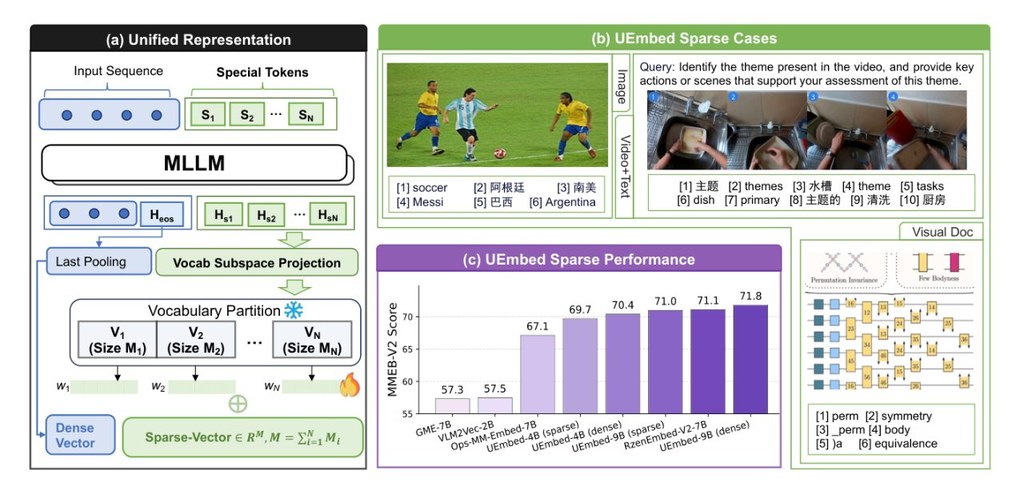
UEmbed 把文字、圖片、影片都放進同一套 embedding 流程,它走的是多模態 embedding 模型路線,重點是把 dense 向量和 SPLADE-style sparse lexical 向量放在同一個 causal forward pass 內處理,方便直接做檢索、多模態搜尋和 visual-document retrieval。它不是只做文字匹配,而是把文字、圖片、影片與混合輸入統一到同一套表示空間。

直接取用 Hugging Face 上的 2B、4B、9B 權重,再按輸入格式送入不同媒體內容,檢查 dense 與 sparse 輸出是否符合預期。若要部署到搜尋系統,dense 部分可接向量檢索,sparse 部分可接倒排索引,兩條路可以同時保留。

它和傳統 learned sparse retriever 最大分別,在於保留 decoder-only multimodal backbone,並用 16 個 learnable special tokens 分攤稀疏詞彙空間,避開單一 token 的表達瓶頸。訓練時同時優化 dense InfoNCE、sparse InfoNCE 和 FLOPS regularization,取捨是結構較巧,但推理時可以用同一個模型兼顧語義召回與詞彙可解釋性。

效能方面,UEmbed-9B 在 MMEB-v2 取得 71.8(dense)與 71.0(sparse),並在公開數據訓練條件下做出很強的稀疏檢索表現;在 BEIR 上亦保持競爭力。對做搜尋、RAG、跨媒體內容索引,或者要把文字與圖像一齊納入檢索的團隊,這套做法會較有吸引力。

  • 同一個模型同時輸出 dense 與 sparse 表示
  • 支援文字、圖片、影片與混合輸入
  • 稀疏輸出可直接對接倒排索引,較易解釋
  • 以 Qwen3.5 multimodal backbone 為基礎,並用公開資料訓練
  • 2B、4B、9B 三個規模可選

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, RAG, Embedding, 模型, 多模態模型, Qwen, Image

Page 1 of 5
1 2 3 … 5