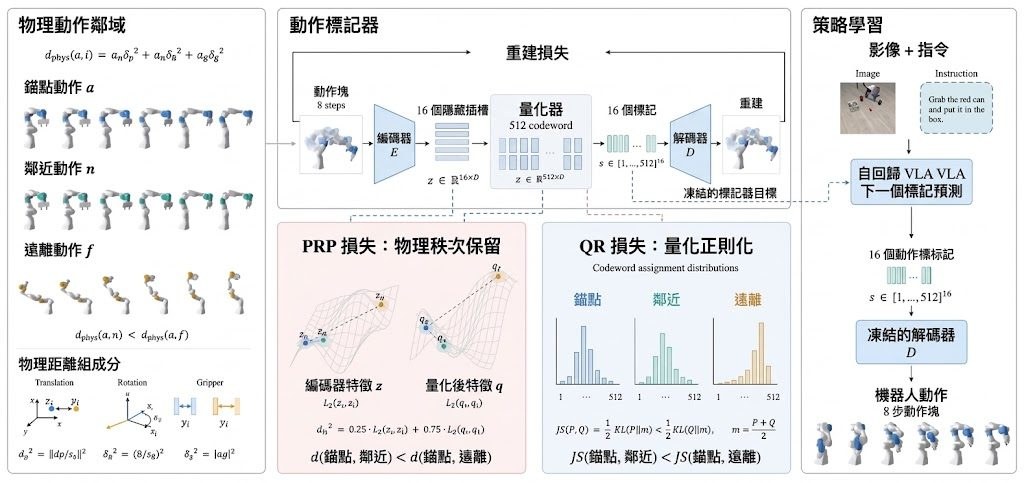
當自回歸視覺語言動作模型(VLA)把機械人動作切成離散 token 再一個個吐出來,最大的隱性成本往往不是單一動作的誤差,而是相鄰動作之間的物理距離被打亂。ActionPiece 正是針對這個卡位設計:它把動作切成一塊八步的短序列,每塊壓成 16 個離散 token,並要求 tokenizer 不只重建動作,還要保留「物理排序一致性」(physical rank consistency, PRC)。換句話,兩個本來很接近的動作,編碼後的距離也要維持接近;兩個本來很遠的動作,編碼後也要維持較遠。這種監督讓 token 表徵本身帶有物理結構,而不是純粹的重建損失。
在 Libero、Libero-Plus、SimplerEnv 與 VLA-Arena 四組基準上,ActionPiece 配合 Qwen3-VL-4B 作為策略骨幹,跑出 94.8%、68.8%、71.9%,以及 VLA-Arena L0 至 L2 平均 51.5% 的成功率。Libero-Plus 的訓練刻意排除其示範數據,因此這項成績更能反映遷移表現,而不是單純記住示範。從結果可以看到,重建保真度與 PRC 之間並非完全等價:有些 tokenizer 重建得很好,但鄰近關係一塌糊塗,部署成功率也跟著掉。ActionPiece 把「物理排序保留」與「碼字分配的量化正則化」綁在一起訓練,正好同時壓住這兩個問題。
這個項目的實際意義,是給正在做 VLA 研究的團隊一個可直接替換的動作 tokenizer,無需重寫策略架構。對關注 SimplerEnv 真實遙操作或 VLA-Arena 跨平台泛化的工程師來說,這類保留物理關係的分詞方式,會比純重建式 tokenizer 更貼近控制任務的需求。PhysBrain 1.5 也採用了 ActionPiece 作為動作 tokenizer,顯示它已不只在論文層面,而是走進實際模型發佈。
要真正評估它,比較合理的做法是把它接進自己的 VLA 流程,比對換 tokenizer 前後的策略成功率與 PRC;單看 Libero 94.8% 容易被低估,因為重建誤差小的 tokenizer 不一定保留鄰近結構。原始程式碼與 PhysBrain 1.5 的權重將在官方頁面釋出,想搶先試的人可以先讀論文並鎖定後續更新。