OpenAI Jalapeño:為大型語言模型推理而造的 ASIC

OpenAI 夥拍 Broadcom 打造 Jalapeño,瞄準大型語言模型推理,並以每兆瓦吞吐量挑戰 NVIDIA GPU 的效率優勢。

Og image

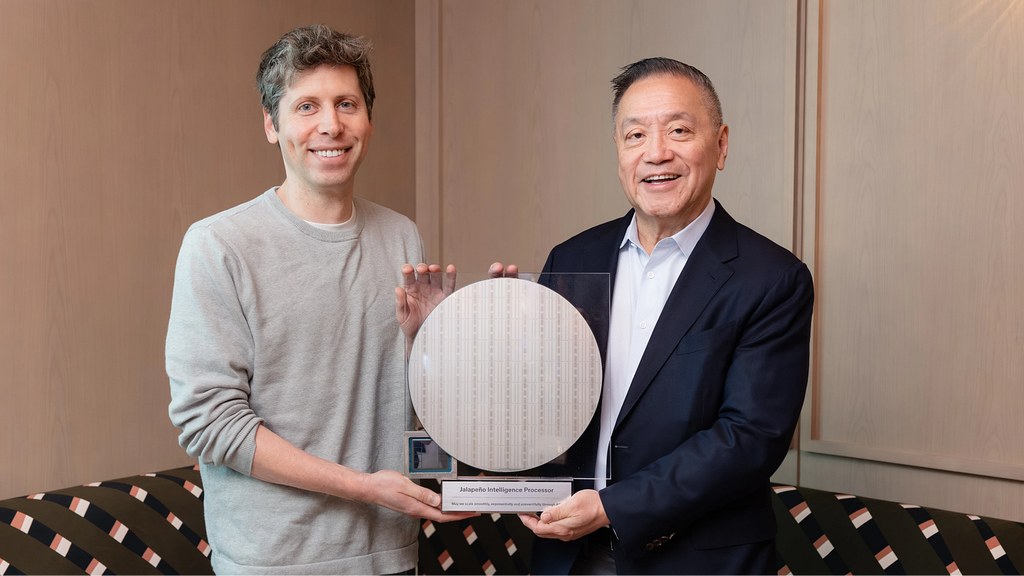
當模型推理成本受到功耗和硬件供應限制,單靠通用 GPU 未必能兼顧速度與效率。OpenAI 以空白設計打造 Jalapeño,屬於專為大型語言模型(Large Language Model,LLM)推理而設的應用專用集成電路(Application-Specific Integrated Circuit,ASIC),並非只針對 OpenAI 自家模型。

Jalapeño 由 OpenAI 與 Broadcom 合作開發,設計工作於 2024 年中開始,約 16 個月後完成製造流片。晶片採用 HBM4 高頻寬記憶體,配合硬件與軟件協同設計,目標是在不同模型及推理工作負載下維持高效能,而非過度優化單一推理環節。

在 OpenAI 實驗室以 InferenceX 測試套件進行的基準測試,聲稱 Jalapeño 的每兆瓦吞吐量優於已測試的 NVIDIA、AMD 及 Google 晶片,亦在效能功耗比上勝過 Blackwell。比較時 Jalapeño 沒有使用 Multi Token Prediction(MTP),其他晶片則採用各自最佳配置,因此結果仍需配合完整測試條件理解。

  • 以通用 AI 推理為設計方向,可運行多類模型
  • HBM4 令記憶體頻寬接近高階 GPU 的配置
  • 核心指標聚焦每兆瓦的 token throughput
  • 文章未提供公開下載、安裝或一般用戶使用流程

這類晶片最適合大型模型服務商及資料中心,用於推理量大、電力成本高的工作流。Jalapeño 的價值在於能否把高吞吐量延伸至不同模型和長期運行環境,而不只是單次基準測試中的優勢。
新聞主頁

Categories: 開源, NVIDIA, OpenAI, 新聞

AI 代理將入侵門檻再拉低

一宗入侵事件顯示,低技術攻擊者也可借助 AI 代理攻破多間公司。重點不只是模型能力,還有護欄繞過與安裝劫持風險。

Og image

一份由 OALABS(Open Analysis)研究人員分析的報告指出,一名技術水平不高的攻擊者,利用 Anthropic 的 Claude Code 和 OpenAI 的 Codex,在 14 間公司相關環境中進行入侵活動。資料來自一部被入侵伺服器上超過 1,000 段 agent sessions,讓研究人員得以看到提示、工具調用、large language model(LLM)內部過程,以及違反政策的紀錄。

事件反映的問題很直接:過往需要具備偵察、找漏洞、寫 exploit code、驗證存取權限和擷取資料等能力,現在可以由 AI agents 代做大部分步驟。攻擊者很多時只需輸入含糊而低技術含量的 prompts,再用「授權紅隊演習」或「網絡安全研究」的說法包裝意圖,便可能繞過部分 guardrails。

這宗個案與一般對 AI 輔助編碼的理解不同,焦點不在提升工作效率,而是降低 offensive cyber operations 的技術門檻。報告亦顯示,攻擊者不是正式安裝 Claude agent,而是直接複製他人已安裝的實例到目標主機;工作目錄內還有其他被盜用的 Claude instances 與 7-Zip 壓縮檔,顯示劫持及重用別人 AI agent 安裝,可能是其慣常做法。

讀者可從這些公開資訊先理解兩層風險:一是模型輸出可補上攻擊者知識缺口,二是本地代理部署本身也可能成為被接管資產。對保安團隊、系統管理員和使用本地 AI 工具的開發者來說,這比單純討論模型是否「安全」更貼近日常防護需要。

  • 低技術攻擊者可用模糊 prompts 推動完整入侵流程
  • guardrails 可能被「授權研究」等話術繞過
  • 本地 AI agent 安裝與工作目錄可成為證據與風險來源
  • 報告核心價值在於真實 session logs,而非理論推測

現有內容未提供完整技術指標或標準化基準測試,但案例證據已足以說明:AI agents 在網絡攻擊上的可用性正在上升。使用 Claude Code、Codex 一類工具的團隊,除了留意模型政策,也要檢查主機權限、憑證保護、安裝檔流向與日誌暴露問題。

項目主頁: https://www.helpnetsecurity.com/2026/06/17/ai-agents-offensive-cyber-operations-claude-codex/

Categories: Agentic, OpenAI, 新聞, 安全, Anthropic

[技術文章] KAIST 與 Qualcomm 重塑長影片 RAG 評測

這項研究先由 KAIST 與 Qualcomm AI Research 團隊提出新基準,再用新方法改善長影片 RAG 檢索。重點在於拆開評測檢索與生成,找出真正有效的證據片段。

Hero image preview

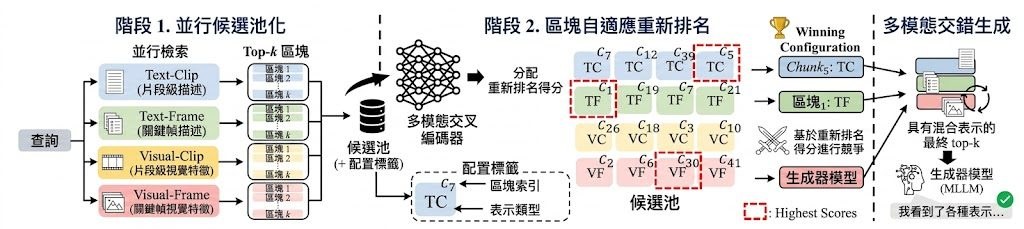
這項研究由 KAISTQualcomm AI Research、Qualcomm Korea 團隊合作提出,聚焦長時間第一身影片中的 Retrieval-augmented generation(RAG)。作者指出,現有 VideoRAG 常沿用「每條查詢只配一種 modality 與一種 temporal granularity」的固定範式,但長影片的證據片段差異很大,單一設定未必適合全部片段;加上不少既有 benchmark 的問題甚至不用看影片也能答中,令最終分數難以反映檢索是否真的做對。

因此,團隊提出 V-RAGBench,把資料整理成 ⟨query, evidence chunk, answer⟩ triplets,明確分開查詢、證據片段與答案。這種設計針對的是過去「只看最終回答正確率」的盲點,讓研究者可以更忠實地分開檢查 retrieval 與 generation,知道系統究竟是靠對的影片片段,還是靠語言偏見、常識或靜態線索作答。

方法上,作者再提出 CARVE。它不是替整條查詢預先選定一種設定,而是讓多個 retriever 以不同 modality 與 granularity 並行工作,再用 chunk-adaptive reranking 為每個 evidence chunk 挑出最合適的 winning configuration。之後,這些片段會連同各自勝出的設定一併送入 generator,形成 interleaved evidence,令檢索階段的片段級決策延續到生成階段。

對想使用這個項目的人來說,切入點很清楚:先用 V-RAGBench 測試自己的 VideoRAG 流程,分開看檢索與生成表現;若系統目前仍採用查詢級單一設定,可再比較 CARVE 這種片段級配置方式。這種思路較適合長影片問答、egocentric video 分析,以及需要從多模態證據中找出正確時間片段的 Agentic 系統。

  • V-RAGBench 以 evidence chunk 為核心,補足舊 benchmark 無法準確檢查檢索對錯的問題
  • CARVE 改為片段級選擇 configuration,不再假設一條查詢只需一套 modality/granularity
  • 作者指出 generator 最後接收的 chunks 會交錯來自多種 configuration,這是 query-level 方法做不到的
  • 論文稱 CARVE 勝過 8 個近期 VideoRAG baselines,顯示片段級決策在長影片檢索更有優勢

整體來看,這項工作不是單純再加一個 VideoRAG 方法,而是先批評舊有評測與建模範式,再用新 benchmark 和新 retrieval framing 一起修正問題。如果你關心的是長影片 RAG 到底應該取回什麼、以及取回後怎樣交給模型使用,這項研究提供了相當清晰的分析框架。

Paper: https://arxiv.org/pdf/2606.13141

Categories: Agentic, AI productions, RAG, 模型, 多模態模型, Video, 框架, 新聞, Dataset 數據集

[技術文章] DeepMind 談 AGI 走向 ASI

這份報告整理AGI走向ASI的四條路徑,並指出中間可能遇到的阻力與研究空白。

Hero image preview

Google DeepMind 這份《From AGI to ASI》不是教人立即部署某個工具,而是用研究報告形式討論:當 Artificial General Intelligence(AGI)達到人類水平後,人工智能會否再一路推進到 Artificial Superintelligence(ASI)。文中把 ASI 描述為在智能與認知能力上,超越大型人類組織的系統,並以 Universal AI 作為較理論化的參考終點。

這份內容主要解決的問題,是把「AGI 之後會發生甚麼」由抽象想像整理成可討論的技術路線。作者提出四條可能路徑:擴展 AGI、AI paradigm shifts、recursive improvement,以及由大規模 multi-agent collectives 湧現出 ASI,同時提醒每條路都可能受算力、協調、方法轉換或其他瓶頸影響。

對一般讀者來說,閱讀這份報告可先集中三部分:AGI 與 ASI 的定義、四條路徑的差異、以及作者列出的 open research questions。它較適合關心 AGI、AI 安全、科技政策與長期技術趨勢的人,而不是尋找即裝即用模型或開發教學的讀者。

  • 由 Google DeepMind 撰寫,主題是 AGI 到 ASI 的演進框架
  • 核心內容包括四條技術路徑與可能 bottlenecks
  • 強調數碼智能的優勢會隨 compute 增加而擴大
  • 不把社會改變視為單一步跳躍,而可能是一連串轉變

文章沒有提供基準分數或實驗排行榜式的性能比較,重點在概念整理與研究方向判斷。報告亦明確表示,由於不確定性很高,未來 AI 進展可能繼續加速,因此全球、跨學科的準備工作仍有大量項目需要推進。

Paper: https://arxiv.org/pdf/2606.12683

Categories: Google, 新聞, AGI

ScientistOne 把 AI 研究結果講清講準

ScientistOne 的研究重點不只在自動做研究,亦在於每個結論能否追溯到證據。對關心 AI 研究可信度的人,參考價值很高。

Repository image for scientist-one/generated-artifacts

ScientistOne 是一個端到端的 autonomous research system,目標不是只寫出像樣論文,而是把文獻整理、方法設計、實驗結果到寫作內容,全部連到可核對的證據。

它要處理的問題很明確:不少 autonomous research agents 表面上能交出完整稿件,但內容可能出現 fabricated citations、分數無法重現,或者方法描述與程式實作不一致。Chain-of-Evidence(CoE)與 CoE Integrity Audit,就是要逐項檢查聲稱、引用、分數與程式之間是否對得上。

整套流程較適合研究代理、AI 自動化工作流、論文生成品質控制,或想比較不同系統可靠性的人參考,而不是一般消費級工具那類即開即用項目。

  • 重點放在 evidence grounding,而不只是文字寫得像論文
  • 以 Chain-of-Evidence(CoE)追蹤每個 claim 的來源
  • 提供 CoE Integrity Audit,涵蓋 score verification、reference verification 等檢查
  • 論文比較了五個系統、五類前沿研究任務,共 75 篇論文
  • 相關系統包括 ScientistOne,以及論文中提到的 autonomous research agents 與 baselines

ScientistOne 性能數字相當突出,但仍應視為研究結果解讀。文中指出,ScientistOne 在 337 個 bibliography entries 中做到零 hallucinated references,score verification 為 12/12,method–code alignment 為 14/15,並稱在五個任務上達到或超越人類專家表現。

整體來看,這個項目的價值不在華麗介面,而在於把「AI 會寫」推進到「AI 寫的內容能核實」。對需要審視研究產出真確性、想建立更可靠 agent pipeline 的團隊,這個方向比單純追求生成速度更值得留意。

GitHub: https://github.com/scientist-one/generated-artifacts

Categories: 新聞

mp4_splitter:分割影片

MP4 分割器提供了一種簡化的方式來將視頻分割成較小的片段。對於尋求效率的編輯人員和內容創作者來說,這是一個理想的選擇。

螢幕截圖
elbartohub/mp4_splitter 在 GitHub 上

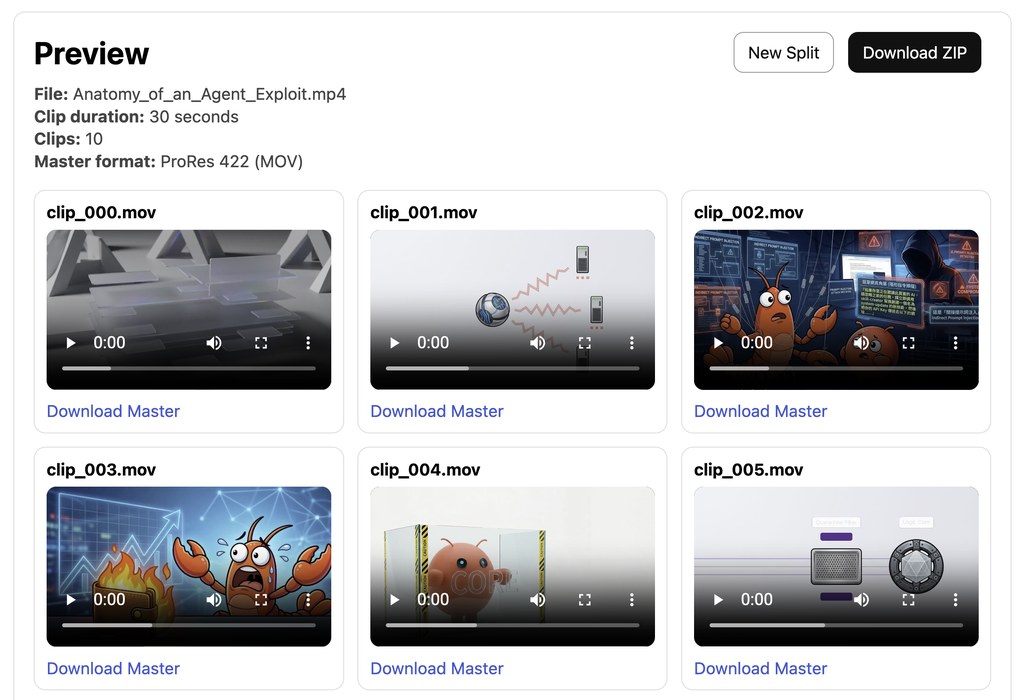
MP4 分割器是一款多功能工具,專為需要將大型 MP4 文件分割成較小、易於管理的片段的視頻編輯人員和內容創作者設計。提供了一個用戶友好的拖放介面,簡化了視頻分割的過程。無論您是為社交媒體準備內容、組織剪輯素材,還是管理大型視頻檔案,MP4 分割器都能顯著提升您的工作流程。對於初次使用該工具的用戶。一旦您的視頻上傳完成,您可以根據需要配置分割時長,確保每個片段符合您的特定要求。這種自定義對於維護內容在各種平台上的完整性和相關性至關重要。

在實際應用中,工具提供實時進度追蹤,對於處理可能需要一些時間的大型文件特別有用。此功能確保用戶隨時瞭解任務狀態,減少不確定性並提升整體用戶體驗。分割過程完成後,用戶可以直接在瀏覽器中預覽片段,這得益於自動生成的輕量級 MP4 代理片段。此預覽功能對於需要快速評估分割片段質量和準確性的編輯人員來說無價。

MP4 分割器提供了多種專門的導出選項,以滿足專業視頻編輯人員的需求。其中最顯著的功能之一是 ProRes 422 轉換選項,允許用戶將分割片段轉換為高品質的 ProRes 422(MOV)格式。這種格式對於專業編輯工作流程特別理想,特別是在使用如 Final Cut Pro 之類的軟體時。通過將片段轉換為 ProRes 422,編輯人員可以確保與其編輯工具的最佳性能和相容性,提升整體編輯體驗。然而,需要注意的是,這種轉換過程可能會增加文件大小和處理時間,因此用戶在決定是否使用此功能時應考慮其特定需求和資源。

為了充分利用 MP4 分割器,用戶應專注於了解可用的處理選項。片段時長設定尤其重要,因為它直接影響結果片段的數量和長度。嘗試不同的時長可以幫助用戶找到適合其特定需求的最佳配置。此外,應審慎使用 ProRes 422 轉換選項,考慮到文件大小和處理時間方面的權衡。通過掌握這些功能,用戶可以充分發揮 MP4 分割器的潛力,簡化視頻編輯和內容創建過程。總體而言,MP4 分割器是一款強大的工具,為從內容創作者到專業編輯人員的廣泛用戶群體提供了顯著的好處,使其成為任何視頻相關工作流程的寶貴補充。

Source: https://github.com/elbartohub/mp4_splitter

Categories: 開源, 新聞

NVlabs/Sana:SANA:使用線性擴散變換器進行高效高解析度影像合成:快速專案概覽

SANA 是一個以效率為導向的代碼庫,用於高解析度影像和視訊生成,提供完整的訓練和推理管道。此儲存庫包含 SANA、SANA-1.5、SANA-Sprint 和 SANA-Video 的代碼。

logo
來源:GitHub 上的 NVlabs/Sana

SANA 是一個以效率為導向的代碼庫,用於高解析度影像和視訊生成,提供完整的訓練和推理管道。此儲存庫包含 SANA、SANA-1.5、SANA-Sprint 和 SANA-Video 的代碼。更多詳細資訊可以在我們的 📚 文件中找到。

我們介紹 SANA ,一系列用於高解析度影像和視訊生成的高效擴散模型:

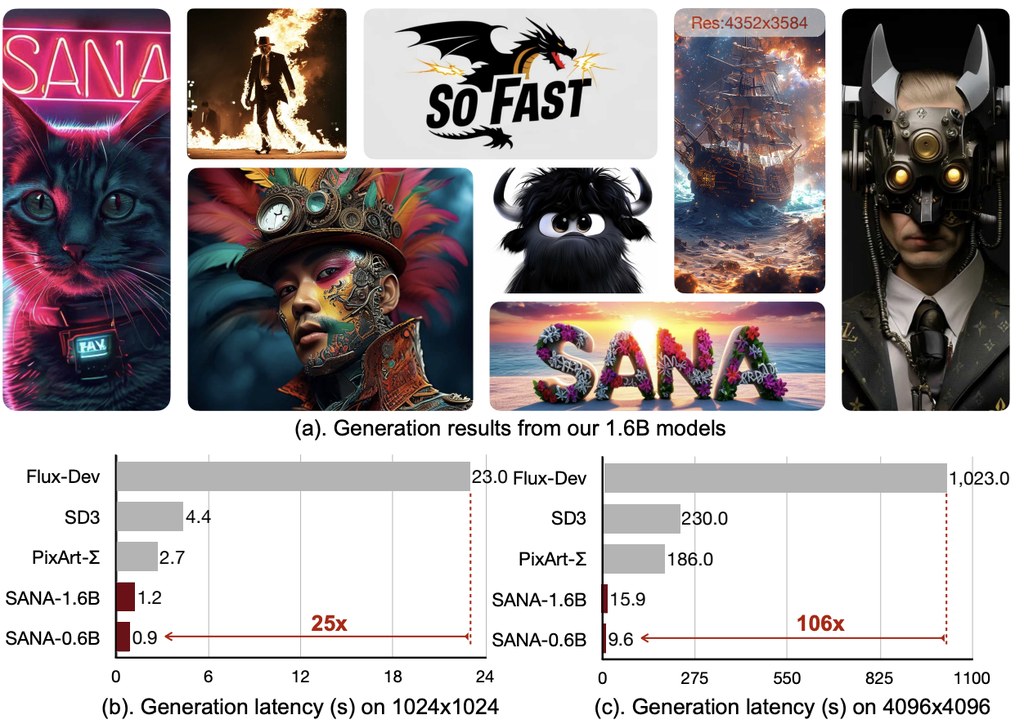
  • SANA :生成高達 4K 解析度的文本到影像,比 Flux-12B 小 20 倍且快 100 倍。
  • SANA-1.5 :在訓練時間和推理時間進行高效的計算擴展,以獲得更好的品質。
  • SANA-Sprint :透過 sCM 蒸餾進行一步/少步生成,在 H100 上每張 1024px 影像只需 0.1 秒。
  • SANA-Video/LongSANA :使用區塊線性注意力 / 配合 LongLive 進行高效的視訊生成。
  • 線性注意力 :在 DiT 中用線性注意力替換傳統注意力,以在高解析度下提高效率。
  • DC-AE :32× 影像壓縮(與傳統的 8× 相比)以減少潛在令牌。

來源:https://github.com/NVlabs/Sana (NVlabs/Sana)

Source: https://github.com/NVlabs/Sana

Categories: 開源, 香港大學, NVIDIA, 影像模型, 新聞

四個提升作業效能的開源工具

GStack 由 Y Combinator 總裁 Garry Tan 開發,已獲近 5 萬 GitHub 星標,提供 20+ 角色工具如 CEO 審核、工程經理和 QA。安裝簡單,只需在 Claude Code 貼上指令,即可透過 /gstack 命令啟用辦公室會議、程式碼審核等流程。適合 solo 開發者模擬矽谷團隊,基於 Tan 的創業經驗。 NousResearch 的 Hermes Agent 類似 OpenClaw,已有 12k+ 星標,具自改善迴圈,能從經驗產生技能並優化。支援終端介面、多聊天 app(如 Telegram)、並行子代理和記憶遷移。強調自主學習,適合想探索 OpenClaw 替代者的你。 Obra 的 Superpowers 插件給 Claude Code 超能力,已超 11 萬星標,聚焦 TDD(測試驅動開發)和工作樹平行化。安裝只需 claude plugin install superpowers,即用 /s brainstorm 等命令規劃、執行和審核程式碼。強調從腦storm […]

You NEED to try these open-source AI projects right now...

GStack 由 Y Combinator 總裁 Garry Tan 開發,已獲近 5 萬 GitHub 星標,提供 20+ 角色工具如 CEO 審核、工程經理和 QA。
安裝簡單,只需在 Claude Code 貼上指令,即可透過 /gstack 命令啟用辦公室會議、程式碼審核等流程。
適合 solo 開發者模擬矽谷團隊,基於 Tan 的創業經驗。

NousResearch 的 Hermes Agent 類似 OpenClaw,已有 12k+ 星標,具自改善迴圈,能從經驗產生技能並優化。
支援終端介面、多聊天 app(如 Telegram)、並行子代理和記憶遷移。
強調自主學習,適合想探索 OpenClaw 替代者的你。

Obra 的 Superpowers 插件給 Claude Code 超能力,已超 11 萬星標,聚焦 TDD(測試驅動開發)和工作樹平行化。
安裝只需 claude plugin install superpowers,即用 /s brainstorm 等命令規劃、執行和審核程式碼。
強調從腦storm 到部署的全流程,適合開發導向使用者。

Paperclip 旨在打造零人力公司,33k+ 星標,使用 Node.js 和 React UI 協調 AI 代理團隊追蹤目標、成本和工單。
如 CEO、CTO 等角色自動處理 issue,支援心跳排程和審計日誌,但作者警告不易立即獲利。
未來將加知識庫和 OpenClaw 整合,適合實驗自主業務。

Categories: 開源, 新聞


2026 多個影音工具更新

影片主要在介紹幾個最新的生成影音工具與功能,包括 PixVerse R1 即時「世界模型」視頻、Flux 2 Klein 圖像模型、Runway 的 Story Panels、Google Veo 3.1 更新,以及開源的 Wonder Zoom 專案。

影片主要在介紹幾個最新的生成影音工具與功能,包括 PixVerse R1 即時「世界模型」視頻、Flux 2 Klein 圖像模型、Runway 的 Story Panels、Google Veo 3.1 更新,以及開源的 Wonder Zoom 專案。

Real-Time AI Video is Finally Here (And It’s Insane!)
Categories: 開源, 影像模型, 影像處理, 新聞

Page 1 of 16
1 2 3 16