WorldSonus 為影片補上可互動立體聲音

WorldSonus 將影片動態、文字指令和立體聲音同步起來,讓世界模型生成的畫面不再只有無聲場景。

WorldSonus architecture

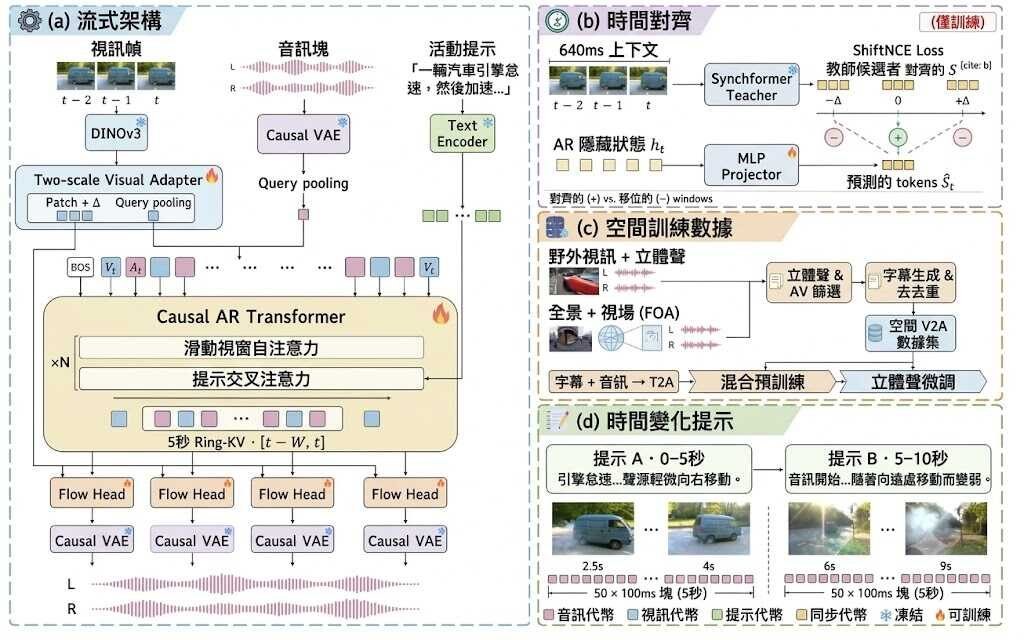
影片中的腳步、流水和列車聲可以隨畫面變化,甚至在生成途中接受新的文字指令。WorldSonus 是一個影片轉音訊模型,處理世界模型和互動影片缺少同步聲音的問題,並以每 100 毫秒一段的方式生成 48 kHz 立體聲。

它採用 streaming causal autoregressive diffusion 架構,讓影片畫面經過兩種時間尺度的視覺 token 後,交由 AR transformer 和 rectified-flow head 生成音訊。生成模型、audio decoder、normalization statistics,以及凍結的 DINOv3 和 T5Gemma 2 視覺/文字編碼器分工合作;文字提示可在 chunk 邊界更新,同時保留聲音連續性。

• 支援離線生成和 streaming generation,兩者使用同一條三幀生成路徑
• Visual temporal differences、Ring-KV 歷史狀態和 causal decoder convolution states 會跨 chunk 保留
• 可用影片加提示詞控制聲音,也可只用影片作條件
• 輸出為 stereo 48 kHz 音訊,片段長度會按 100 毫秒 chunk 向下取整

研究結果給出的 real-time factor (RTF) 是 0.41,並在開放領域 video-to-audio benchmark 中達到或超越部分雙向模型的聲學質素和空間對齊表現。不過參考實作沒有承諾固定延遲,模型和編碼器亦要在串流開始前載入,不能直接把 RTF 當成使用者必然取得的端到端延遲。

測試需要 Python 3.10 或以上、支援 CUDA 的 GPU、FFmpeg 和 ffprobe,GPU 驅動程式要預先安裝;設定程序會安裝 CUDA 12.4 的 PyTorch wheels。模型權重和編碼器可從 Hugging Face 下載,適合研究世界模型、影片生成、互動模擬或需要空間聲音的內容製作團隊,但硬件要求和上游模型的授權/存取條件仍需先核對。
項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, AI productions, 模型, 世界模型, NVIDIA, Gemini, Video, Audio, 提示詞, 香港, Python, Dataset 數據集

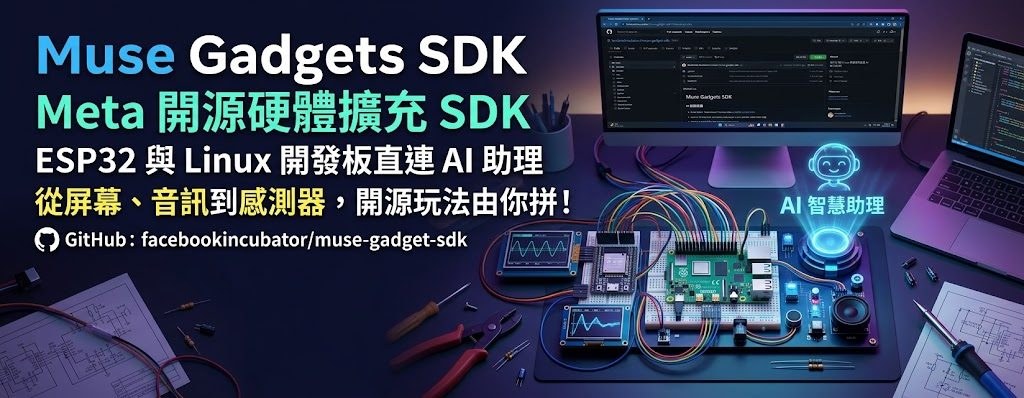
Meta 開源 Muse Gadgets SDK:把 ESP32 與樹莓派變成 AI 配件

Meta 把 Muse 的硬體擴充 SDK 放到 GitHub,讓你手邊的 ESP32 與 Linux 開發板直接接駁 AI 助理。從屏幕、音訊到感測器,開源玩法交給社群自己拼。

Muse gadgets: a Waveshare round AMOLED, an M5Stack StickS3, Muse Home Link, a Raspberry Pi and a Seeed reTerminal e-ink

想讓家裏的 ESP32 或樹莓派直接跟 AI 助理對話嗎?Meta 旗下 facebookincubator 開源的 Muse Gadgets SDK,正是針對這種「自製 AI 配件」場景而設的開發工具包。項目分為 ESP32 與 Linux 兩條主線,分別對應 MicroPython 級別的微控制器,以及樹莓派或一般 Linux 單板電腦,開發者可以按自己手邊的硬件選擇對應 SDK。

每塊板配對 Muse 應用前需要先在 gadgets.muse.ai 申請 SDK token,並開啟 App 內的 Developer mode,掃描「MuseGadget」前綴的裝置即可連線。ESP32 路線主打屏幕顯示、I/O 音訊與各類感測器,Linux 路線則偏向讓 Muse 處理 Home Assistant 自動化或系統管理指令,等於把語音助理變成 Home Lab 的遙控器。

項目定位屬於「工具+框架」混合體,核心價值是降低自製硬件的門檻,但要求開發者有一定焊接與刷機經驗,因為 README 已經明言副作用包括「bricked boards」、保養失效甚至電壓跌落。相對於坊間封閉式智能家居配件,它勝在完全開源並允許自定義指令,但又需要自備 token 與相容硬件,部署成本不低。

硬件玩家、Home Assistant 玩家,以及想用 AI 助理串連感測器或自製機械按鈕的開發者,最容易從中受惠。每個子目錄都附上 README.md 與供 AI 編程助手如 Muse Code 使用的 AGENTS.md,社群則集中在 Discord 交流改機心得。

項目重點摘要

  • 支援 ESP32 與 Linux(樹莓派)兩條開發路線,各自獨立 SDK
  • 配對 Muse App 需先申請 SDK token 並開啟 Developer mode
  • 涵蓋顯示、音訊、感測器、Home Assistant 自動化等多種擴充方向
  • 程式以 Apache 2.0 開源,第三方組件如 minimp3 保留上游 CC0-1.0 許可
  • 社群交流集中在 Discord,文件內附 AGENTS.md 方便 AI 編程助手介入

項目主頁 · GitHub

Categories: 開源, Agentic, API, Audio, 框架, Discord, Linux, 編程, 語音, Meta

Prism 令 2K 影音生成訓練加速 2.5 倍

Prism 將影片畫面與聲音互動納入稀疏注意力,令原生 2K 影音生成模型訓練更快,並兼顧生成質素。

model architecture

高解像度影音生成最難處理的地方,是畫面 token 大增後,Full Attention 需要付出平方級計算成本,聲音與畫面之間的有效互動亦容易被大量冗餘資訊沖淡。Prism 屬於 Dynamic Sparse Attention 框架,專門處理原生 2K Joint Video-Audio Generation Model Training,目標是減少訓練成本而不犧牲影音同步與細節。

Prism 將影片 token 按時空位置整理成 macro-zones,再利用影片特徵的 channel variance,以及 audio-to-video cross-attention 的 feature norm,判斷每個區域的畫面變化和聲音影響程度。變化較快或影音耦合較強的位置會採用更細的 block 分割,並透過 hybrid block selection 為不同 query 動態決定稀疏範圍,令每個 block 保留較一致的語義內容。

[Fudan&Tencent Hunyuan] Prism: Dynamic Sparse Attention for Native 2K Joint Video-Audio Training

同 Full Attention 相比,Prism 不再對所有 token 進行密集互相關注;同時,它亦不是單純套用只為推理加速而設的稀疏注意力。這個取捨針對聯合影音資料的結構作出調整,代價是訓練流程需要額外計算區域資訊和動態選擇,實作複雜度會高於標準注意力。

項目提供 Project Page、Hugging Face 模型和示範影片,可先透過合成結果、模型比較、消融研究及解析度擴展示範理解效果。提供的資料未列出完整本地安裝指令或硬件要求,因此暫時較適合研究團隊按論文與模型資源自行整理環境,而不是即時套用到一般影音工具。

  • 訓練速度較 Full Attention 提升 2.5 倍
  • 生成質素據報超越 Full Attention
  • 同時考慮視覺變化與 audio-visual coupling
  • 面向原生 2K 影音生成模型訓練

Prism 對需要訓練高解像度文字轉影片及同步聲音模型的研究團隊較有價值,尤其適合計算資源昂貴、影音互動集中於局部區域的工作。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, AI productions, 模型, 多模態模型, 模型訓練, Google, NVIDIA, Video, Audio, 框架, 工具, 語音

Kandinsky 6.0 把同步聲畫生成帶入開源模型

Kandinsky 6.0 可由文字或圖片生成帶同步音效、口形的短片,並提供 3B 與 29B 兩款模型。

promo

由文字或圖片輸入,到畫面、音效和口形同步輸出的流程,Kandinsky 6.0 將短片生成由單純影像延伸至完整 audio-video 內容。這個項目屬於開源多模態視頻模型,實際處理的是聲音與畫面難以同步、創作者需要分開製作素材的問題。

Kandinsky 6.0 Video Lite 有 3B 參數,Kandinsky 6.0 Video Pro 則有 29B 參數,兩者都能生成 5 秒片段、44 kHz 音訊及 lip-sync,支援 text-to-audio-video(T2AV)和 image-to-audio-video(TI2AV)。額外的 super-resolution 模型可把輸出提升至 Full-HD 1920×1080,但這並不代表原生生成階段已經以 Full-HD 運作。

• 同一生成流程處理視頻、音效和口形同步
• Lite 較適合資源有限的測試,Pro 追求更高生成能力
• 支援文字生成及圖片延伸兩種模式
• 可透過 Hugging Face Space、Diffusers、ComfyUI 或 vLLM-omni 接入

測試需要 NVIDIA GPU,以及 Python 3.13 或 3.14;首次執行會下載 Kandinsky-6.0-Pro-distill-5s 權重,輸出會寫入項目指定的 MP4 路徑。對不想自行配置環境的創作者,Hugging Face Space 是較直接的試用入口;需要納入工作流的團隊則可考慮 Diffusers 或 ComfyUI。

在非精簡版顯示卡上處理 5 秒影片片段的工作時間(秒)。不包括負載載入和 MP4 編碼時間。 RTX PRO 6000 (96 GB)、A100 80 GB 和 H100 80 GB 使用模組卸載。消費級顯示卡使用區塊卸載。 RTX 4090、RTX 5060 Ti、RTX 5080、RTX 5090、RTX PRO 6000 和 A100 80 GB 使用 SageAttention2++ 進行視覺自註意力控制。 H100 使用 FlashAttention 3。

RTX 4090RTX 5060 TiRTX 5080RTX 5090RTX PRO 6000A100 80 GBH100
Lite SD4371310577309242532239
Lite HD4221328579296274472203
Lite Full HD5781774770406387664284
Pro SD93630801336754621972356
Pro HD119427161189638561791292
Pro Full HD1247353015468547651106402

Kandinsky 6.0 適合製作概念片、角色對白及需要同步聲畫的短內容,但 5 秒時長、NVIDIA GPU 依賴,以及高解像度要靠額外模型處理,仍限制了它作為長片生產工具的角色。

項目主頁 · GitHub · 模型

Categories: 開源, ComfyUI, 模型, 多模態模型, 視頻模型, NVIDIA, Video, Image, 影像處理, Audio, 工具, Content Creator, Python, Dataset 數據集

HelixWorld 即時生成互動視聽世界

輸入一張圖片和提示詞,再用方向指令探索場景,HelixWorld 會同步更新畫面與空間聲音。預覽版已提供瀏覽器示範及離線推理程式碼,但硬件門檻不低。

HelixWorld — Sound and vision, born together

轉身時,聲音方向也會跟着視角改變,這是 HelixWorld 與一般先生成畫面、再配上音軌的做法不同之處。它是 Noiz AI 開發的即時互動視聽世界模型,讓使用者從一張圖片和提示詞出發,以方向指令在生成場景中移動,並同步產生影像與聲音。

瀏覽器示範適合先感受互動效果;想離線測試,則可使用已公開的 Preview v1 推理程式碼和預覽模型。它目前支援 Linux、Python 3.11 和 CUDA 12.x,建議使用配備 80 GB VRAM 的 NVIDIA GPU;BF16 單卡測試約需 70 GB VRAM,對個人電腦使用者而言是明顯門檻。

操作時可輸入前進、轉向或停止等動作,並設定第一人稱視角及生成影格數;提示詞亦可分別描述影片、音訊或視聽內容。輸出會整理成 MP4,適合研究人員、互動內容創作者及想探索空間音效生成的團隊測試,但目前公開資訊未提供性能評測數據,亦未公開完整模型與訓練資料。

  • 畫面和聲音會隨鏡頭移動同步更新,空間聲場跟隨視點改變。
  • 可先用瀏覽器示範體驗,也可在符合硬件條件的 Linux 系統離線推理。
  • 預覽版已開放,完整模型、訓練資訊及報告仍待公開。

HelixWorld 展示了視聽生成從固定片段走向可操控場景的一種做法;不過,現階段的高顯示記憶體需求和有限評測資訊,令它較適合研究與原型測試。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, NVIDIA, Video, Image, Audio, 提示詞, Content Creator, Linux, Python

mg-styles-15:AI 寫出 15 種動態設計短片

Claude Opus 5.5 以程式碼生成畫面、動畫、音樂與音效,並公開提示詞和完整源碼。

The showcase page: the Frame-by-Frame film next to its style notes, with the prompt open below

由一段提示詞開始,Claude Opus 5.5 便能寫出 15 支各具風格的 10 秒動態設計短片,連畫面、動畫、配樂和音效都由程式碼生成。這個開源項目同時提供成片、風格說明、完整提示詞和源碼,實際解決的是把視覺創意轉成可重現瀏覽器渲染流程的問題。

每支片本質上是一個能按時間繪製畫面的網頁,以背景執行 Chrome 逐幀截圖,再由 ffmpeg 合成影片和音軌;3D 作品則額外使用 Blender。使用者需要 Node、Chrome 和 ffmpeg,複製指定提示詞後可修改故事、品牌、配色、尺寸和時長,亦可用 rubric.md 交由另一個 AI 評審再迭代。

• 15 種風格,涵蓋逐格動畫、等距 2.5D、像素藝術、液態動態及 9:16 字幕作品
• 畫面每次重新生成未必相同,原作經過多輪修訂,單次執行通常達不到相同完成度
• 音效腳本具確定性,但只有 4 支能在指定環境精確重現原音軌,其餘 11 支可能因數值庫版本而有差異
• 字體未隨倉庫提供,缺少指定字體會令文字造型與原片不同

對內容創作者、動態設計師和想研究 AI 輔助編程的人,這個項目更像可拆解的製作案例,而不是按掣即出的成品工具。它把創意、提示詞、瀏覽器渲染和聲音合成放在同一條可閱讀的流程內,方便比較不同風格如何透過程式結構呈現;代價是需要自行處理環境、字體和多輪修訂。

項目主頁 · GitHub

Categories: 開源, AI productions, Video, Audio, 提示詞, 工具, Content Creator, 3D, 庫, 編程, Anthropic, 動畫, 音樂

DMAD:MiniMax-H3 影片生成壓縮至四步

DMAD 將 MiniMax-H3 的 50 步生成流程壓縮至 4 步,兼顧 1344×768 影片與原生立體聲音輸出。

Videos generated by the 4-step DMAD student of MiniMax-H3 (video only; every clip also has generated audio)

由 50 步縮至 4 步,DMAD 讓 MiniMax-H3-33B 可以更快完成文字轉音訊影片生成,同時保留 1344×768 影片及原生立體聲音。這項目屬於模型蒸餾與推理工具,實際處理的是高質素生成與推理速度之間的取捨。

項目提供兩個 rank 128 的 LoRA,每個約 1.4GB,分別是論文使用的 lora critic,以及在 AVGen-Bench 取得較高分數的 full critic。它們都掛載於 H3 transformer,將 50 步 teacher 轉成四步 student;DMAD 以兩個 discriminator head 分辨真實資料、teacher 樣本與 student 樣本,直接學習 log-density ratio,省卻 DMD 所需的輔助 diffusion model。

  • 4 步生成 1344×768 影片及立體聲音
  • 提供 lora critic 與 full critic 兩個版本
  • 支援獨立推理程式及 Diffusers pipeline
  • 方法以 adversarial distillation 取代額外 score fitting

MiniMax-H3 與 rCM 的人類偏好比較為 84.6%,但 AVGen-Bench 只明確指出 full critic 分數較高,未提供具體差距;選擇模型時仍應按畫面質素、聲畫同步及硬件成本自行測試。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 多模態模型, 模型訓練, NVIDIA, Video, Image, Audio, 工具, MiniMax, LoRA

MiniMax H3 4-bit 量化保留原生影音生成

MiniMax H3 壓縮至 4-bit 後,仍保留影片與音訊生成能力。

Og image

要在較有限的硬件資源下製作影片,又不想放棄同步音訊,MiniMax H3-QuantFunc-4bit 提供了一個量化選擇。頁面將它定位為 MiniMax H3 的 4-bit 量化版本,而非獨立微調模型;原始基礎模型可確認為 MiniMax H3,但未交代更完整的 base model 訓練資料或微調流程。

模型把核心權重精度由 16-bit 降至 4-bit,官方稱壓縮幅度約為 4 倍,並宣稱角色細節、風格一致性及快速動作仍可維持。它支援 text-to-video、image-to-video,以及原生 video+audio generation;附真人演出、動畫追逐、高速汽車及風格化角色展示生成結果。

FL2VA 在相同提示詞及 seed 下,QuantFunc INT4 對 BF16 基準取得約 23.7 dB PSNR。這個數字可用作重建品質參考,但屬項目方的內部測試,未有列出測試硬件、影片設定、速度或顯存用量,因此不能單憑該指標推算日常生成體驗。

  • 標籤包含 svdquant、int4、quantized 及 comfyui,但沒有交代量化演算法細節。
  • 頁面未提供 GGUF 檔案名稱、檔案大小、mmproj、上下文長度或推薦量化級別。
  • 未列明 llama.cpp、Ollama 或 LM Studio 支援,也沒有硬件需求及 MTP draft speculation 資訊。
  • 項目連結 ComfyUI-QuantFunc,較適合配合相關工作流探索;授權為 MiniMax H3 Community License,使用前應查閱條款。

模型

Categories: 開源, ComfyUI, AI productions, 模型, 視頻模型, 模型訓練, Video, Image, 影像模型, 影像處理, Audio, 提示詞, Discord, LLaMa, Ollama, 動畫, MiniMax

Vlo 把 ComfyUI 帶進本地影片剪輯時間線

Vlo 將生成式 AI、ComfyUI 和傳統剪輯工具放在同一條時間線,適合想在本地處理影片的創作者。

landing

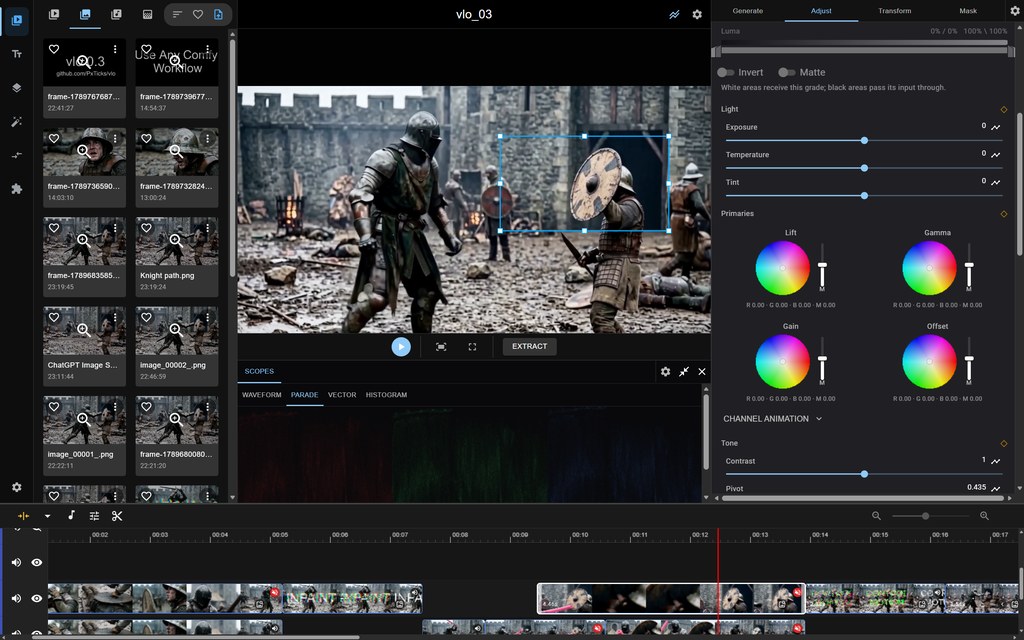
想在影片時間線內直接交給 AI 做遮罩、修補或畫面變換,Vlo 提供了一條較完整的工作流程。它屬於免費、開源的本地影片編輯器,處理的是生成式 AI 與逐格剪輯之間難以銜接的問題,亦支援在本機或遠端 GPU 上編輯同一批本地項目檔案。

Vlo 把 ComfyUI bridge 接入編輯器,圖片、影片和時間線選取內容都可以送入 ComfyUI 工作流;SAM2 points editor 則用於遮罩,並配合自動裁剪與拼接處理 video inpainting。自動調整 aspect ratio 讓不同影片模型處理素材時毋須先裁走畫面,色彩校正、音訊、版面、濾鏡、keyframes、spline editor、beat detection 和可吸附 markers,則補上傳統剪輯所需的控制。

測試時需要 Chromium-based browser,官方已測試 Chrome 和 Edge;Firefox 由於 WebCodecs 實作差異,早期測試曾出現明顯延遲。媒體渲染由 mediabunny 包裝 WebCodecs,配合 File System Access API 直接管理磁碟檔案,但清除瀏覽器資料後可能遺失項目資料夾位置。

  • ComfyUI 工作流可直接套用到時間線選取內容
  • SAM2 遮罩支援影片修補流程的自動裁剪與拼接
  • 本地項目可配合本機或遠端 GPU 編輯
  • 具備逐格影片編輯所需的 keyframes 和 spline 控制
  • 目前依賴 Chromium,瀏覽器兼容性是主要限制

Vlo 較適合需要把 AI 影片生成、inpainting 和傳統後期剪輯放在同一個工作區的創作者或小型團隊。項目沒有提供可直接比較的性能指標,現階段較能確認的是它以 WebCodecs 支撐 frame-accurate nonlinear video editing,並以可擴展的 ComfyUI 工作流延伸功能;瀏覽器限制和本地檔案管理方式,仍會影響團隊採用前的測試安排。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 視頻模型, API, Video, Image, 影像處理, Audio, 工具, Content Creator

VoxMem 測試音訊模型的記憶盲點

VoxMem 不只測模型記得講過甚麼,還檢查能否辨認說話者、語氣與背景聲音,直面多輪語音記憶的缺口。

VoxMem logo

當語音助手要回想幾次對話之前的內容,答案未必藏在文字轉錄稿內:誰說過一句話、當時的語氣,以及背景傳來甚麼聲音,同樣可能決定答案。VoxMem 屬於語音記憶評測基準,透過多次會話測試 Large Audio Language Models(LALMs)能否保留及運用這些非文字資訊。

項目把測試拆成兩條軸線:需要找回的聲音證據包括 speech semantics、speaker identity、paralinguistic cues 和 environmental sound;記憶操作則涵蓋 information extraction(IE)、multi-session reasoning(MSR)、temporal evolution tracking(TET)及 answer refusal(AR)。這個安排比只問模型能否找回一句原話更接近長期語音助手的工作情境。

VoxMem 提供 3,196 個評測實例,涵蓋 34,743 段、共 177小時的語音會話,並固定問題及證據,只改變8K、16K、32K 和 64K tokens的上下文長度。測試者可從 GitHub 項目取得程式碼,再配合 Hugging Face上的資料集重現評測;Python 3.9 或以上是已列出的基本環境,但不同 LALM仍可能需要各自的模型存取設定。

結果指出,15個 LALMs 在 32K 上下文下沒有模型達到 40% 整體準確率;模型記住文字內容的能力明顯高於辨認說話者、語氣及環境聲音,而且歷史越長,差距越大。這令VoxMem 更適合用來找出語音記憶系統的失效位置,而非單純作為模型排名工具。

• 同時測試聲音證據與記憶操作,涵蓋15個有效組合
• 以多會話歷史取代單一錄音,檢查跨場景整合能力
• 包含證據不足時拒絕回答,能檢視模型是否過度猜測
• 非文字聲音資訊在長上下文下明顯較難保留

研究語音代理、會話記憶、音訊模型或長上下文系統的團隊,能用這套基準分辨問題究竟出在聲音理解、跨會話推理、狀態追蹤,還是拒答判斷。資料採用 CC BY-NC 4.0,程式碼則使用MIT授權,商業產品整合前仍要獨立檢查資料使用條件。

項目主頁 · GitHub · 數據集

Categories: 開源, 模型, Audio, 工具, Python, 語音, Dataset 數據集

Page 1 of 9
1 2 3 … 9