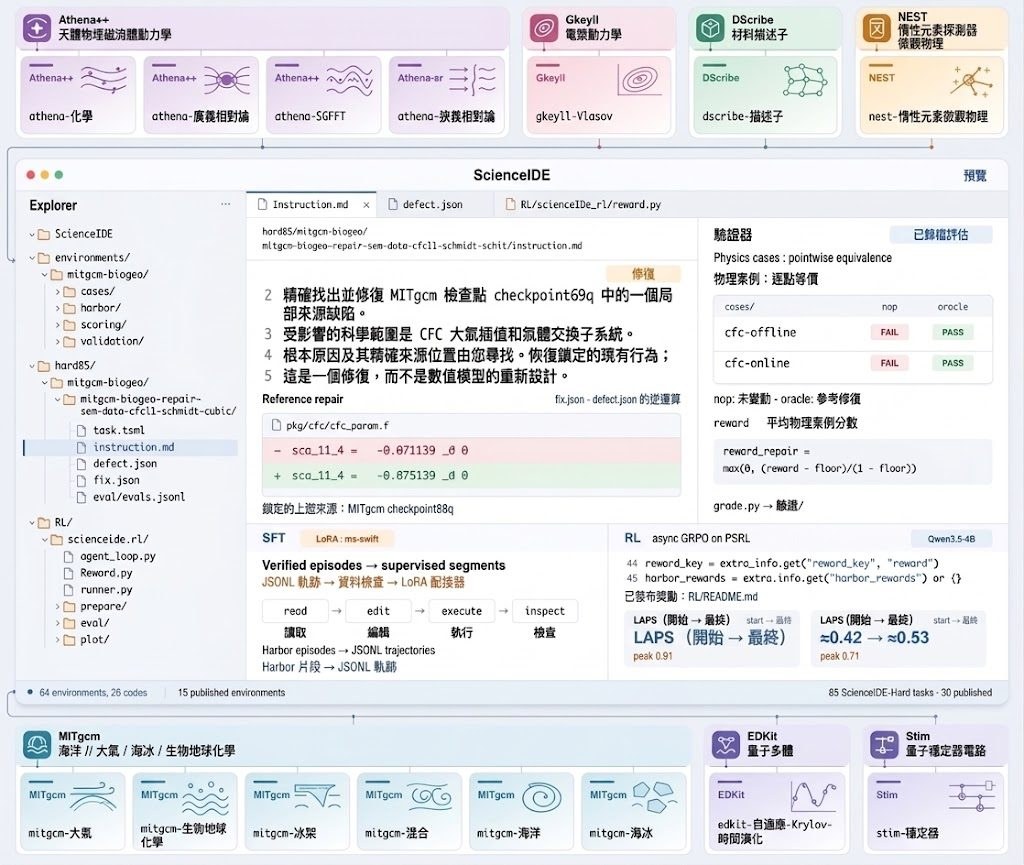
大多數 code agent 訓練環境用靜態單元測試或合成題目,ScienceIDE 走一條更狠嘅路:直接搬真實科學模擬器入嚟做試煉場,等 agent 改動 pinned、未經修改嘅上游源碼,再由 verifier 重新編譯並跑原本嘅物理 case,數值要對得返先算過。換句話,reward 唔係「diff 似唔似」,而係「模擬結果啱唔啱」。呢套框架對工程團隊同做 AI for Science 研究嘅人特別有用,因為佢直接量度 agent 對物理計算嘅影響,而唔係紙上談兵。
項目提供 64 個環境同 85 條 ScienceIDE-Hard 任務,已公開 15 個,全部都附帶可量度嘅難度指標(未修復分數、編輯點數量、驗證成本、通過率),避免人為標 difficulty。Reward 設計亦幾巧妙:untouched repository 一定攞零分,等模型必須真係做嘢先有分。
團隊同時釋出 PhAI-IDE-4B、9B、72B 三個模型,覆蓋唔同算力預算。從結果睇,SFT 後 PLUTO-Particles-Dust 由 0.0 跳到 0.33;Qwen3.5-4B 經 30 步 RL,LAPS 由 0.357 升到 0.857,MITgcm-biogeo 由 0.286 升到 0.571。訓練用科學 code 唔止提升呢類任務,亦帶動一般 benchmark:CodeXGLUE defect detection +6.99pp,BBH Word Sorting +36pp。
要部署嘅人最直接嘅入口係 Hugging Face 嘅 model collection 同 GitHub repo;想理解 reward 邏輯同難度定義,paper 同項目頁有完整交代。訓練數據、開發環境同 verifier 開源,等社區可以喺真實科學 codebase 上繼續 scale up。
重點摘要:
- 真實物理模擬做 reward:agent 改動上游源碼後,verifier 重編譯並比對物理 case 數值,唔靠 diff 相似度。
- 64 個環境、85 條 Hard 任務:已開源 15 個,難度由可量度指標自動決定,唔靠人手標 label。
- 三個模型規模:PhAI-IDE-4B、9B、72B 覆蓋唔同算力,訓練設定與評估條件一致。
- 科學任務外溢到通用 benchmark:CodeXGLUE defect detection +6.99pp,BBH Word Sorting +36pp。
- 完整開源鏈:code、environments、tasks 同模型權重同步釋出,方便研究團隊複製同擴展。