用 5 百萬次人類投票煉成的文生圖獎勵機制,公開給開源社群

Arena.ai 提出一套文生圖模型的後訓練方法,把人類偏好分數加上自動評分量尺,結果讓 FLUX.2-dev 與 Ideogram 4 同時衝上排行榜高位。你可以把它理解成幫文生圖模型「補課」的兩條評分線。

Og image

文生圖模型越來越強,但要靠後訓練再往上推,卻卡在同一個難題:到底要拿什麼訊號當作優化目標。Arena.ai 這項工作直接把答案拆成兩條互相補位的獎勵線,再把他們公開給社群參考。

第一條線來自 Text-to-Image Arena 上大約 500 萬組真實人類對決投票,用 Bradley–Terry 目標訓練出一個偏好獎勵模型,負責衡量視覺品質、構圖、美感這些廣義的好看與否。這個偏好模型在 MMRB2 基準上比其他獎勵模型表現更好,而且訓練資料越多,後訓練成果也越好。

第二條線則對應一個偏好資料看不到的問題:圖片可以極漂亮,卻把提示詞裡的物件寫漏、多塞東西,或者走偏要求的風格。Arena.ai 用視覺語言模型自動產生一組評分量尺,針對提示詞忠實度、相關約束、以及常見的獎勵漏洞行為打分,把這些規則式分數一起混入優化目標。

比起 Flow-GRPO 或 DiffusionNFT 這類只靠單一獎勵訊號的後訓練方法,這套組合給人的差別感在於:美感與合規不再互搶資源。經過他們的後訓練食譜,FLUX.2-dev 在 Arena 即時文生圖排行榜上多了 69 分,Ideogram 4 更拿到 1224 分,超越 2026 年 9 月 4 日之前所有公開上架的開源模型。
項目主頁 · Paper

Categories: 開源, 模型訓練, Image, txt2img, 提示詞, 教學, Dataset 數據集, 強化學習

OneSearch-VL:多模體視覺 deep research agent

由單張相片到影片片段,OneSearch-VL 會找出視覺線索、搜尋外部資料,再把證據串成可核對的答案。

OneSearch-VL

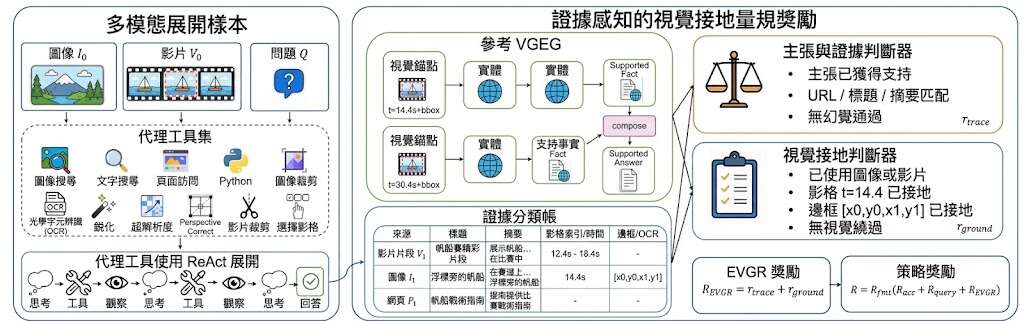
由一張相片、相片集合到影片片段,OneSearch-VL 會先定位視覺線索,再檢索外部知識,將相關證據組合成答案。它屬於多模態 deep research agent,處理的是影像內容理解與資料查證之間難以銜接的工作。

核心是 Visually Grounded Evidence Graph(VGEG),把視覺錨點、來源支持的事實和產生答案所需的操作連在一起。VGEG 亦支援資料建立及驗證;Evidence-aware Visual-Grounded Rubric reward(EVGR)則在強化學習中監督證據是否可追溯,以及答案有沒有真正對應影像內容。

項目提供 OneSearch-MI-Bench 和 OneSearch-Video-Bench,分別面向多圖及影片研究能力。輸入資料未列出具體分數或模型名稱,因此不能把它描述成已全面勝過其他視覺研究方案;它較適合用作研究原型、訓練資料管線和 agentic workflow 的基礎。

OneSearch-VL 包含 Agentic SFT、Agentic RL、推理及評估相關目錄,並標示 Python 3.11+;先準備模型、資料集和外部工具,再執行訓練或評估流程。對需要查核圖片來源、比較多張圖片,或從影片整理證據的研究團隊,這種統一處理方式較容易整合到既有工作流,但部署成本和工具依賴仍要自行確認。

• 同時支援單圖、多圖集合及影片
• 以 VGEG 統一視覺線索與外部證據
• EVGR 強調證據可追溯及視覺對齊
• 提供多圖與影片專用 benchmark
• 支援 SFT、RL、推理和評估流程

GitHub · 模型

Categories: 開源, Agentic, AI productions, 模型, 視覺模型, 多模態模型, 模型訓練, Video, Image, 工具, Python, 庫, Dataset 數據集, 強化學習

Compo:以 Spatial Canvas 編排海報中的文字、人物與圖像

Compo 讓你用畫布安排文字、人物與圖像位置,再交由模型生成海報,減少只靠文字描述構圖的反覆試錯。

Compo Teaser

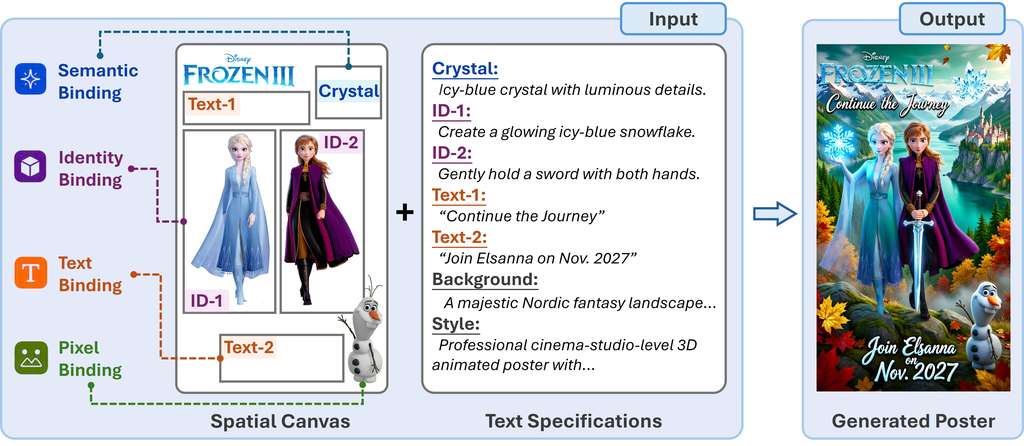
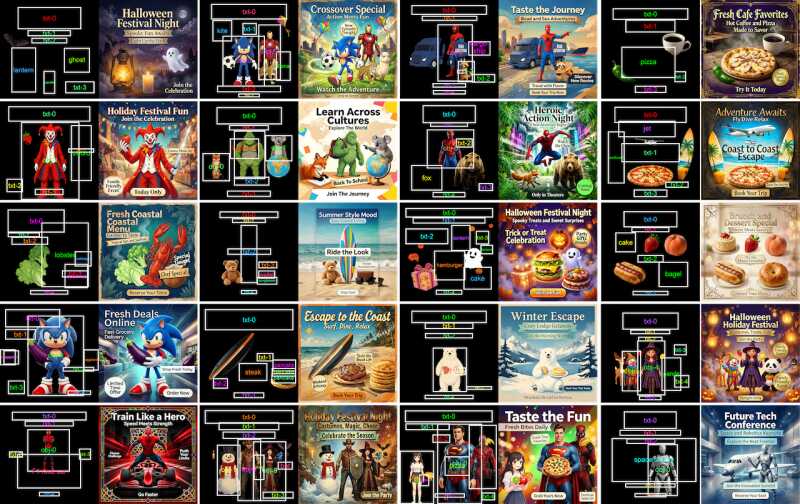
海報生成最難控制的往往不是主題,而是文字、人物和裝飾元素應該放在哪裏。Compo 屬於海報生成模型及介面項目,將 Spatial Canvas Interface 與 Text Specifications 結合,讓使用者直接在畫面中表達二維構圖意圖。

Spatial Canvas 支援四種綁定方式:Semantic Binding 指定文字概念及目標區域,Identity Binding 以參考圖保留視覺身份,Text Binding 同時交代準確字句與位置,Pixel Binding 則放入需要保留的像素內容。Bounding boxes、參考圖片和文字識別資料會一併渲染到畫布,形成模型接收的統一影像輸入。

  • 以畫布補足單靠文字提示難以交代的空間關係
  • Compo 由預訓練 image editing model 改編而成,毋須另建 task-specific architecture
  • 支援 direct inference,也支援 agentic mode 自動規劃畫布
  • 可用於海報、宣傳圖及需要精確排版的視覺內容

Compo 的模型改編重點,是令現有 image editing model 理解不同綁定方式及其組合,而不是從零訓練專用 poster generator。項目亦建立自動產生監督數據的流程,協助模型學習各類 Spatial Canvas 輸入;這比純文字提示更容易控制位置,但使用者仍要準備畫布內容,agentic mode 的自動規劃亦未必取代人工微調。

適合研究人員、設計工具開發者和需要批量製作宣傳海報的內容團隊作為試驗起點,而非直接視作成熟的製作平台。

項目主頁 · GitHub

Categories: 開源, 香港大學, Agentic, 模型, 視覺模型, 模型訓練, 微軟, Image, 影像處理, 香港, 工具, 中國, Dataset 數據集

VibeEdit:以畫布指令精準指定影像編輯位置

圈選、畫線或拖動就能指定修圖位置,VibeEdit 以空間標記處理相似物件難以辨認的問題。

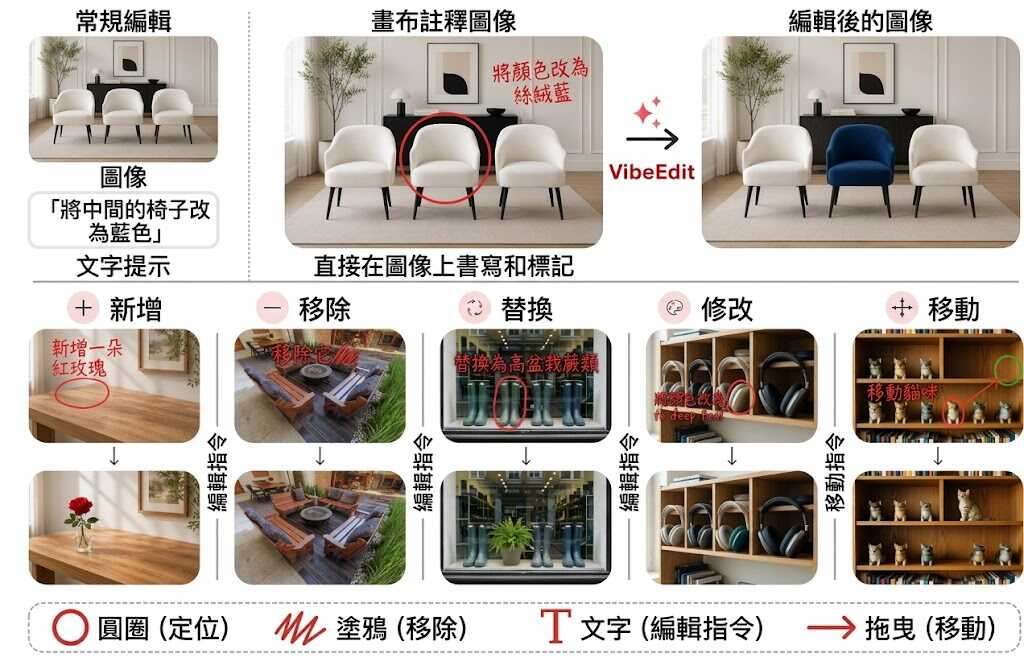
VibeEdit enables image editing with canvas instructions, including circles, scribbles, short notes and drag gestures.

圈選物件、畫幾筆線,或在圖片上拖動指定位置,再補上一句短註記,便能要求模型新增、移除、替換、改變屬性或移動內容。VibeEdit 屬於影像編輯模型,處理的是文字提示難以準確指出相似物件和局部區域的問題。

它採用 Qwen-Image-Edit,以 layer-decoupled conditioning 分開編碼原圖與 canvas instruction,再配合 region-weighted supervised fine-tuning,以及 rubric-guided reinforcement learning(RL)改善局部修改、指令完成度和未編輯區域的保留。訓練資料包含 155 萬組 source–target edit pairs、物件遮罩和結構化編輯描述,畫布指令則由這些資料生成。

  • 支援新增、移除、替換、屬性修改及移動物件
  • 不要求獨立文字提示,空間標記直接表達目標位置
  • 以 419 個人工整理案例測試相似物件選取能力
  • VLM(Vision-Language Model)評分為 79.9,outside-region PSNR 為 32.8 dB
  • 對比 FireRed 的 67.4 分及 24.0 dB,局部編輯和區域保留均較佳

對需要精準修圖的設計、內容製作和研究團隊,畫布指令比長篇描述更容易表達「改哪一件」;但模型仍屬研究項目,程式碼標示為 Coming soon,暫時不能按儲存庫直接安裝或自行重現。評測規模亦只有 419 個案例,結果未必涵蓋所有圖片類型和複雜編輯情境。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, Image, 庫, 強化學習

SuperNav 讓多模態模型指揮機械狗導航

由多模態模型處理找物件、按次序到訪及高層次指令,SuperNav 把導航變成可觀察、可評估的代理工作流。

SuperNav

當指令由「找出籃球」延伸至「先找打印機,再找垃圾桶」,SuperNav 以 Agentic Navigation System 的形式處理場景理解、路線行動與任務進度。項目實際解決的是機械人面對不同場景和非固定指令時,難以只靠預設導航流程完成工作的問題。

系統由預訓練多模態模型 (multimodal model) 作決策,再透過工具、task-progress tracking 和 context management 將決定轉成移動行動,不需要為導航專門微調模型。Codex、OpenCode 或 Kimi 都可作為代理執行端,任務、工具與 Skills 則透過實驗設定組合,彈性高於寫死單一路線,但結果仍會受模型判斷及工具能力影響。

作者提供 agent runtime、導航工具、Skills、實驗配方及評估工具,支援 Habitat-GS 和 AI2-THOR。測試時可先在模擬環境執行單物件、多物件和 demand-driven navigation,再查看 RGB 觀察、軌跡、tool calls、提示詞、工具結果及原生記錄;儲存庫目前沒有真實機械人驅動程式,Unitree Go2 的示範主要來自研究項目展示。

研究結果指出,SuperNav 在單物件、多物件及需求導向導航的成功率高於所比較的基線,並展示 Unitree Go2 實體部署。可留意的限制是,資料只交代高於評估基線,未提供足夠細節讓讀者單靠儲存庫重現所有真實機械人測試。

  • 適合場景: 室內找物件、依次到訪多個目標,以及較高層次的整理要求
  • 可觀察性: 即時查看 RGB 影像、軌跡和工具呼叫,完成後再檢查記錄
  • 模型關係: 多模態模型負責決策,SuperNav 負責工具協調、進度追蹤與導航執行
  • 測試範圍: Habitat-GS、AI2-THOR,並有 Unitree Go2 示範

研究團隊、具身 AI 開發者和需要比較導航代理的人,會較容易從這個開源項目受益;一般使用者則要先準備相應模型服務、模擬環境和實驗設定,不能把儲存庫直接當成已包裝完成的機械人應用。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 多模態模型, 模型訓練, Image, 提示詞, 工具, 庫, Kimi, Skill 技能

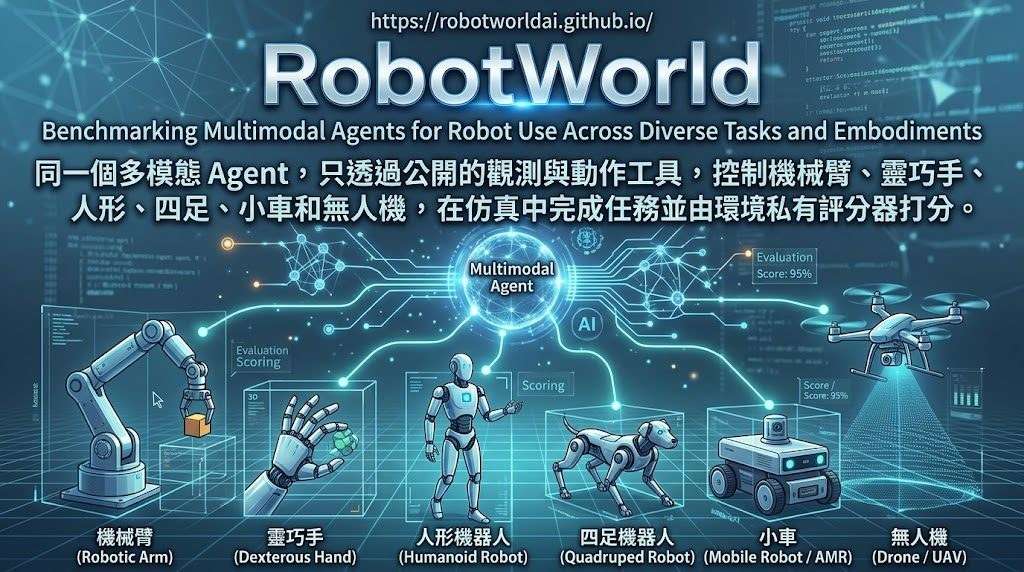
RobotWorld:把多模態智能體放進機械人世界測試

想比較多模態模型控制不同機械人的能力,RobotWorld 提供 84 項模擬任務及隱藏評測。

Watch RobotWorld in 45 seconds

想測試模型能否由影像和狀態資訊控制機械人,而不只是回答完成任務,RobotWorld 提供一套跨模擬器的機械人基準測試項目。它屬於具身智能體評測框架,讓多模態代理透過觀察與動作介面控制機械臂、靈巧手、人形機械人、四足機械人、汽車及無人機,處理 84 項任務和 20 個 benchmark integrations。

代理只能讀取允許的相機影像、關節及任務狀態,再發出受限制的控制指令;環境會回傳執行收據和新觀察,讓代理修正下一步。任務結果由代理看不到的 hidden evaluators 判定,避免模型自行聲稱成功而取代環境驗證,亦能揭示物件狀態遺失、子目標停滯和錯誤完成判斷等失敗原因。

  • 評測方式:預設每項任務進行三次 rollout,並停用 environment-side code control。
  • 涵蓋範圍:由 manipulation、locomotion 延伸至 driving 和 flight。
  • 執行流程:需要還原 source、準備指定 assets、建立 Docker images、編譯 runtime,以及設定模型 API credentials。
  • 限制:已註冊任務不代表全部都有已驗證的成功軌跡,部分依賴和受限制資料集仍需另行取得。

相比只測文字答案或單一機械人的方法,RobotWorld 把模型推理、感知、控制和環境回饋放入同一條閉環,較適合研究團隊比較不同多模態模型、重現評測流程,或為新任務和新 embodiment 擴充測試。代價是安裝和資源準備較複雜,結果亦會受模擬器、模型設定及每項任務預算影響。

項目主頁 · GitHub

Categories: 開源, 模型, 多模態模型, API, Image, World-Action Model, Robotic, 框架, Anthropic, Dataset 數據集

VIEScore2 讓影像評分不再只剩一個分數

VIEScore2 同時評估影像質素、語意一致性與缺陷位置,將難以解讀的分數轉成可追蹤的修改方向。

teaser

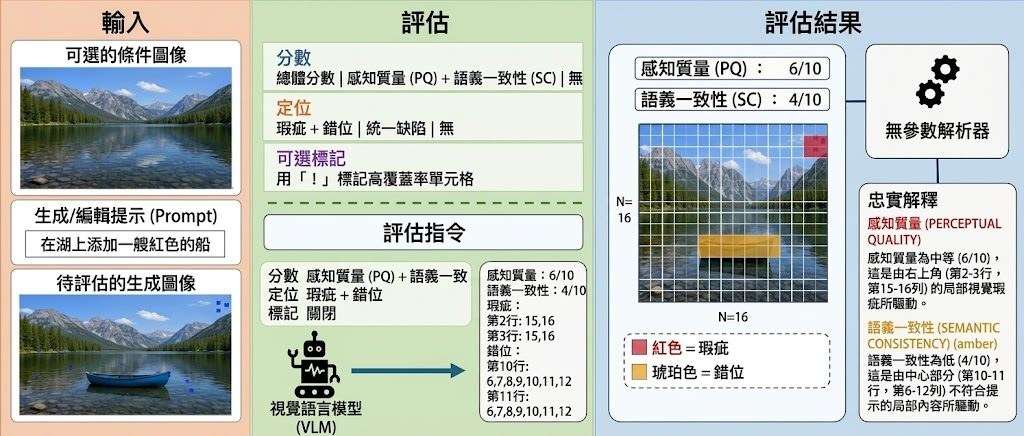
評估 AI 生成或編輯影像時,單一分數往往只能告訴你好不好,卻說不出問題在哪裏。VIEScore2 屬於影像評估模型,處理生成圖、編輯圖、提示詞及可選的條件影像,並在一次模型運算中輸出質素、語意一致性和缺陷位置。

Qwen3-VL-8B 經微調後,以自回歸方式同時預測 perceptual-quality(PQ)、semantic-consistency(SC)及 16×16 defect grid;artifact 和 misalign 兩個通道可分開標示視覺瑕疵與語意錯位。參數免訓練的 parser 再把網格結果穩定轉成文字解釋,避免說明內容與定位結果互相矛盾。

相比只輸出總分的評估器,VIEScore2 提供較具操作性的空間線索;相比通用 VLM,模型則專注於影像評分和缺陷定位,代價是網格以 16×16 單元表達,細節精度有限。訓練資料把 ImagenWorld、RichHF-18K、PAL4VST、COCO 的遮罩或熱圖,以及 EvalMuse-40K 的分數資料統一成同一格式,再以 SFT 和 GRPO 配合 cell-level Dice、分數準確度及格式有效性獎勵訓練。

GitHub 儲存庫提供評估協議、資料 manifests、外部測試集轉換器,以及 run_eval.py;可使用本地 checkpoint,亦支援 OpenAI、Gemini 和 Anthropic API backend。主要套件包括 AbHuman、AGIQA-3K、EvalMuse、PAL4VST 等評估集,適合研究影像生成模型、建立自動質量檢查流程,或分析編輯結果的錯誤位置。

  • 評分更完整:同時輸出 PQ、SC、缺陷網格及文字解釋。
  • 結果較接近人評:主要測試集 overall-score SRCC 為 0.601,最佳 VLM baseline 為 0.491。
  • 定位能力具競爭力:6 個定位基準中有 3 個取得最高 grid IoU,5 個進入前三。
  • 限制清晰:網格定位仍屬區域級提示,並需要按儲存庫協議整理資料與輸入格式。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 模型訓練, Qwen, NVIDIA, OpenAI, Gemini, API, Image, 提示詞, 庫, Anthropic

RecursiveGameCreator:讓你的創意從原型走向成功的遊戲開發框架

Recursive Game Creator 把設計、開發、遊玩與評審串成循環,令 AI 遊戲開發不止於成功運行。

Recursive Game Creator framework: Designer, Builder, coding-native Player, and Reviewer connected through game developme

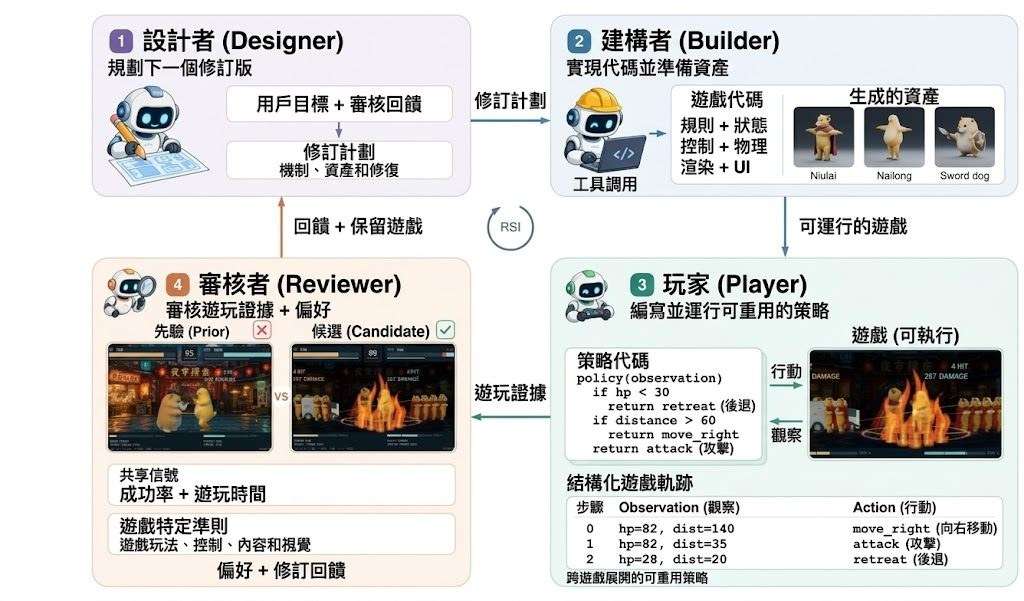
遊戲能夠運行,不代表玩家會覺得好玩。Recursive Game Creator 將 Designer、Builder、coding-native Player 與 Reviewer 串成循環,屬於一個 Agentic Product-Level Experience-Oriented Game Harness,處理 AI 由可玩原型持續改良至完整遊戲時,缺乏體驗評估的問題。

Player 會透過程式介面執行可重用的 gameplay policies,收集多條 gameplay trajectories,毋須每個動作都重新呼叫模型,較適合反覆測試機制與內容。Reviewer 再結合行為軌跡、畫面觀察、玩家偏好及遊戲專屬準則,為下一輪 Designer 計劃提供修訂回饋。

項目支援 HTML 和 Godot,遊戲可在隔離 runtime 內開發及測試,亦可選擇接入影像、3D asset 與 Blender。macOS 或 Linux、Git、Node.js 22/npm,以及運行中的 Docker daemon 是主要環境要求;Docker 使用 software rendering,主機不必配備 GPU。

目前公開結果以三輪迭代展示改良,GameCraft-Bench overall 由 R1 至 R3 提升 5.19 points。這個數字反映循環式修訂的效果,但未等同所有遊戲都能獲得相同體驗,因為評審準則、玩家偏好及遊戲類型仍會影響結果。

較適合研究 agentic game development、需要大量自動 playtesting 的團隊,以及希望比較遊戲版本演進的開發者。實驗可從 HTML 遊戲開始,再按需要加入 Godot、視覺素材或 Blender 整合,先驗證設計—開發—遊玩—評審流程是否符合自身工作流。

  • 以四個角色連接設計、實作、遊玩與評審
  • 透過 reusable policies 收集 gameplay trajectories
  • 同時考慮行為、畫面與玩家偏好
  • 支援 HTML、Godot、3D asset 及 Blender 整合
  • GameCraft-Bench 三輪迭代提升 5.19 points

項目主頁 · GitHub

Categories: 開源, 香港大學, Agentic, 模型, DeepSeek, Image, 框架, 香港, 軟件, Mac, 3D, Linux, 編程

ArtCraft 以 Rust 重做七款 Adobe 創作工具

ArtCraft 把影像、影片、PDF、排版等工作整合到七款原生工具,檔案留在本機,亦方便接入自動化流程。

Og image

由影像編輯、向量繪圖到影片、PDF、動態圖像和頁面排版,ArtCraft 正以 Pure Rust 打造七款原生、開源及免費的創作應用,處理創作者需要在不同工具之間切換,以及雲端往返檔案的工作流程問題。項目涵蓋 PhotoCraft、VectorCraft、FilmCraft、LightCraft、PdfCraft、EffectCraft 和 DesignCraft。

這套工具的差異不只在於功能範圍,而在於每款應用都直接編譯成 macOS、Windows 和 Linux 桌面程式,不依賴 Electron 或 web views。檔案在本機處理,介面、工具和快捷鍵則沿用專業創作軟件較熟悉的操作方式;PhotoCraft、VectorCraft、LightCraft、PdfCraft、EffectCraft 和 DesignCraft 亦可透過 WebAssembly 在瀏覽器執行。

目前 PhotoCraft 和 PdfCraft 屬於 Early alpha,其餘多數工具仍在 In development,不能視為已完成的商業級套裝。不同應用的安裝程式已涵蓋多個平台。

項目亦預留了自動化和 AI agents 的接入方式,可透過 CLI、JSON control channel 或 MCP server 操作應用,適合需要批量處理素材、建立創作流程,或希望自行檢視和修改程式碼的使用者。

  • 七款工具涵蓋影像、向量、影片、攝影、PDF、VFX 和排版
  • 以 Rust 從頭開發,採用原生桌面程式架構
  • 開源程式碼放在 GitHub,並使用 permissive licenses
  • 檔案留在本機,部分應用同時支援瀏覽器和 WebAssembly
  • 多數工具仍在早期開發階段,成熟度各有不同

項目主頁

Categories: 開源, Agentic, AI productions, MCP, 視頻模型, Video, Image, 影像模型, 教學, 軟件, 工具, Content Creator, Discord, Mac, Linux, 庫

Building Rome 單張相片重建完整 3D 場景

只用一張相片,Building Rome 便嘗試補全鏡頭外的建築與室內結構,生成可探索的 3D 場景網格。連看不見的空間也能生成。

Og image

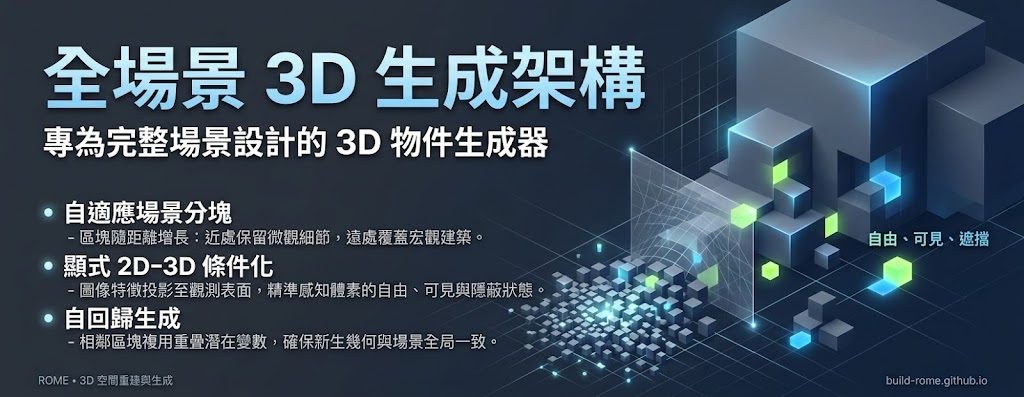
只得一張相片,Building Rome 便嘗試補全鏡頭未拍到的空間,生成室內、戶外及大型環境的完整 3D scene mesh。這個單影像 3D 場景重建項目,處理的是照片只提供單一視角、遠近物件細節不一致,以及隱藏幾何無法直接觀察的問題。

方法把場景切成會隨距離變化的 adaptive chunks:近處使用較細區塊保留細節,遠處則用較大區塊涵蓋建築。影像特徵會投射到已觀察到的表面,而每個 voxel 亦會標示空置、可見或隱藏狀態;生成鄰近區塊時重用重疊 latent,令新加入的幾何結構較能保持連貫。

讀者可以透過互動檢視重建結果,透過拖曳旋轉、滾輪縮放及 WASD、Q、E 移動,亦可選取兩點量度距離。網頁展示用 mesh 為方便瀏覽而簡化至約 1.5M faces,論文圖像及影片則採用完整解析度,因此兩者的視覺細節不應直接視為相同。

  • 單張相片重建室內、戶外及大型場景
  • 以 adaptive chunks 處理不同距離的細節
  • 透過 2D&3D conditioning 推斷可見與隱藏幾何
  • 以 autoregressive generation 延續相鄰區塊的一致性
  • Code 標示為即將提供,現時可先透過互動網頁查看結果

項目由 Applied Intuition 聯同 Purdue University、UIUC 及 UC Berkeley 研究人員完成,並以 World Tracing、GenRecon、VolFill 及 Lyra 2.0 等方法作比較。對需要由照片建立可探索環境、進行空間分析或製作 3D 內容的人,這種由單一視角推算完整場景的做法提供了另一條工作流程,但隱藏區域屬於模型生成,不能當作相片直接觀察所得的精確測量。

項目主頁 · 項目

Categories: 開源, AI productions, 模型, 視覺模型, Video, Image, 3D, Anthropic

Page 1 of 20
1 2 3 … 20