MiniMax-H3 LoRA:[特集]讓影片生成更懂運鏡與物件互動

從穩定物件動作到固定首尾畫面的 360° 環繞,這批 LoRA 把 MiniMax-H3 延伸成多種影片工作流。

AVvXsEjfkOvyf5h2H5Z vYu8kIES0pGOidPGIbqyszhocYoXkK67 2yzenUgugZ9qtXe3Hzn5kB0K6Sdy36A78G4DPO1 veLpRRoPuSivw3r4Vdw zSOSgs1

生成影片時,物件可能在動作中複製或互相穿透,鏡頭也未必能按要求回到起點。這批 MiniMax-H3 LoRA 和相關版本,分別處理物件一致性、鏡頭運動、視覺風格,以及音畫同步等需求,讓影片創作可以按任務挑選適合的能力。

其中,H3 Licon VBVR LoRA 把圖片轉成影片,並以專為 H3 重建的 VBVR data 訓練。它著重改善物件在運動期間的連貫性,減少複製、穿透和錯誤重疊,適合需要人物或物件持續移動的 image-to-video(I2V)工作流。它處理的是生成過程中的空間一致性,不代表所有動作都會符合現實物理。

要製作可循環播放的環繞鏡頭,MiniMax-H3 360° Orbit LoRA(FL2VA version)採用另一種約束:同一張圖片同時作為影片的首尾 keyframe。模型需要在兩個相同畫面之間完成 360° 鏡頭環繞,再回到起始視角。相較之下,Reference-to-Video(Ref2V)把圖片當成較寬鬆的參考;First-and-Last-Frame-to-Video(FL2VA)則會固定起始與結束畫面。一般情況下,首尾畫面相同容易令 base model 停在原地,這個 LoRA 專門用來生成兩者之間的運鏡。

風格轉換方面,MiniMax H3 3D Animation Style LoRA 支援 text-to-video(T2V)和 I2V,使用自訂 3D animation dataset 訓練。人類角色建議將 strength 設為 0.8,以兼顧提示詞跟隨和角色一致性;動物、幻想角色或環境則建議 1.0,令 3D 動畫風格更明顯。MiniMax-H3 Anime2Realism 則透過 Ref2V,把動漫圖片轉成寫實真人影片,同時保留角色特徵、姿勢、服裝、構圖、物件、光線和色彩,適合需要延續原有設計元素的風格轉換。

若要替換影片中的人物,MiniMax-H3 Character Swap LoRA 會參考新角色圖片,嘗試在保留原場景的情況下換掉來源影片中的人物。這個實驗版本訓練了 1,000 steps;項目文件稱,本地測試中它比 base model 更能保留背景。不過,動作時間、面部表情和 hard cuts 仍可能不準確,因此較適合先做概念測試,不宜直接假設每個鏡頭都能無縫接合。

需要音訊與影片一同生成時,TaoMate-H3 使用 3-step LoRA,以小段方式同步產生兩者,並可延續生成較長影片。它支援 480p、768p 和 1080p,但須配合原版 TaoMate-H3 model。另有供 ComfyUI 使用的轉換版本,目的是讓既有 MiniMax H3 workflows 更容易載入;這是 checkpoint 轉換,不應與原版模型本身混為一談。

更多的 LoRA 未能盡列,請到 項目主頁
Categories: ComfyUI, AI productions, 模型, 視頻模型, 模型訓練, Video, Image, World-Action Model, Audio, 提示詞, 3D, 動畫, Dataset 數據集, MiniMax, LoRA

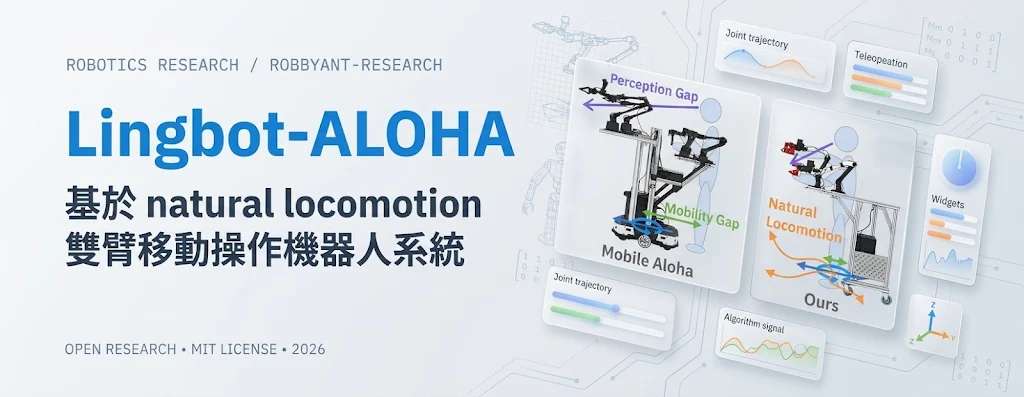
LingBot ALOHA:讓動作預測接續執行中的指令

把上一段動作帶入下一次預測,有助安排連續控制;但重疊動作可能重播,接駁機械人仍要處理交接。

Repository image for robbyant-research/Lingbot-ALOHA

讓機械人執行動作期間,同時準備下一段指令,是 LingBot ALOHA 最有辨識度的能力。這套基於 OpenPI、為 Mobile ALOHA 改編的策略訓練與推論程式碼,將 Real-Time Chunking(RTC)的 prefix conditioning 接到 JAX π₀.₅ 模型,並支援合併多個 LeRobot datasets 訓練,適合已有機械人資料和控制系統的研究團隊。

RTC 會把上一段預測中的部分動作,放到下一段預測開頭作為參考,讓模型接着已有計劃往下生成。訓練時,開頭保留不加噪音的動作,後段才加入噪音並計算 flow-matching loss;開頭只提供條件,不計入損失。這把「接續動作」納入訓練過程,但項目文件描述的支援限於 JAX π₀.₅,未證明 PyTorch 路徑具備等效能力。

執行端的 RTCActionChunkBroker 每次回傳一個 action,並在舊動作段仍在執行時,非同步要求新預測。交接未必無縫:切換時會從新動作段的 index 0 開始,沒有跳過已用作條件的 prefix,因此重疊期間執行過的動作可能重播。對需要連續移動或精確協調的任務,團隊應先檢查交接位置的指令序列;文件沒有提供足以量化這個問題影響的測試結果。

多資料集訓練則把資料整理方式直接變成訓練取捨:MultiVLADataset 將影格串成共同索引,再打亂抽樣,沒有獨立的 dataset-weight 參數,也不會自動平衡來源。項目文件的例子中,A 有 10,000 個影格、B 有 30,000 個影格,預期混合比例約為 25% A、75% B。較小資料集即使包含重要任務,也不會因此獲得更多抽樣機會,資料量本身便影響模型接觸各類示範的頻率。

能夠串接資料,不代表能直接混用不同機械人的紀錄。各資料集的 feature dimensions、camera conventions、action ordering、units 和 task meanings 必須一致,否則相同欄位可能代表不同動作或觀察,串接流程不會替團隊調和差異。這令它較適合同一套機械人規格下累積的多批資料;跨硬件整合仍須先處理資料定義,不能單靠增加路徑完成。

  • RTC 把前一段預測帶入下一段,將動作接續納入模型條件。
  • 非同步取得新預測可與舊動作執行重疊,但交接可能重播動作。
  • 多資料集按影格量參與抽樣,來源比例需要自行管理。
  • 資料欄位、單位及動作含義須一致,合併不會自動完成對齊。
  • 發布內容只有 source code,資料與模型資產均須另外準備。

要驗證這套流程,團隊須自行提供 datasets、pretrained weights 和 trained checkpoints,不能下載後便直接重現已訓練策略。訓練配置需要 π₀.₅ 初始 parameters 及 tokenizer assets,也可改用本地 parameters 目錄。合理的試驗順序是先核對資料定義及抽樣比例,再測試新舊動作段交接,避免把資料混合問題與控制時序問題混在一起判斷。

執行環境支援 Ubuntu 22.04 與 NVIDIA Graphics Processing Unit(GPU),依賴透過 uv 管理,定義保存在 pyproject.toml 和 uv.lock。上游列出的 full fine-tuning 單 GPU 記憶體需求約為 70 GB,而 RTC 範例正是採用 full fine-tuning;這只能作資源規劃參考,實際用量仍取決於配置,不能視為本項目的實測要求。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 模型, 多模態模型, 模型訓練, NVIDIA, 香港, Linux, Python, Dataset 數據集, Tokenize

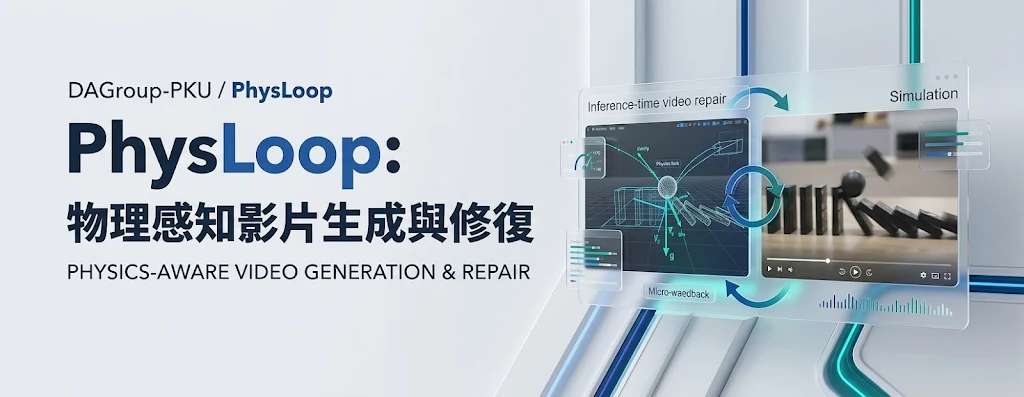
PhysLoop:讓影片生成模型自行修正物理錯誤

PhysLoop 以大型語言模型的物理認知驅動影片生成與修復,嘗試減少碰撞、堆疊和物件互動中的不合理畫面。

WeChat contact QR code

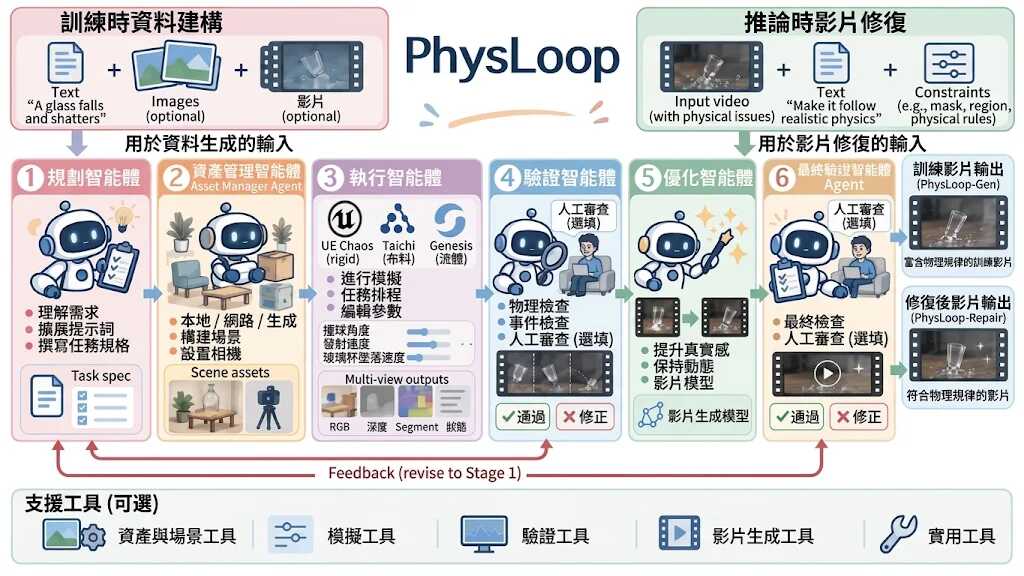
PhysLoop 是一套結合大型語言模型(Large Language Model,LLM)與物理模擬的影片生成研究框架,專門處理生成影片中物件碰撞、掉落、堆疊及互動失真的問題。它把影片規劃、執行、驗證與修訂串成閉環,讓模型不是一次生成便交差,而是按物理規律反覆檢查結果。

  • 以 LLM 的物理知識規劃生成、驗證及修訂流程
  • 支援文字轉影片與圖片轉影片案例
  • 涵蓋撞球、多米諾、衣物擺動及連鎖反應等場景
  • 計劃發布 PhysLoop-Gen、PhysLoop-Repair 評測資料集與 PhysLoop-100K 訓練資料

與只靠擴大影片生成模型參數的做法相比,PhysLoop 把改進焦點放在生成後的物理驗證與局部修正,取捨是需要額外模擬、規劃及檢查成本。其公開案例涵蓋台球入袋、網籃接球、磁鐵移除金屬底座、吊飾倒下等互動,可從多個角度比較結果,但項目文件未提供完整評測數據或重現套件,因此目前較適合理解為研究原型,而不是已可直接安裝使用的成熟產品。

儲存庫已整理環境、案例規格、執行與重播方式,以及測試和資料集說明;不過程式碼仍待公司政策審批,PhysLoop-Gen、PhysLoop-Repair 評測資料集和 PhysLoop-100K 訓練資料亦未完成發布。現階段可先閱讀論文與公開示範,之後再按工程文件設定 Unreal Engine 環境並執行案例。

研究團隊、影片生成模型開發者,以及需要處理物理互動內容的動畫與廣告製作團隊,可從中取得方法與資料規劃的參考;開發者則要預留模擬器整合、案例調試及模型訓練資源。

項目主頁 · GitHub

Categories: 開源, 北京大學, 字節跳動, AI productions, 模型, 模型訓練, Video, Image, 框架, 庫, 動畫, Dataset 數據集

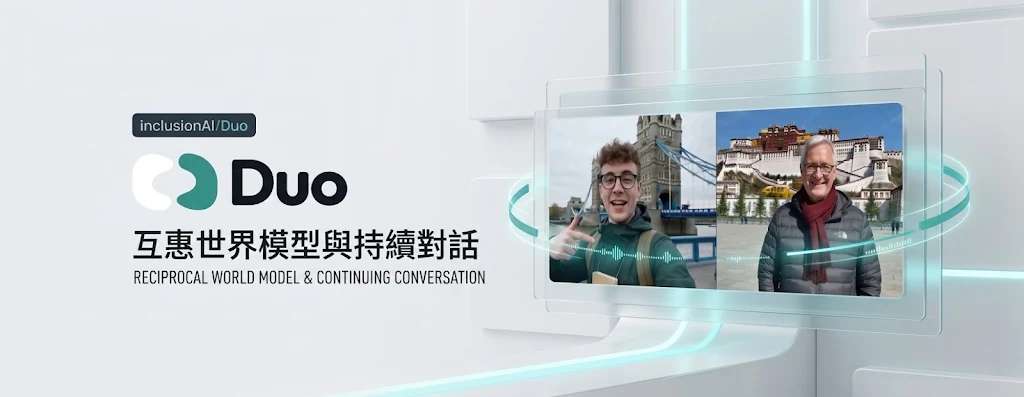
Duo:讓模型在對話中即時插嘴及回應

Duo v1 是螞蟻集團(Ant Research)開 Apache 2.0 授權的全雙工互動世界模型,主分支提供離線研究流程,vLLM-Omni 與 SGLang-Omni 分支則走向線上即時串流。

Duo

先聽你說一半被打斷,然後繼續講——這種像真人對話的互動,一直是擴散模型(diffusion model)難以處理的部分。Duo v1 由 inclusionAI 團隊推出,是一個 Reciprocal World Model(互惠世界模型),把「智能」與「物理現實」放在同一個世界裡看待:一邊持續感知影音輸入,一邊即時回應,讓 spontaneous conversation(自發對話)與插話打斷自然發生。

這是一個模型加推論管線的開源項目,Apache 2.0 授權。跟純文字對話模型最大的不同,是它把「決定要不要參與」與「決定要說什麼、發出什麼聲音」拆成兩個模組,交錯在同一條時間線上運作,因此不需要等使用者講完才回話。

要做到這一點,技術上用了三招:

  • 自迴歸建模處理持續互動的推理與參與決策,而不是把生成限制在指令理解
  • 分塊條件與跨塊 token 同步,加上模組專屬的 attention mask,確保因果依賴關係,讀不到未來的輸入
  • 雙重 rollout 蒸餾,用自迴歸生成的 Intent token 與合成的影音歷史訓練,緩解兩個模組之間的 distribution shift

模型權重在 Hugging Face 公開:Duo-1.0 causal base、distill、quantized,以及 Duo-1.2 causal base,同時附上離線推論程式碼給研究用。想線上部署的話,vLLM-Omni 與 SGLang-Omni 兩條分支提供加速的即時串流流程,vLLM-Omni 是官方推薦的那條。

硬體門檻不低:參考離線配置需要兩張 CUDA GPU,一張給 Intent 與 codecs、另一張給 Realization,另有記憶體要求;離線環境還要把模型與語音環境分開,因為 qwen-asr 綁定了特定版本的 Transformers。

要留意的是,這仍是 preview 版本,目前只支援基本影音對話,官方表示新版會陸續推出。適合關注實時語音互動、數碼人(digital human)、陪伴式 agent 的團隊,以及做世界模型、串流推論與語音多模態研究的實驗室。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 數字人, 模型, 多模態模型, 世界模型, 模型訓練, Qwen, NVIDIA, Video, Audio, 語音, Dataset 數據集

TailSteer:減少多輪圖像編輯漂移

TailSteer 是圖像模型的後訓練方法,專注改善連續編輯時的細節累積偏差,同時保留原有生成與編輯能力。

TailSteer trajectory mark

連續修改同一張圖時,模型常會在前幾輪表現良好,之後卻逐步改變人物外觀、背景或物體關係。TailSteer 是一種圖像模型後訓練方法,針對這種多輪編輯漂移,在保留原有文字轉圖像與單輪編輯能力的同時,提升長程修改的穩定性。

它的取捨不是加入全新的推理模組,而是把介入放在模型生成軌跡的尾段:早期保留基礎模型已學到的生成動態,後段再引導結果走向較穩定的終點。官方已提供 FLUX.2 [klein] Base 9B、SenseNova-U1.5-8B-MoT 與 Qwen-Image-2.1 的版本,後續仍沿用原有架構、sampling pipeline 及官方模型載入方式。

  • 以 SFT、RL 或 OPD 後的模型作為起點,進行最後階段訓練
  • 減少連續編輯、參考圖運動及多圖合成造成的累積漂移
  • 保留 text-to-image 與單輪編輯表現,避免大幅削弱基礎模型能力
  • 提供 TailSteer-Source 與 Add & Preserve Bench 資料集供訓練及評估
  • 已發布模型權重,可透過原有介面更換 model ID 或路徑

Add & Preserve Bench 以 100 張圖片及十輪連續編輯測試保留能力;官方亦涵蓋一般多輪編輯評估,並以相同 prompt 與 seed 比較視覺結果。項目文件聲稱,部分長程保留表現可接近或超越 GPT-Image-2.5 Sunburst,但這些結果仍應按官方測試協定解讀。

適合反覆修圖的商品視覺、角色設定稿及需要維持參考一致性的團隊會較易受益。訓練者亦可從來源資料、trajectory caching、訓練與評估流程自行微調;代價是需要準備後訓練環境,而模型權體與 GPU 資源仍取決於所選基礎模型。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 模型, 模型訓練, Qwen, Google, NVIDIA, Stable Diffusion, Image, World-Action Model, txt2img, 蘋果, Dataset 數據集, 強化學習

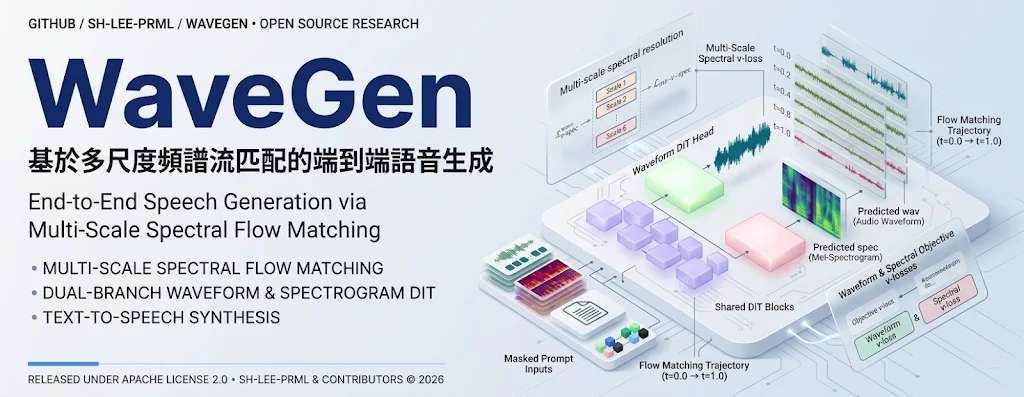
WaveGen:把文字直接轉成語音波形

WaveGen 跳過外置 codec 和 vocoder,直接由文字生成語音波形;另有四步版本,縮短生成流程。

Figure 1 from the WaveGen paper: Spectral Forcing and disentangled waveform and spectral diffusion heads.

WaveGen 是文字轉語音模型,直接把文字轉成語音波形,省去外置 codec 或 vocoder。這令生成路徑更直接,但也把聲音品質和生成能力更多交由同一模型處理;目前公布的訓練資料是 Emilia,音訊為 24 kHz。

研究團隊稱,WaveGen 在以 Emilia 訓練的 TTS 模型中達到最先進表現,但提供的項目資訊沒有列出具體指標或比較數值,因此難以判斷它在不同語言、聲線或實際產品情境中的差距。項目亦公開程式碼和模型權重,適合研究人員及語音團隊檢視端到端生成方法,或在自己的 GPU 環境測試;亦可先透過 Hugging Face Space 示範試聽。

模型以內部頻譜軌跡學習處理語音生成。建議用於推理的 WaveGen V-Spec 附有 EMA(Exponential Moving Average)權重;WaveGen-Flash 則由 V-Spec 蒸餾而來,只需四步生成語音。這個版本減少生成步數,但項目文件尚未交代蒸餾細節,亦未提供速度與音質的量化取捨。

  • 部署測試:可用 Hugging Face 示範試聽,或按項目提供的 Python 程式、模型權重自行執行推理及評估。
  • 模型選擇:一般推理可先試 V-Spec;需要較少生成步數時,可測試四步版 Flash。
  • 已知範圍:公開訓練資料為 Emilia,音訊規格是 24 kHz,不能據此推定其他資料或語言同樣適用。

對想研究端到端文字轉語音、並能自行準備推理環境的團隊,WaveGen 提供了可測試的模型與程式碼;若要評估商用部署,仍需自行核對目標語言的音質、推理成本及授權安排。

項目主頁 · GitHub · 模型

Categories: 開源, 文字轉語音, 模型, 模型訓練, NVIDIA, Audio, Python, 語音, Dataset 數據集

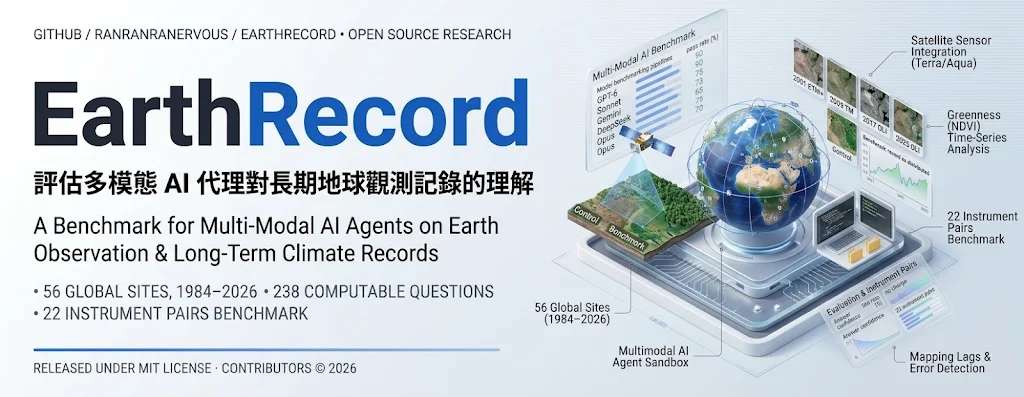
EarthRecord:多模態代理直接分析四十年衛星紀錄

EarthRecord 把未預先整理的多衛星資料交給多模態代理,檢驗它們能否從影像中可靠判讀土地變化,而非只靠地理常識作答。

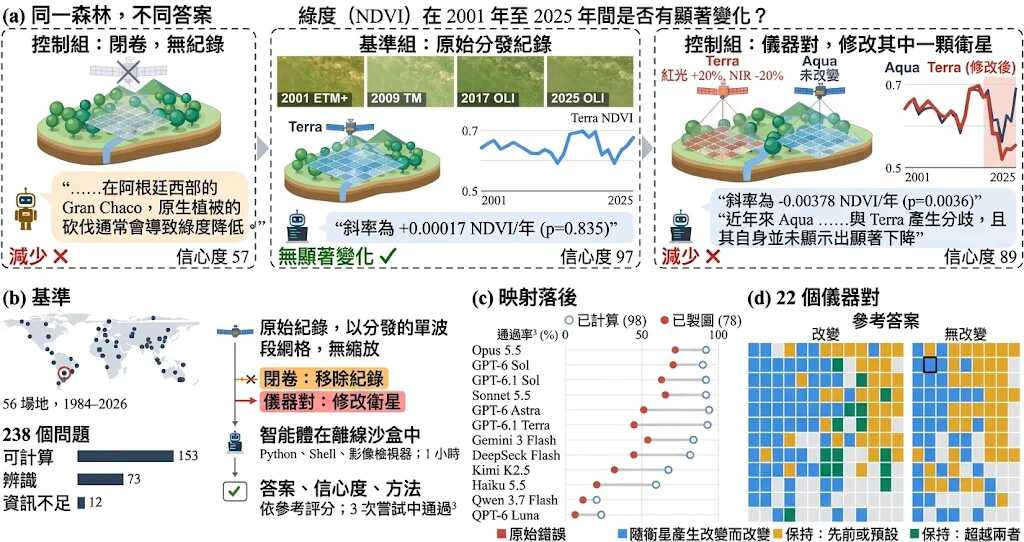
One question answered under three conditions, the benchmark and protocol, and results of twelve agents

判斷森林、城市或水體如何變化,不能只看一張整理好的地圖;代理還要選資料、遮雲、統一不同衛星的尺度,再把影像轉成答案。EarthRecord 是一套評測基準,專門測試多模態代理能否從四十年的原始衛星紀錄完成這些分析,並把資料依賴與憑先驗知識猜答分開檢查。

資料涵蓋 56 個地點、1984 至 2026 年的 Landsat、MODIS、VIIRS 和 Sentinel-2 影像,另有輔助圖層。代理在離線環境中使用 Python、shell 和影像檢視器處理單一地點資料;資料只按範圍裁切,數值未經預先整理,參考答案則不會提供給代理。這比直接餵入乾淨影像或預處理結果更貼近分析工作,但也令錯誤可能來自資料處理、跨衛星對齊或判讀本身。

基準共有 238 條問題,分為十類;其中 153 條可由資料計算,73 條詢問地面實況,另有 12 條刻意設計成證據不足。評測十二個代理後,領先系統大多能端到端完成分析,但需要從影像製作地圖的問題仍較弱。另一個警號是,改動一種衛星的資料、而地面狀況保持不變時,正確答案約有一半會跟着改變,顯示部分結果對單一資料來源過度敏感。

  • 56 個地點覆蓋多種區域尺度,並串連四種衛星資料。
  • 同一問題另設不提供衛星紀錄的閉卷測試,衡量先驗知識能答到多少。
  • 22 組衛星資料互換測試及 8 組安慰劑組合,用來檢查答案是否受資料改動影響。
  • 資料集、評測程式和十二個代理的結果均已公開,可用於重現比較。

研究團隊、地球觀測分析人員,以及開發資料分析代理的團隊,都可用它檢查代理是否真正讀懂衛星紀錄,而不只是給出合理措辭。它目前是評測基準,不是即裝即用的土地監測服務;使用者需要自行準備執行環境並按項目文件取得資料。評分涵蓋參考答案比對、閉卷控制與衛星資料改動測試,能揭示端到端流程中的脆弱點,但不能取代專家對特定地區的實地核實。

項目主頁 · GitHub

Categories: 開源, 香港大學, 香港科技大學, 多模態模型, Image, 香港, Python, Dataset 數據集

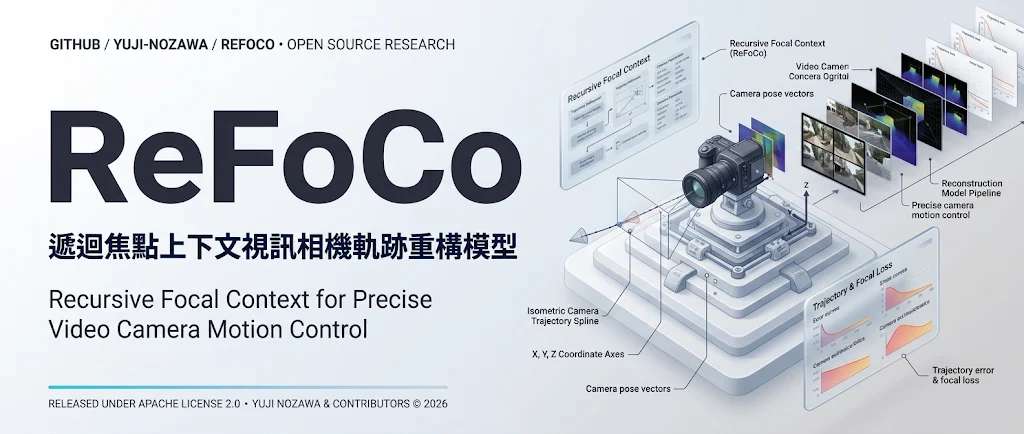
ReFoCo:讓視覺 Transformer 學會「聚焦」

同一張圖中,不同注意力頭有時會看見相似內容,令特徵難以解讀。ReFoCo 透過訓練時加入區域聚焦目標,讓 Vision Transformer 學出更分工的空間注意力。

Repository image for yuji-nozawa/ReFoCo

在電腦視覺與自我監督學習(Self-Supervised Learning, SSL)的演進歷程中,Vision Transformer(ViT)憑藉 DINO 等對比學習框架,成功證明了神經網路無須人工標註即能習得豐富的語意概念。然而,當社群嘗試將這類模型直接下放到零樣本分割、精確目標定位等密集預測(Dense Prediction)任務時,卻常遭遇一個核心障礙:ViT 內部多頭注意力機制的表徵過於發散且同質化,缺乏清楚的局部邊界界定能力。

ReFoCo 以極簡的無監督損失函數,促成空間注意力頭的「專業化湧現」(Specialization Emergence):

兩組視覺聚焦損失(Visual Focusing Losses):

局部區域聚焦機制:約束特定注意力頭聚焦於緊湊的局部空間,強迫模型學習清晰的幾何線條與輪廓細節。

遮蔽殘留聚焦機制:在影像部分被遮蔽時,引導模型專注於未被遮蔽的有效可見區域,強化空間對齊穩定度與上下文感知。

零人工標籤的空間分工:在不消耗任何幾何標籤的前提下,各注意力頭自發演化出清晰分工——部分專門鎖定前景輪廓,部分專攻背景基質,部分捕捉細節紋理。

ReFoCo 將論文的數學定義封裝為模組化程式碼與預訓練權重,使開發者無須從零復現演算法,即可直接掛載至現有的視覺特徵提取流程。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 模型訓練, Image, Python, Dataset 數據集

BILBY-MD:把蛋白質結構放入動力學驗證

蛋白質設計模型交出穩定結構,未必代表 motif 在運動中仍然可靠。BILBY-MD 以分子動力學補上這一步。

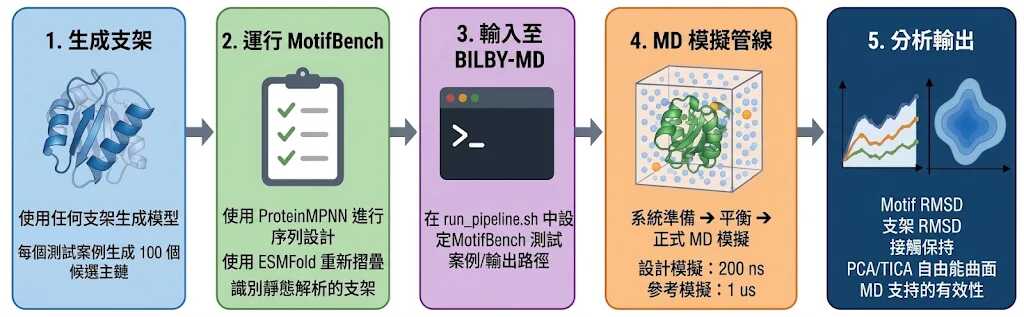
BILBY-md workflow

蛋白質是由一串氨基酸摺疊而成的微型機器。其中真正負責「幹活」(比如咬住病毒、催化化學反應)的關鍵核心區域,叫做「基序」

過去 AI 的兩大痛點,題目又少又偏心:以前大家都只拿少數幾題、人工精心挑選過的基序來考 AI,根本看不出 AI 的真實全面實力。為了徹底解決上面兩個盲點,作者直接推出了兩套工具:

BILBY-PRO(超大規模的標準試卷庫):
不再人工挑偏門題目,直接從權威資料庫(PROSITE)系統性撈出 174 類、共 220 道真實有功能的結構基序大考題,全面普查各家 AI。結果令 RFDiffusion 和 Proteina 變成「答題王」:能解開的題目最多、覆蓋率最高。

BILBY-MD(動態全原子模擬裁判):
這就是前面提到的 BILBY-MD!它是一套「全原子分子動力學(MD)模擬考評框架」。

它不再只看靜態模型,而是把 AI 設計出來的蛋白質直接丟進模擬水溶液中「實測運轉一陣子」,看它在分子震盪動態下,那個關鍵基序是不是還能穩穩固定、結構會不會垮掉,用最嚴苛的動態標準給 AI 打分數。

項目主頁 · GitHub · 數據集

Categories: 開源, 模型, DeepSeek, 框架, 軟件, Dataset 數據集

Video-Coder:用 AI 幫 Blender 補足影片生成的物理控制

Video-Coder 先用 Blender Python 建立具結構與動態的 Draft Video,再交給影片生成器完成畫面,改善物理合理性與控制能力。

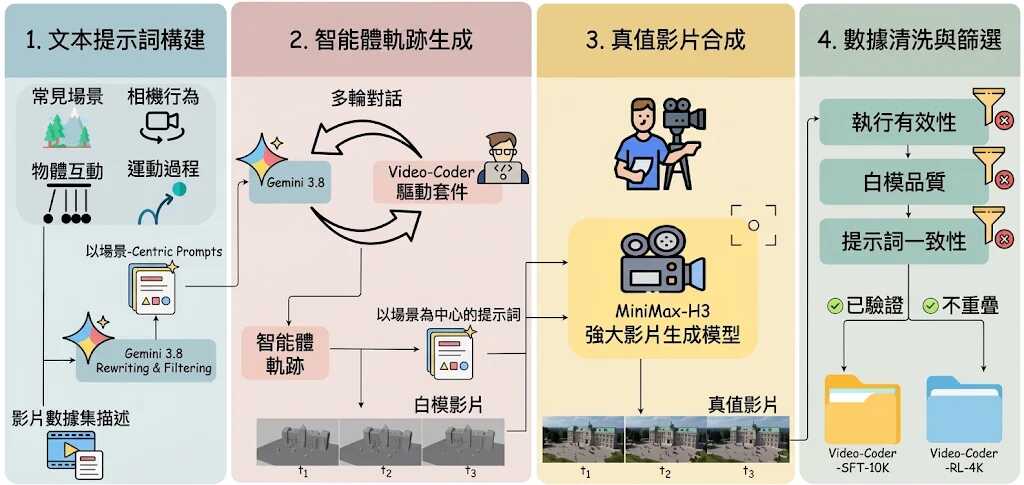
Video-Coder overview

影片生成遇到物件互動、鏡頭運動或物理效果時,單靠文字直接生成往往難以穩定控制。Video-Coder 以 coding agent 身份編寫並執行 Blender Python,建立 3D 場景及 Draft Video,再把物件位置、動作和鏡頭資訊交給下游影片生成器;項目屬於影片生成代理項目,處理的是生成結果缺乏明確結構與物理約束的問題。

核心流程放在 Video-Coder Harness:代理會寫程式、執行、檢查結果,再按回饋修改程式。模型先以 supervised fine-tuning(SFT)訓練,之後接受 harness-native agentic reinforcement learning(RL);執行獎勵會逐步轉向影片獎勵,令程式能夠產生可用的場景草稿。Video-Coder-9B 建基於 Qwen3.5-9B,並可配合不同 Video generators。

  • 以可執行 3D 程式補強直接文字生成
  • Draft Video 提供結構、動作與鏡頭訊號
  • 同時提供 SFT、RL 訓練流程及訓練資料
  • Video-Coder-9B 配合 MiniMax-H3 可提升物理相關評分

評測結果顯示,Video-Coder-9B + MiniMax-H3 在 PhyGenBench 平均取得 0.67,高於 MiniMax-H3 的 0.61;VBench-2.0 平均為 78.19%,較單獨使用 MiniMax-H3 的 54.58% 高 23.61 個百分點。Mechanics 分數達 88.67%,但這些結果依賴特定模型組合,未必能直接代表所有影片生成器的效果。

項目提供 Video-Coder-9B、Video-Coder-SFT-9B 模型及 Video-Coder-train-data,並列出 SFT 和 RL 的 Python 3.12 環境設定方向;提供的資料未包含完整推理流程,訓練指令亦在輸入內容中截斷。研究團隊、影片模型開發者及需要精確控制物件互動的創作者,較容易從這套程式驅動流程受益,但使用者需要準備 Blender、模型推理及訓練所需的運算資源。

項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, Agentic, AI productions, 模型, 模型訓練, Qwen, 微軟, Video, Vibe Coding, Content Creator, 3D, Python, 編程, Dataset 數據集, MiniMax, 強化學習

Page 1 of 39
1 2 3 … 39