VIEScore2 讓影像評分不再只剩一個分數

VIEScore2 同時評估影像質素、語意一致性與缺陷位置,將難以解讀的分數轉成可追蹤的修改方向。

teaser

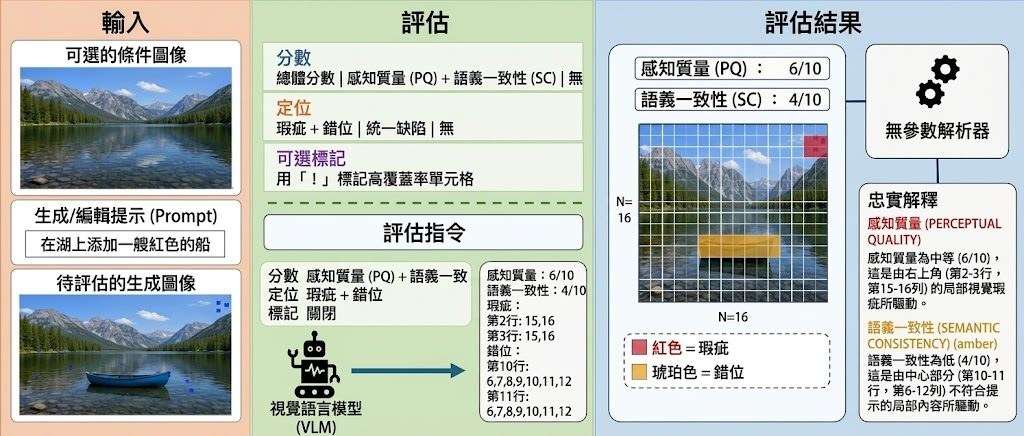
評估 AI 生成或編輯影像時,單一分數往往只能告訴你好不好,卻說不出問題在哪裏。VIEScore2 屬於影像評估模型,處理生成圖、編輯圖、提示詞及可選的條件影像,並在一次模型運算中輸出質素、語意一致性和缺陷位置。

Qwen3-VL-8B 經微調後,以自回歸方式同時預測 perceptual-quality(PQ)、semantic-consistency(SC)及 16×16 defect grid;artifact 和 misalign 兩個通道可分開標示視覺瑕疵與語意錯位。參數免訓練的 parser 再把網格結果穩定轉成文字解釋,避免說明內容與定位結果互相矛盾。

相比只輸出總分的評估器,VIEScore2 提供較具操作性的空間線索;相比通用 VLM,模型則專注於影像評分和缺陷定位,代價是網格以 16×16 單元表達,細節精度有限。訓練資料把 ImagenWorld、RichHF-18K、PAL4VST、COCO 的遮罩或熱圖,以及 EvalMuse-40K 的分數資料統一成同一格式,再以 SFT 和 GRPO 配合 cell-level Dice、分數準確度及格式有效性獎勵訓練。

GitHub 儲存庫提供評估協議、資料 manifests、外部測試集轉換器,以及 run_eval.py;可使用本地 checkpoint,亦支援 OpenAI、Gemini 和 Anthropic API backend。主要套件包括 AbHuman、AGIQA-3K、EvalMuse、PAL4VST 等評估集,適合研究影像生成模型、建立自動質量檢查流程,或分析編輯結果的錯誤位置。

  • 評分更完整:同時輸出 PQ、SC、缺陷網格及文字解釋。
  • 結果較接近人評:主要測試集 overall-score SRCC 為 0.601,最佳 VLM baseline 為 0.491。
  • 定位能力具競爭力:6 個定位基準中有 3 個取得最高 grid IoU,5 個進入前三。
  • 限制清晰:網格定位仍屬區域級提示,並需要按儲存庫協議整理資料與輸入格式。
項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 模型訓練, Qwen, NVIDIA, OpenAI, Gemini, API, Image, 提示詞, 庫, Anthropic

WorldSonus 為影片補上可互動立體聲音

WorldSonus 將影片動態、文字指令和立體聲音同步起來,讓世界模型生成的畫面不再只有無聲場景。

WorldSonus architecture

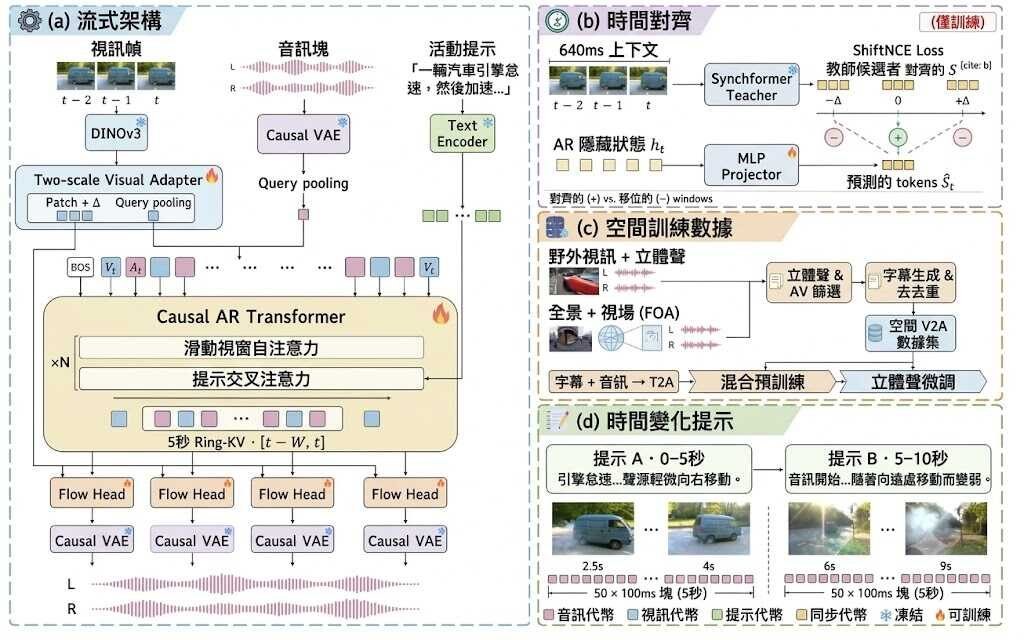
影片中的腳步、流水和列車聲可以隨畫面變化,甚至在生成途中接受新的文字指令。WorldSonus 是一個影片轉音訊模型,處理世界模型和互動影片缺少同步聲音的問題,並以每 100 毫秒一段的方式生成 48 kHz 立體聲。

它採用 streaming causal autoregressive diffusion 架構,讓影片畫面經過兩種時間尺度的視覺 token 後,交由 AR transformer 和 rectified-flow head 生成音訊。生成模型、audio decoder、normalization statistics,以及凍結的 DINOv3 和 T5Gemma 2 視覺/文字編碼器分工合作;文字提示可在 chunk 邊界更新,同時保留聲音連續性。

• 支援離線生成和 streaming generation,兩者使用同一條三幀生成路徑
• Visual temporal differences、Ring-KV 歷史狀態和 causal decoder convolution states 會跨 chunk 保留
• 可用影片加提示詞控制聲音,也可只用影片作條件
• 輸出為 stereo 48 kHz 音訊,片段長度會按 100 毫秒 chunk 向下取整

研究結果給出的 real-time factor (RTF) 是 0.41,並在開放領域 video-to-audio benchmark 中達到或超越部分雙向模型的聲學質素和空間對齊表現。不過參考實作沒有承諾固定延遲,模型和編碼器亦要在串流開始前載入,不能直接把 RTF 當成使用者必然取得的端到端延遲。

測試需要 Python 3.10 或以上、支援 CUDA 的 GPU、FFmpeg 和 ffprobe,GPU 驅動程式要預先安裝;設定程序會安裝 CUDA 12.4 的 PyTorch wheels。模型權重和編碼器可從 Hugging Face 下載,適合研究世界模型、影片生成、互動模擬或需要空間聲音的內容製作團隊,但硬件要求和上游模型的授權/存取條件仍需先核對。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, AI productions, 模型, 世界模型, NVIDIA, Gemini, Video, Audio, 提示詞, 香港, Python, Dataset 數據集

VeriHarness 長流程 AI 任務的修訂

長時間 AI 任務不再只靠一次輸出或投票,VeriHarness 讓模型查證分歧與共識,再交付有證據支援的成果。結果同一模型也能做驗證!

VeriHarness

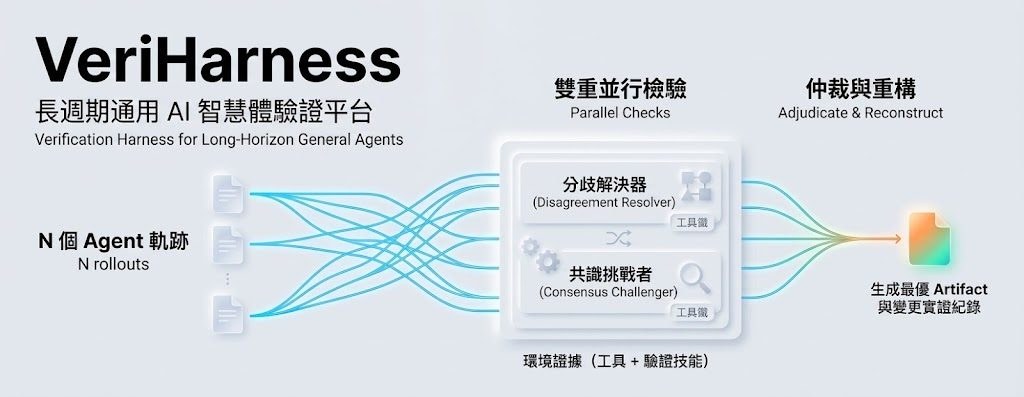
長時間 AI 任務容易在細節中累積錯誤,單靠一次 rollout 或多數票未必能找出共同誤判。VeriHarness 是一個面向 long-horizon general agents 的 verification harness,讓產生答案的同一個模型檢查環境證據、修訂成果,並記錄每項改動的原因。

它會把 N 次獨立 rollout 交給兩條調查流程:disagreement resolver 核對不同嘗試提出的主張,consensus challenger 則專門反查所有嘗試都同意的內容。兩邊取得文件、資料或可重新計算數值後,再由 adjudication 選取或重建 artifact,處理了「分歧不等於錯誤、共識也可能共同出錯」的取捨。

透過 Gemini on Vertex AI 或 Claude on Vertex AI 執行驗證;wb 與 wsb 評分器則在網絡容器中處理文件、試算表、程式碼及多檔案工作區任務。項目同時公開約 26,000 次 rollout,方便研究團隊重現流程或比較自己的 verifier。

結果顯示,Gemini 3.5 Flash 作為 generator 和 verifier 時,證據支援的修訂比單次 rollout 平均高 6.2 分;Claude Opus 4.8 則高 6.4 分,五個 benchmark 的十個 model–benchmark settings 均取得最高 primary selection score。這些數字反映選擇與修訂能力,不能直接等同完整 artifact 必然正確。

  • 適合長流程工作:文件、試算表、程式碼及多檔案任務均可納入檢查。
  • 核心差異:同一模型負責產生與驗證,優勢來自 rollout pool 結構及環境證據,而非更強的 judge。
  • 研究價值:分開測試 disagreement 與 consensus,能定位模型反覆犯下的共同錯誤。
  • 使用限制:需要模型服務、評分容器及可檢查的任務環境,配置成本高於單次生成。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, Google, Gemini, Anthropic, Dataset 數據集

ThinkV2V 讓影片編輯先思考再生成

ThinkV2V讓多模態模型先理解影片中的因果與隱含意圖,再交由DiT完成較複雜的指令式影片編輯。

ThinkV2V Overview

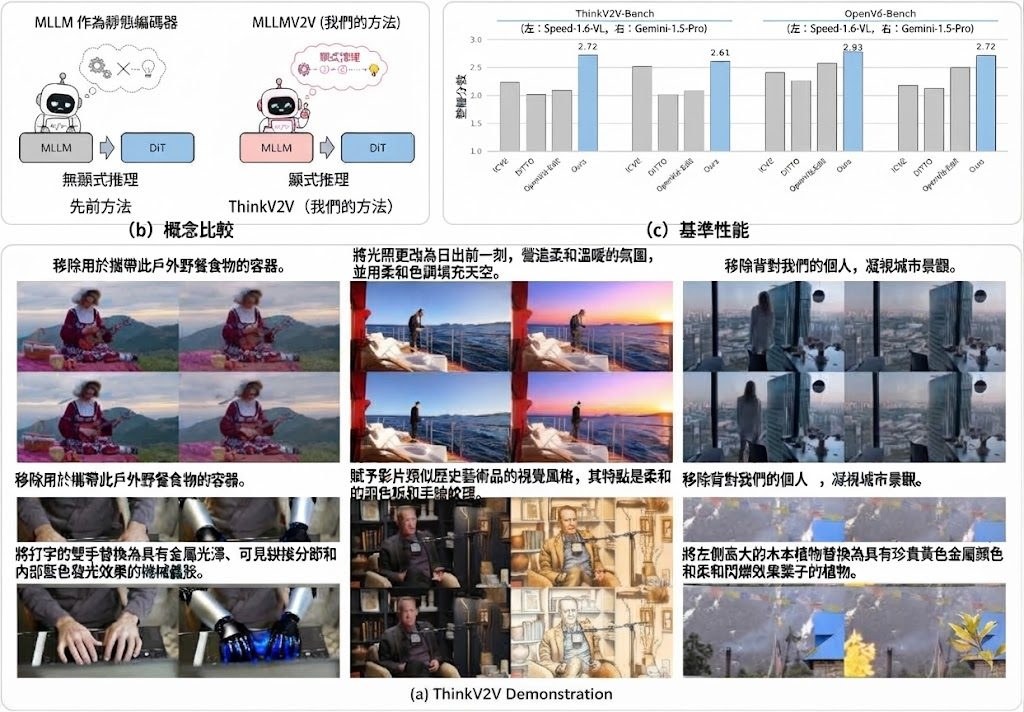
面對「按場景關係修改影片」這類指令,單靠文字語意對齊往往不足。ThinkV2V屬於推理導向的影片編輯框架,讓Multimodal Large Language Model(MLLM)先分析來源影片與指令,再把推理結果轉成DiT影片生成器可用的條件訊號,處理物件關係、時間變化及隱含意圖。

MLLM並非只擔任靜態語意編碼器,Qwen3-VL-8B-Thinking負責理解和推理,connector則把相關特徵對齊至DiT條件空間;原始文字嵌入、MLLM隱藏狀態及來源影片的VAE特徵會一同交由ThinkV2V-5B執行編輯。訓練由穩定的基本編輯逐步過渡至高解像度及推理密集案例,推理階段亦會生成多個候選計劃,再由MLLM篩選較可靠的一個。

  • 適合場景:需要根據時間脈絡、物件互動或因果關係修改影片的工作流程。
  • 評估資源:提供ThinkV2V-150K訓練數據集及ThinkV2V-Bench,後者包含308個樣本和5類推理密集編輯,預設支援720p。
  • 執行條件:Python 3.10、CUDA 12.x、PyTorch 2.6.0,並以torchrun或accelerate進行多GPU運算。
  • 資料限制:OpenVE-HQ-1M與ThinkV2V-150K主要是metadata釋出,下載腳本不會一併取得OpenVE-3M影片資料。

項目需要同時準備ThinkV2V、Qwen3-VL-8B-Thinking、Wan2.2-TI2V-5B及Lucy-Edit-Dev等權重,並按儲存庫指定的data與weights結構放置,較適合有CUDA多GPU環境及影片生成經驗的研究團隊。它相較只把MLLM當編碼器的做法,換取更深入的指令理解,但推理、多候選篩選及多模型權重亦會增加顯存、時間和安裝成本;儲存庫提供模型、資料集與基準測試,卻未在提供內容中列出可直接引用的量化領先幅度,不能只憑架構宣稱全面勝過其他影片編輯器。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 字節跳動, AI productions, 模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, 框架, 香港, Python, 庫, Dataset 數據集

Diffusion Controller:讓模型更準確聽懂提示詞

Diffusion Controller以輕量控制網絡改善提示詞對齊,同時保留原有影像質素與生成穩定性。

Og image

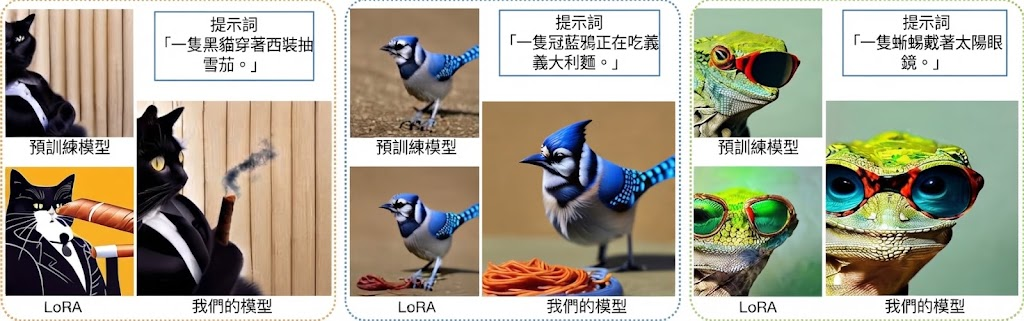
當影像模型明白你要一隻「戴太陽眼鏡的蜥蜴」,卻只生成蜥蜴,或勉強加入眼鏡後令面部變形,問題往往不在畫面是否逼真,而在提示詞要求與生成結果之間難以取得平衡。Google Research提出的 Diffusion Controller,正是針對這種提示詞對齊與影像質素互相牽制的情況而設計的輕量「steering damper」網絡。

Diffusion Controller可以接到包括 access-restricted、closed-source 模型在內的現有影像生成模型,無需改動基礎模型的核心結構,便能在生成過程中施加更精準的控制。它將原本由隨機噪聲逐步還原成影像的 denoising process,重新理解為一個連續、平滑的 control problem,讓控制訊號不必只在個別步驟中硬性修正結果。

  • 改善文字提示與生成影像之間的 prompt alignment
  • 以輕量 add-on network 控制現有模型,兼容 access-restricted、closed-source 模型
  • 在提升指令符合度的同時,維持 baseline stability 和原有影像質素
  • 將 inference-time guidance 與模型微調放入同一套分析框架
  • white-box 版本在所述測試中取得相對 baseline model 的 90% 勝率

過往做法通常分成兩條路線:一類是在 inference time 使用 classifier-free diffusion guidance,調整文字提示對生成過程的影響;另一類則透過 parameter-efficient adapters,例如 LoRA、reward-weighted regressions 或 policy gradients,對模型行為進行較重的微調。Diffusion Controller嘗試以統一的數學語言連接這些控制方式,減少工程師靠反覆試驗,在使用者偏好、提示詞要求和影像質素之間摸索的需要。

Google Research表示,Diffusion Controller的輕量版本表現優於用於配合人類偏好的業界標準方法;完全解鎖、可直接修改模型內部權重的 white-box 版本,則相對 baseline model 取得 90% 勝率。這些結果反映項目適合需要精準遵循文字描述、同時不希望破壞原有生成穩定性的影像工作流,但提供的內容未包括下載連結、安裝步驟或完整使用流程,讀者仍需等待論文或官方程式碼資料作進一步驗證。

項目主頁 · Paper

Categories: Google, Gemini, Image, 影像處理, 提示詞, 框架

Dream-RSI:讓 AI 先在探索紀錄中演練,再投入昂貴的搜尋

Dream-RSI 把 AI 過往探索過程變成可重播的模擬環境,讓新策略先離線比較,再挑選勝出者投入下一輪搜尋,減少試錯成本。

Google

當 AI 要花數千輪提出和評估方案,探索方向選得不好,計算資源便會浪費在無效搜尋上。Dream-RSI 是一套用來改進 AI 探索策略的遞迴自我改進框架,讓策略先在既有探索紀錄中演練,再決定是否投入昂貴的線上搜尋。

它不另建一個學習出來的世界模型,而是把代理過往建立的探索樹當成可重播的模擬器。系統在線上收集搜尋歷史,再離線測試多個候選策略;選出的策略才會部署到下一輪,並帶回新的探索紀錄,逐步擴大可供演練的經驗池。這做法省去逐一實跑候選策略的成本,但模擬範圍受限於過往探索到的路徑,未曾出現的情況仍須在線上驗證。

目前公布的測試涵蓋演算法工程、數學最佳化及 GPU kernel 工程,共八項任務。在演算法工程中,與 Recursive Fixed Exploration 相比,下游執行速度提高 1.22 倍,探索計算量減少 1.74 倍,呼叫次數比 SimpleTES 少 162 倍;GPU kernel 的四項測試全部改善,同等預算下效能提高 2.09 倍。數學最佳化則有三項中的兩項達到或超越所選基線,結果仍需按任務解讀,不能視為所有搜尋問題都會有相同收益。

這套方法較適合需要長時間、多輪探索的演算法與工程研究團隊,尤其是每次線上評估成本高昂的工作。程式碼仍在準備發布,現階段可閱讀技術報告與論文了解方法和結果;儲存庫尚未提供可直接安裝執行的公開版本。

  • 探索樹被重用為策略演練環境,不必為每個候選策略重新執行完整搜尋。
  • 每輪勝出的策略會投入線上搜尋,並補充新的探索歷史。
  • 已測試三個領域、八項任務,GPU kernel 測試四項全有改善。
  • 模擬器只涵蓋已探索的搜尋空間,公開程式碼仍在準備中。

項目主頁 · GitHub

Categories: 開源, Embedding, Google, Gemini, 框架

BVB 用 影片內容令 AI 自動轉為 Blender 3D 場景

BVB 拋開選擇題,要求 AI 代理直接用 Blender 重建 288 段真實室內影片,從程式碼品質判斷它到底有冇真正理解畫面內容。

BVB logo

現時大多數影片理解 benchmark 都係問 AI 「張圖入面有幾多張椅」,但 BVB(Blender-VideoBench)行另一條路:畀 AI 睇一段室內影片,然後叫佢自己寫 Blender 腳本,把場景、鏡頭動線逐個 primitive 砌返出嚟。如果代理人交到一個可以重新開啟、可以渲染嘅 .blend 檔,代表佢真係睇明條片。

每個代理會都被困喺同一個 Blender 4.2 Docker 沙盒入面,淨係可以用 bash 同 frames,仲有共享成本上限。禁止使用任何外部素材庫,幾何體全部由代理自己用基本操作砌出嚟。呢種「同條件競技」設計解決咗以往影片 benchmark 靠選擇題容易被 prompt hack 或者背答案嘅問題。

數據方面,BVB 用咗 ARKitScenes、ScanNet、ScanNet++ 嘅 288 段室內影片,配合 5,130 條時空題目,並涵蓋 10 個模型家族、共 51 個配置。評分用兩條軸:Dual VQA 睇重建場景保留幾多影片入面嘅時空事實;Latent Similarity 就用凍結影片 embedding 對比重建結果同原片嘅感知距離,再以平方根均值合成綜合分數。

對做空間智能、機器人感知或者影片理解研究嘅團隊嚟講,呢個 benchmark 提供咗一個更貼近「代理人真係要喺軟件入面操作世界」嘅測試場景。視頻生成、動畫製作或者世界模型團隊亦可以直接借用 Mini-BVB harness 喺自己 pipeline 度做壓力測試。

團隊結果顯示,最強配置喺 Latent Similarity 做到 88.6,但 Dual VQA 仲有明顯差距,代表現時頂級模型仲未做到「理解」同「重建」兩條線同步推進。呢個落差本身就係 BVB 想凸顯嘅訊號:識答題未必等於識建模。

重點摘要

  • 288 段真實室內影片,全部來自 ARKitScenes、ScanNet、ScanNet++ 嘅 held-out split。
  • 51 個代理配置橫跨 10 個模型家族,統一跑喺 Mini-BVB 沙盒同成本上限下。
  • 禁止使用外部素材庫,逼代理人由 Blender primitives 自己砌幾何。
  • 評分用 Dual VQA 加 Latent Similarity 兩條軸,避免單一指標偏廢。
  • 目標係可執行、可重新渲染嘅 .blend 檔案,而唔係文字描述或者單張圖。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, Embedding, 視覺模型, 多模態模型, 世界模型, Qwen, OpenAI, Gemini, Video, 軟件, 庫, Anthropic, 動畫, Dataset 數據集

jarvis-voice-butler:識睇住嘢同你傾偈 + 開瀏覽器幫你查資料

用講嘢就可以叫 AI 幫你上網、搜尋、填表,仲配上一把英式管家口吻。這個項目把 LiveKit Agents、Google Gemini Live 同 Playwright 串成一套聲控代理人。

Repository image for ruxakK/jarvis-voice-butler

聲控助手最麻煩嘅地方,往往係講完一句佢就要重新聽成段指令,又或者根本無法直接代你落手做嘢。Jarvis 直接針對呢個卡位,把 LiveKit Agents 框架、Google Gemini 3.1 Flash Live 即時語音模型,同 Playwright 操控嘅 Chromium 瀏覽器三樣嘢扣埋一齊。你可以理解成一個識講英式冷笑話嘅 AI 管家:你開口叫佢搜尋資料、撳掣、打字、捲頁、讀網頁內容,佢都會即時用「Enceladus」把聲回應你,過程仲支援自適應打斷同搶先生成。

對比起一般只能對答嘅語音 bot,呢個項目最大嘅突破係將語音輸入直接打通到瀏覽器操作層。佢內建十一個工具,包括開網址、搜尋、讀取同檢查頁面、撳掣、打字、捲動、撳掣鍵同截圖,仲有一個 confirm_browser_action 安全閘,去處理會造成實際後果嘅動作,例如提交表單或者刪除資料。視訊鏡頭輸入亦支援,等 AI 可以「睇到」你。

How to build a JARVIS AI Voice Agent for FREE | Full Livekit Tutorial (2026)

如果你想由頭砌起,作者用 uv 管理 Python 依賴,前端就用 Next.js 加 React,而家嘅程式庫亦用 Python 寫評估測試,覆蓋代理行為、瀏覽器操作同 prompt 表現。前端介面跟住會播一段自訂粒子動畫,連 Flutter 手機客戶端都一齊包埋,等你可以用手機當遙控。

呢類項目最適合做內部自動化研究助理,或者需要示範 Computer-use agents(CUAs)點樣融入聲音介面嘅團隊。值得留意嘅限制係實作仍處於早期階段,prompt 同安全策略都係寫死嘅版本,如果你想用佢處理高風險任務,仍然要自行加多一層審批同監察。

GitHub

Categories: 開源, Agentic, Google, Gemini, Audio, 框架, 工具, Python, 庫, 語音, 動畫

Wenyi 把整本書放進記憶:一次譯完一本書,角色名終於唔再走樣

Wenyi 是一款針對小說、專書同長篇敘事嘅開源翻譯工具,主打逐章掃描、術語即時對齊同可斷點續譯,支援 DeepSeek、OpenAI、Gemini 等多個模型供應商。

wenyi emblem

好多人試過用大型語言模型 (LLM) 翻譯小說或學術專書,往往喺第三、四章就發現角色名譯咗另一個譯法,或者術語前後矛盾,要回頭逐段人手修正。Wenyi 就係針對呢個常見痛點而設計嘅 Python 開源工具,主打長篇文本嘅翻譯流程。佢會事先將全書掃描一次,為每個章節建立摘要同全書概要,再喺逐批翻譯時一齊注入,令模型對脈絡同角色關係有長期記憶。

工具同時內建術語管理模組,會隨翻譯過程自動抽取人名、地名同專有詞彙,並偵測前後唔一致嘅譯法,要求人手仲裁,再影響後續批次。咁樣嘅設計對譯者、編輯同人氣翻譯團隊特別有用,可以避免「譯到後期先發現譯名漂移」嘅慘況。Wenyi 仲提供可選嘅多階段品管:先以主力模型做初譯,再由較強模型做潤稿,最後以證據導向嘅方式做整書 AI 審閱,適合對品質要求高、但又想慳人手嘅場景。

操作上,每批翻譯都有 checkpoint 落盤,章節狀態有獨立追蹤,任何時候中斷都可以用同一個指令續譯。支援嘅模型供應商包括 DeepSeek、OpenAI、OpenRouter、OrcaRouter、Google Gemini、Ollama、vLLM 及任何 OpenAI 兼容端點,可分為三個方便嘅 tier,亦可每個操作揀唔同模型。輸出格式方面,佢會直接寫返入原 EPUB 嘅 XHTML 模板,嘗試保留樣式、圖片、目錄同錨點,對電子書排版敏感嘅讀者會幾啱用。

要注意嘅限制係,Wenyi 仍然依賴上游模型嘅語言能力同上下文窗口,對語氣、文風同微妙雙關嘅判斷無可避免會受模型本身限制;長篇翻譯嘅成本同時間亦會隨章節增加。文檔列明需要 Python 3.10 或以上,社群主要喺 Discord 運作。

重點摘要:
– 全書預掃描 (Whole-book prescan):每章摘要 + 全書概要同時注入翻譯批次
– 即時術語同衝突偵測,可人手決議後回寫後續翻譯
– 支援 DeepSeek、OpenAI、Gemini、Ollama 等多 LLM,可分三層 tier
– 提供 checkpoint 續譯,中斷後同一指令可接返
– 多階段品管:初譯 → 強模型潤稿 → 全書 AI 審閱,並原生保留 EPUB 排版

GitHub

Categories: 開源, Google, OpenAI, DeepSeek, Gemini, Image, 工具, Ollama, Python

Dr. Claw 把 AI 研究流程收進一個可審核工作台

一款開源 AI 研究助理,把文獻回顧、實驗、寫作整合在同一介面,讓人類決策與 AI 執行之間留下可追蹤的紀錄。

Dr. Claw

跑過 AI 研究的團隊都遇過同樣的痛:Claude Code、Gemini CLI 等命令行編碼代理(coding agents)能讀寫檔案、撐住長對話,但文獻回顧、構思、實驗、寫論文、投期刊這些步驟散落在聊天工具、IDE、終端機、寫作軟件之間,中間決策也難以回頭追溯。Dr. Claw(GitHub: OpenLAIR/dr-claw)針對的正正是這個碎片化問題——它不是另起爐灶造一個新代理,而是把現有命令行編碼代理(Claude Code、Gemini CLI、Codex,以及透過 OpenRouter 接入的數百個模型)包進一個可控、可審核、人在回路(human-in-the-loop)的工作流。

項目覆蓋 survey → ideation → experiments → paper writing → slides & promotion 整條研究生命週期,與只懂執行程式碼的 CLI 代理相比,差異在於「全流程編排層」。底層靠三個關鍵設計撐起這層:持久化狀態物件(persistent state objects)、可重用技能庫(reusable skill library),以及多執行器協調(multi-executor coordination),把計劃、執行、寫作綁成一條可恢復的循環。論文亦明確指出,比起只共享同一後端執行器的裸 CLI 代理,Dr. Claw 在研究完整性上得分更高,同時保留可審計、可回溯的過程痕跡。

對獨立研究者、AI 實驗室團隊、需要把研究流程制度化的單位而言,這套架構的價值在於把人類決策(目標、約束、驗收)與 AI 執行清楚分開,並透過 checkpoint 反饋(Verify / Revise / Retry / Handoff)保留介入點。它支援本地部署(自家機器、自家 GPU、自家資料),亦提供桌面版(.dmg / .exe)或 npx dr-claw 零安裝啟動,甚至能在終端機直接 dr-claw chat 跑 agentic 對話。

項目已被 EMNLP 2026 System Demonstrations track 收錄(arXiv: 2609.00365),並採用 AGPL-3.0 搭配上游 GPL-3.0 元件授權,免費、無訂閱。需要留意的是,它自定位為 Anthropic Claude Science 的開源、模型中立替代方案,主打全生命週期而非單純計算分析。

GitHub · Paper

Categories: 開源, Agentic, 模型, OpenAI, Gemini, 軟件, 工具, IDE, 庫, 編程, Anthropic, Skill 技能

Page 1 of 9
1 2 3 … 9