Route Anything:按輸入選模型,兼顧品質與成本

面對文字、影像、影片、語音和機械人任務,Route Anything 研究路由器如何按輸入挑選候選模型或策略,並在品質容許範圍內減少成本。

Repository image for InfRec-Cardinal/route-anything

處理不同類型任務時,系統未必要每次都交給同一個模型或機械人策略。Route Anything 是一套研究實驗程式碼,探討路由器如何按輸入選擇候選方案,並在品質下降有限的前提下控制成本,涵蓋語言模型、影像、影片、語音生成器及機械人策略。

選擇與固定候選方案:在 24 個基準、19,814 個測試輸入上,理想路由得分為 87.98,固定方案為 82.60;但這個差距代表潛在上限,不等於訓練出的路由器已能達成同等收益。實際訓練的能力樹路由器在 16 個基準上只高 0.3 分,影片生成則高 2.1 分。

成本實驗顯示,四個測試環境平均效率提升 8.82 倍,品質損失低於 0.5 分;程式碼任務提升 25.5 倍,文字問答提升 7.1 倍。機械人測試中,結果路由器提升 1.1 分並減少 24% 策略執行時間;以勝出標籤預測結果的成功率為 42.8%,結果回歸則為 71.55%,反映訓練目標會左右路由效果。

  • 路由依據是路由器可觀察的輸入資訊,並按預期價值扣除成本選擇候選方案。
  • 參考策略與品質容忍度用來設定成本價格,適合比較省成本幅度與品質底線。
  • 程式碼提供路由實作、離線重播及品質底線認證工具,可按實驗指南重現部分測試。

研究團隊或需要在多種模型、生成器與機械人策略間分配任務的工程團隊,可用這套工具檢驗路由是否值得加入工作流程。限制是全模態實驗所用的軌跡矩陣並未公開,因此相關結果未必能完整重現;公開的程式碼與文字測試資料目前只支援部分實驗。
項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 模型訓練, Video, Image, 工具, 語音

TaoMate-FVSR:用音訊與稀疏參考修復人臉影片

小臉在影片中容易失去細節,換上新配音時口形也可能對不上。TaoMate-FVSR 把音訊、參考畫面與生成歷史一併用於人臉修復,亦支援視覺配音。

favicon

影片中的人臉太小或細節模糊,單純放大未必能還原自然的面貌;換上新語音後,嘴形亦要配合音訊。TaoMate-FVSR 是一套人臉影片修復推理工具,利用音訊、稀疏的視覺參考和生成畫面歷史重建臉部,支援保留原聲修復,以及配合替換語音進行視覺配音。

它把臉部細節與口部動作放在同一個重建流程處理,並以來源影片保留場景結構,再由高質素參考提供外觀線索、目標音訊引導嘴部動態。相比先做超解像、再交給另一個配音模型的分段流程,這種聯合處理方式有機會減少修復結果與口形之間的不一致。

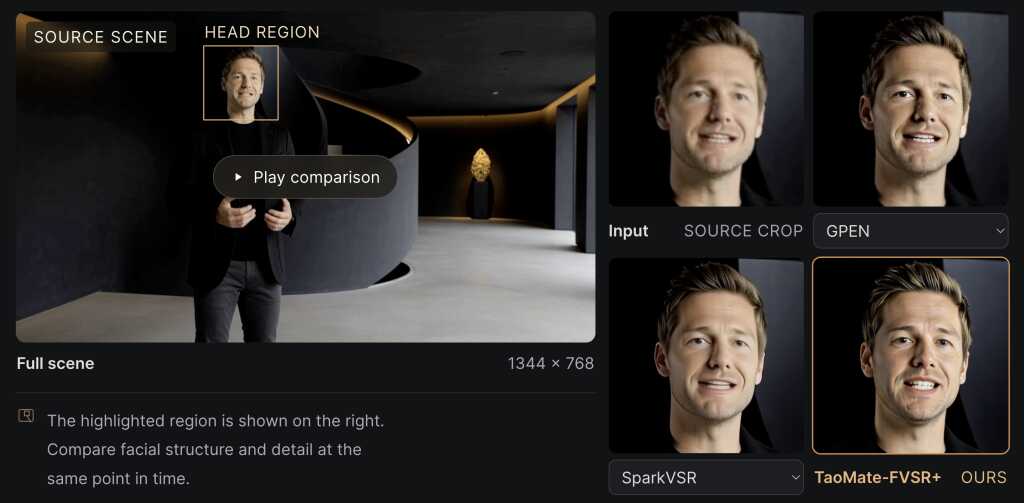
畫面可用 GPEN 處理首幀作參考,也可以提供自行編輯的首幀或完成的參考圖。推理流程會先以 DWPose 裁切人臉,再做修復、色彩與遮罩融合,最後貼回原影片;模型可按 1× 或 2× 尺寸運算,合成前會縮回 512×512,因此輸出場景維持原有尺寸。全場景比較也有助檢查修復臉部與原本畫面是否協調,但身體和背景不會一併提升解像度。

  • 支援原始音訊修復及替換語音配音。
  • 可用 GPEN、外部編輯首幀或完成的參考圖提供外觀線索。
  • 1× 與 2× 推理分別使用 512×512 與 1024×1024 處理尺寸。
  • 執行需要支援 BF16 的 NVIDIA CUDA GPU,以及 CUDA 版本相容的 PyTorch 2.6 或更新版本和 torchvision 0.21 或更新版本。

這套工具較適合需要修復 AI 生成影片人臉、製作配音版本,或比較局部臉部細節與完整場景效果的創作者及研究團隊。參考畫面質素和場景合成效果都會影響最後成果,正式製作前宜用自己的素材測試。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, NVIDIA, Video, Audio, 工具, Content Creator, 線上服務, 語音

Lemo-Opuscar:讓 coding agent 用 66 種程式影像風格拍片

想把故事變成風格鮮明的短片,可以從 66 種程式製作的影片風格選擇,再交由 coding agent 協助導演。

OPUSCAR 98 — 98 Years of Best Picture

想把文字故事變成短片,又希望畫面不只停留在一般生成影像的風格,Lemo-Opuscar 提供 66 種可直接選用的程式影像風格,並支援自行修改或從空白開始創作。它是一套以程式碼製作影片的風格工具箱,讓 coding agent 按所選風格處理故事呈現;每種風格亦附有短片示例,方便先看效果再決定方向。

畫面由 canvas 和 WebGL 網頁逐格繪製,音樂採用免費取樣音源製作原創配樂,旁白則使用文字轉語音。這種做法把視覺風格、配樂和旁白組合成一條影片製作流程,適合想快速嘗試不同美術呈現的創作者,也可用於資料敘事、紀錄片及短片概念驗證。

使用者可以先到線上風格展示頁瀏覽範例,再挑選風格、提供故事,或修改既有風格及自行建立新風格。

風格針對 Claude Opus 5.5 調校,作者提醒其他模型未必能重現相同效果;這是選用工具時需要納入考慮的限制。項目亦展示每部作品配合相應風格呈現,說明這套方法可用於較長篇幅的主題作品。

  • 提供 66 種可用影片風格,並可修改或自行創作。
  • 以 canvas、WebGL 逐格繪製畫面,並結合配樂與文字轉語音旁白。
  • 可先瀏覽線上展示頁和短片範例,再決定風格與故事方向。
  • 風格主要針對 Claude Opus 5.5 調校,其他模型的重現效果未有保證。

GitHub

Categories: 開源, 文字轉語音, Agentic, AI productions, 模型, Video, Image, Vibe Coding, 工具, Content Creator, 編程, 語音, Anthropic, 音樂

huashu-motion:AI Agent 按節奏製作產品宣傳片

由 Claude Code 或 Codex 讀取產品內容、編排動畫和配樂,再讓你在瀏覽器畫面上指定位置修改。製作流程可在本機完成,配樂亦毋須呼叫付費接口。

huashu-motion发布片开场:一整面墙的片子,说一句,出一支片

想把產品介紹變成一支短片,可以直接向 Claude Code 或 Codex 提出需求;huashu-motion 會先閱讀產品內容,提供三個創作方向,再編寫動畫與配樂,並在瀏覽器開啟編輯器。它是一套供 AI Agent 使用的動畫製作 skill,處理從產品內容到宣傳片、再到局部修改的工作流程。

修改方式著重畫面定位:在預覽中按 C,再點選要調整的位置並留下意見。評論會附上時間點、場景、所選元素及其原始碼位置,Agent 可針對該處修改;版本會保留,亦可撤回。標題、數字、顏色和停留時長等項目則可直接在編輯器輸入框調整。

配樂不是完成影片後才補上的背景音。Agent 會先按節奏單寫 ABC 記譜法樂譜,並以樂譜標記配合場景切換;樂器音色可選本機採樣或合成音色,音效則配合畫面元素落地的時刻。本機生成配樂不需付費接口;使用三腳鋼琴、弦樂和鼓組等真實樂器音色,需另行下載約 55MB 採樣。口播亦屬可選功能,Kokoro 中文語音和逐字對齊各有額外安裝需求。

項目列出以 Chrome、Chromium 或 Edge 執行截帧、檢查及匯出,不需另外下載渲染器;也展示 Claude Code、Codex 和 DeepSeek V4.1 Flash 等案例。當中一支 22 秒動效片以 DeepSeek V4.1 Flash 製作,經三輪修改,不到半小時完成;文中記錄當時費用為 1.95 元,不能視為固定成本或其他模型的效能保證。安裝方式雖有列出,但資料沒有完整說明各平台的操作流程,首次使用仍要按所選音色和口播功能處理相應依賴。

  • 先閱讀產品內容,再提供三個方向並生成完整短片。
  • 在預覽指定畫面位置,讓 Agent 針對局部修改;版本可保留和撤回。
  • 配樂以 ABC 樂譜和場景標記同步,音樂及音效可在本機生成。
  • 可透過瀏覽器截帧、檢查和匯出;真實樂器採樣與中文口播需額外依賴。

這套流程適合需要快速製作產品發布片、又希望保留逐處審核和修改能力的產品及設計團隊。它把創作交給 Agent,但仍讓人透過畫面評論調整細節;採樣下載、語音工具安裝及各平台實際操作方式,則是導入前需要確認的成本。

GitHub

Categories: 開源, Agentic, AI productions, 模型, DeepSeek, Video, 工具, 語音, Anthropic, 動畫, 音樂, Skill 技能

HDR mini-skill 讓 AI 片由 SDR 轉為 HDR

纯 ffmpeg + 自己生成的 3D LUT,不依赖 zscale / libplacebo / drawtext(Homebrew 的 ffmpeg 常常没带)。

Repository image for limin112/min-skill

把普通(SDR)視頻或其中一段,轉成 10-bit HEVC / HLG / BT.2020 的 HDR 文件:在 HDR 屏幕上,雲、太陽、水面反光、 金屬高光會“發光”。還能做左右對比:同一個文件里左邊 SDR、右邊 HDR。

  • 輸出 HLG HDR、10-bit HEVC 及 SDR/HDR 對比片。
  • 效果取決於素材。 米色卡片、文字、PPT 這類畫面轉成 HDR 只是把“紙”變亮,不適合。
  • 只有在 HDR 屏(Mac XDR、iPhone)上用 QuickTime 才有效果;普通播放器里會發灰、紅偏橙,這是正常的。
  • 原片已經是 HDR 的,腳本會拒絕(退出碼 2)。
  • 沒在真正的 HDR 屏上做過觀感驗證,也沒驗證過上傳各平台後是否保持 HDR;詳見 SKILL.md 末尾“已驗證 / 沒驗證”。

GitHub

Categories: 開源, 文字轉語音, AI productions, 數字人, 模型, Video, 框架, 工具, Content Creator, 3D, 庫, 語音, Anthropic, MiniMax, Skill 技能, LoRA

CoSTA:壓縮語音生成序列,提升對話模型推理速度

語音對話模型可以先產生較短的語音 token 序列,再還原成原有格式的合成波形。CoSTA 在中英文基準測試中提升生成速度,並保留原有語音 tokenizer 和 decoder。

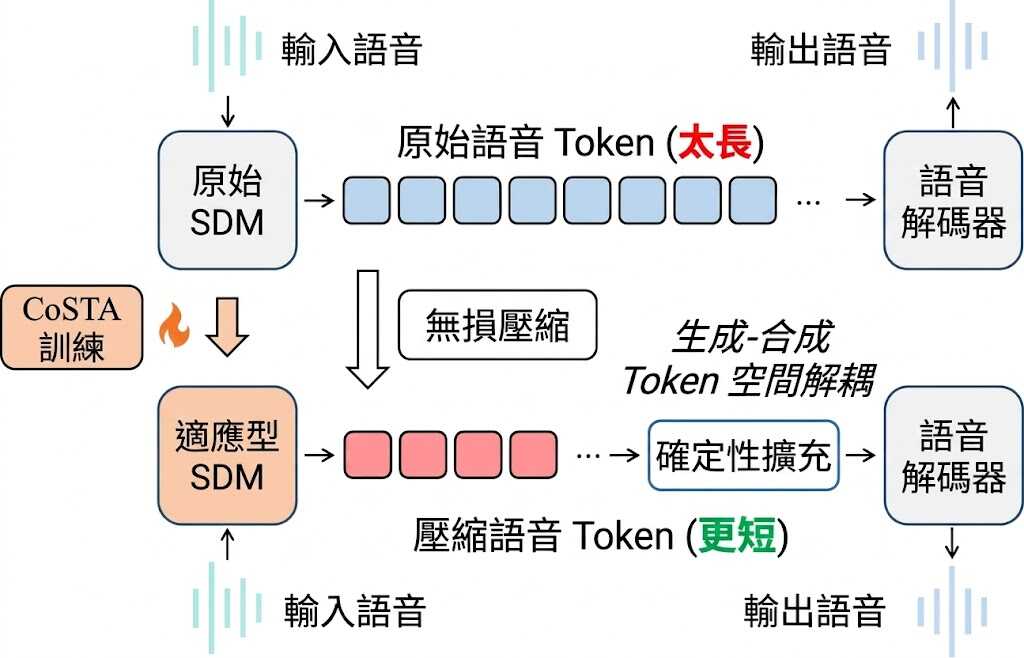
CoSTA separates compressed speech-token generation from original-token synthesis.

語音對話模型要逐個生成語音 token,序列較長時會拖慢回應。CoSTA 是一套語音模型適配方法,透過壓縮生成序列加快推理,同時保留原有語音 tokenizer 和 decoder,讓壓縮後的 token 可在合成波形前還原。

CoSTA 使用 byte-pair encoding(BPE)學習合併語音 token,並以原有 token 的 embedding 和 LM head 權重平均值初始化新增詞彙。適配分階段進行:先訓練發音,再調整語音對話輸出,讓模型生成交錯的文字與語音內容。它改變的是生成時使用的 token 空間,而非取代負責語音合成的原有元件。

在中英文基準結果中,CoSTA-ZH 的壓縮序列保留原 token 數量的 66.81%,擴展後語音 token 生成速度為每秒 101.99 個;CoSTA-EN 分別為 70.17% 和每秒 99.05 個。兩者相對 Step-Audio 2 mini 的速度為 173.63% 和 165.94%;這些結果反映特定基準測試,不能直接當成所有模型或硬件上的延遲保證。

對已有語音對話模型、希望提高回應速度而不重建語音合成流程的研究團隊,CoSTA 提供了一條可評估的適配路徑。GitHub 提供程式碼與論文連結,但模型權重及資料集仍標示為即將推出,現有資訊亦未列出完整安裝及測試流程。

  • 壓縮自回歸生成用的語音 token 序列,再於合成前確定性還原。
  • 保留原有語音 tokenizer 和 speech decoder。
  • 中英文基準測試均報告高於 Step-Audio 2 mini 的生成速度。
  • 權重與資料集尚未提供,現階段難以直接復現完整流程。

項目主頁 · GitHub

Categories: 開源, Embedding, 模型, 模型訓練, Audio, 語音, Tokenize

WeVisCut 單一 9B 模型自主剪出多分鐘知識影片

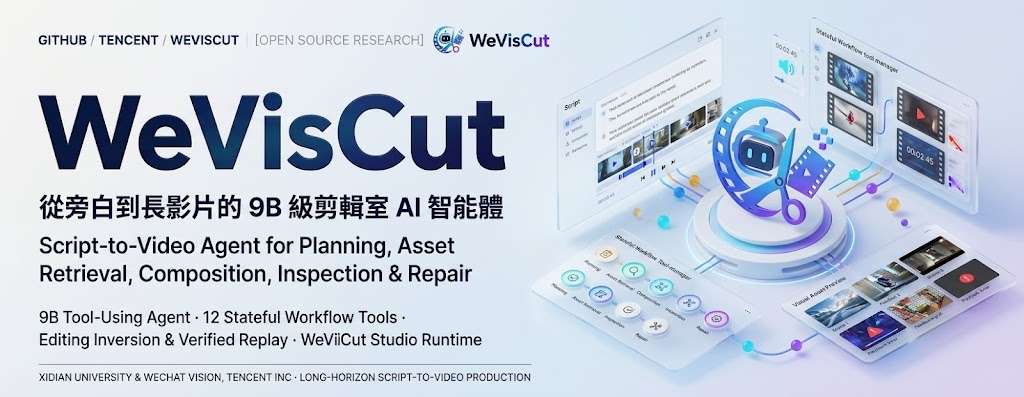
由文章或旁白稿生成多分鐘影片,WeVisCut 讓模型逐步選擇剪輯工具,並可在時間線上修改成片。運行 9B 模型約需 24 GB NVIDIA GPU。

WeVisCut

把知識文章或旁白稿變成多分鐘影片,通常要處理分段、鏡頭、配音、素材、字幕和配樂。WeVisCut 是一個長流程影片剪輯 Agent,由單一 9B 模型讀取剪輯狀態,每次呼叫一項工具,逐步完成製作;它處理的是長篇內容轉成可編輯成片的流程,而非只生成單一畫面或短片段。

模型不依照寫死的階段流程前進,而是按當前狀態決定下一步;防護規則只會拒絕不合法的操作,不會代替模型選擇。每次任務通常約有 12 次工具呼叫,涵蓋文章分段、鏡頭規劃、語音合成、素材檢索、動畫模板、配樂、檢查、修正及合成。檢查與反思本身也是工具,模型可按檢查結果修補未達要求的部分。

Studio 提供八條同步時間軌,成片完成後仍可手動編輯,也支援暫停與續做、聊天修改、單鏡頭重製及版本回退。這讓內容團隊能把它用作長篇解說影片的初剪與修改工作台;成片仍需要人手確認素材、旁白和敘事是否合適。要運行 bf16 9B 模型,項目列出的硬件需求約為 24 GB NVIDIA GPU;只開啟介面、不執行模型則不需 GPU。資料未提供完整安裝及素材服務設定流程,不能只憑這些資訊判定部署所需的全部硬件與外部服務。

評估使用 100 項保留任務,整體分數為 90.5;項目亦報告,每分鐘成功輸出的生成 token 數約比 Claude Opus 5 少 33 倍。這些數字反映項目設定下的測試結果,不足以單獨證明不同影片類型或工作環境都能得到同樣成效。訓練資料則由 3,750 個完成影片項目還原剪輯意圖,再經驗證重播整理出 134,771 個訓練例子;開放的資料建構流程可供研究長流程工具操作的團隊參考。

  • 輸入知識文章或旁白稿,輸出多分鐘剪輯影片。
  • 單一 9B policy 每次呼叫一項工具,按編輯狀態自行規劃後續動作。
  • Studio 保留可編輯時間線,支援逐鏡修改與版本回退。
  • bf16 9B 模型約需 24 GB NVIDIA GPU;純介面模式毋須 GPU。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, Agentic, AI productions, 模型, 模型訓練, NVIDIA, Video, 工具, 語音, Anthropic, 動畫

Ming-3.0-tts:0.5B 優化講東話語音合成、語氣控制!

需要複製聲線、調整情緒,或按劇本生成多角色對話時,Ming-3.0-tts 提供多種控制方式,並支援多種語言與方言。

Ming-3.0-tts Logo

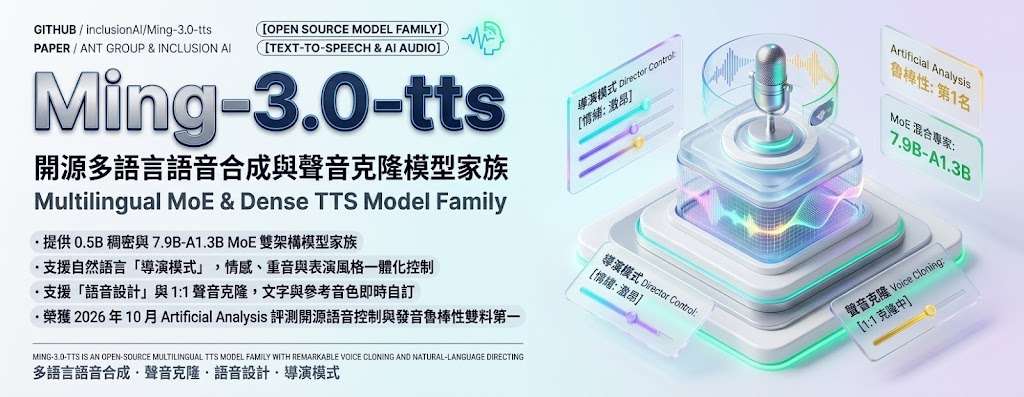
要為短片配旁白、製作有情緒起伏的角色對白,或生成多角色 Podcast,Ming-3.0-tts 都提供相應能力。這個開源語音生成模型項目支援中文、英文等七種語言,以及廣東話和四川話兩種方言;使用者可克隆參考聲線、用文字描述設計音色,亦可用自然語言指示演繹方式。

支持中文、英文、德文、西班牙文、法文、韓文和日文語音,亦可選擇四川話或廣東話;語速、音高和音量也可以調整。項目提供兩個模型:0.5b 是 dense model,tiny 則是建基於 Ling V3 的 MoE model,總參數量為 7.9B、每次啟用 1.3B。只有 tiny 支援按劇本和參考聲線生成多說話者對話。

兩個模型各有取捨。0.5b 在廣東話 Base CER、ACC,以及部分情緒和屬性控制指標取得領先;tiny 在多項多語言、聲線相似度和播客測試中排名靠前。不過,部分歷史紀錄仍由 Ming-omni-tts 保持,例如播客 CER;tiny 的韓語準確度、音高控制和角色扮演指令遵循能力,亦列為後續改善方向。

模型支持聲線複製、自然語言控制及多角色對話。適合需要製作多語言旁白、有聲內容或角色語音的創作者和開發團隊;若工作依賴特定方言的聲線相似度,或要求穩定遵循複雜角色指令,仍應先用目標語料自行驗證。

  • 可用文字設計語氣聲線或選用內置中英文聲線。
  • 支援 14 種中文或英文語氣標籤,以及情緒、語速、音高和音量控制。
  • tiny 可按劇本生成多說話者對話;0.5b 不具備這項功能。
  • 公開測試涵蓋方言、多語言、情緒、屬性控制和播客,兩個模型的領先項目各有不同。
  • ComfyUI 整合

項目主頁 · GitHub · 模型

Categories: 開源, 文字轉語音, 模型, Content Creator, 語音, 廣東話

CapCut 以外,Concat 把影片剪輯搬回本機

想剪片但不想上載素材、註冊帳戶或處理浮水印?開源影片編輯器 Concat 提供本機字幕、語音與多軌剪輯功能。

Concat

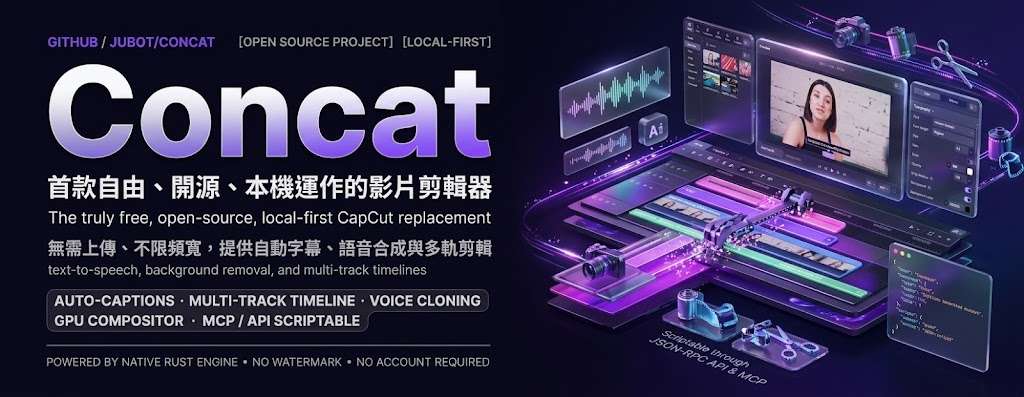
剪短片、上字幕、替換背景,卻不想先建立帳戶,把原片交給雲端平台處理,Concat 提供了另一條路。這個跨平台開源影片編輯器把自動字幕、文字轉語音、聲音複製、背景移除、多軌剪輯及 4K 匯出放進同一個介面,支援 macOS、Windows、Linux 與 Android。

Concat 屬於桌面及流動裝置影片編輯工具,核心特色不是追求完整取代所有專業軟件,而是針對 CapCut 常用的剪輯流程,減少上載素材及依賴訂閱的摩擦。自動字幕由本機 Whisper 處理,選擇模型大小後即可把字幕放上時間軸,再配合文字轉語音、關鍵幀動畫、特效及標題完成內容製作。

這項取捨十分清楚:素材可完全留在本機,離線工作,不會因平台政策改變而失去作品控制權;但代價是本機運算能力會直接影響字幕生成等功能的處理速度。Concat 亦提供語音複製,只需數秒錄音便可建立聲音,適合處理旁白、角色對白及多語言版本,背景移除則涵蓋人物、物件,亦可自行修正遮罩。

  • 支援 macOS、Windows、Linux 及 Android
  • 本機 Whisper 自動字幕,無須上載影片
  • 提供文字轉語音、聲音複製及背景移除
  • 支援多軌剪輯、關鍵幀、特效、標題與 4K 匯出
  • 無浮水印、無需帳戶,亦沒有上載限制或訂閱費用

對內容創作者、獨立製作者、教育工作者及需要處理敏感素材的團隊而言,這是一套頗完整的本機工作流。多軌剪輯、位置、縮放、旋轉、透明度及音量關鍵幀控制,令它不只停留在簡單裁片工具;惟目前版本號仍為 0.2.8,跨平台的成熟度、介面細節及不同裝置上的匯出表現,仍須經實際作品驗證。

GitHub

Categories: 開源, 文字轉語音, AI productions, 模型, Video, Audio, 軟件, 工具, Content Creator, Mac, Linux, 語音, 動畫

MoneyPrinterTurbo 整合 AI 影片流程

輸入主題即可生成短片內容與素材,亦可接入不同模型;適合內容團隊快速製作多語言影片。

Kimi 赞助 MoneyPrinterTurbo

給定一個主題,便要自行寫稿、找素材、配音、加字幕再剪輯;MoneyPrinterTurbo 將這套流程整合成 AI 短影片生成工具,涵蓋腳本、配音、素材搜尋、字幕、配樂及剪輯,並提供 AI Agent、WebUI、API 和 CLI 四種介面。

由一句主題到成片:它可自動生成或改寫多語言影片腳本,也允許逐個環節改用自訂內容。支援批量生成、任務紀錄,以及設定和 API Key 的匯入、匯出與恢復,對經常製作大量短內容的編輯、社交媒體營運團隊及小型工作室尤其方便。

  • 輸入主題或關鍵詞,自動完成短片內容與素材配對
  • 以 WebUI、API、CLI 或 AI Agent 接入不同工作流程
  • 可替換腳本、配音、素材、字幕或配樂
  • 支援批量生成、任務歷史及多語言腳本
  • 兼容多種模型服務、統一網關及本地環境

模型選擇相當廣,可連接 Kimi/Moonshot AI、OpenAI、Anthropic Claude、Google Gemini、DeepSeek、阿里云通義千問、Microsoft Azure OpenAI、火山引擎方舟、xAI Grok、MiniMax、小米 MiMo,以及 Ollama、LiteLLM、OpenRouter 等平台。Kimi K3 獲項目採用,負責撰寫文案、提煉素材搜尋關鍵詞及判斷合適畫面;本地模型則適合重視資料控制或降低雲端依賴的團隊,但最終流暢度與準確度仍取決於所選模型、服務配額及素材來源。

這套工具的優勢不是生成單段影片,而是把多個製作步驟串成可重複運作的流程。代價是成品質素仍受文字模型、素材版權、語音及剪輯設定影響,重要影片應保留人工審核,而非直接自動發佈。

GitHub

Categories: 開源, Agentic, AI productions, 模型, Google, 微軟, OpenAI, DeepSeek, Gemini, API, Video, 工具, Ollama, 語音, Anthropic, Kimi, 小米-Xiaomi, MiniMax

Page 1 of 11
1 2 3 … 11