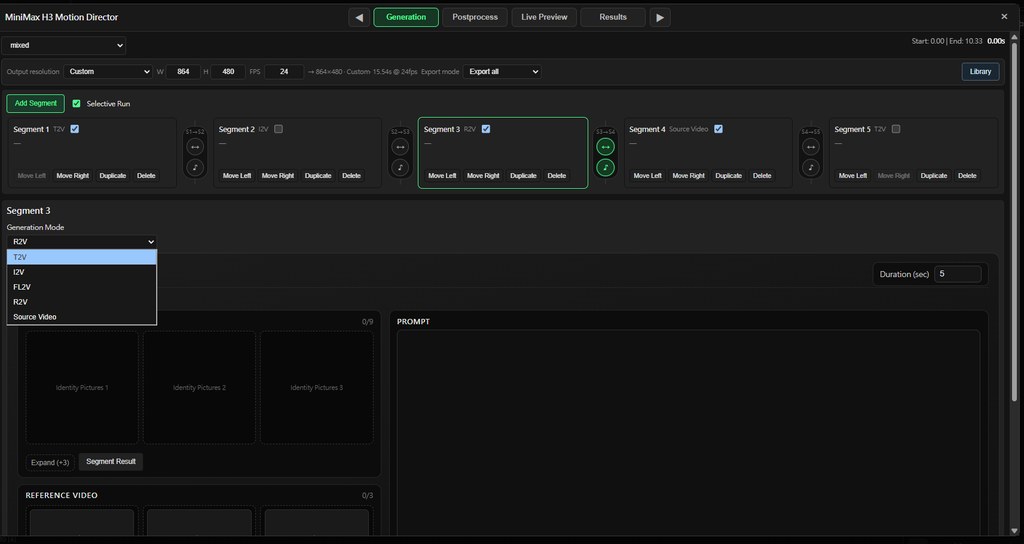
MiniMax-H3-Motion-Director 全能導演台節點

ComfyUI 自訂節點 Motion Director 將 T2V、I2V、V2V 等多段生成整合到同一介面,支援分鏡重跑、跨鏡頭連貫與即時預覽,讓多片段 AI 影片製作不再被節點海淹沒。

MiniMax H3 Motion Director — Mixed Mode

用 ComfyUI 砌 AI 影片嘅朋友,多數都經歷過呢個困局:想做一個有五個鏡頭嘅項目,要由零開始接 T2V、I2V、V2V 各種 workflow,每段調好參數再串埋,節點一多就連自己都搞唔清邊段行緊、邊段要重做。Motion Director 想處理嘅就係呢個問題——佢係一個 ComfyUI 自訂節點,把多段影片生成收納到同一個 Director 介面,等你可以逐段揀唔同生成方法(T2V / I2V / FL2V / R2V / V2V / RV2V),又唔使為咗切換而重新拉整個圖。

佢同一般 ComfyUI 工作流最大嘅分別,係圍繞「項目」做設計。Director 介面入面有 Segment、Multi Segment、Final Result 三層檢視,亦有 Director Live Preview 即時顯示邊段行緊、邊段做完。跨段連貫靠 Motion Context、Context Frames、Latent Scale Lock 同生成音訊接續,仲可以將上一段已解碼嘅幀直接當下一段嘅 I2V/FL2V 輸入,避免每次都重新生成首幀。素材方面提供 Common References 同持久化 Material Library,圖、音、影片、提示詞都可以重複用。

另一個貼地嘅設計係 Selective Run——只要揀要重做嘅片段就得,唔使成條 pipeline 重跑,配合 MIXED 模式用,可以幾段文生、幾段圖生、幾段源影片剪輯混埋做項目。Director 本身係 OUTPUT_NODE,最尾嗰格就可以輸出畫面、音訊同 FPS 畀下游 ComfyUI 節點繼續接。後製方面內置 Global Refine、放大、可揀 NVIDIA RTX VSR / Deblur 同 Face Refine,不過 VSR/Deblur 要相容 NVIDIA VFX runtime,Face Refine 要 UI 揀好對應 detector/SAM 路徑。

適合要處理多鏡頭、有分鏡表、要保持視覺同音訊一致嘅創作者,例如廣告原型、MV 概念、敘事短片預覽,或者要把源影片做局部 V2V/RV2V 修補嘅後期流程。生成方面支援內建 sampling 或外部 ComfyUI SAMPLER + SIGMAS,方便想自己控制 noise schedule 嘅人。版本去到 v1.2.0,採用 GPL-3.0;硬件門檻就睇你揀嘅功能——基本生成跟返 ComfyUI 一般配置,想用 VSR/Deblur 或大尺寸放大就要 NVIDIA 顯卡同對應 runtime。

重點摘要:

  • 多段整合 Director 介面:T2V/I2V/FL2V/R2V/V2V/RV2V 同一畫面揀,逐段切換唔使重拉 workflow
  • Selective Run + Mixed Mode:只重跑指定片段,唔使成條 pipeline 由頭嚟
  • 跨鏡頭連貫:Motion Context、Context Frames、Latent Scale Lock 同音訊接續,仲可以重用上一段解碼幀
  • 內建 Live Preview 與三層檢視:Director 介面直接睇 Segment/Multi Segment/Final Result
  • 後製選項齊全:Global Refine、放大、可選 RTX VSR/Deblur 與 Face Refine,對硬件有特定要求
GitHub

Categories: 開源, NVIDIA, ComfyUI, Video, AI productions, , MiniMax, 框架

Atlas 世界模型一次處理文字、圖片、影片與 3D

World Labs 推出 Atlas,聲稱是目前首個原生同時處理文字、圖像、影片與 3D 的「omni」世界模型,能從一張相機路徑推算未見過的視角,並重建真實場景。

Og image

World Labs 公開了新一代世界模型 Atlas。它的特別之處在於從訓練階段就同時處理四種輸入——文字、圖像、影片、3D——並把它們整合到同一個空間脈絡裡,再以多模態自迴歸擴散 Transformer 推算下一個畫面。這意味著 Atlas 不只是「看得更多」,而是嘗試理解世界怎樣呈現、怎樣變化,並把想像中的場景渲染出來。

從使用場景來看,Atlas 主要涵蓋四類工作:相機控制生成、空間重建、空間時間模擬,以及純文字生圖與 360 度全景。其中相機控制生成支援 1 至 6 張輸入圖片,可輸出最高 1440p、最長約 1 分鐘的影片,並以像素級精度的相機幾何作為輸入,而不只是粗略的文字描述。

重建方面,Atlas 只需要 1 張到幾十張相片,就能還原真實場景並產出新視角的影像幀與明確的 3D 輸出。團隊指出,這項表現優於專門做 3D 重建的同類模型。空間時間模擬則可從影片重新取景,生成電影級視覺效果,並支援 Real-to-Sim 流程,供機器人規劃動作。

以下幾點值得留意:

  • 原生多模態:文字、圖片、影片、3D 一開始就共享同一空間脈絡,並非後期拼接。
  • 像素級相機控制:把精確相機幾何列為原生輸入,能逐格構圖、逐段運鏡。
  • 超越專用模型:3D 重建表現優於專門訓練的模型。
  • 支援 Real-to-Sim:能把真實影片轉成可模擬的世界,供機器人規劃。
  • 規模持續擴展:團隊表示表現會隨訓練算力提升,並預期這個趨勢會延續下去。

World Labs 表示,Atlas 將驅動他們自家 Marble 的未來版本及其他產品,現已開放早期使用的申請。

項目主頁

Categories: API, Video, Image, 3D, AI productions, 多模態模型, 影像模型, 模型訓練, Robotic, 世界模型

H3-World 讓鍵盤控制生成影片世界

H3-World把鍵盤輸入轉成可控制的未來畫面,展示互動式世界模型由理解指令走向操控環境。

Repository image for Danzer1xxxxChan/H3-World

按下 W、A、S、D 控制角色,或以 I、J、K、L 操控鏡頭,H3-World 便會由初始畫面生成相應的動作影片。這個項目屬於互動式世界模型,實際處理的是角色與鏡頭動作如何連貫地影響後續畫面,適合遊戲代理、視覺模擬及 Computer-use agents(CUAs)相關研究。

H3-World 建基於 MiniMax-H3,將每個鍵盤狀態轉換成對應未來 video latent 的語言指令,再透過 directed attention routing 把指令綁定到相應的 latent 區間。模型以 8,000 段 ABot-World-Explorer-500h gameplay clips 訓練,只學習 65.6M 個 Low-Rank Adaptation(LoRA)參數,約佔 33B backbone 的 0.199%,在保留大型模型能力與控制專用訓練成本之間取得折衷。

目前資料提供的重點包括:
– 角色控制使用 W、A、S、D;鏡頭控制使用 I、J、K、L,F 代表快速鏡頭移動。
– H3-World LoRA 是 MiniMax-H3 的 delta,不能直接套入未修改的 MiniMax-H3 pipeline。
– 推理需要約 135 GB 的 MiniMax-H3 base weights,以及 H3-World 的 directed-attention patch。
– 公開資料沒有列出明確的畫質、延遲或成功率比較,因此未能判斷它在不同世界模型之間的性能差距。

儲存庫提供 Python 3.10、CUDA 12.8、PyTorch 2.10.0 和指定版本 DiffSynth-Studio 的配置要求;模型權重及 LoRA checkpoint 則分別放在 Hugging Face 指定位置,訓練另需 ABot-World-Explorer-500h。研究團隊、遊戲代理開發者及需要可控影片生成的視覺模擬項目較容易受益,但硬件容量、專用 patch 和模型授權條款都是採用前必須核對的條件。

項目主頁 · GitHub · 模型

Categories: 開源, NVIDIA, Agentic, Video, AI productions, Python, 多模態模型, 模型訓練, 視頻模型, MiniMax

ComfyUI-OCIO:ComfyUI 直通 ACES 與 HDR 的色彩管理節點

由模型輸出到 ProRes、EXR 或 HDR 交付,ComfyUI-OCIO 保留更多影像色彩與亮度資訊。

OCIO Nodes for ComfyUI - by AI VFX NEWS, Slava Sexton

由 LTX、Flux 或其他影像流程產生的 HDR、Cineon 及 10-bit 影片,可以在 ComfyUI 原生 VIDEO wire 內完成色彩管理、ACES 調色及輸出。ComfyUI-OCIO 屬於 ComfyUI 自訂節點項目,處理的是模型解碼後容易被截斷、降位深或轉成 4:2:0 的影像資料。

核心差異在於 OCIO VAE Decode 以 float32 解碼,而且不會把數值夾到固定範圍;低於 0 的值亦會保留,讓超出工作色域的顏色和場景線性動態範圍交由 OpenColorIO 轉換。普通 SDR 生成不會因取消 clamp 自動變成 HDR,素材本身沒有相關範圍時,收益亦會有限。

LTX-2.5 可經由 ACEScct 路徑接入其 HDR path,補足 ComfyUI 原生流程未能直接觸及的部分。輸出可包括 32-bit float EXR、ProRes 4444 10-bit 4:4:4、DPX log,以及 Rec.2100 PQ/HLG;FFV1 才能做到無損保存,ProRes 讀回則以 12-bit 處理並承載 10-bit 資料。

ComfyUI-OCIO 提供的單一 LTX-2.5 測試中,模型浮點母片有 2304 個亮度級別,該項目的 ProRes 4444 版本保留 3520 個可辨識級別,與母片可辨識差異為 0.0001%;原生 10-bit 流程則為 882 級,出廠流程只有 220 級。安裝所需依賴包括 OpenColorIO、OpenCV、tifffile、Pillow、numpy 及 FFmpeg,但資料未提供完整圖形化操作步驟;較適合熟悉 ComfyUI、ACES 和影片編碼的 VFX、影片生成及後期團隊。

  • 保留 float32 解碼結果,不強制限制亮度範圍
  • 支援 ACES、HDR、Cineon、LTX、Flux 及 10-bit 影片流程
  • 可在原生 VIDEO graph 內讀取序列、調色及寫出影片
  • LTX-2.5 可經 ACEScct 進入其 HDR path
  • FFV1 適合無損保存,ProRes 4444 適合交付

GitHub

Categories: 開源, ComfyUI, Video, AI productions, LTX

Diffusion Studio:智能影片剪輯工作流

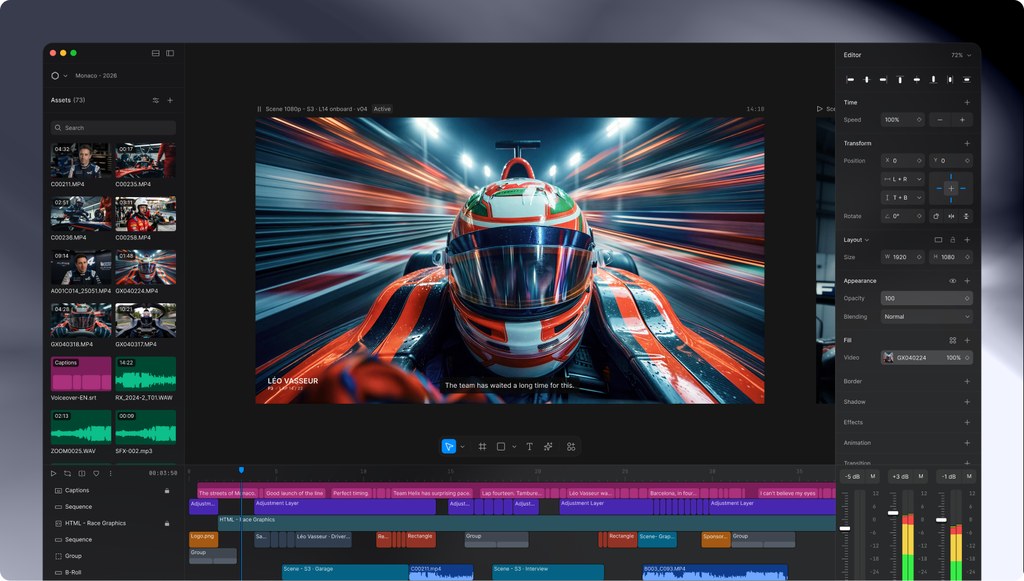
Diffusion Studio 將時間軸剪輯與 SolidJS 程式碼互相同步,讓 AI agents 可以直接協助製作影片。

Diffusion Studio

想用自然語言叫 AI 整理素材、剪出精華片段,甚至加入動態圖像和旁白,Diffusion Studio 提供了一條由命令列控制影片編輯器的工作流。它屬於開源影片編輯工具,核心是以 SolidJS modules 作為文件來源,處理由原始片段到成片的剪輯、合成和影片理解。

畫布與程式碼可以雙向修改:在畫布調整內容,變更會寫回程式碼;直接編輯程式碼,影片畫布亦會重新繪製。配合 dapi CLI,Claude Code、Codex、Cursor、Copilot 或 Gemini CLI 等 agents 能以文字指令操作時間軸,亦可要求系統摘要影片、搜尋場景,或找出附有時間戳的引述。

  • 影片剪輯、Motion graphics、社交平台短片重製
  • 以程式碼宣告圖片、影片和 voiceover,再合成到時間軸
  • 由命令列觀看及聆聽素材,交由 agents 協助處理
  • 可在 macOS Apple Silicon 使用桌面版本,並透過 skills 接入工作流

相比只在時間軸介面操作的編輯器,程式碼成為可保存、修改和交給 agents 處理的文件來源,較適合需要重複產出、批量改版或以生成式資產組成影片的團隊。代價是使用者要同時理解畫布、SolidJS modules 和 CLI 的關係;項目資料亦未提供獨立性能指標或完整平台支援範圍,不能單憑介紹判斷長片剪輯效率。

Diffusion Studio 連接 AI agents 之後可透過程式碼與影片時間軸進行編輯。內容創作者可先下載 macOS Apple Silicon 版本,再安裝官方 skills,透過自然語言要求建立影片,並在畫布中檢查結果;熟悉編程的團隊則可直接維護可重用的影片程式碼。

GitHub

Categories: 開源, Agentic, AI productions, IDE, Mac, 蘋果, Skill 技能

WeMM-Embedding:對齊文字、圖片、影片的多模態檢索

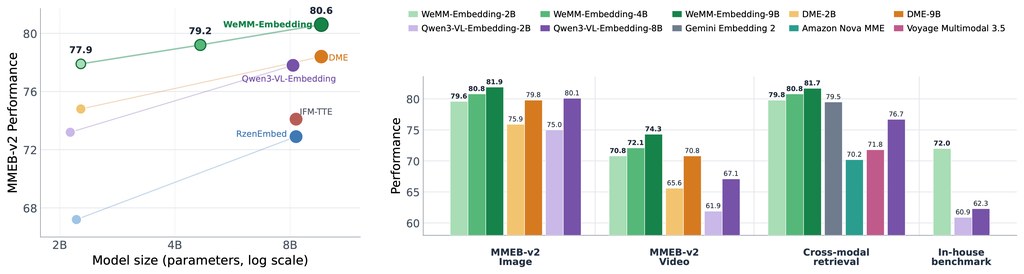
騰訊微信視覺團隊把文字、圖片、影片、視覺文件等多種輸入收進同一個嵌入空間,推出涵蓋 2B/4B/9B 三個尺寸的 WeMM-Embedding 系列,主打檢索與多模態理解一條龍。

WeMM-Embedding Performance Overview

把文字、圖片、短影片、文件截圖一次過丟進同一個嵌入空間做檢索,一直是多模態團隊頭痛的工程難題。WeMM-Embedding 系列由騰訊微信視覺團隊開源,正是針對這個場景而來:三個規模(2B/4B/9B)都用同一套介面,輸出可直接比對的向量,免卻多模型串接的麻煩。

向量從模型最後一層的 <embedding> token 位置取出,再做 L2 正規化,方便直接接入既有向量資料庫。對想做跨模態檢索或 RAG 的團隊而言,這類統一模型比起同時維護 CLIP 系、BGE 系、影片模型幾套 pipeline,部署成本明顯較低。

官方推薦 transformers==5.2.0 以保證預處理一致性,亦支援 SentenceTransformer 直接載入 Hugging Face 模型 ID。比較有彈性的是 Matryoshka Representation Learning(MRL):例如 9B 版本支援 64 到 4096 多段維度,開發階段可以用低維度快速迭代,再逐步切到高維度;2B 與 4B 版同樣提供 64 至 2048 左右的選項。已驗證 vLLM 0.27.0 與 SGLang 0.5.9 兩套推理引擎,兩者都以 pooling runner 啟動,搭配專屬的 chat template 即可提供 embedding 服務。

與同類開源嵌入模型相比,WeMM-Embedding 強調「影片與視覺文件也在同一個向量空間」,而不是只覆蓋到圖文。短影片摘要、PDF 截圖理解、社交媒體(X Demo)多模態內容推薦等場景,會比純圖文模型更貼地。音訊輸入目前不在支援範圍內,是規劃時要留意的限制。受惠對象包括做多模態 RAG、跨模態檢索、商品搜尋及內容審核的中小團隊,因為他們通常缺乏同時訓練多個專門模型的資源。

重點:

  • 統一嵌入空間:文字、圖片、影片、視覺文件、交錯輸入共用同一向量表示,免除多模型串接。
  • 三種規模:2B、4B、9B 同步開源,可在準確度與成本之間靈活取捨。
  • Matryoshka 維度彈性:支援 64 至 4096 多段可選維度,平衡儲存與效果。
  • 生態友善:兼容 transformersSentenceTransformer,並已驗證 vLLM 與 SGLang 部署。
  • 目前限制:音訊輸入未支援,預處理對 Transformers 版本敏感,需固定在 5.2.0。

GitHub · 模型

Categories: 開源, 騰訊, Video, Image, AI productions, Embedding, RAG, 模型, Dataset 數據集

阿里巴巴 PAI 以 PDD 加速 MiniMax-H3 影片生成

阿里巴巴 PAI 團隊把 MiniMax-H3 變成少步數就能出片的版本。你可以把它理解成針對影片生成速度做加速的 LoRA。

Og image

阿里巴巴 PAI 團隊針對 MiniMax-H3 做了 Parallel Decoding Distillation(PDD),目標是用更少推理步數完成影片生成。這份項目同時保留 MiniMax-H3 的兩條路線,分別對應 FL2VA 和 Ref2VA,方便按不同基礎版本套用加速 LoRA。

兩個官方 8-step Acc LoRA,檔名分別是 MiniMax-H3-FL2VA-Acc-8Step.safetensorsMiniMax-H3-Ref2VA-Acc-8Step.safetensors,兩者都標示 rank=64network_alpha=64,並以 BF16 形式提供。這表示它們不是完整底模,而是掛在對應 base model 上的加速適配器。

8-step Acc LoRA 可配合 768p 生成流程,並對比 baseline、Turbo 4-step 版本和 8-step Acc LoRA。

實務上,8-step Acc LoRA 代表在速度和畫面穩定度之間做取捨,重點是把影片生成的推理成本壓低,而不是追求最長流程。相較原始 MiniMax-H3,這類 LoRA 的用途更偏向快速出樣和迭代,適合需要較短等待時間的影片生成工作流。

  • 開發團隊是 Alibaba-PAI,並以 MiniMax-H3 做 PDD 加速
  • 提供兩個 8-step 官方 Acc LoRA,分別對應 FL2VA 和 Ref2VA
  • 檔案以 BF16、rank=64network_alpha=64 方式發布
  • 頁面有 768p Demo,但未交代 GGUF、mmproj 或硬體需求

項目主頁 · 模型

Categories: 開源, 阿里巴巴, Video, AI productions, 多模態模型, 視頻模型, MiniMax

TLive-Omni:專攻直播電商的多模態理解模型

TLive-Omni 將影像、影片、語音和文字統一成文字輸出,特別適合要即時理解直播內容的場景。它同時處理商品畫面、聲音與對話脈絡,目標是減少直播電商裡資訊斷裂的問題。

logo

TLive-Omni 是一個多模態理解模型,針對直播電商場景,把影像、影片、語音和文字整合到同一個文字輸出介面。對做直播監控、商品理解、內容標註或客服輔助的人來說,它處理的是同一場直播裡多種訊號難以對齊的問題。

這個項目建基於 Qwen3.5 backbone,再接入 AuT audio encoder 和輕量 MLP 對齊層,並用 timestamped Per-vGrid 把聲音片段和對應畫面放在一起。它支援最長 256K tokens context,適合長時間直播流的連續理解,而不是只看單段截圖或單句語音。

訓練流程分三階段 SFT,先做語音與語言對齊,再擴展到完整多模態指令跟隨,之後加入 Faithful-RFT,強調回答要貼近直播場景的即時需要。README 亦列出聲音辨識、講者分析、商品視覺定位、文字辨識、時序定位、影片密集描述和 omni-modal QA 等能力,顯示它不是單一功能模型,而是面向直播任務的綜合型系統。

  • 4B 和 9B 版本都已公開,方便按算力和部署成本選擇。
  • 在直播電商的音訊、影像和影片任務上有不錯表現。
  • 對一般基準也有泛化能力,不只局限於單一場景。
  • 更適合需要長上下文、多訊號同步分析的團隊。
  • 取捨在於它很聚焦直播電商,未必是通用多模態助手的最佳替代。

整體來看,TLive-Omni 把直播場景最麻煩的訊號對齊、長上下文理解和即時回答放在同一條路徑處理,對做電商直播分析、內容審核和銷售輔助的團隊會更實用。它的價值不在於把功能堆滿,而在於把多模態理解收斂到直播工作流裡真正會撞到的問題。

項目主頁 · GitHub · 模型

Categories: 開源, Qwen, Video, Audio, AI productions, 多模態模型, 語音

[教學影片]MiniMax H3 六格分鏡生成多鏡頭 AI 影片

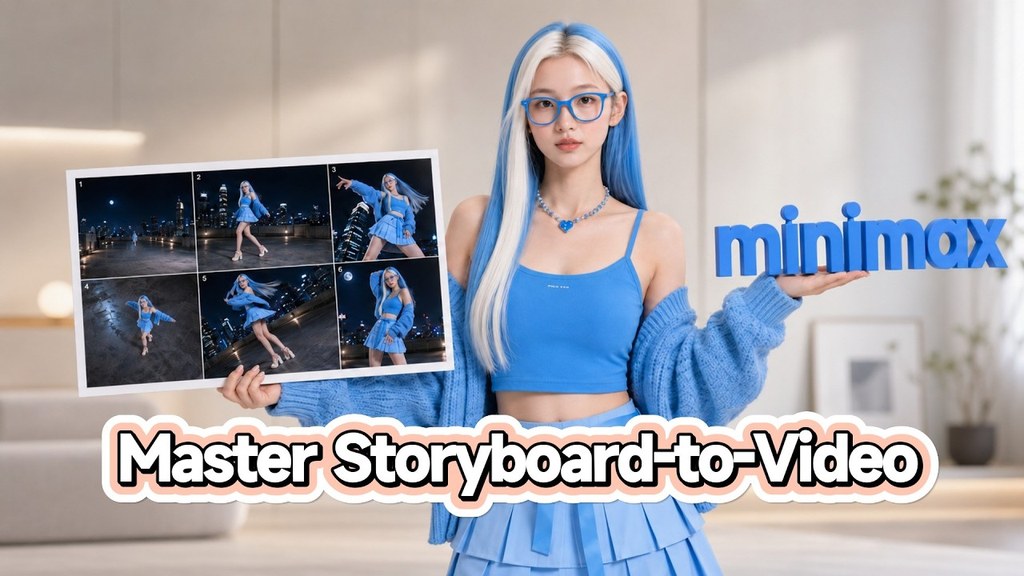
MiniMax H3 加入六格分鏡網格參考功能,用戶可直接餵故事板圖,再生成多鏡頭連貫短片,解決單鏡頭 AI 影片動作細節不足的問題。

Og image

AI 影片生成最常見的痛點之一,是鏡頭內動作幅度細,剪接起來又欠缺段落感。MiniMax H3 這次加入的 6-Grid Reference(六格分鏡網格)功能,嘗試從輸入端就解決這個問題:使用者把一張包含六格分鏡的故事板圖丟入模型,H3 會按格子內容分別生成對應鏡頭,再組成一條多鏡頭短片,避免單次生成只能「前後郁幾吋」的局限。

對熟悉影視分鏡流程的人來說,這等於把前期 storyboard 直接搬進生成管線。對一般創作者而言,操作門檻也比逐個鏡頭獨立 prompt 再拼接低很多——畫好六格、寫好提示詞,剩下的運鏡與節奏交給模型處理。

以下是這次教學與功能值得留意的幾個重點:

  • 六格分鏡直接餵入:以一張 2×3 或 3×2 的網格圖作為視覺參考,模型按格生成對應鏡頭,無需逐個 cut 分開生成。
  • 多鏡頭連貫輸出:最終成品會包含多個 shot,而非單一長鏡頭,方便直接接上剪接流程。
  • 適合分鏡先行的工作流:對動畫短片、廣告腳本、遊戲過場等已有 storyboard 習慣的團隊特別受用。
  • 降低逐鏡 prompt 成本:一次輸入即可覆蓋多個鏡頭,減少重複描述角色、場景、風格的工序。
  • 與 H3 既有能力整合:可與 H3 的角色一致性與風格控制一併使用,保持多鏡頭之間的人物與美術統一。

教學影片示範的工作流程大致是:先準備好六格分鏡圖,每格代表一個鏡頭的構圖與動作重點,提示詞內描述場景氛圍與鏡頭運動方向,再由 H3 一次過輸出。對於想快速測試分鏡概念、或者要把動畫前期視覺化的人,這條工作流比起從零開始寫分鏡 prompt 更直觀。

需要留意的是,六格分鏡的格數、比例與每格內容差異會直接影響成品質素,每格的構圖與動作如果太擠迫或太模糊,模型理解鏡頭意圖時容易出錯。建議先用簡潔構圖測試,再逐步加入複雜元素。

影片主頁ComfyUI 工作流特別版 H3 模型

Categories: 開源, ComfyUI, Video, AI productions, 多模態模型, MiniMax

[影片教學] 利用開源探索 3D 世界

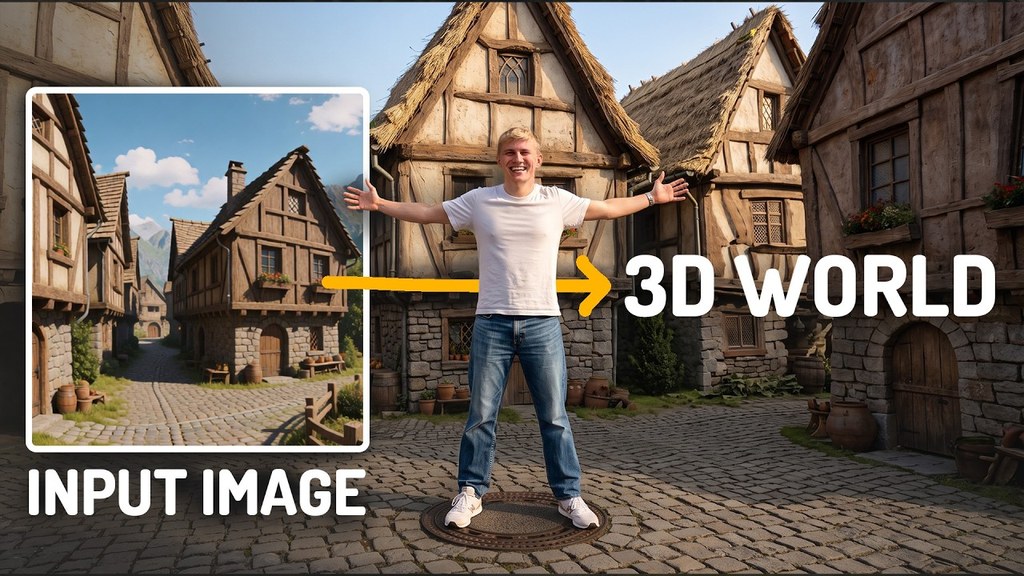
這個開源項目讓你用一張圖或一段文字 prompt,在本地免費生成可自由行走的 3D 世界,毋須依賴雲端服務。

Og image

過往要把一張圖變成可探索嘅 3D 場景,往往需要動用雲端 GPU 或者封閉式商業工具。一個新開源嘅世界生成項目反其道而行,主打「本地、免費、完全開源」,用家只需要餵一張圖片,或者寫一段文字 prompt,就可以產出一個可以行入去慢慢逛嘅 3D 場景。對遊戲開發、空間設計或者 VR 內容創作嚟講,呢種「零門檻起手」嘅流程可以省卻大量建模時間。

同一般文生圖或者文生影片模型唔同,呢類世界生成系統要處理嘅唔係單一畫面,而係保持視點一致嘅連續空間。背後通常會結合影像生成、深度估計同體積渲染(volumetric rendering)等幾組技術,再用 NeRF(Neural Radiance Fields,神經輻射場)或類近嘅 3D 表徵方式重建場景,等用家可以即時改變視角行入去睇。

對玩家嚟講,最直接嘅體驗係輸入一張京都街景相或者一句「霧夜嘅科幻實驗室」,幾分鐘之後就有一個可以操控角色行入去嘅小型世界;對開發者嚟講,由於整套工具鏈都係本地行得通,唔使擔心 prompt 或者素材被上傳到第三方伺服器,私隱同成本都較易掌控。

不過本地跑呢類模型對 GPU 仍然有要求,視訊記憶體唔夠嘅話生成時間會明顯拉長;另外世界嘅規模同互動深度仲未去到遊戲引擎嗰種水平,比較適合作為概念驗證或者素材起手稿,而唔係完整場景嘅最終方案。

以下係幾個值得留意嘅重點:

  • 支援圖生世界(image-to-world)同文生世界(text-to-world)兩種入口
  • 完全開源,可在本地離線運行
  • 採用神經輻射場或類近技術做 3D 重建,保持視角一致
  • 私隱同成本上比雲端方案更具優勢
  • 對 GPU 仍有要求,目前較適合做概念驗證階段

項目主頁

Categories: Image, 3D, AI productions, 影像處理, 教學, 世界模型

Page 1 of 7
1 2 3 7