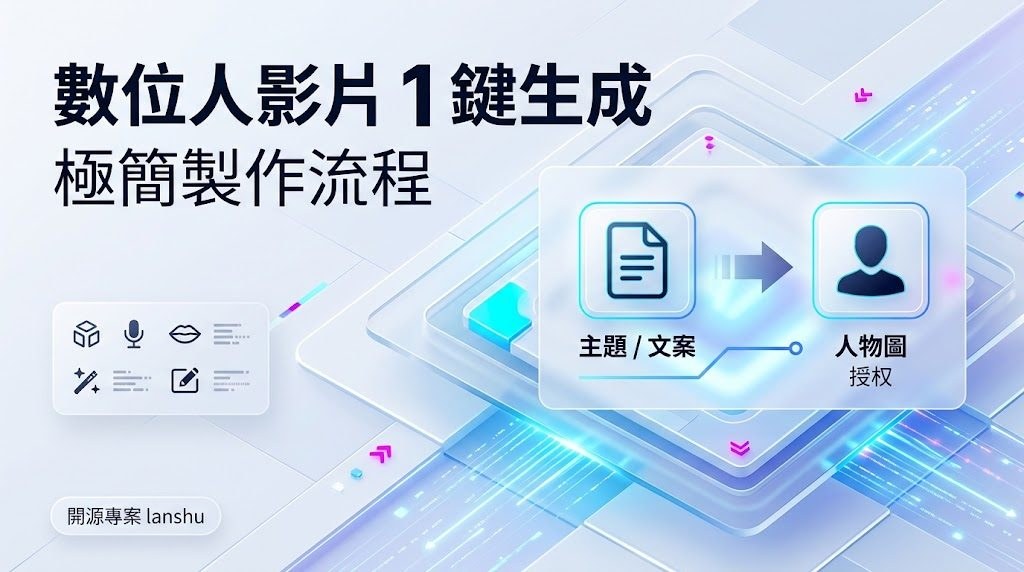
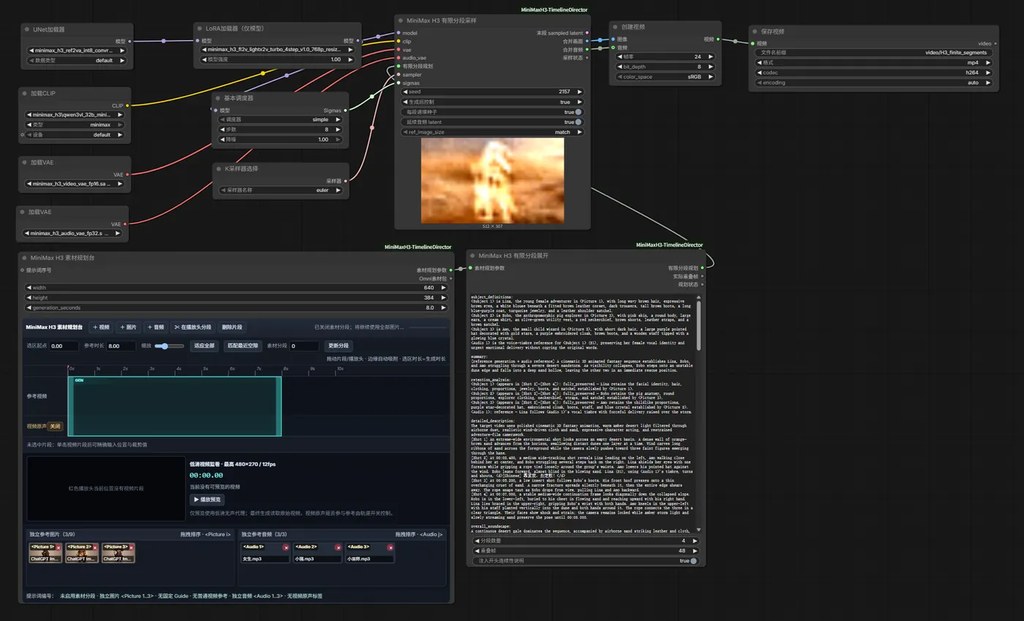
佢唔係一個獨立嘅模型,而係一套組織數字人影片工序嘅 Skill 框架,價值在於把配音、人物、字幕、剪輯、驗收等步驟統一在同一條音頻時間軸上,避免最常見嘅口型錯位同片段斷裂。內容創作者、行銷團隊、課程錄製同需要快速產出講解影片嘅場景會較受惠,特別係想喺不同 AI 服務商之間靈活切換、又唔想被單一平台鎖死嘅人。
幾個重要限制:nr intensity 鎖死喺 1.0,1.0、1.5、2.0 嘅輸出 bit identical;skin structure strength 必須開啟 automatic mask 先有效,閂咗之後所有皮膚參數都唔再產生變化;nr preset 喺任何數值下都係 bit identical。只有 local structure strength 同 local tone strength 係全程範圍真正可調。預設、J、K 幾個 dlss model preset 嘅源幀 detail energy 大約喺 0.56x 左右,呢個唔係銳化工具想要嘅走向,反映嘅係材質重建比邊緣強化重要嘅設計取向。
想讓 AI 數字人不只是「會打字」,而是真的「邊說邊演」?香港中文大學(深圳)與 LIGHTSPEED 合作開源的 Ex-Omni-2D,正是針對這個目標設計。它是一個開源對話框架,接受多模態查詢、參考圖像與參考音訊後,先由語言模型輸出一份結構化的 Visual Thought Plan(VTP),再依此生成文字回應、個人化語音,並產出嘴形與動作同步的頭像影片。